

Ko prihajanju v izdelek, ki se razvija že več kot desetletje, ni presenetljivo srečati zastarelih tehnologij. Ampak kaj, če morate čez šest mesecev obvladovati obremenitev, ki je desetkrat večja, cena padcev pa se poveča stokrat? V tem primeru potrebujete vrhunskega inženirja za visoko obremenitev. Ker pa takega ni, so se odločili zaupati rešitev meni. V prvem delu članka bom opisal, kako smo prešli z Redis-a na Redis-cluster, v drugem delu pa bom dal nasvete, kako začeti uporabljati cluster in na kaj biti pozoren pri njegovi uporabi.
Technologiewahl
Je res tako slab ločen Redis (standalone redis) v konfiguraciji 1 glavni in N klonov? Zakaj ga imenujem zastarelo tehnologijo?
Ne, Redis ni tako slab... Vendar pa obstajajo nekateri pomankljivosti, ki jih ni mogoče ignorirati.
Prvič, Redis ne podpira mehanizmov za obnovitev po izpadu glavnega strežnika. Za rešitev tega problema smo uporabili konfiguracijo z avtomatskim preusmerjanjem VIP-ov na novega glavnega, spremembo vloge enega od klonov in preklop preostalih. Ta mehanizem je deloval, a ga ni bilo mogoče šteti za zanesljivo rešitev. Prvič, pojavile so se lažne alarme, drugič, bil je enkratni postopek in po sprožitvi so bile potrebne ročne akcije.
Drugič, prisotnost le enega glavnega je vodila do težave s shardiranjem. Treba je bilo ustvariti več neodvisnih clusterjev '1 glavni in N klonov', nato ročno razpršiti baze po teh strojih in upati, da se jutri ena izmed baz ne bo povečala toliko, da bi jo bilo treba preložiti na ločen instanc.
Kakšne so možnosti?
- Najdražja in najbogatejša rešitev je Redis-Enterprise. To je ploščatna rešitev s popolno tehnično podporo. Kljub temu, da izgleda popolno z vidika tehnologije, nam ni ustrezala iz ideoloških razlogov.
- Redis-cluster. Iz škatle podpira avtomatsko preklapljanje glavnega in shardiranje. Vmesnik se skoraj ne razlikuje od običajne različice. Izgleda obetavno, o skritih pasti bomo govorili pozneje.
- Tarantool, Memcache, Aerospike in drugi. Vsa ta orodja delajo približno isto. Vendar ima vsako svoje pomanjkljivosti. Odločili smo se, da ne bomo dali vseh jajc v eno košarico. Memcache in Tarantool uporabljamo za druge naloge, in povem vnaprej, da smo imeli z njimi več težav.
Specifika uporabe
Poglejmo, katere naloge smo zgodovinsko reševali z Redisom in kakšne funkcionalnosti smo uporabljali:
- Predpomnilnik pred poizvedbami do oddaljenih storitev, kot je 2GIS | Golang
GET SET MGET MSET "IZBERI DB"
- Predpomnilnik pred MYSQL | PHP
GET SET MGET MSET SCAN "KLJUČ PO PATRONU" "IZBERI DB"
- Glavno skladišče za storitev za upravljanje s sejami in koordinatami voznikov | Golang
GET SET MGET MSET "IZBERI DB" "DODAJ GEO KLJUČ" "GET GEO KLJUČ" SCAN
Kot vidite, nobene višje matematike. Kje pa je potem zapletenost? Poglejmo posamezno vsako metodo.
Metod
Opis
Posebnosti Redis-cluster
Solution
GET SET
Zapisati / prebrati ključ
MGET MSET
Zapisati / prebrati več ključev
Ključi bodo na različnih vozlih. Gotove knjižnice znajo izvajati Multi-operacije le v okviru enega vozla
Zamenjati MGET z pipeline-om N GET operacij
IZBERI DB
Izberite bazo, s katero bomo delali
Ne podpira več baz podatkov
Vse shraniti v eno bazo. Dodajte predpone ključem
SCAN
Prebrskati vse ključe v bazi
Ker imamo eno bazo, je prečkanje vseh ključev v clustrov preveč potratno
Ohraniti invariant znotraj enega ključa in izvesti HSCAN po tem ključu. Ali se popolnoma odpovedati
GEO
Operacije z geo ključem
Geo ključ ni shardiran
KLJUČ PO PATRONU
Iskanje ključa po vzorcu
Ker imamo eno bazo, bomo iskali po vseh ključih v clustrov. Preveč potratno
Odpovedati se ali ohranjati invariant, kot pri SCAN-u
Redis proti Redis-cluster
Kaj izgubljamo in kaj pridobimo pri prehodu na cluster?
- Slabosti: izgubljamo funkcionalnost več baz.
- Če želimo shranjevati v enem clustru logično nepovezane podatke, bomo morali izdelati rešitev v obliki predpon.
- Izgubimo vse operacije 'po bazi', kot so SCAN, DBSIZE, CLEAR DB itd.
- Multi-operacije so postale bistveno bolj zapletene za izvajanje, ker je lahko potrebno dostopati do več vozlov.
- Prednosti:
- Odpornost v obliki preklopa na rezervnega vodjo.
- Shardiranja na strani Redis.
- Prenos podatkov med vozli atomarno in brez zastojev.
- Dodajanje in prerazporeditev zmogljivosti in obremenitev brez zastojev.
Pričakujem, da če vam ni treba zagotoviti visoke ravni odpornosti, premik na klaster ne bo vreden truda, saj je to lahko zapletena naloga. Vendar, če morate izbrati med ločeno različico in klastrsko, je smiselno izbrati klaster, ker ni nič slabši in dodatno vam odvzame del skrbi.
Priprava na selitev
Začnimo s zahtevami za selitev:
- Mora biti brezšivna. Popolna zaustavitev storitve za 5 minut nas ne zadostuje.
- Mora biti kar se da varen in postopno izveden. Želimo imeti nadzor nad situacijo. Ne želimo, da vse prenesemo hkrati in molimo za gumb za povrnitev.
- Minimalne izgube podatkov med selitvijo. Zavedamo se, da bo atomarno selitev zelo težko izvesti, zato dopuščamo določeno nesinkronizacijo med podatki v običajnem in klasterskem Redis-u.
Vzdrževanje klasterja
Pred selitvijo se je vredno vprašati, ali lahko vzdržujemo klaster:
- Grafi. Uporabljamo Prometheus in Grafano za grafične prikaze obremenitve procesorjev, zasedenosti pomnilnika, števila strank, števila operacij GET, SET, AUTH itd.
- Strokovnost. Predstavljajte si, da bo jutri pod vašo odgovornostjo ogromen klaster. Če se pokvari, ga nihče, razen vas, ne bo mogel popraviti. Če bo začel upočasnjevati — vsi se bodo obrnili k vam. Če bo treba dodati vire ali prerazporediti obremenitev — spet k vam. Da ne postanete sivi pri 25, je smiselno predvideti te primere in vnaprej preveriti, kako se bo tehnologija obnašala pri takšnih ali drugačnih dejanjih. O tem se bomo podrobneje pogovorili v razdelku 'Strokovnost'.
- Nadzori in obvestila. Ko se klaster pokvari, bi želeli izvedeti prvi. Tu smo se omejili na obveščanje, da vse vozlišča vračajo enake informacije o stanju klasterja (da, včasih je tudi drugače). Druge težave je hitreje opaziti preko obvestil storitev-odjemalcev Redis.
Preseljenje
Kako se bomo selili:
- Najprej je potrebno pripraviti knjižnico za delo s klasterjem. Kot osnovo za različico v Gо smo vzeli go-redis in jo nekoliko prilagodili. Implementirali smo Multi-metode preko pipeline-ov, prav tako pa nekoliko spremenili pravila ponavljanja poizvedb. Z različico za PHP je bilo več težav, vendar smo se nazadnje odločili za php-redis. Nedavno so uvedli podporo za klaster, ki se nam zdi dobro zasnovana.
- Nato je potrebno postaviti klaster. To lahko storimo dobesedno v dveh ukazih na podlagi konfiguracijske datoteke. Podrobneje o nastavitvah bomo razpravljali kasneje.
- Za postopno preselitev uporabljamo dry-mode. Ker imamo dve različici knjižnice z enakim vmesnikom (eno za običajno različico, drugo za klaster), ni težko ustvariti ovitka, ki bo deloval z ločeno različico in hkrati podvajal vse poizvedbe v klaster, primerjal odgovore in beležil razlike v dnevnikih (v našem primeru v NewRelic). Tako, tudi če se klasterna različica pri uvajanju zlomi, naš produkcijski sistem ne bo prizadet.
- Ko je klaster uveden v dry-režimu, lahko mirno spremljamo graf razhajanja odgovorov. Če se delež napak počasi, a zanesljivo približuje neki majhni konstanti, to pomeni, da je vse v redu. Zakaj kljub temu obstajajo razhajanja? Ker se zapis v ločeni različici zgodi nekoliko prej kot v klasterju, in z mikro zamikom se lahko podatki razhajajo. Preostalo je le še preveriti dnevnike razhajanja, in če so vsi razumljivi zaradi neatomarnosti zapisa, lahko gremo naprej.
- Zdaj lahko obrnemo dry-mode. Pisali in brali bomo iz klasterja, in podvajali v ločeno različico. Zakaj? V naslednjem tednu želimo opazovati delovanje klasterja. Če se izkaže, da so ob takratnih obremenitvah težave ali pa smo kaj spregledali, imamo vedno možnost vračanja na staro kodo s trenutnimi podatki, zahvaljujoč dry-mode.
- Preostalo je le še izključiti dry-mode in odstraniti ločeno različico.
Ekspertiza
Najprej na kratko o delovanju klasterja.
Najprej, Redis je key-value shranjevanje. Kot ključ se uporabljajo poljubne nize. Kot vrednosti se lahko uporabljajo številke, nizi in celotne strukture. Teh je nešteto, vendar za razumevanje splošne strukture to ni pomembno.
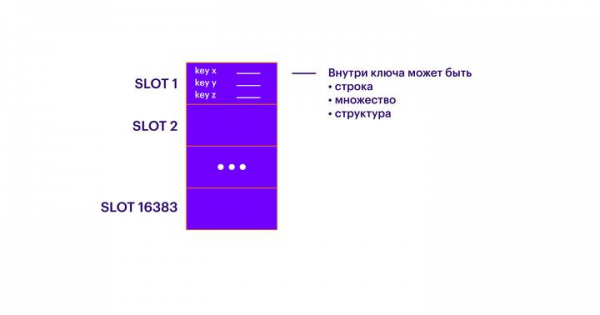
Naslednji nivo abstrakcije po ključih so reže (SLOTS). Vsak ključ pripada enemu od 16.383 rež. Znotraj vsake reže lahko obstaja neomejeno število ključev. Tako so vsi ključi razdeljeni na 16.383 nepreglednih množic.
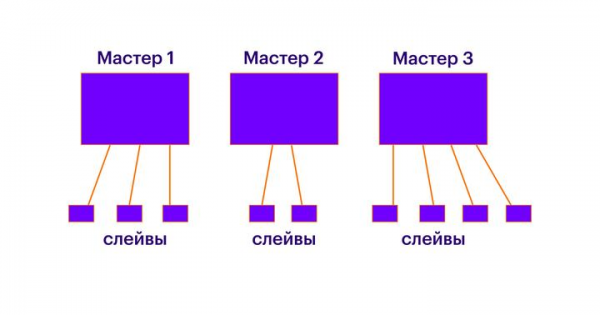
Nadalje, v klastru mora biti N master vozlišč. Vsako vozlišče lahko obravnavamo kot ločen instančni Redis, ki ve vse o drugih vozliščih znotraj klastre. Vsaka master vozlišče vsebuje določeno število rež. Vsaka rež pripada samo eni master vozlišču. Vse reže je potrebno razporediti med vozlišča. Če določene reže niso razporejene, ključi, shranjeni v njih, ne bodo dostopni. Vsako master vozlišče je smiselno zagnati na ločeni logični ali fizični napravi. Prav tako je treba upoštevati, da vsako vozlišče deluje samo na enem jedru, in če želite na eni logični napravi zagnati več instanc Redis, se prepričajte, da delujejo na različnih jedrih (sami nismo tega preizkusili, a teoretično bi moralo delovati). V bistvu master vozlišča zagotavljajo običajno razdelitev, in večje število master vozlišč omogoča skaliranje pisnih in bralnih poizvedb.
Ko so vsi ključi razporejeni po režah, in so reže razporejene med master vozlišča, lahko vsaki master vozlišču dodamo poljubno število slave vozlišč. Znotraj vsakih takih povezav "master-slave" deluje običajna replikacija. Slaves so potrebni za skaliranje bralnih poizvedb in za preklapljanje v primeru okvare master vozlišča.
Zdaj se pogovorimo o operacijah, ki bi jih bilo dobro znati izvesti.
Do sistema se bomo obrnili preko Redis-CLI. Ker Redis nima enotne točke vstopa, je možno izvajati naslednje operacije na katerem koli vozlišču. V vsakem odstavku posebej poudarjam možnost izvajanja operacije pod obremenitvijo.
- Prva in najpomembnejša stvar, ki jo potrebujemo: operacija cluster nodes. Ta vrne stanje klasterja, prikaže seznam vozlišč, njihove vloge, razporeditev rež itd. Dodatne informacije lahko pridobimo s pomočjo cluster info in cluster slots.
- Bilo bi dobro moći dodavati i uklanjati čvorove. Za to postoje operacije cluster meet i cluster forget. Obratite pozornost da cluster forget treba primijeniti na SVAKI čvor, kako na mastere, tako i na replike. A cluster meet treba pozvati samo na jednom čvoru. Ova razlika može zbuniti, pa je bolje upoznati se s njom prije nego što pokrenete klaster u proizvodnji. Dodavanje čvora se sigurno vrši u radu i nikako ne utječe na funkcioniranje klastera (što je logično). Ako planirate ukloniti čvor iz klastera, trebate se uvjeriti da na njemu nema slotova (inače riskirate gubitak pristupa svim ključevima na tom čvoru). Također, ne uklanjajte master koji ima slave, inače će se provoditi bespotrebno glasanje za novog mastera. Ako na čvorovima već nema slotova, to je manji problem, ali zašto bismo imali suvišne izbore kada možemo prvo ukloniti slave.
- Ako je potrebno silom zamijeniti master i slave, može se koristiti naredba cluster failover. Pozivajući je u radu, treba shvatiti da će master biti nedostupan tijekom izvršavanja operacije. Obično prebacivanje traje manje od sekunde, ali nije atomsko. Možete računati da će dio zahtjeva prema masteru u tom trenutku završiti s greškom.
- Preden odstranite vozlišče iz klasterja, na njem ne sme ostati nobenih rež. Najbolje jih je prenesti z ukazom cluster reshard. Reže bodo prenesene z enega mojstra na drugega. Celoten postopek lahko traja nekaj minut, odvisno od količine prenesenih podatkov, vendar je proces prenosa varen in ne vpliva na delovanje klasterja. Tako lahko vse podatke prenesete z enega vozlišča na drugo med obremenitvijo, ne da bi skrbeli za njihovo dostopnost. Vendar obstajajo tudi nekatere nianse. Prvič, prenos podatkov obremeni tako prejemno kot pošiljateljsko vozlišče. Če je prejemno vozlišče že močno obremenjeno z obdelavo, ga ne obremenjujte še z novimi podatki. Drugič, takoj ko na pošiljateljskem mojstru ne bo več nobenih rež, bodo vsi njegovi slavi takoj prešli k mojstru, na katerega so bile te reže prenesene. In težava je v tem, da si vsi ti slavi hkrati želijo sinhronizirati podatke. Imate še srečo, če bo to delna, ne pa popolna sinhronizacija. Upoštevajte to in kombinirajte operacije prenosa rež in izklopa/prenosa slavov. Ali pa upajte, da imate dovolj rezerve.
- Kaj storiti, če med prenosom odkrijete, da ste kje izgubili reže? Upam, da vas ta težava ne bo zajela, toda če že, obstaja operacija cluster fix. Ta slabo in dobro razprši reže po vozliščih naključno. Priporočam, da preverite njeno delovanje, preden iz klasterja odstranite vozlišče z razporejenimi režami. Ker podatki v nerazporejenih režah nekako niso dostopni, je skrb za težave z dostopnostjo teh rež že prepozna. Na razporejene reže ta operacija ne bo vplivala.
- Še ena koristna operacija je monitor. Ta omogoča v realnem času videti celoten seznam poizvedb, ki prihajajo na vozlišče. Kar je še boljše, po njej lahko izvedete grep in izveste, ali obstaja potreben promet.
Prav tako je vredno omeniti postopek preklopa mojstra. Na kratko: obstaja, in po mojem mnenju deluje odlično. Vendar pa ne mislite, da bo Redis takoj preklopil in stranke ne bodo opazile izgube, če iztaknete vtič na napravi z mojstrsko vozlišče. Po mojih izkušnjah preklop traja nekaj sekund. V tem času bodo nekateri podatki nedostopni: zazna se nedostopnost mojstra, vozlišča glasujejo za novega, slavi se preklapljajo, podatki se sinhronizirajo. Najboljši način, da se sami prepričate, da shema deluje, je, da izvedete lokalna usposabljanja. Postavite klaster na svojem prenosniku, dajte minimalno obremenitev, simulirajte padec (na primer, tako, da blokirate porte) in ocenite hitrost preklopa. Po mojem mnenju lahko le z dvodnevnim igranjem takšne vrste postanete prepričani v delovanje tehnologije. No, ali pa upate, da programska oprema, ki jo uporablja polovica interneta, zagotovo deluje.
Конфигурация
Pogosto je konfiguracija prva stvar, ki jo potrebujemo za začetek dela z orodjem. Ko vse deluje, pa se ne želimo več dotikati konfiguracije. Potrebna je določena prizadevanja, da se prisilimo vrniti k nastavitvam in jih skrbno pregledati. Po mojem spominu smo imeli vsaj dva resna spodrsljaja zaradi nepazljivosti do konfiguracije. Bodite še posebej pozorni na naslednje točke:
- timeout 0
Čas, po katerem se zaprejo neaktivne povezave (v sekundah). 0 — se ne zaprejo.
Ne glede na to, da naše knjižnice niso vse znale pravilno zapirati povezav. Če izklopimo to nastavitev, tvegamo, da bomo dosegli omejitev števila strank. Po drugi strani pa, če takšna težava obstaja, bo samodejno prekinjanje izgubljenih povezav to prikrilo, in morda ne bomo opazili. Poleg tega te nastavitve ne smete vključevati pri uporabi persist-ponižanj. - Save x y & appendonly yes
Shranjevanje RDB-posnetka.
Težave RDB/AOF bomo podrobno obravnavali spodaj. - stop-writes-on-bgsave-error no & slave-serve-stale-data yes
Če je vključeno, bo mojster prenehal sprejemati zahteve za spremembo ob napaki RDB-posnetka. Če se povezava z mojstrom izgubi, lahko slave še naprej odgovarja na zahteve (yes). Ali pa preneha odgovarjati (no).
Ni nam všeč situacija, kjer Redis postane buča. - repl-ping-slave-period 5
Po tem času bomo začeli skrbeti, da je mojster odpovedal in je čas za izvajanje postopka failover.
Ravno tako bo potrebno ročno iskati ravnotežje med lažnimi alarmi in zagonim failover. Po našem izkušnjah je to 5 sekund. - repl-backlog-size 1024mb & epl-backlog-ttl 0
Točno toliko podatkov lahko hranimo v predpomnilniku za odpadlo replico. Če se predpomnilnik izprazni, se bo potrebno popolnoma sinhronizirati.
Praksa kaže, da je bolje nastaviti nekoliko večjo vrednost. Razlogov, zakaj lahko republika začne zamujati, je dovolj. Če zamujate, je velika verjetnost, da že vaš mojster komaj zmore, in popolna sinhronizacija bo zadnja kaplja. - maxclients 10000
Največje število hkrati povezanih strank.
Po naših izkušnjah je bolje nastaviti večjo vrednost. Redis odlično obvlada 10 tisoč povezav. Le poskrbite, da bo v sistemu dovolj rež. - maxmemory-policy volatile-ttl
Pravilnik, po katerem se ključi brišejo, ko dosežemo omejitev razpoložljive pomnilnika.
Tukaj ni pomembno samo pravilo, temveč razumevanje, kako bo to potekalo. Redis zasluži pohvalo za sposobnost, da brez težav deluje pri doseganju omejitve pomnilnika.
Težave RDB in AOF
Čeprav sam Redis shranjuje vse informacije v delovnem pomnilniku, obstaja tudi mehanizem za shranjevanje podatkov na disk. Natančneje, tri mehanizme:
- RDB-snapshot — popoln posnetek vseh podatkov. Nastavi se z konfiguracijo SAVE X Y in bere kot "Shrani popoln posnetek vseh podatkov vsakih X sekund, če se je spremenil vsaj Y ključev."
- Append-only file — seznam operacij v zaporedju njihovega izvajanja. Dodaja nove prihajajoče operacije v datoteko vsakih X sekund ali po Y operacijah.
- RDB in AOF — kombinacija dveh prejšnjih.
Vsaka metoda ima svoje prednosti in slabosti, ne bom jih našteval vseh, le opozoril bom na manj očitne, po mojem mnenju, vidike.
Prvič, za shranitev RDB-snapshot je potrebno poklicati FORK. Če je podatkov veliko, lahko to obremeni celoten Redis za obdobje od nekaj milisekund do sekunde. Poleg tega sistem potrebuje dodeliti pomnilnik za tak snapshot, kar privede do potrebe po dvojni rezervi delovnega pomnilnika na logični napravi: če je za Redis namenjenih 8 GB, mora biti na virtualni napravi na voljo 16.
Po drugi strani se pojavljajo težave s parcialno sinhronizacijo. V načinu AOF, ko se slavni strežnik ponovno poveže, se lahko namesto parcialne sinhronizacije izvede popolna. Zakaj se to dogaja, mi ni uspelo razumeti. Vendar se je o tem vredno spomniti.
Ti dve točki že pripeljeta do razmišljanja, ali so ti podatki res potrebni na disku, če se že vse podvaja s slavnimi strežniki. Podatke je mogoče izgubiti le, če vsi slavni strežniki odpovejo, kar je problem na ravni 'požar v podatkovnem centru'. Kot kompromis lahko predlagamo shranjevanje podatkov le na slavnih strežnikih, vendar je v tem primeru treba zagotoviti, da ti strežniki nikoli ne postanejo glavni pri nujnem okrevanju (za to je nastavitev prioritet slavnimi strežniki v njihovi konfiguraciji). V vsakem posameznem primeru se sprašujemo, ali je smiselno shraniti podatke na disk, in večinoma odgovarjamo 'ne'.
Zaključek
Na koncu upam, da sem dal splošen pregled delovanja redis-clustra za tiste, ki o njem še niso slišali, ter izpostavil nekatere očitne vidike za tiste, ki ga že dolgo uporabljajo.
Hvala za vaš čas in kot vedno so komentarji na temo dobrodošli.
Izvor: habr.com
