

Uvod
Pozdrav!
V tem članku bom delil izkušnje pri gradnji mikroservisne arhitekture za projekt, ki uporablja nevronske mreže.
Pogovorili bomo o zahtevah za arhitekturo, si ogledali različne strukturne diagrame, razpravljali o vsakem od komponent končne arhitekture in ocenili tehnične metrike rešitve.
Uživajte v branju!
Nekaj besed o nalogi in njenem rešenju
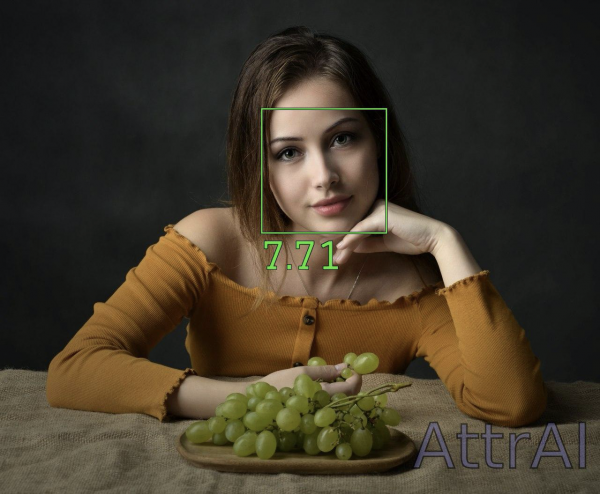
Osnovna ideja je, da na podlagi fotografij ocenimo privlačnost osebe na desetstopenjski lestvici.
V tem članku se bomo odmaknili od opisovanja tako uporabljenih nevronskih mrež kot tudi procesa priprave podatkov in učenja. Vendar pa se bomo v eni izmed naslednjih objav zagotovo vrnili k razpravi o cevem sistemu ocene na poglobljeni ravni.
Trenutno bomo na visoki ravni preleteli cevi sistem ocene, pri čemer se bomo osredotočili na interakcijo mikroservisov v okviru celotne arhitekture projekta.
Pri delu na cevi sistema ocene privlačnosti je bila naloga razdeljena na naslednje sestavne dele:
- Izločanje obrazov na fotografijah
- Ocena vsakega obraza
- Prikaz rezultata
Prvo nalogo rešuje predhodno usposobljena . Za drugo je bila usposobljena konvolucijska nevronska mreža na PyTorchu, pri čemer je bila uporabljena – s poudarkom na ravnotežju "kakovost / hitrost inference na CPU".
Funkcionalni diagram cevi sistema ocene
Analiza zahtev za arhitekturo projekta
V življenjskem ciklu projekti so faze dela na arhitekturi in avtomatizaciji uvajanja modela pogosto med najbolj zamudnimi po času in virih.
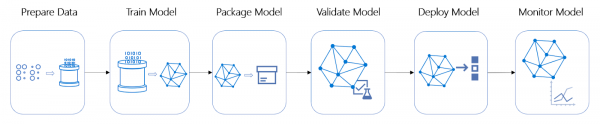
Življenjski cikel ML projekta
Ta projekt ni izjema – sprejeta je bila odločitev, da se cevni sistem ocene ovije v spletno storitev, pri čemer je bilo potrebno poglobiti se v arhitekturo. Določene so bile naslednje osnovne zahteve:
- Enotno skladišče dnevnikov – vsi servisi morajo beležiti dnevnike na eno mesto, ki naj bi jih bilo enostavno analizirati.
- Možnost horizontalnega skaliranja storitve ocene – kot najverjetnejši Bottleneck.
- Na oceno vsake fotografije je treba dodeliti enako število procesorskih virov – da se izognemo odstopanjem v porazdelitvi časa na inference.
- Hitro (ponovno) uvajanje tako konkretnih storitev kot tudi celotnega sklada.
- Možnost, po potrebi, uporabe skupnih objektov v različnih storitvah.
Arhitektura
Po analizi zahtevov je postalo očitno, da mikroservisna arhitektura v večini primerov ustreza skoraj popolnoma.
Da bi se izognili nepotrebnim težavam, je bila za frontend izbrana Telegram API.
Za začetek si oglejmo strukturni diagram končne arhitekture, nato pa se bomo podali v opis posameznih komponent in formalizirali postopek uspešnega obdelovanja slik.
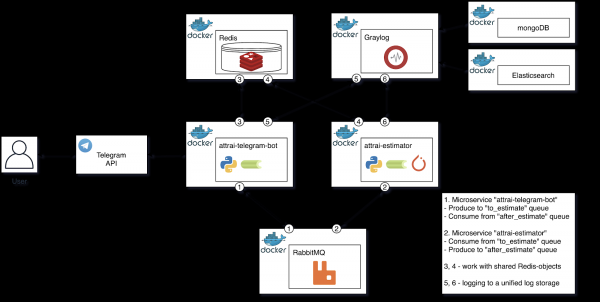
Strukturni diagram končne arhitekture
Podrobneje se bomo pogovorili o vsaki komponenti diagrama, označili bomo njihovo enotno odgovornost v procesu ocenjevanja slik.
Mikroservis „attrai-telegram-bot“
Ta mikroservis inkapsulira vse interakcije z Telegram API. Lahko izpostavimo dva glavna scenarija – delo s slikami uporabnikov in delo z rezultatom procesiranja ocenjevanja. Obe scenariju bosta predstavljeni na splošno.
Ob prejemu uporabniškega sporočila s sliko:
- Izvaja se filtriranje, ki vključuje naslednje preverjanja:
- Obstoja optimalne velikosti slike
- Števila slik uporabnika, ki so že v čakalni vrsti
- Ob uspešnem prehodu začetne filtracije se slika shranjuje v docker volume
- V čakalno vrsto “to_estimate” se posreduje naloga, ki vsebuje tudi pot do slike, ki leži v našem volumnu
- Če so zgoraj navedeni koraki uspešno zaključeni – uporabnik bo prejel sporočilo z okvirnim časom obdelave slike, ki se izračuna na podlagi števila nalog v čakalni vrsti. V primeru napake bo uporabnik jasno obveščen – z pošiljanjem sporočila z informacijami o tem, kaj bi lahko šlo narobe.
Poleg tega ta mikroservis, kot celery worker, posluša čakalno vrsto „after_estimate“, namenjeno nalogam, ki so prešle skozi proces ocenjevanja.
Ob prejemu nove naloge iz “after_estimate”:
- Če je bila slika uspešno obdelana – pošljemo rezultat uporabniku, sicer ga obvestimo o napaki
- Izbrišemo sliko, ki je rezultat procesa ocenjevanja
Mikroservis za ocenjevanje „attrai-estimator“
Ta mikroservis je celery worker in inkapsulira vse, kar je povezano s procesom ocenjevanja slike. Algoritem dela je en sam – razložimo ga.
Ob prejemu nove naloge iz “to_estimate”:
- Sliko preusmerimo skozi proces ocenjevanja:
- Naložimo sliko v spomin
- Prilagodimo sliku na odgovarajuću veličinu
- Pronalaženje svih lica (MTCNN)
- Procjenjujemo sva lica (omotamo pronađena lica iz prethodnog koraka u grupu i izvršavamo inference pomoću ResNet34)
- Renderujemo konačnu sliku
- Crtamo bounding boxeve
- Crtamo procjene
- Brišemo korisničku (izvorno) sliku
- Spremamo izlaz iz procjenske cevi
- Stavljamo zadatak u red “after_estimate”, koji sluša razrađeni mikroslužbeni “attrai-telegram-bot”
Graylog (+ mongoDB + Elasticsearch)
— je rešenje za centralizovano upravljanje logovima. U ovom projektu, korišćen je za svoju pravu svrhu.
Izbor je pao baš na njega, a ne na svima poznati stack, zbog praktičnosti rada sa njim iz Pythona. Sve što je potrebno za logiranje u Graylog, je da dodate GELFTCPHandler iz paketa ostalim root logger handlerima našeg python mikroservisa.
Ja, kao osoba koja je pre radila samo sa ELK stackom, u suštini sam imao pozitivno iskustvo tokom rada sa Graylogom. Jedino što odbija su prednosti Kibane nad web-interfejsom Grayloga.
RabbitMQ
— je posrednik poruka na osnovu AMQP protokola.
U ovom projektu korišćen je kao posrednik za Celery i radio je u durable režimu.
Redis
— je NoSQL DBMS koja radi sa strukturama podataka tipa ‘ključ — vrednost’
Ponekad se pojavljuje potreba za korišćenjem zajedničkih objekata u različitim python mikroservisima, koji implementiraju određene strukture podataka.
Na primer, u Redis-u se čuva hashmap tipa ‘telegram_user_id => broj aktivnih zadataka u redu’, što omogućava ograničavanje broja zahteva od jednog korisnika na određenu vrednost i tako sprečava DoS napade.
Formalizujemo proces uspešne obrade slike
- Korisnik šalje sliku telegram botu
- “attrai-telegram-bot” prima poruku od Telegram API i obrađuje je
- Zadatak sa slikom se dodaje u asinhronu grupu ‘to_estimate’
- Korisnik prima poruku sa planiranim vremenom procene
- “attrai-estimator” uzima zadatak iz reda ‘to_estimate’, prolazi kroz procenjivačku cev i šalje zadatak u red ‘after_estimate’
- “attrai-telegram-bot”, koji sluša red ‘after_estimate’, šalje rezultat korisniku
DevOps
Na kraju, nakon pregleda arhitekture, možemo preći na ne manje zanimljiv deo — DevOps
Docker Swarm
— sistem za klasterizaciju, čija je funkcionalnost implementirana unutar Docker Engine i dostupna iz kutije.
Pomoću „roja“, sve node našeg klastera mogu se podeliti u 2 tipa – worker i manager. Na mašinama prvog tipa se pokreću grupe kontejnera (stackovi), dok mašine drugog tipa obavljaju skaliranje, ravnotežu i . Menadžeri su po defaultu takođe i radnici.
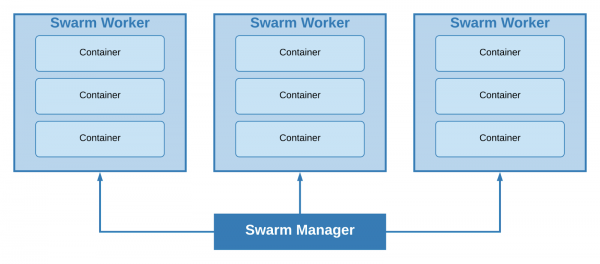
Klaster s jednim leader managerom i tri radnika
Minimalna veličina klastera je 1 node, jedina mašina će istovremeno biti i leader manager i worker. U zavisnosti od veličine projekta i minimalnih zahteva za otpornosti na greške, odlučeno je da se koristi ovakav pristup.
Zabranjujući unapred, mogu reći da od prve produkcijske isporuke, koja je bila sredinom juna, nije bilo problema vezanih za ovu organizaciju klastera (ali to ne znači da je takva organizacija uopšte prihvatljiva za bilo koje srednje-velike projekte koji imaju zahteve za otpornost na greške).
Docker Stack
U režimu „roja“ za implementaciju stackova (skupova docker servisa) odgovara
Podržava docker-compose konfiguracije, omogućavajući dodatnu upotrebu deploy parametara.
Na primer, pomoću ovih parametara su ograničeni resursi za svaku od instanci mikrosistema za procenu (dodeljući na N instanci N jezgara, a u samom mikrosistemu ograničavamo broj jezgara koje koristi PyTorch, na jedan)
attrai_estimator:
  image: 'erqups/attrai_estimator:1.2'
  deploy:
    replicas: 4
    resources:
      limits:
        cpus: '4'
    restart_policy:
      condition: on-failure
      …
Važno je napomenuti da su Redis, RabbitMQ i Graylog — stateful servisi i skaliranje njih nije tako jednostavno kao „attrai-estimator“.
Predviđajući pitanje — zašto ne Kubernetes?
Izgleda da je korišćenje Kubernetes-a u projektima malog i srednjeg obima — prekomerno opterećenje, sav potrebni funkcionalnost može se dobiti od Docker Swarm, koji je prilično user friendly za orkestrator kontejnera, a takođe ima nizak prag ulaska.
Infrastruktura
Sve to je implementirano na VDS sa sledećim karakteristikama:
- CPU: 4 jezgara Intel® Xeon® Gold 5120 CPU @ 2.20GHz
- RAM: 8 GB
- SSD: 160 GB
Nakon lokalnog stres testiranja, delovalo je da će ova mašina biti na granici kapaciteta prilikom ozbiljnog povećanja korisnika.
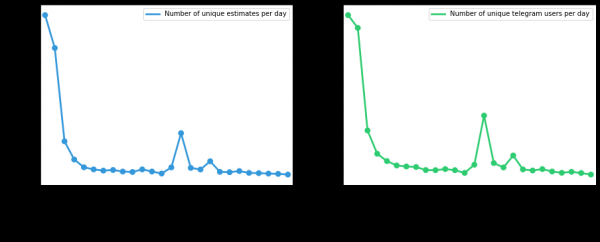
Immediately after the deployment, I posted a link to one of the most popular image boards in the CIS (yes, that one), after which people became interested, and within a few hours, the service successfully processed tens of thousands of images. At peak moments, the CPU and RAM resources were not even used halfway.
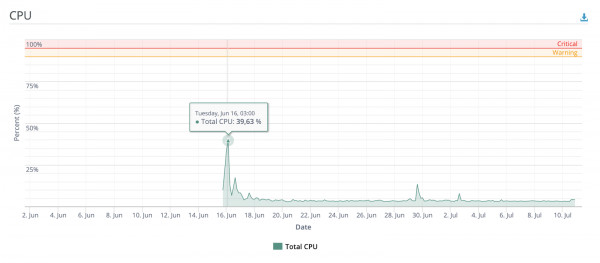
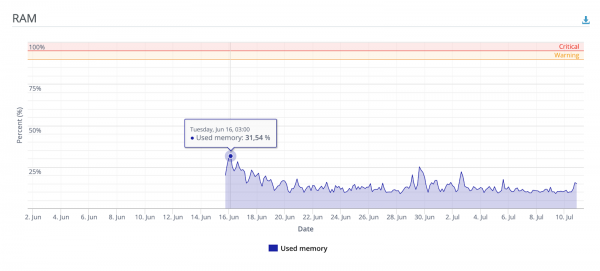
A bit more graphics
The number of unique users and assessment requests since deployment, depending on the day
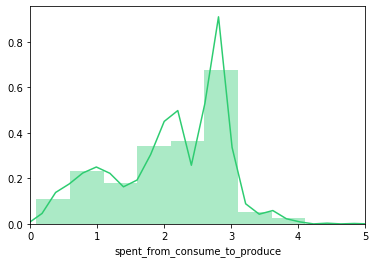
Distribution of inference time for the assessment pipeline
Zaključki
In summary, I can say that the architecture and approach to container orchestration have fully justified themselves — even during peak moments, there were no crashes or delays in processing time.
I believe that small and medium-sized projects using real-time inference of neural networks on CPUs can successfully adopt the practices described in this article.
I would like to add that the original article was longer, but to avoid posting a long read, I decided to omit some points — we will return to them in future publications.
You can poke the bot in Telegram — @AttraiBot, it will be operational at least until the end of autumn 2020. I remind you — no user data is stored — neither the original images nor the results of the assessment pipeline — everything is deleted after processing.
Izvor: habr.com
