

Uvod v operacijske sisteme
Pozdravljeni, Habr! Želim vam predstaviti serijo prevodnih člankov, ki se mi zdijo zanimivi — OSTEP. V tem gradivu se poglobljeno obravnava delovanje unix-podobnih operacijskih sistemov, in sicer obravnava procesov, različnih pojedinškov, pomnilnika in ostalih podobnih komponent, ki sestavljajo sodobni OS. Izvirnik vseh gradiv si lahko ogledate tukaj. . Prosimo, upoštevajte, da je prevod izveden nepoklicno (dokaj prosto), a upam, da sem ohranil splošen smisel.
Laboratorijske vaje za to temo lahko najdete tukaj:
Druge dele:
Lahko tudi obiščete moj kanal v =)
Planlegging: Multi-Level Feedback Queue
I denne forelesningen skal vi snakke om problemene ved å utvikle en av de mest kjente tilnærmingene til
planlegging, som kalles Multi-Level Feedback Queue (MLFQ). MLFQ-scheduler ble først beskrevet i 1962 av Fernando J. Corbató i et system kalt
Compatible Time-Sharing System (CTSS). Dette arbeidet (inkludert senere arbeider om
Multics) ble senere nominert til Turing Award. Scheduler ble
senere forbedret og fikk en form som kan finnes i
noen moderne systemer.
MLFQ-algoritmen prøver å løse to grunnleggende overlappende problemer.
Najprej,, den prøver å optimalisere gjennomløpstiden, som vi så på i forrige forelesning, optimalisert ved å kjøre de mest
korte oppgavene først. Imidlertid vet ikke OS hvor lenge en prosess vil kjøre, og dette
er nødvendig kunnskap for SJF- og STCF-algoritmene. Drugič, MLFQ prøver
å gjøre systemet responsivt for brukerne (for eksempel de som sitter og
stirer på skjermen i påvente av at oppgaven skal bli fullført) og dermed minimere responstiden. Dessverre reduserer algoritmer som RR responstiden, men har en ekstremt
dårlig påvirkning på gjennomløpstiden. Her er vårt problem: Hvordan designe
en scheduler som vil møte våre krav og samtidig ikke vite noe om
karakteren til prosessen generelt? Hvordan kan en scheduler lære seg oppgavekarakteristikkene,
og dermed ta bedre avgjørelser om planlegging?
Kjernen i problemet: Hvordan planlegge oppgavesetting uten perfekt kunnskap?
Hvordan utvikle en scheduler som samtidig minimerer responstiden
for interaktive oppgaver og samtidig reduserer gjennomløpstiden uten avgjørende
kunnskap om oppgavens kjøretid?
Merknad: Lærer av tidligere hendelser
MLFQ-køen er et glimrende eksempel på et system som lærer av
tidligere hendelser for å forutsi fremtiden. Slike tilnærminger er ofte
vanlige i OS (og mange andre områder innen databehandling, inkludert fils
forutsigelser i maskinvare og caching-algoritmer). Slike tilnærminger
virker når oppgavene har atferdsfaser og dermed er forutsigbare.
срабатывают, когда у задач есть поведенческие фазы и таким образом они предсказуемы.
Vendar je s to tehniko treba biti previden, saj so napovedi lahko zelo enostavne
in lahko privedejo do slabših odločitev kot pa
bi bile brez znanja sploh.
MLFQ: Osnovna pravila
Poglejmo osnovna pravila algoritma MLFQ. Čeprav obstaja več realizacij tega algoritma,
so osnovni pristopi podobni.
V tisti realizaciji, ki jo bomo obravnavali, bo MLFQ imela več
ločene vrste, vsaka bo imela različno prednost. Ob vsakem trenutku
je naloga, ki je pripravljena za izvajanje, v eni od vrst. MLFQ uporablja prednostne
za odločanje, katero nalogo zagnati za izvajanje, tj. naloga z višjo
prednostjo (naloga iz vrste z višjo prednostjo) se bo izvedla prva.
Seveda lahko v določeni vrsti obstaja več kot ena naloga, tako
da imajo enako prednost. V tem primeru bo uporabljen mehanizem
RR za načrtovanje izvajanja med temi nalogami.
Tako pridemo do dveh osnovnih pravil za MLFQ:
Pravilo 1: Če je prednost(A) > Prednost(B), se izvede naloga A (B ne bo)
- Pravilo 2: Če je prednost(A) = Prednost(B), A in B se izvajata z uporabo RR
- Na podlagi zgoraj navedenega so ključni elementi pri načrtovanju MLFQ
prednosti. Namesto da bi dodelili fiksno prednost vsaki
nalogi, MLFQ spreminja njeno prednost glede na opazovano obnašanje.
Na primer, če naloga nenehno prekine delo na CPU in čaka na vnos z tipkovnice,
bo MLFQ ohranjal prednost procesa na visoki ravni, ker tako
mora delovati interaktiven proces. Če pa naloga stalno in
intenzivno uporablja CPU dolgo časa, bo MLFQ zmanjšal njeno
prednost. Tako bo MLFQ preučeval obnašanje procesov med njihovim delom
in uporabljal to obnašanje.
Narisi primer, kako bi lahko izgledale vrste v nekem trenutku
in rezultat bi bil nekaj takega:
V tem diagramu sta procesa A in B v vrsti z najvišjo prednostjo. Proces
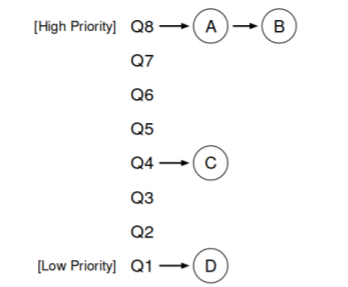
C je nekje v sredini, proces D pa na koncu vrste. V skladu z zgoraj navedenimi
opisi algoritma MLFQ bo načrtovalnik izvajal naloge le z najvišjo
prednostjo.
prioriteto v skladu z RR, medtem ko naloge C in D ne bodo obravnavane.
Seveda statičen posnetek ne bo dal popolne slike, kako deluje MLFQ.
Pomembno je razumeti, kako se slika dejansko spreminja skozi čas.
Poskus 1: Kako spremeniti prednost
V tem trenutku je treba odločiti, kako bo MLFQ spreminjal raven prioritet
nalog (in tako tudi položaj naloge v vrsti) skozi njen življenjski cikel. Za
to je potrebno imeti v mislih delovni postopek: določeno število
interaktivnih nalog z kratkim časom obdelave (in s tem pogosto sproščanje
CPU) in nekaj dolgih nalog, ki uporabljajo CPU ves svoj delovni čas, pri čemer
je čas odziva za take naloge nepomemben. Tako lahko poskusimo
izvesti algoritem MLFQ s sledečimi pravili:
- Pravilo 3: Ko naloga vstopi v sistem, je nameščena v čakalno vrsto z najvišjim
- prioriteto.
- Pravilo 4a: Če naloga v celoti izkoristi dodeljen časovni okvir, se njen
- prioriteta zniža.
- Pravilo 4b: Če naloga sprosti CPU pred potekom svojega časovnega okvirja, ostane
- s prejšnjim prioritetom.
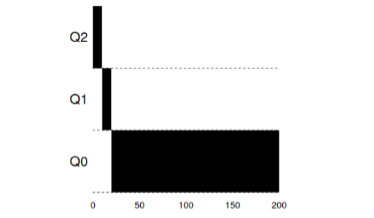
Primer 1: Enotna dolgo delujoča naloga
Kot je razvidno v tem primeru, se naloga ob vstopu postavi z najvišjim
prioritetom. Po časovnem okviru 10 ms se prioriteta zniža
z načrtovalnikom. Po naslednjem časovnem okviru se naloga končno zniža na
najnižjo prioriteto v sistemu, kjer tudi ostane.
Primer 2: Novo kratko nalogo
Sedaj si poglejmo primer, kako bo MLFQ poskušal pristopiti k SJF. V tem
primeru sta dve nalogi: A, ki je dolgotrajna naloga, ki nenehno
zaseda CPU, in B, ki je kratka interaktivna naloga. Predpostavimo,
da je A že deloval nekaj časa, ko je naloga B vstopila.
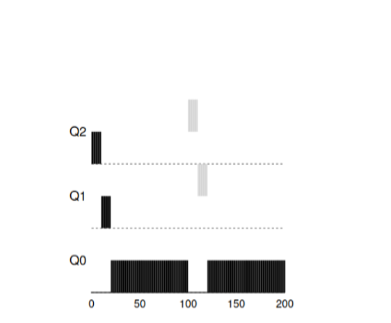
Na tej grafiki so prikazani rezultati scenarija. Naloga A, kot katerakoli naloga,
ki uporablja CPU, se je znašla na dnu. Naloga B bo prišla ob T=100 in bo
postavljena v čakalno vrsto z najvišjim prioritetom. Ker je njen čas obdelave kratek,
se bo zaključila, preden doseže zadnjo čakalno vrsto.
Iz tega primera je treba razumeti glavni cilj algoritma: ker algoritem ne
ve, ali je naloga dolga ali kratka, predpostavlja, da je naloga
kratka i joj daje najviši prioritet. Ako je ovo zaista kratka zadaća,
ona će se brzo izvršiti, inače, ako je dugotrajna zadaća, ona će se polako kretati
nadole po prioritetu i uskoro će dokazati da je to zaista duga zadaća koja ne
zahteva odziv.
Primer 3: Šta je sa ulazom-izlazom?
Sada pogledajmo primer sa ulazom-izlazom. Kako je navedeno u pravilu 4b,
ako proces oslobodi procesor, ne koristeći potpuno svoje procesorsko vreme,
onda ostaje na prethodnom nivou prioriteta. Namere ovog pravila su prilično jednostavne
- ako interaktivni zadatak vrši mnogo operacija ulaza-izlaza, na primer, čekajući
na pritiske dugmadi ili miša od korisnika, takav zadatak će osloboditi procesor
pre ranije dodeljenog vremena. Ne bismo želeli da smanjimo prioritet takvom zadatku,
pa će tako ostati na prethodnom nivou.
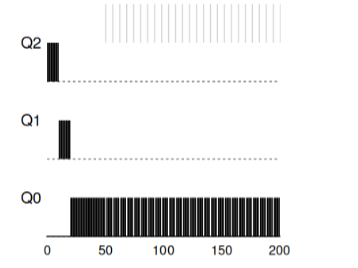
Ovaj primer pokazuje kako će algoritam raditi sa takvim procesima - interaktivni zadatak B, koji treba CPU samo na 1ms pre izvršenja
procesa ulaza-izlaza i dugotrajni zadatak A, koji koristi sve vreme CPU-a.
MLFQ drži proces B sa najvišim prioritetom, jer stalno
oslobađa CPU. Ako je B interaktivni zadatak, tada algoritam u ovom slučaju postiže
svoj cilj da brzo pokreće interaktivne zadatke.
Problemi sa trenutnim algoritmom MLFQ
U prethodnim primerima izgradili smo osnovnu verziju MLFQ. Čini se da on
dobro obavlja svoj posao, pošteno raspodeljujući procesorsko vreme između
dugih zadataka i omogućavajući kratkim zadacima ili zadacima koji intenzivno koriste
ulaz-izlaz da se brzo izvršavaju. Nažalost, ovaj pristup ima nekoliko
ozbiljnih problema.
Najprej,, problem gladi: ako u sistemu bude mnogo interaktivnih
zadataka, oni će trošiti sav procesorski vreme i tako nijedna duga
zadatak neće dobiti priliku da se izvršava (gladni su).
Drugič, pametni korisnici mogli bi pisati svoje programe tako da
obmanu planirača. Prevara se sastoji u tome da se uradi nešto da bi se nateralo
planirač da dodeli procesu više procesorskog vremena. Algoritam koji
opisano zgoraj je popolnoma ranljivo za take napade: preden časovno okno praktično
počne treba izvesti operacijo vhod-izhod (na nek, nepomemben datoteko)
in na ta način osvoboditi CPU. Takšno vedenje bo omogočilo, da ostane v istem
vrstnem redu in znova pridobi večji delež procesorskega časa. Če to naredimo
pravilno (na primer, izvajati 99% časa okna pred osvoboditvijo CPU),
takšna naloga lahko preprosto monopilizira procesor.
Nazadnje, program lahko spremeni svoje vedenje s časom. Tiste naloge,
ki so uporabljale CPU, lahko postanejo interaktivne. V našem primeru take
naloge ne bodo prejele ustrezne obravnave s strani načrtovalnika, saj bi dobile druge
(prvotne) interaktivne naloge.
Vprašanje za dvorano: katere napade na načrtovalnik bi lahko izvedli v sodobnem svetu?
Poskus 2: Povečanje prioritete
Poskusimo spremeniti pravila in vidimo, ali se lahko izognemo težavam z
lakoto. Kaj bi lahko storili, da zagotovimo, da naloge povezane z
CPU prejemajo svoj čas (tudi če ne dolgo).
Kot preprosta rešitev problema lahko predlagamo občasno
povečanje prioritete vseh takih nalog v sistemu. Obstaja več načinov
za dosego tega, poskusimo uresničiti nekaj preprostega: prevesti
takoj vse naloge v najvišjo prioriteto, od tod novo pravilo:
- Rule5: Po preteku nekega obdobja S prenesite vse naloge v sistemu v najvišjo vrsto.
Naše novo pravilo rešuje dve težavi naenkrat. Prvič, procesi
zagotovljeno ne lakotijo: naloge, ki so v višji vrsti, bodo delile
procesorsko časovno obdobje v skladu z algoritmom RR, in tako bodo vsi procesi prejeli
procesorsko časovno obdobje. Drugič, če nek proces, ki je prej uporabljal
samo procesor, postane interaktiven, bo ostal v vrsti z višjo
prioriteto potem, ko enkrat pridobi povečanje prioritete do najvišje.
Oglejmo si primer. V tem scenariju bomo obravnavali en proces, ki uporablja
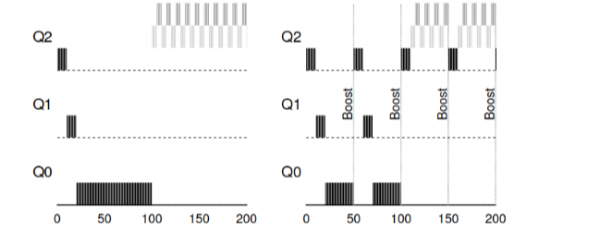
CPU in dva interaktivna, kratka procesa. Levo na sliki prikazan je način delovanja brez izboljšanja prioritete, zaradi česar dolga naloga začne stradati po prihodu dveh interaktivnih opravil v sistem. Na desni sliki se vsakih 50 ms izvede izboljšanje prioritete, kar zagotavlja, da vsa opravila prejmejo procesorski čas in se bodo občasno zagnala. 50 ms je v tem primeru izbrano kot primer, v resnici je ta številka nekoliko večja.
Očitno je, da dodajanje časa periodičnega izboljšanja S vodi do
logičnega vprašanja: katera vrednost naj bi bila nastavljena? Eden od priznanih
sistemskih inženirjev John Ousterhout je takšne veličine v sistemih imenoval voo-doo
konstanta, saj so v nekem pogledu zahtevala čarovnijo za pravilno
nastavitev. In, na žalost, S ima tak vonj. Če nastavite vrednost preveliko,
dolge naloge začnejo stradati. Če pa nastavite premajhno vrednost,
interaktivne naloge ne bodo prejele dovolj procesorskega časa.
Poskus 3: Najboljša evidenca
Zdaj imamo še en problem, ki ga je treba rešiti: kako preprečiti, da
bi naš načrtovalnik bil prevaran? Krivci za to možnost so
pravila 4a, 4b, ki omogočajo nalogi, da ohrani prednost, sprošča procesor
preden poteče dodeljeni čas. Kako se s tem spopasti?
Rešitev v tem primeru je lahko najboljša evidenca časa CPU na vsakem
nivou MLFQ. Namesto da pozabimo na čas, ki ga je program uporabil
procesor v dodeljenem obdobju, ga je treba upoštevati in shraniti. Potem ko
proces porabi dodeljeni čas, je treba njegov prioritetni nivo znižati na naslednjo
stopnjo prioritete. Zdaj ni pomembno, kako bo proces izkoristil svoj čas — kot
stalen izračun na procesorju ali kot več klicev. Tako je
treba pravilo 4 prepisati na naslednji način:
- Rule4: Ko je naloga porabila dodeljeni čas v trenutni vrsti (ne glede na to, kolikokrat je sprostila CPU), se prioritetna stopnja te naloge zniža (premakne se navzdol v vrsti).
Poglejmo primer:
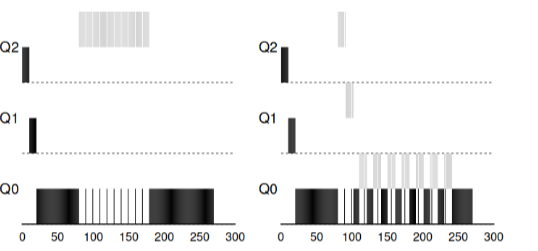 »
Na sliki je prikazano, kaj se zgodi, če poskusite prevarati načrtovalnik, kako
če bi bilo s prejšnjimi pravili 4a, 4b, bi dobili rezultat levo. Z novim
pravilom — rezultat desno. Pred zaščito je lahko vsak postopek povzročil I/O do konca in
tako prevzel CPU, po vključitvi zaščite, ne glede na obnašanje
I/O, bo vseeno padel v vrsto navzdol in tako ne bo mogel na nespoštljiv način
prevzeti CPU vire.
Izboljšamo MLFQ in druge težave
S navedenimi izboljšavami nastajajo nove težave: eno od glavnih
vprašanj je, kako parametrize takšen načrtovalnik? Tj. Koliko naj bi bilo
vrst? Kakšna naj bi bila velikost delovnega okna programa v okviru vrste? Kako
pogosto je treba dvigniti prioritet programa, da se izogne gladovni in
upošteva spremembe v obnašanju programa? Na ta vprašanja ni preprostega
odziva in samo poskusi z obremenitvami ter kasnejša konfiguracija
načrtovalnika lahko privedejo do zadovoljivega ravnotežja.
Na primer, večina izvedb MLFQ omogoča dodeljevanje različnih
časalnih intervalov različnim vrstam. Visokoprioritetne vrste imajo običajno
dodeljene kratke intervale. Te vrste vsebujejo interaktivne naloge,
med katerimi je preklapljanje precej občutljivo in naj traja 10 ali manj
ms. Nasprotno pa nizkoprioritetne vrste vsebujejo dolge naloge, ki uporabljajo
CPU. In v tem primeru dolgi časovni intervali dobro ustrezajo (100 ms).
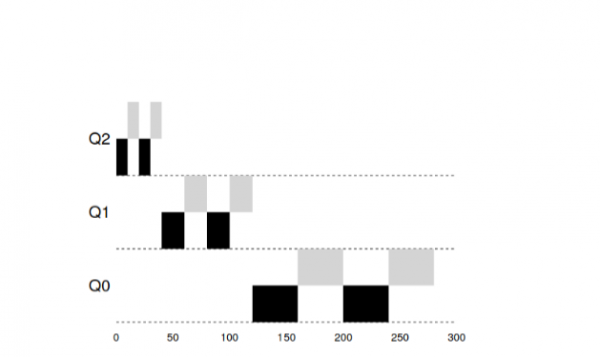
V tem primeru sta 2 nalogi delali v visokoprioritetni vrsti 20
ms, razdeljeni na okna po 10 ms. 40 ms v srednji vrsti (okno 20 ms) in pri nizkoprioritetni
vrsti je bil časovni interval 40 ms, kjer so naloge zaključile svoje delo.
Izvedba MLFQ v OS Solaris — razred načrtovalnikov, ki delijo čas.
Načrtovalnik omogoča niz tabel, ki natančno določajo, kako naj se
spremenijo prioritetni procesi skozi njihovo življenje, kakšna naj bi bila velikost
dodeljenega okna in kako pogosto je treba dvigniti prioritete naloge. Sistem
administrator lahko sodeluje s to tabelo in prisili načrtovalnik, da deluje
drugače. Privzeto je v tej tabeli 60 vrst z postopnim povečevanjem
velikosti okna od 20 ms (visok prioritet) do več sto ms (nizka prioritet),
tudi s povečanjem vseh nalog enkrat na sekundo.
Drugi MLFQ načrtovalniki ne uporabljajo tabele ali kakšnih specifičnih
pravil, opisanih v tej predavanju, temveč izračunavajo prioritete z uporabo
matematičnih formul. Na primer, načrtovalnik v FreeBSD uporablja formulo za
izračun trenutne prioritetne naloge, temelječo na tem, koliko proces
je uporabil CPU. Poleg tega z uporabo CPU s časom upada, in tako
se zvišanje prioritet dogaja nekoliko drugače, kot je opisano zgoraj. To so
tako imenovani decay algoritmi. Od različice 7.1 se v FreeBSD uporablja načrtovalnik ULE.
Nazadnje, mnogi načrtovalniki imajo druge značilnosti. Na primer, nekateri
načrtovalniki rezervirajo najvišje ravni za delovanje operacijskega sistema in tako
nobena uporabniška naloga ne more doseči najvišje prioritete v
sistemu. Nekateri sistemi omogočajo dajanje nasvetov, da bi pomagali
načrtovalniku pravilno določiti prioritete. Tako lahko na primer s pomočjo ukaza nice
povišate ali znižate prioriteto naloge in tako povišate ali
znižate možnosti programa za procesorski čas.
MLFQ: Povzetek
Opisali smo pristop k načrtovanju, ki se imenuje MLFQ. Njegovo ime
je zapisano v načelu delovanja — ima več vrstic in uporablja povratne informacije
za določanje prioritete naloge.
Končni izgled pravil bo naslednji:
- Pravilo1: Če je prioriteta(A) > Prioriteta(B), bo zagnana naloga A (B ne bo)
- Pravilo2: Če je prioriteta(A) = Prioriteta(B), A in B se zagnata z uporabo RR
- Pravilo3: Ko naloga pride v sistem, je postavljena v vrsto z najvišjo prioriteto.
- Rule4: Ko je naloga porabila dodeljeni čas v trenutni vrsti (ne glede na to, kolikokrat je sprostila CPU), se prioritetna stopnja te naloge zniža (premakne se navzdol v vrsti).
- Rule5: Po preteku nekega obdobja S prenesite vse naloge v sistemu v najvišjo vrsto.
MLFQ je zanimiv iz naslednjega razloga — namesto da bi zahteval poznavanje o
naravi naloge vnaprej, algoritem proučuje preteklo vedenje naloge in postavlja
prioritete ustrezno. Tako si prizadeva sedeti na dveh stolih hkrati — doseči učinkovitost za majhne naloge (SJF, STCF) in pošteno zagnati dolge,
CPU obremenjujoče naloge. Zato mnogi sistemi, vključujoč BSD in njihove različice,
Solaris, Windows, Mac uporabljajo kot načrtovalnik nekakšno obliko algoritma
MLFQ kot osnovno zasnovo.
Dodatni materiali:
- (computing)
Izvor: habr.com
