

Poročilo se osredotoča na praktična vprašanja razvoja operatorjev v Kubernetesu, oblikovanju njihove arhitekture in osnovnih načel delovanja.
V prvem delu poročila bomo obravnavali:
- kaj je operator v Kubernetesu in zakaj je potreben;
- kako operator poenostavi upravljanje zapletenih sistemov;
- kaj operator lahko, in kaj operator ne more.
Nato se bomo posvetili notranji zgradbi operatorja. Oglejna si bomo arhitekturo in delovanje operatorja korak za korakom. Podrobno bomo obravnavali:
- interakcijo med operatorjem in Kubernetesom;
- katere funkcije prevzame operator in katere delegira v Kubernetes.
Poglejmo upravljanje fragmentov in replik baz podatkov v Kubernetes.
Nato se bomo pogovorili o vprašanjih hrambe podatkov:
- kako delati s Persistent Storage z vidika operatorja;
- skriti izzivi uporabe Local Storage.
V zaključnem delu poročila bomo obravnavali praktične primere uporabe z uporabo Amazon ali Google Cloud Service. Poročilo temelji na razvoju in izkušnjah z obratovanjem operatorja za ClickHouse.
Video:
Moje ime je Vladislav Klimenko. Danes bi rad spregovoril o naših izkušnjah z razvojem in obratovanjem operatorja, in to je specializirani operator za upravljanje baz podatkovnih grozdov. Na primeru za upravljanje grozda ClickHouse.
Zakaj imamo možnost govoriti o operatorju in ClickHouse?
- Zaposleni smo v podpori in razvoju ClickHouse.
- Trenutno se trudimo počasi prispevati svoj delež v razvoju ClickHouse. In smo drugi po Yandexu po obsegu izvedenih sprememb v ClickHouse.
- Trudimo se izvajati dodatne projekte za ekosistem ClickHouse.
O enem takšnem projektu bi rad spregovoril. To je ClickHouse-operator za Kubernetes.
V svojem poročilu bi rad obravnaval dve temi:
- Prva tema – kako naš operator za upravljanje baz podatkov ClickHouse v Kubernetes deluje.
- Druga tema – kako deluje kateri koli operator, torej kako deluje z Kubernetesom.
Pri tem bosta ti dve vprašanji čez celotno moje poročilo prepletena.
Koga bi to zanimalo poslušati?
- Najbolj bo zanimivo tistim, ki upravljajo operatorje.
- Ali tistim, ki želijo razviti svojega, da bi razumeli, kako deluje notranjost, kako interagira operator s Kubernetesom in kateri skriti izzivi se lahko pojavijo.
Da bi bolje razumeli ono o čemu ćemo danas govoriti, bilo bi dobro poznavati osnove Kubernetes-a i imati osnovno poznavanje cloud tehnologija.
Šta je ClickHouse? To je kolumna baza podataka specijalizovana za online obradu analitičkih upita. A potpuno je otvorenog koda.
Važno je znati samo dve stvari. Treba znati da je to baza podataka, tako da će ono o čemu ću govoriti biti primenljivo praktično na svaku bazu podataka. I da se ClickHouse vrlo dobro skalira, pružajući skoro linijsku skalabilnost. Zato je stanje klastera prirodno za ClickHouse. Najviše nas zanima kako održavati ClickHouse klaster u Kubernetes-u.
Zašto je to potrebno? Zašto ne možemo nastaviti sa samostalnom eksploatacijom? Odgovori su delimično tehnički, a delimično organizacioni.
- U praksi sve češće nailazimo na situaciju u kojoj su u velikim kompanijama već gotovo svi komponenti u Kubernetes-u. Baze podataka ostaju napolju.
- I sve više se postavlja pitanje: "Može li se to unutra staviti?" Zbog toga velike kompanije nastoje maksimalno unifikovati upravljanje kako bi brzo mogle upravljati svojim skladištima podataka.
- To posebno pomaže kada je potrebna maksimalna mogućnost ponovnog postavljanja istog na novom mestu, tj. maksimalna prenosivost.
Koliko je to jednostavno ili složeno? To se naravno može raditi ručno. Ali nije baš jednostavno jer imamo složenost upravljanja samim Kubernetes-om, a istovremeno i specifičnost ClickHouse-a. Rezultat je takva agregacija.
I sve to zajedno stvara prilično veliki skup tehnologija kojima je upravljanje postalo prilično složeno, jer Kubernetes donosi pitanja svakodnevnog održavanja, a ClickHouse donosi svoja pitanja dnevnog rada. Pogotovo ako imamo nekoliko ClickHouse-a i moramo stalno raditi nešto s njima.
ClickHouse sa dinamičkom konfiguracijom ima priličan broj pitanja koja stvaraju stalno opterećenje na DevOps:
- Kada želimo promeniti nešto u ClickHouse-u, na primer dodati repliku ili shard, potrebno je upravljati konfiguracijom.
- Nato je potrebno spremeniti podatkovno shemo, saj ClickHouse uporablja poseben način sharding-a. Treba je razporediti podatkovno shemo in nastavitve.
- Potrebno je nastaviti nadzor.
- Zbiranje logov za nove sharde in nove replikacije.
- Poskrbite za obnovitev.
- In znova zagnati.
To so rutinska dela, ki bi jih želeli olajšati pri obratovanju.
Kubernetes dobro pomaga pri obratovanju, vendar pri osnovnih sistemskih stvareh.
Kubernetes dobro poenostavi in avtomatizira stvari, kot so:
- Obnovitev.
- Ponovni zagon.
- Upravljanje sistema shranjevanja.
To je dobro, to je pravilna smer, vendar nima povsem predstave o tem, kako obratovati podatkovni sklop.
Želimo več, da bi celoten podatkovni sklop deloval v Kubernetesu.
Želeli bi imeti nekaj podobnega veliki čarobni rdeči tipki, na katero pritisneš, in se ti razvije ter vzdržuje celoten sklop v vsej življenjski dobi, z vsakodnevnimi nalogami, ki jih je treba rešiti. Sklop ClickHouse v Kubernetesu.
Poskusili smo ustvariti rešitev, ki bi olajšala delo. To je ClickHouse-operator za Kubernetes podjetja Altinity.
Operator je program, katerega glavna naloga je upravljanje drugih programov, torej je upravljavski program.
Vsebuje vzorce obnašanja. To lahko imenujemo kodificirano znanje o predmetni oblasti.
Njegova glavna naloga je olajšati življenje DevOpsu in zmanjšati mikroupravljanje, da lahko razmišlja v visokih nivojih, torej da se ne ukvarja z mikroupravljanjem in ne nastavlja vseh podrobnosti ročno.
In prav operator je roboti pomočnik, ki se bori z mikronaloge in pomaga DevOpsu.
Zakaj je operator potreben? Še posebej dobro se izkaže pri dveh vprašanjih:
- Ko strokovnjaku, ki se ukvarja s ClickHouse, primanjkuje izkušenj, a je ClickHouse že treba obratovati, operator poenostavi obratovanje in omogoča upravljanje sklopa ClickHouse z dovolj zapleteno konfiguracijo, brez prekomernega poglabljanja v podrobnosti, kako vse to deluje znotraj. Preprosto mu daš naloge na višji ravni in to deluje.
- In the second task, where he shows himself best, it's when a large number of routine tasks need to be automated. It frees sysadmins from micro-tasks.
This is most needed either by those just starting out or by those who need to focus heavily on automation.
What is the difference between an operator-based approach and other systems? There's Helm. It also helps install ClickHouse, and you can draw helm charts that even set up an entire ClickHouse cluster. So, what's the difference between an operator and something like Helm?
The fundamental difference is that Helm is package management, while an operator goes further. It oversees the entire lifecycle. It's not just installation; it includes daily tasks such as scaling and sharding, meaning everything that needs to be done throughout the lifecycle (and if necessary, deletion as well) is all handled by the operator. It aims to automate and manage the entire software lifecycle. This is its fundamental distinction from other available solutions.
That was the introductory part; let's move on.
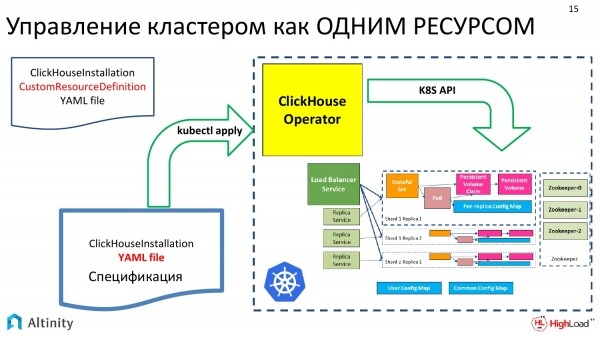
How do we build our operator? We aim to manage the ClickHouse cluster as a single resource.
On the left side of the picture, we have the input data. This is a YAML with the cluster specification, which is traditionally passed into Kubernetes via kubectl. There, our operator picks it up and does its magic. And what we get out at the end is this diagram. This is the implementation of ClickHouse in Kubernetes.
Next, we will gradually look at how the operator actually works, what typical tasks can be solved. We will only cover typical tasks because we have limited time. Not everything that an operator can solve will be discussed.
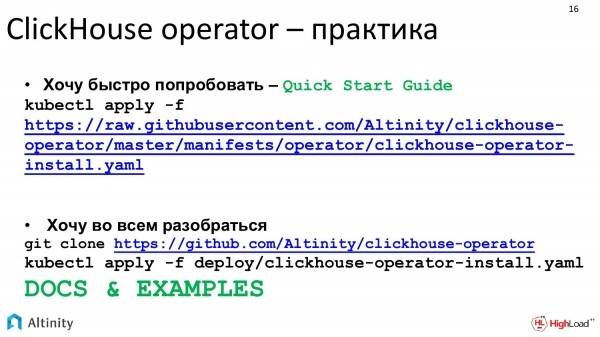
Let's start from practice. Our project is completely open source, so you can check out how it works on GitHub. And you can consider that if you just want to get started, the Quick Start Guide is a good place to begin.
If you want to dive into details, we strive to maintain the documentation in a reasonably good state.
Začnemo s praktično nalogo. Prva naloga, s čimer želimo začeti, je zagnati prvi primer na kakršenkoli način. Kako z operaterjem zagnati ClickHouse, tudi brez posebnega znanja o tem, kako deluje? Pišemo manifest, saj je vsa komunikacija z k8s komunikacija preko manifestov.
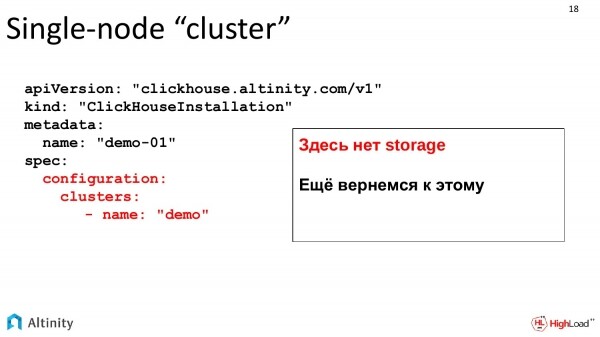
Tukaj imamo tak kompleksni manifest. To, kar imamo označeno rdeče, je tisto, na kar je treba opozoriti. Operaterja prosimo, da ustvari klaster z imenom demo.
Za zdaj so to osnovni primeri. Shranjevanje še ni opisano, a se bomo ob shranjevanju vrnili nekoliko pozneje. Za zdaj bomo opazovali razvoj klustra v dinamiki.
Ta manifest smo ustvarili. Napravimo ga našem operaterju. On je delal, naredil je čarovnijo.
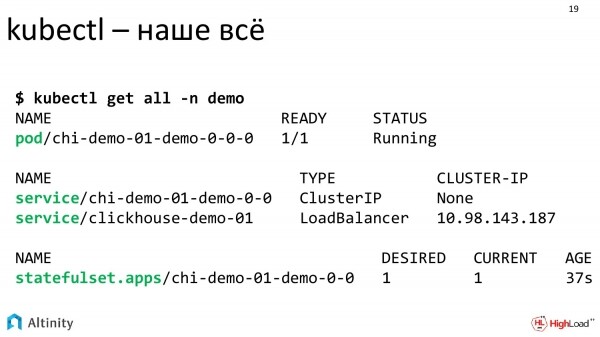
Ogledujemo si konzolo. Zanimajo nas trije elementi – to je Pod, dva Servisa, StatefulSet.
Operater je deloval in lahko si ogledamo, kaj točno je ustvaril.
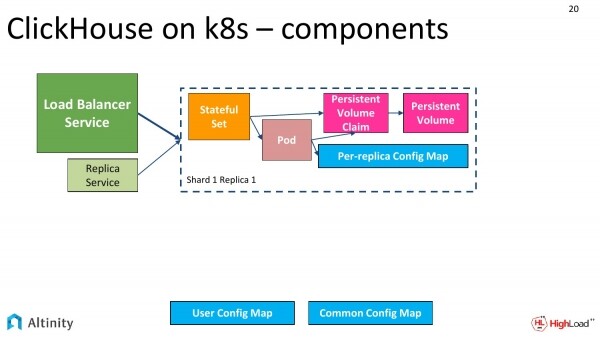
Ustvari približno takšno shemo. Imamo StatefulSet, Pod, ConfigMap za vsako repliko, ConfigMap za celoten kluster. Obvezni so servisi kot dostopne točke do klustra.
Servisi so centralni Load Balancer Service in še za vsako repliko, za vsak shard.
Naš osnovni kluster izgleda približno takole. Sestavljen je iz ene same nod.
Gremo naprej, bomo zapletli. Treba je sharding klustra.
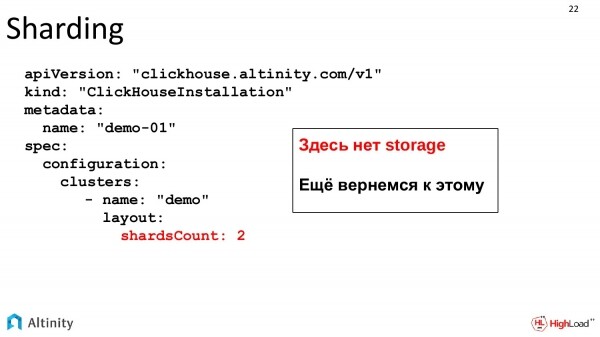
Naše naloge naraščajo, dinamika se začne. Želimo dodati shard. Spremljamo razvoj. Spreminjamo našo specifikacijo. Oznanjamo, da želimo dva sharda.
To je isti datoteka, ki se dinamično razvija z rastjo sistema. Shranjevanje ni, shranjevanje bo obravnavano pozneje, to je ločena tema.
Napravimo YAML-operater in pogledamo, kaj se zgodi.
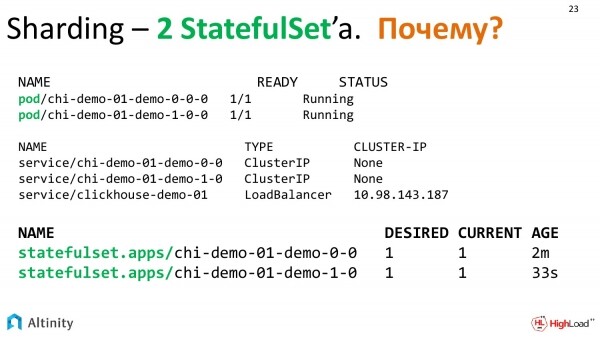
Operater je razmislil in naredil naslednje entitete. Imamo že dva Pod, tri Servise in nenadoma, 2 StatefulSet-a. Zakaj 2 StatefulSet-a?
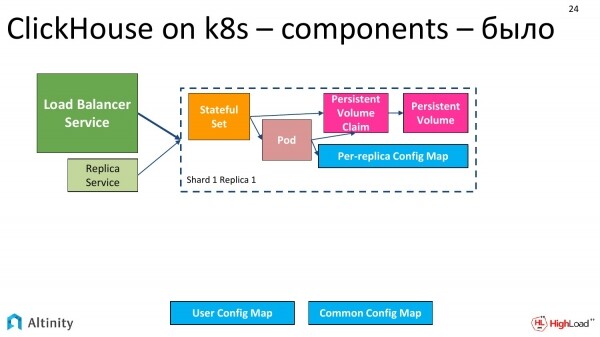
Na shemi je bilo tako – to je naše prvotno stanje, ko smo imeli en pod.
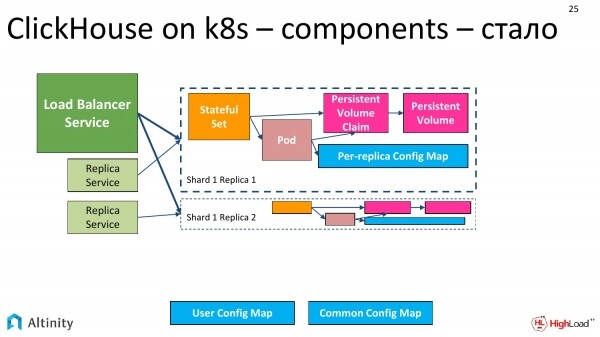
Sedaj je tako. Za zdaj je vse preprosto, podvojilo se je.
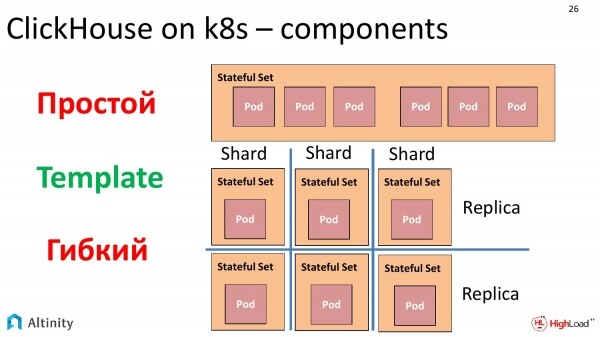
In zakaj sta zdaj dva StatefulSet-a? Tukaj se je treba oditi in razpravljati o vprašanju, kako v Kubernetesu poteka upravljanje s Pod-ji.
Obstaja objekt, imenovan StatefulSet, ki omogoča ustvarjanje niza Pod-ov iz predloge. Ključni dejavnik tukaj je Template. V enem StatefulSetu lahko zaženemo veliko Pod-ov po eni predlogi. Ključna fraza tukaj je 'po eni predlogi veliko Pod-ov'.
Obstaja velika želja, da bi celoten gruči zapakirali v en StatefulSet. To bo delovalo, s tem ni nobenih težav. Vendar pa je ena podrobnost. Če želimo zgraditi heterogeno gruči, tj. iz več različic ClickHouse, se tukaj pojavijo vprašanja. Da, StatefulSet lahko izvede rolling update, da lahko namestimo novo različico in razložimo, da ne bi smeli poskusiti več kot toliko vozlišč hkrati.
Toda če extrapoliramo nalogo in rečemo, da želimo ustvariti popolnoma heterogeno gruči in želimo ne zamenjati stare različice z novo s pomočjo rolling update, ampak preprosto želimo ustvariti heterogeno gruči tako v smislu različnih različic ClickHouse kot tudi različnih shranjevanj. Na primer, nekateri replikati bi morali biti na ločenih diskih, na počasnih, na splošno, popolnoma zgraditi heterogeno gruči. Zaradi tega, ker StatefulSet naredi standardizirano rešitev iz enega predloge, zato to ni mogoče.
Po nekaj premišljevanju smo se odločili, da to storimo tako. Vsaka replika ima svoj StatefulSet. Ta rešitev ima nekatera pomanjkljivosti, vendar v praksi to v celoti inkapsulira operator. In obstaja cela vrsta prednosti. Zgradimo lahko popolnoma takšno gruči, kot jo želimo, na primer popolnoma heterogeno. Zato bo v gruči, kjer imamo dva sharda z eno repliko, 2 StatefulSet-a in 2 Pod-a ravno zato, ker smo izbrali ta pristop zaradi zgoraj navedenih razlogov, da bi lahko zgradili heterogeno gruči.
Vrnimo se k praktičnim nalogam. V naši gruči je potrebno nastaviti uporabnike, tj. potrebno je nekako konfigurirati ClickHouse v Kubernetes. Operator za to ponuja vse možnosti.
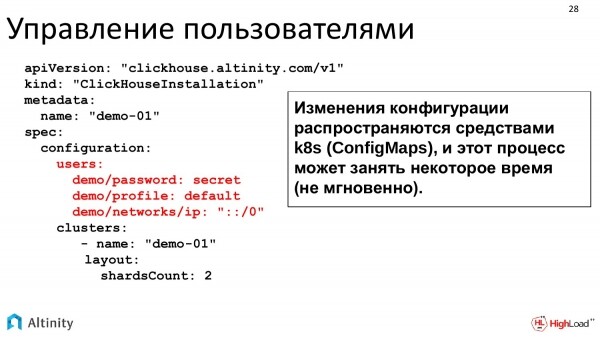
Lahko neposredno v YAML napišemo, kar želimo. Vse konfiguracijske možnosti se neposredno preslikajo iz tega YAML v nastavitve ClickHouse, ki se nato razporedijo po celotni gruči.
Lahko pa pišemo tudi takole. To je za primer. Geslo lahko naredite šifrirano. Podpirajo se vse konfiguracijske možnosti ClickHouse. Tukaj je le primer.
Konfiguracija po gruči se širi kot ConfigMap. V praksi se posodobitev ConfigMap ne zgodi takoj, zato če je gruča velika, postopek prehajanja konfiguracije traja nekaj časa. Toda vse to je zelo udobno za uporabo.
Zahtevamo kompleksnost. Klaster se razvija. Želimo da repliciramo podatke. Odnosno, već imamo dva shard-a, po jednom replikatu, korisnici su podešeni. Rasti ćemo i baviti se replikacijom.
Šta nam je potrebno za replikaciju?
Potrebni su nam ZooKeeper. U ClickHouse replikacija se gradi koristeći ZooKeeper. ZooKeeper je potreban kako bi različite replikate ClickHouse imale konsenzus o tome koji su podaci na kojem ClickHouse.
Možete koristiti bilo koji ZooKeeper. Ako preduzeće ima spoljašnji ZooKeeper, može ga koristiti. Ako nema, možemo ga postaviti iz našeg repozitorijuma. Postoji instalater koji olakšava celu stvar.
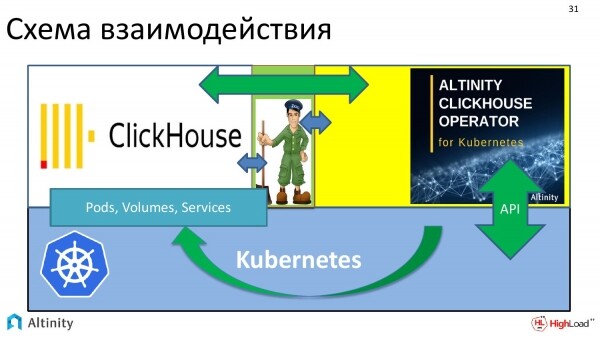
I shema interakcije celog sistema izgleda ovako. Imamo Kubernetes kao platformu. Na njemu se izvršava ClickHouse operator. ZooKeeper je ovde prikazan. Operator interaguje i sa ClickHouse i sa ZooKeeper. Odnosno, dolazi do interakcije.
I sve to je potrebno da ClickHouse uspešno replikira podatke u k8s.
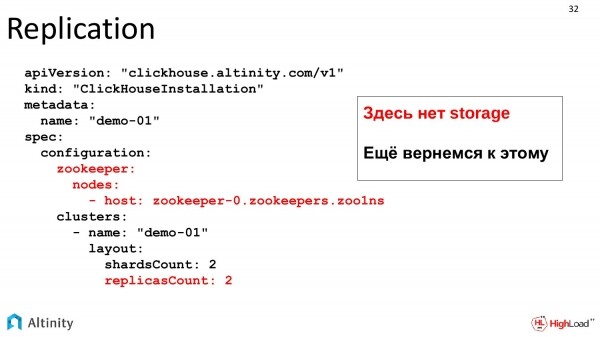
Pogledajmo sada samu zadatak, kako će izgledati manifest za replikaciju.
Dodajemo dve sekcije našem manifestu. Prva – odakle uzeti ZooKeeper, koji može biti unutar Kubernetes-a ili spoljašnji. Ovo je samo opis. I naručujemo replikate. Odnosno, želimo dve replikate. Tako da na izlazu treba da imamo 4 pod-a. Što se tiče skladišta, toga se sećamo, vratiće se malo kasnije. Skladište je posebna tema.
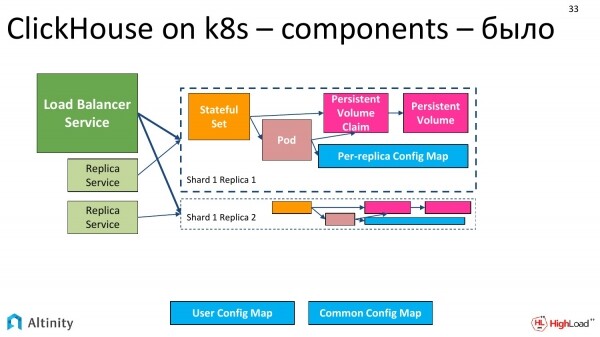
Bilo je ovako.
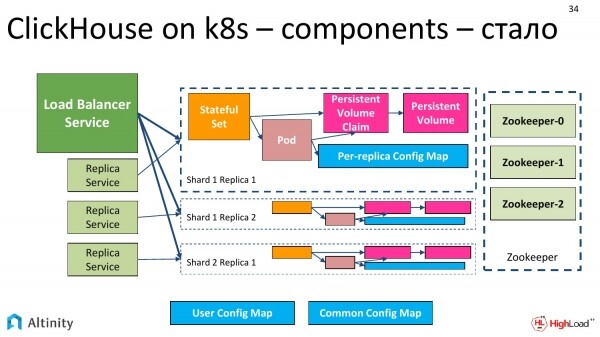
Postaje ovako. Dodaju se replikati. Četvrti se nije uklapao, verujemo da ih može biti mnogo. A sa strane se dodaje ZooKeeper. Šeme postaju složenije.
I došao je trenutak da dodamo sledeći zadatak. Dodaćemo Persistent Storage.
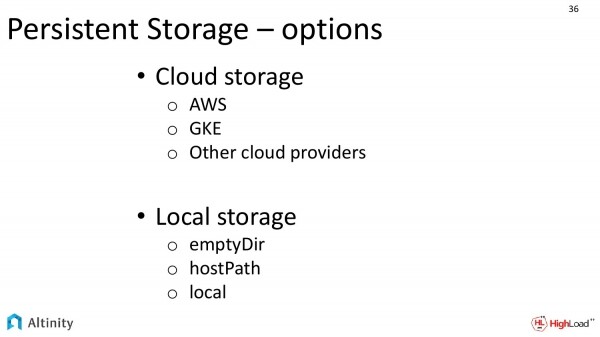 Imamo različite opcije za Persistent Storage.
U slučaju da se izvršavamo u cloud provajderu, na primer, koristeći Amazon, Google, postoji velika iskušenje da iskoristimo cloud skladište. To je veoma zgodno, to je dobro.
I postoji druga opcija. To je za lokalno skladište, kada su nam diskovi lokalni na svakoj nodi. Ova opcija je mnogo složenija za izvršenje, ali je pritom i produktivnija.
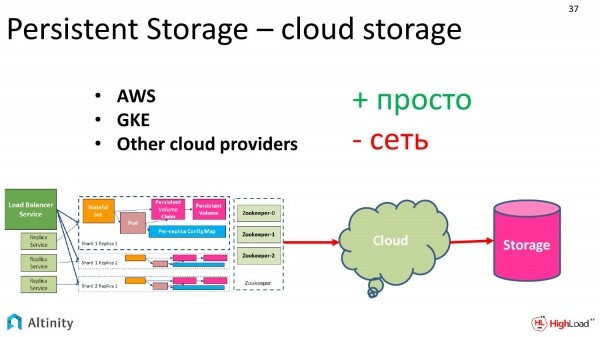
Pogledajmo šta imamo u vezi sa cloud skladištem.
Postoje prednosti. Veoma je jednostavno konfigurirati. Jednostavno naručimo od cloud provajdera da nam da skladište određenog kapaciteta, određene klase. Klase su opisane od strane provajdera.
Obstaja pa tudi pomanjkljivost. Za nekatere to morda ni kritična pomanjkljivost. Seveda so lahko prisotne nekatere težave z zmogljivostjo. To je zelo priročno za delo, zanesljivo, a so prisotna nekatera potencialna zmanjšanja zmogljivosti.
Ker se ClickHouse osredotoča prav na zmogljivost, bi lahko celo rekli, da iztisne vse kar se da, zato mnogi naročniki poskušajo iztisniti maksimum zmogljivosti.
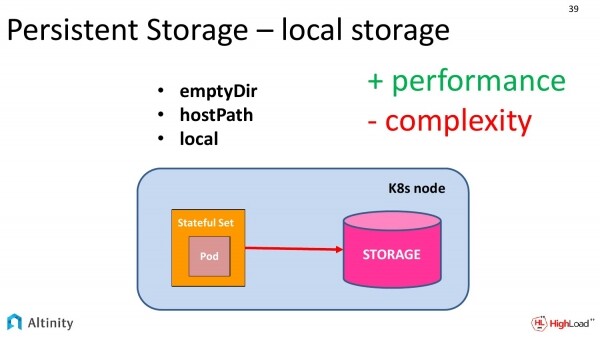
Da bi dosegli maksimum, potrebujemo lokalni spomin.
Kubernetes nudi tri abstrakcije za uporabo lokalnega pomnilnika v Kubernetesu. To so:
- EmptyDir
- HostPath.
- Local
Poglejmo, kako se razlikujejo in kako so si podobni.
Prvič, pri vseh treh pristopih imamo storage – to so lokalni diski, ki se nahajajo na istem fizičnem k8s vozlišču. A obstajajo nekatere razlike.
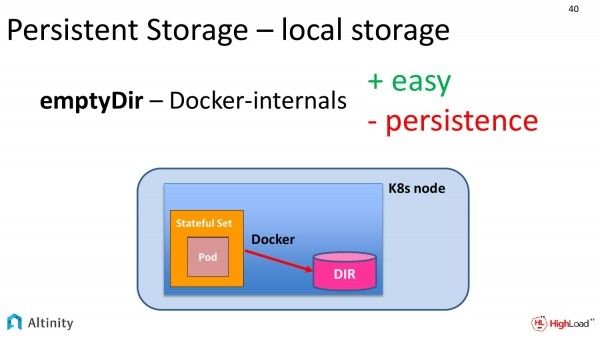
Začnimo z najpreprostejšim, torej z emptyDir. Kaj to v praksi pomeni? Prosim našo specifikacijo, da sistemu kontejnerizacije (večinoma je to Docker) omogočimo dostop do mape na lokalnem disku.
V praksi Docker nekje v svojih lastnih poteh ustvari začasno mapo, jo poimenuje z dolgim hašem. In omogoči dostop do nje.
Kako bo to vplivalo na zmogljivost? Delo bo potekalo s hitrostjo lokalnega diska, torej imamo popoln dostop do svojega diska.
Toda ta pristop ima svoje pomanjkljivosti. Trajno ohranjanje podatkov v tem primeru je precej vprašljivo. Pri prvem premiku Dockra s kontejnerji se trajni podatki izgubijo. Če bo Kubernetes iz kakršnega koli razloga želel preseliti to Pod na drug disk, se bodo podatki izgubili.
Ta pristop je dober za teste, ker že pokaže normalno hitrost, vendar ta različica ni primerna za resnejše projekte.
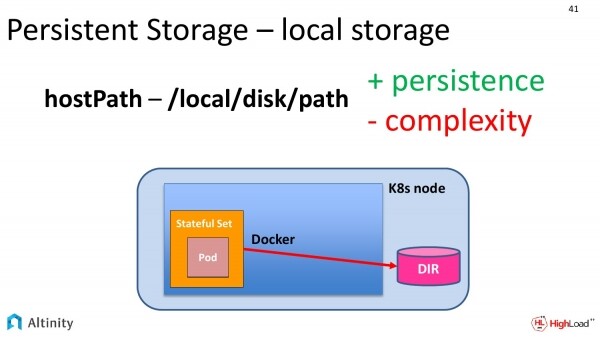
Zato obstaja drugi pristop. To je hostPath. Če primerjate prejšnji diapozitiv in ta, lahko opazite zgolj eno razliko. Naša mapa je prišla iz Dockra neposredno na Kubernetes nod.
Ta način ima svoje prednosti. To je že pravi trajni pomnilnik, klasičen. Na disku bodo podatki shranjeni na določenem naslovu.
Obstajajo tudi slabosti. To je zahtevnost upravljanja. Naš Kubernetes morda želi premakniti Pod na drugo fizično vozlišče. In tu vstopi DevOps. Morajo pravilno razložiti celotni sistem, da se lahko ti podi premikajo samo na tista vozlišča, na katerih imaš po teh poteh nekaj montiranega, in ne več kot na eno vozlišče naenkrat. To je precej zapleteno.
Zato smo za te namene v našem operaterju pripravili predloge, da to zapletenost skrijemo. In tako bi lahko enostavno rekli: „Želim, da imam en instance ClickHouse na vsako fizično vozlišče in po takšni poti.“
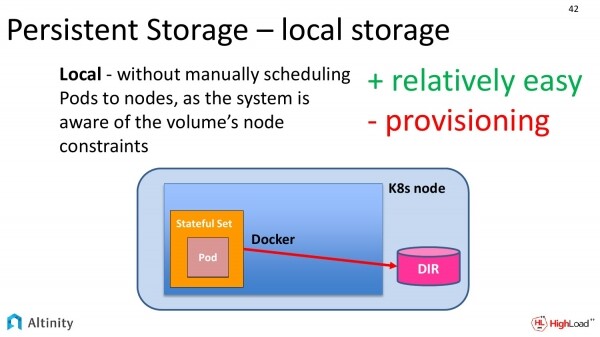
Toda ta potreba ni pomembna samo za nas, zato gospodje iz samega Kubernetesa tudi razumejo, da si ljudje želijo imeti dostop do fizičnih diskov, zato nudijo tretjo raven.
Ta se imenuje local. Razlika od prejšnjega diapozitiva je praktično nobena. Le da je prej bilo treba ročno spremljati, da teh podov ni mogoče prenašati z vozlišča na vozlišče, ker morajo biti pritrjeni po takšni poti na lokalni fizični disk, zdaj pa se vse te informacije inkapsulirajo v samo Kubernetes. In vse skupaj postane veliko lažje za konfiguriranje.
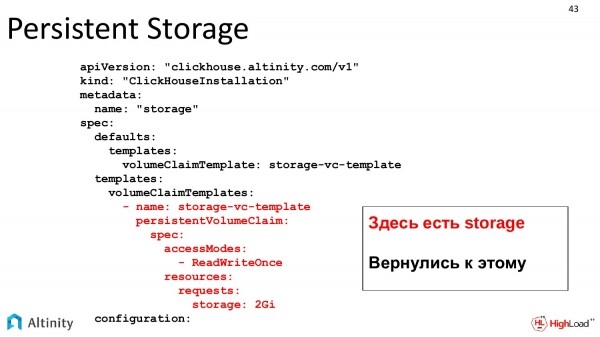
Vrnimo se k naši praktični nalogi. Vrnimo se k YAML predlogi. Tukaj imamo pravi storage. Spet smo se vrnili k temu. Določamo klasičen VolumeClaim predlogo, kot v k8s. In opisujemo, kakšen storage želimo.
Po tem bo k8s zahteval storage. Dodelil nam ga bo v StatefulSet. In na koncu bo to na voljo ClickHouse.
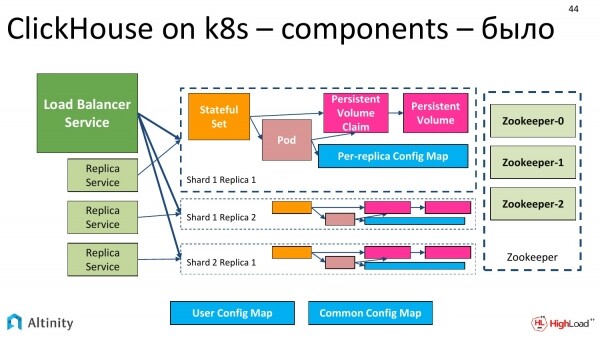
Imeli smo takšno shemo. Naš Persistent Storage je bil rdeč, kar nam je namigovalo, da bi ga bilo treba narediti.
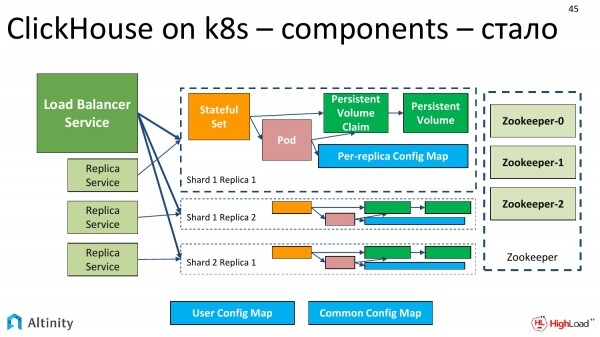
In zdaj postane zelen. Shema klasterja ClickHouse na k8s je zdaj v celoti končana. Imamo sharde, replikate, ZooKeeper, imamo pravi Persistent, ki je realiziran na ta ali oni način. Shema je že popolnoma delujoča.
Nadaljujemo naprej. Naš klaster se razvija. In Aleksej se trudi in izdaja novo različico ClickHouse.
Pojavi se praktična naloga – testirati novo različico ClickHouse na našem klasterju. Seveda si ne želimo, da bi jo takoj namestili na celoten klaster, ampak bi jo želeli nekje v oddaljenem kotu namestiti v eno replikato, morda pa ne eno novo različico, temveč kar dve, ker pogosto izhajajo.
Kaj lahko o tem povemo?
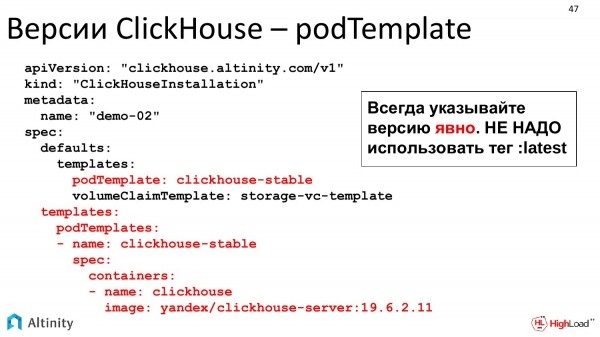
Tuk imamo prav tako možnost. To so predloge podov. Lahko jih konfiguriramo, naš operater omogoča popolno gradnjo heterogenih klastrov. To pomeni, da lahko konfiguriramo vse replike skupaj ali vsako posamezno repliko z različicami ClickHouse in shranjevanja, ki jih želimo. Popolnoma lahko konfiguriramo naš klaster tako, kot potrebujemo.
Sedaj se bomo malo poglobili v podrobnosti. Do sedaj smo govorili, kako ClickHouse-operator deluje v kontekstu ClickHouse.
Zdaj bi rad povedal nekaj besed o tem, kako deluje vsak operator in kako interagira s K8s.
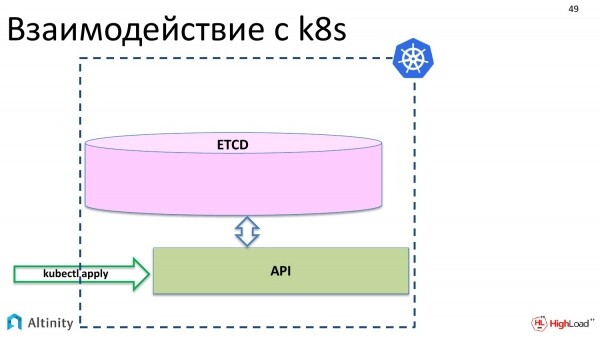
Najprej poglejmo interakcijo s K8s. Kaj se zgodi, ko izvedemo kubectl apply? Naši objekti se prek API-ja pojavijo v etcd.
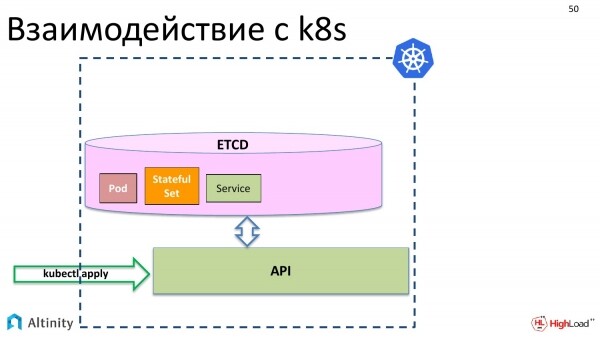
Na primer, osnovni objekti Kubernetes: pod, StatefulSet, storitev in tako dalje.
Hkrati se fizično še nič ne dogaja. Te objekte je treba materializirati v klastru.
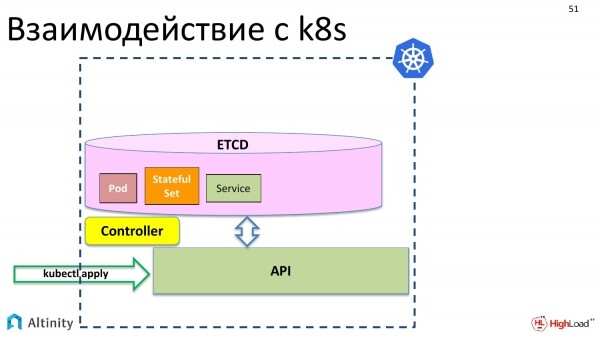
Za to nastane kontroler. Kontroler je poseben komponent K8s, ki zna materializirati te opise. Ve, kako in kaj je treba fizično storiti. Ve, kako zagnati kontejnerje in kaj je treba nastaviti, da strežnik deluje.
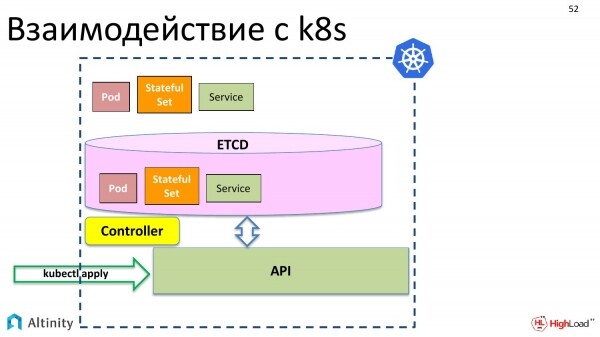
In materializira naše objekte v K8s.
Ampak želimo upravljati ne le s podi in StatefulSeti, temveč želimo ustvariti ClickHouseInstallation, torej objekt tipa ClickHouse, da bi z njim upravljali kot z enoto. Zaenkrat taka možnost ne obstaja.
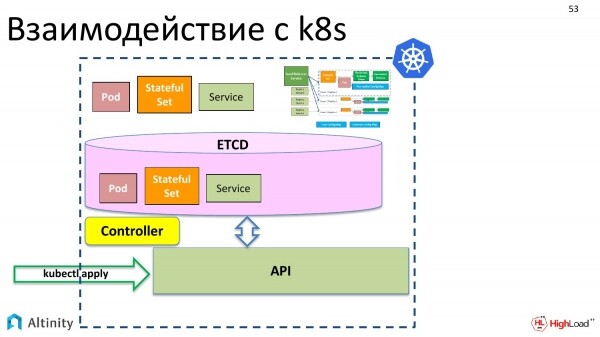
Vendar pa ima K8s eno prijetno lastnost. Želimo, da imamo nekje to kompleksno entiteto, ki bi bila sestavljena iz podov in StatefulSetov našega klasterja.
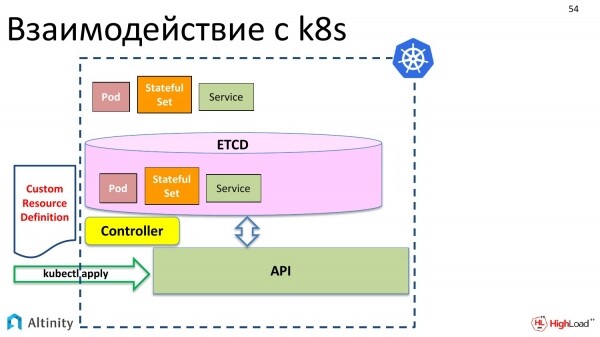
Kaj je torej potrebno storiti? Prvič, na sceno stopi Custom Resource Definition. Kaj to pomeni? To je opis za K8s, da boš imel še en tip podatkov, saj želimo dodati prilagojen vir k podu in StatefulSetu, ki bo notranje kompleksen. To je opis strukture podatkov.
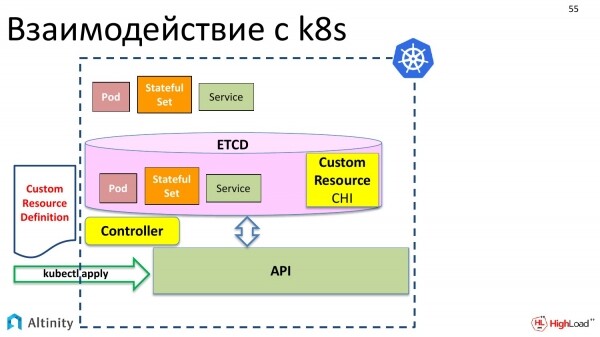
Tudi to pošljemo tja prek kubectl apply. Kubernetes ga je veselo sprejel.
In zdaj imamo v shranjevanju, pri objektu v etcd, možnost zapisati prilagojen vir z imenom ClickHouseInstallation.
Но пока что ничего больше не произойдет. То есть, если мы сейчас создадим YAML-файл с описанием шард, реплик и скажем «kubectl apply», то Kubernetes его примет, положит в etcd и скажет: «Отлично, но что с ним делать, я не знаю. Как управлять ClickHouseInstallation, я не знаю».
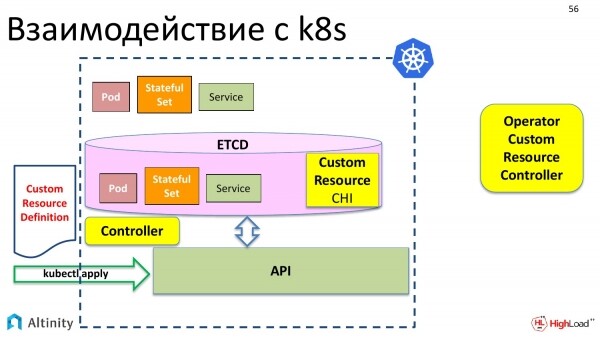
Соответственно, нам нужен кто-то, кто поможет Kubernetes управлять новым типом данных. Слева у нас есть стандартный контроллер Kubernetes, который работает с обычными типами данных. А справа у нас должен появиться кастомный контроллер, который умеет работать с кастомными типами данных.
И по-другому он называется оператор. Я его здесь специально вынес за пределы Kubernetes, потому что он может исполняться и вне K8s. Чаще всего, конечно, все операторы исполняются в Kubernetes, но ничто не мешает ему работать снаружи, поэтому он специально вынесен наружу.
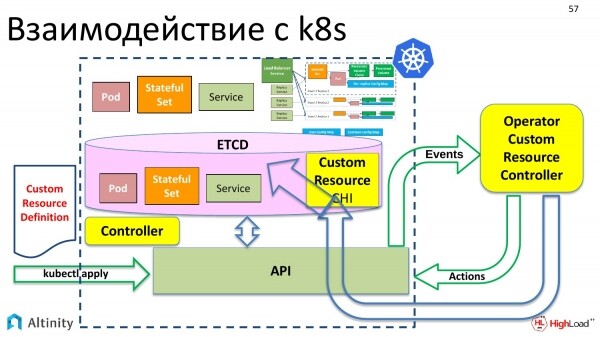
И кастомный контроллер, он же оператор, взаимодействует с Kubernetes через API. Он уже умеет работать с API. И он уже знает, как из кастомного ресурса создать сложную схему, которую мы хотим сделать. Именно этим и занимается оператор.
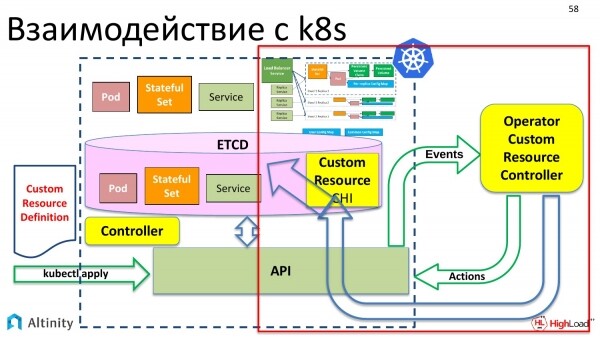
Как работает оператор? Давайте заглянем в правую часть, чтобы узнать, как он это делает. Узнаем, как оператор все это реализует и как дальше происходит взаимодействие с K8s.
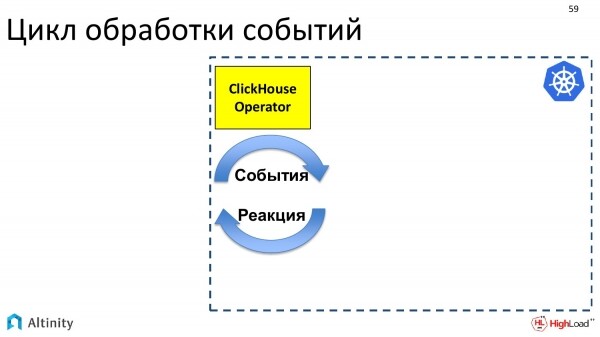
Оператор – это программа. Она ориентирована на события. Оператор с помощью Kubernetes API подписывается на события. В Kubernetes API есть точки входа, на которые можно подписаться для получения событий. И если что-то в K8s меняется, то Kubernetes посылает события всем, кто на это подписался, т.е. кто подписался на данную точку API, тот будет получать уведомления.
Оператор подписывается на события и должен реагировать на них. Его задача – реагировать на возникающие события.
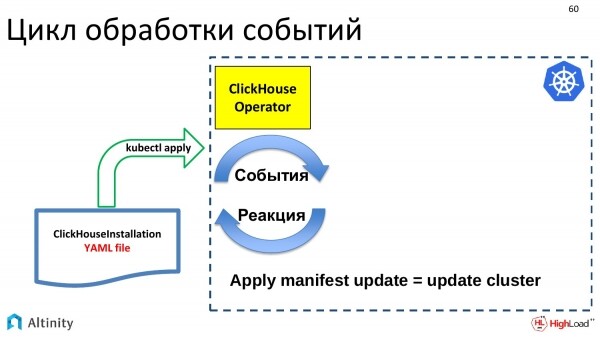
События генерируются различными обновлениями. Приходит наш YAML-файл с описанием ClickHouseInstallation. Он через kubectl apply попадает в etcd. Там срабатывает событие, и в итоге это событие приходит в ClickHouse-operator. Оператор получает это описание и должен что-то сделать. Если пришло обновление на объект ClickHouseInstallation, то необходимо обновить кластер. И задача оператора – это обновить кластер.
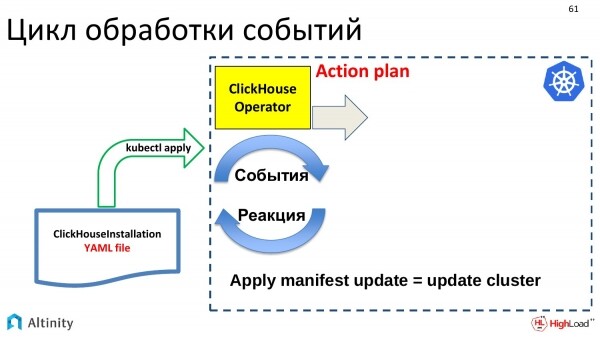
Kaj stori? Najprej je treba izdelati načrti, kako bomo ravnali s to posodobitvijo. Posodobitve so lahko zelo majhne, tj. majhne v YAML-izvedbi, a lahko povzročijo zelo velike spremembe v grozdu. Zato operater ustvari načrt in se ga nato drži.
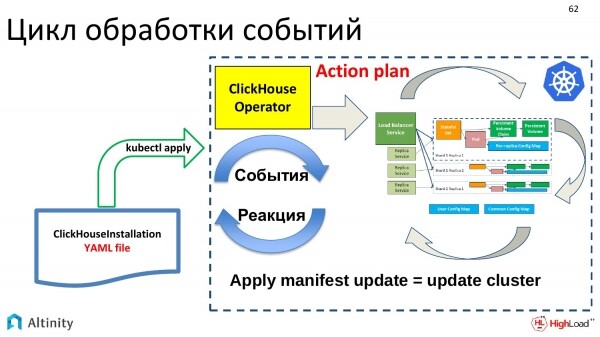
Začne opravljati to strukturo v skladu s tem načrtom, da materializira pod-ove, storitve, tj. počne tisto, kar je njegova glavna naloga. To je podobno gradnji ClickHouse grozda v Kubernetesu.
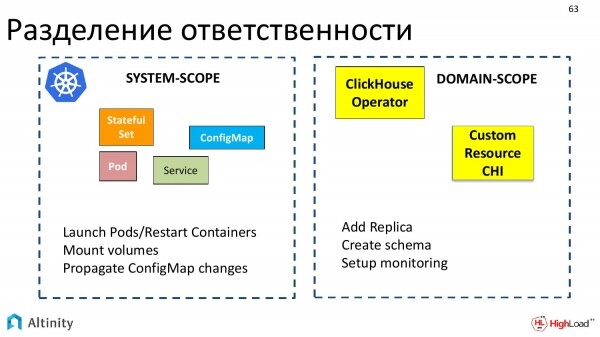
Zdaj se dotaknimo zanimive stvari. To je razdelitev odgovornosti med Kubernetesom in operaterjem, tj. kaj dela Kubernetes, kaj dela operater in kako medsebojno sodelujeta.
Kubernetes je odgovoren za sistemske stvari, tj. za osnovni niz objektov, ki jih lahko interpretiramo kot predmetni obseg sistema. Kubernetes ve, kako zagnati pod-e, kako ponovno zagnati vsebnike, kako narediti mount volumes, kako delati s ConfigMap, tj. vse, kar lahko imenujemo sistem.
Operaterji delujejo v predmetnih področjih. Vsak operater je zasnovan za svoje predmetno področje. Mi smo ga ustvarili za ClickHouse.
In operater deluje natančno v pogojih predmetnega področja, kot so dodajanje replike, ustvarjanje sheme, nastavitev nadzora. Izvaja se takšna razdelitev.
Poglejmo praktičen primer, kako se ta razdelitev odgovornosti uresničuje, ko izvedemo dejanje dodajanja replike.
Operaterju prispe naloga – dodati repliko. Kaj operater stori? Operater izračuna, da mora ustvariti nov StatefulSet, v katerem mora opisati določene predloge, volume claim.
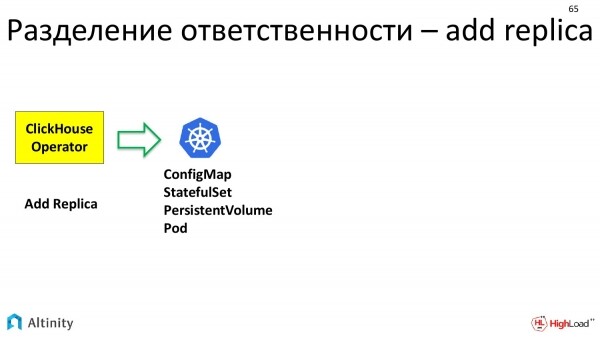
Vse to pripravi in nadaljuje v K8s. Pove, da potrebuje ConfigMap, StatefulSet, Volume. Kubernetes to obdeluje. Materializira osnovne enote, s katerimi deluje.
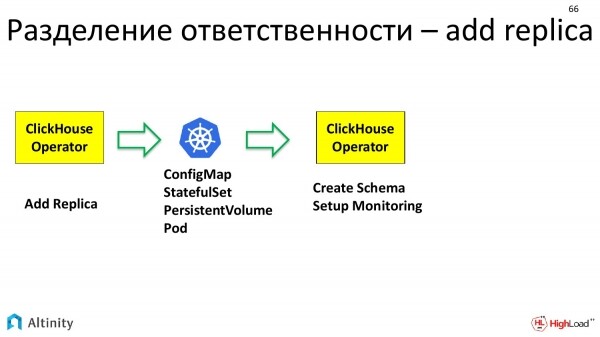
In nato ponovno vstopi ClickHouse-operator. Že ima fizični pod, na katerem je mogoče nekaj početi. In ClickHouse-operator spet deluje v pogojih predmetnega področja. Tj. Specifično ClickHouse za vključitev replike v grozd, je najprej treba nastaviti shemo podatkov, ki obstaja v tem grozdu. In drugič, to repliko je treba vključiti v nadzor, da jo je mogoče dobro spremljati. To nastavi operater.
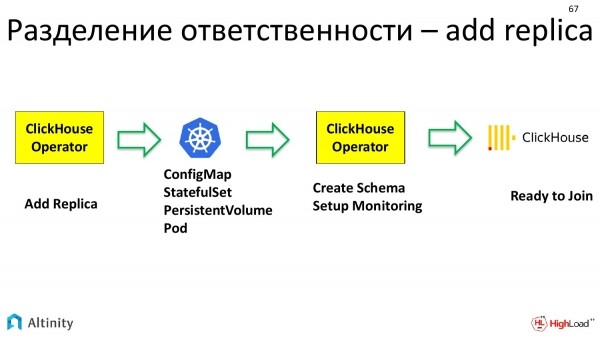
In this way, ClickHouse comes into play, meaning another higher-level entity. This is now a database. It has its own instance, a configured replica that is ready to join the cluster.
Thus, the execution chain and the division of responsibilities when adding a replica is quite long.
Let's continue with our practical tasks. If a cluster already exists, one can carry out a configuration migration.
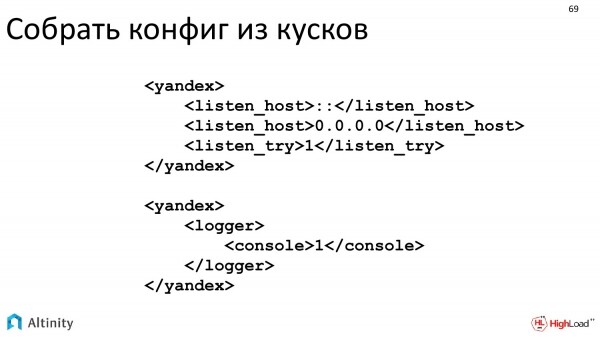
We have made it possible to pass through the existing XML that ClickHouse understands.
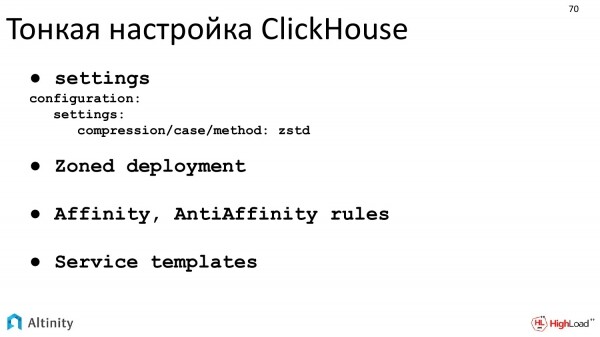
ClickHouse can be finely tuned. Zoned deployment is precisely what I talked about when explaining hostPath and local storage. This is how to properly implement zoned deployment.
The next practical task is monitoring.
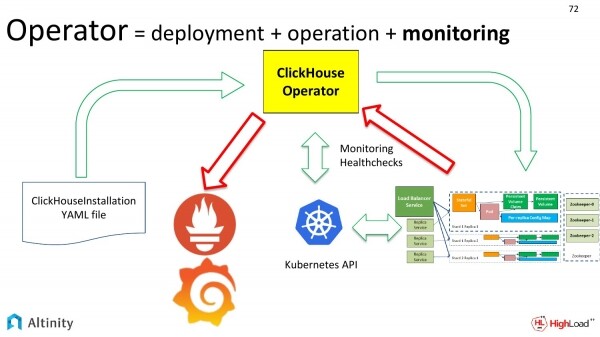
If our cluster changes, we need to periodically adjust the monitoring.
Let's look at the diagram. We have already reviewed the green arrows. Now let's examine the red arrows. This is how we want to monitor our cluster. How metrics from the ClickHouse cluster get into Prometheus and then into Grafana.
What is the challenge with monitoring? Why is it considered some kind of achievement? The difficulty lies in the dynamics. When we have one static cluster, monitoring can be set up once and not thought about again.
However, if we have many clusters or if something is constantly changing, the process is dynamic. Constantly reconfiguring monitoring is a waste of resources and time, or even just laziness. This needs to be automated. The complexity lies in the dynamics of the process, and the operator automates this very well.
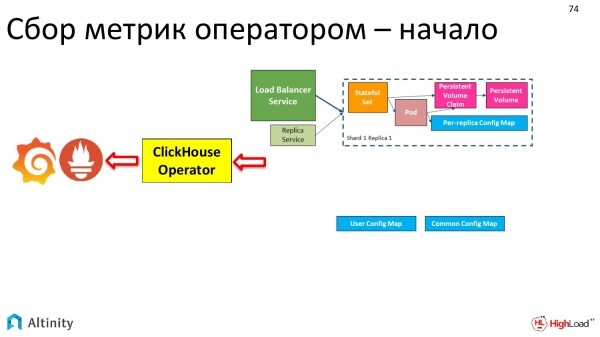
How did our cluster evolve? Initially, it looked like this.
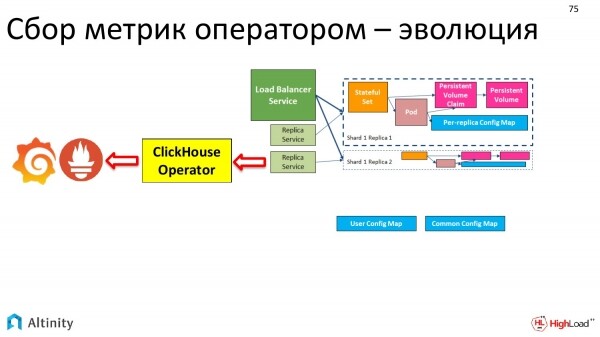
Then it looked like this.
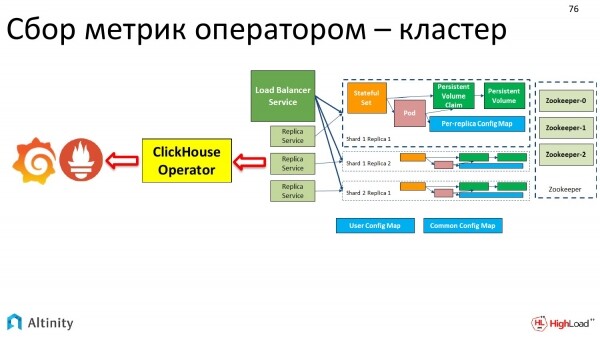
In the end, it became like this.
Monitoring is automated by the operator. A single point of entry.
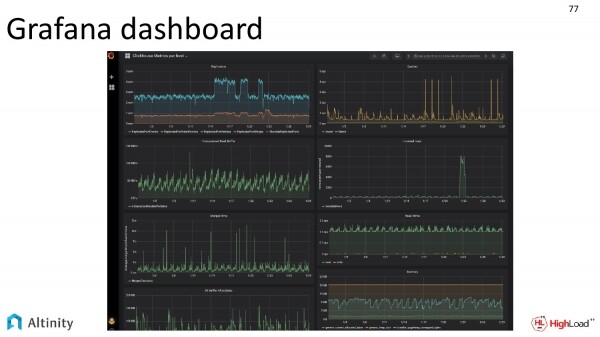
And we simply look at the Grafana dashboard to see how the internal life of our cluster is progressing.
By the way, the Grafana dashboard is also distributed with our operator directly in the source. It can be connected and used. Our DevOps team provided this screenshot.
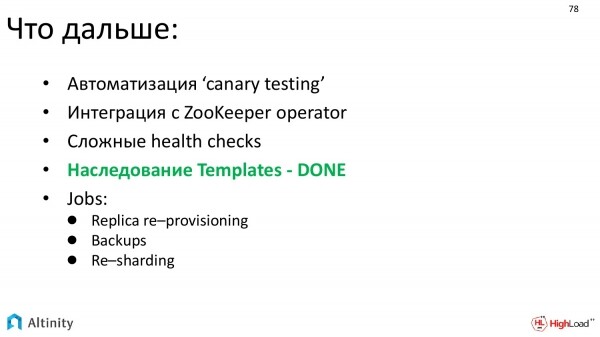
Where would we like to move next? It is to:
- Develop automation for testing. The main task is automated testing of new versions.
- Poleg tega si zelo želimo avtomatizirati integracijo z ZooKeeperjem. In planiramo integracijo z ZooKeeper-operatorjem. To pomeni, da je za ZooKeeper napisan operator in logično je, da bi se ti dva operatorja začela integrirati za ustvarjanje bolj udobne rešitve.
- Želimo izvesti bolj zapletene preglede življenjske dobe.
- V zelenem sem označil to, da imamo na voljo dedovanje predlog – KONČANO, torej z naslednjo različico operatorja bomo že imeli dedovanje predlog. To je močno orodje, ki omogoča sestavljanje zapletenih konfiguracij iz kosov.
- In želimo avtomatizacijo zapletenih nalog. Glavna med njimi je Re-sharding.
Opravimo vmesne rezultate.
Kaj dobimo na izhodu? In ali se splača ukvarjati s tem ali ne? Je sploh smiselno poskusiti prenesti podatkovno bazo v Kubernetes in uporabiti operator na splošno ter Alitnity-operatorja posebej.
Na izhodu dobimo:
- Znatno poenostavitev in avtomatizacijo konfiguracije, uvajanja ter vzdrževanja.
- Takoj vključeno spremljanje.
- In pripravljene za uporabo kodificirane predloge za zapletene situacije. To pomeni, da dodajanje replike ni več potrebno opravljati ročno. To opravi operator.
Ostalo je le še eno vprašanje. Imamo že podatkovno bazo v Kubernetesu, virtualizacijo. Kakšna je zmogljivost te rešitve, še posebej glede na to, da je ClickHouse optimiziran za zmogljivost?
Odgovor – vse je v redu! Ne bom podrobno razlagal, to je tema za posebno poročilo.
Obstaja pa projekt, imenovan TSBS. Kakšen je njegov glavni cilj? To je testiranje podatkovnih baz za zmogljivost. To je poskus primerjave toplega s toplim, mehkega z mehkimi.
Kako deluje? Generira se en niz podatkov. Nato se ta niz podatkov na enakem naboru testov preizkuša na različnih podatkovnih bazah. In vsaka podatkovna baza rešuje en problem tako, kot zna. Potem lahko rezultate primerjamo.
Že podpira številne podatkovne baze. Osvetlil sem tri glavne. To so:
- TimescaleDB.
- InfluxDB.
- ClickHouse.
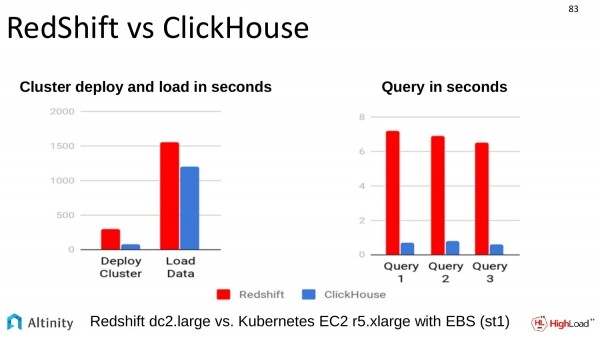
Prav tako je bilo izvedeno primerjavo z drugo podobno rešitvijo. Primerjava z RedShift. Primerjava je bila izvedena na Amazonu. ClickHouse tudi dobro premaga vse v tej zadevi.
Kakšne zaključke lahko izpeljemo iz tega, kar sem povedal?
- DB v Kubernetes je možný. Možná jakýkoliv, ale celkově to vypadá, že to možné je. ClickHouse v Kubernetes určitě použít lze silami našeho operátora.
- Operátor pomáhá automatizovat procesy a skutečně zjednodušuje život.
- Výkon je normální.
- A, máme pocit, že to je možné a mělo by se to používat.
Open source – přidejte se!
Jak jsem již zmínil, operátor je zcela open source produkt, takže by bylo skvělé, kdyby ho co nejvíce lidí používalo. Přidejte se! Čekáme na vás všechny!
Děkuji všem!
Vprašanja
Děkuji za prezentaci! Jmenuji se Anton. Jsem ze společnosti SEMrush. Zajímá mě, co s logováním. O monitorování jsme slyšeli, ale o logování nic, pokud hovoříme o celém klastru. U nás například běží klastr na hardwaru. A používáme centralizované logování, standardními prostředky shromažďujeme do společného místa. A potom odtud získáváme zajímavá data.
Dobrý dotaz, t.j. logování je na seznamu todo. Náš operátor to zatím automatizovat neumí. Je to ještě v rozvoji, projekt je stále dost mladý. Chápeme potřebu logování. To je také velmi důležité téma. A je to asi neméně důležité než monitorování. Ale první v seznamu realizace bylo monitorování. Logování bude. Samozřejmě se snažíme automatizovat všechny stránky životnosti klastru. Proto odpověď – v současnosti operátor, obávám se, to neumí, ale je to v plánu, budeme to dělat. Pokud máte zájem se připojit, tak prosím pull request.
Dobrý den! Děkuji za prezentaci! Mám standardní otázku, týkající se Persistent Volumes. Když vytváříme konfiguraci tímto operátorem, jak operátor určuje, na které nody máme připojený nějaký disk nebo složku? Musíme mu předem vysvětlit, že prosím umístěte náš ClickHouse právě na těch nodech, kde je disk?
Pokud správně rozumím, tato otázka je pokračováním local storage, zejména jeho části o hostPath. Je to jako vysvětlovat celému systému, že pod by měl být spuštěn právě na takové nodě, na kterou máme fyzicky připojený disk, který je připojen na takové cestě. To je celá sekce, kterou jsem dotknul velmi povrchně, protože odpověď je docela obsáhlá.
Na kratko, to izgleda tako. Seveda moramo zagotoviti te volumne. Trenutno v lokalnem shranjevanju ni dinamičnega zagotavljanja, zato morajo DevOps sami odrezati diske, torej te volumne. In morajo razložiti Kubernetesu o zagotavljanju, da bodo imeli trdni volumni določene klase, ki se nahajajo na določenih vozliščih. Nato je treba razložiti Kubernetesu, da se podi, ki zahtevajo točno to lokalno shranjevanje, morajo glede na oznake načrtovati le na ta vozlišča. Za te namene ima operator možnost dodeliti določeno oznako in eno za vsako instanco gostitelja. Tako se bo zgodilo, da bodo podi usmerjeni s Kubernetesom za zagon samo na vozlišča, ki ustrezajo zahtevam, oznakam, enostavno povedano. Administratori dodelijo oznake in ročno izvedejo zagotavljanje diskov. Tako se to lahko razširi.
In prav tretja možnost lokalnega shranjevanja to nekoliko olajša. Kot sem že poudaril, je to potrpežljivo delo na nastavitvah, ki na koncu pomaga doseči največjo zmogljivost.
Imam drugo vprašanje, povezano s tem. Kubernetes je zasnovan tako, da ni pomembno, ali izgubimo vozlišče ali ne. Kaj naj v tem primeru storimo, če izgubimo vozlišče, kjer imamo shard?
Da, Kubernetes je bil prvotno zasnovan tako, da imamo do naših podov odnos kot do goveda, tukaj pa vsak disk postane nekaj podobnega hišnemu ljubljencu. Obstaja težava, da jih ne moremo kar tako zavreči. Razvoj Kubernetes se odvija v smeri, da se tega ne moremo popolnoma filozofsko lotiti, kot da bi bili to popolnoma zavrženi viri.
Zdaj pa praktično vprašanje. Kaj storiti, če ste izgubili vozlišče, na katerem je bil disk? Tukaj se naloga rešuje na višji ravni. V primeru ClickHouse imamo replikate, ki delujejo na višji ravni, tj. na ravni ClickHouse.
Kakšna je torej postavitev? Za to, da se podatki ne izgubijo, je odgovoren DevOps. Pravilno mora nastaviti replikacijo in mora spremljati, da se replikacija izvaja. V repliki na ravni ClickHouse morajo biti podatki podvojeni. To ni naloga, ki jo rešuje operator. In ni naloga, ki jo rešuje sam Kubernetes. To je na ravni ClickHouse.
Kaj narediti, če vam je padla železna vozlišča? Izgleda, da bo treba postaviti drugo, pravilno pripisati disk in nanesti oznake. Potem bo izpolnjevala zahteve, da lahko Kubernetes na njej zažene instanco pod-a. Kubernetes jo bo zagnal. Vašemu številu pod-ov namreč ne zadostuje do zahtevanega. Prešla bo skozi cikel, ki sem ga prikazal. Na najvišji ravni bo ClickHouse razumel, da je prišla replikacija, ki je še prazna in nanjo je treba začeti prenašati podatke. T. j. ta postopek še ni dobro avtomatiziran.
Hvala za vaš govor! Ko pride do težav, operater pade in se ponovno zažene, hkrati pa prihajajo dogodki, kako jih obdelujete?
Kaj se zgodi, če operater pade in se ponovno zažene, ja?
Da. In hkrati so prišli dogodki.
Naloga, kaj narediti v tem primeru, se delno deli med operaterja in Kubernetes. Kubernetes ima možnost predvajati zgodnje dogodke. To predvaja. Naloga operaterja je, da poskrbi, da so ti dogodki idempotentni, ko se izvede predvajanje dnevnika dogodkov. In da ponovni vstop istega dogodka ne zlomi našega sistema. In naš operater obvladuje to nalogo.
Pozdravljeni! Hvala za vaš govor! Dmitrij Zavjalov, podjetje Smedova. Ali je predvideno dodajanje možnosti konfiguracije operatorja s haproxy? Interesira me kakšen drug uravnoteževalnik poleg standardnega, ki bi bil pameten in bi razumel, da je ClickHouse.
Govoriš o Ingressu?
Da, zamenjati Ingress s haproxy. V haproxy lahko navedete topologijo klasterja, kjer ima replikacije.
Zaenkrat o tem nismo razmišljali. Če vam je to potrebno in lahko razložite, zakaj je to potrebno, bi to lahko uresničili, še posebej, če želite sodelovati. Z veseljem bomo preučili to možnost. Kratek odgovor - ne, trenutno takšne funkcionalnosti nimamo. Hvala za namig, to bomo preučili. Če pa še razložite use case in zakaj je to v praksi potrebno, na primer, če ustvarite težave na GitHubu, bi bilo to odlično.
Že je.
Dobro. Odprti smo za vse predloge. Haproxy je na seznamu, ki ga je treba urediti. Seznam opravil se širi, ne zmanjšuje za zdaj. Ampak to je dobro, to pomeni, da je izdelek iskan.
Izvor: habr.com
