

Analitična SODB ClickHouse obdeluje veliko različnih nizov, kar porablja vire. Da bi pospešili delovanje sistema, se nenehno dodajajo nove optimizacije. Razvijalec ClickHouse Nikolaj Kočetov govori o nizu podatkov, vključno z novim tipom, LowCardinality, in pojasnjuje, kako lahko pospešimo delo z nizi.
— Najprej se pogovorimo o tem, kako lahko shranjujemo nize.
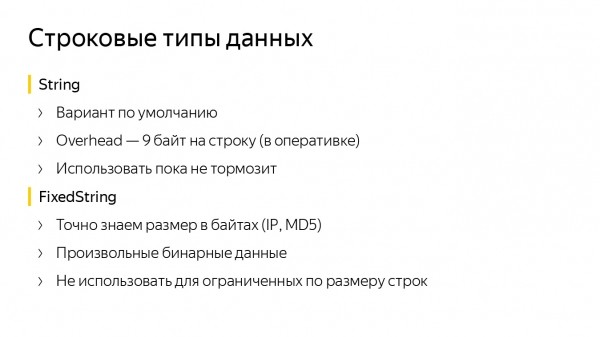
Imamo nize podatkov. String je privzeto dobro odmerjen, zato ga je skoraj vedno vredno uporabiti. Ima majhen Overhead — 9 bajtov na en niz. Če želimo, da je velikost nizov fiksna in znana vnaprej, je bolje uporabiti FixedString. V njem lahko določimo potrebno število bajtov, kar je priročno za podatke, kot so IP-naslovi ali hash-funkcije.
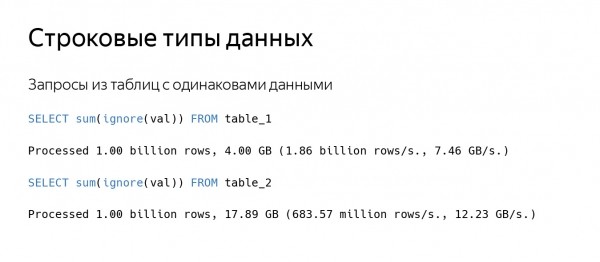
Seveda, včasih kaj upočasni delovanje. Recimo, da izvajate poizvedbo v tabeli. ClickHouse bere kar veliko podatkov, recimo s hitrostjo 100 GB/s, pri tem pa obdeluje malo nizov. Imamo dve tabeli, ki hranita skoraj enake podatke. Iz druge tabele ClickHouse bere podatke z večjo hitrostjo, a na sekundo se preberejo trije krat manj nizov.
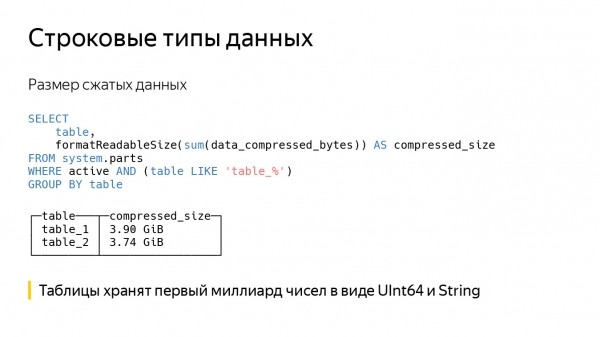
Če pogledamo na velikost stisnjenih podatkov, je skoraj enaka. V resnici so v tabelah zapisani isti podatki — prvi milijard števil — le da je v prvem stolpcu zapisan kot UInt64, v drugem pa kot String. Zaradi tega drugi poizvedba dlje bere podatke z diska in jih razpakira.
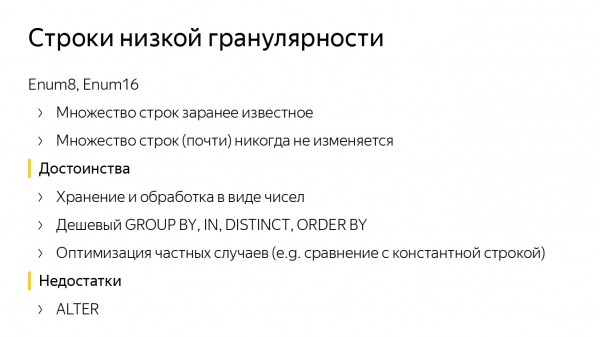
Tukaj je še en primer. Predpostavimo, da obstaja vnaprej znan nabor nizov, ki je omejen na 1000 ali 10 000 in skoraj nikoli ne spremeni. V tem primeru nam ustreza tip podatkov Enum, v ClickHouse pa sta dva — Enum8 in Enum16. S shranjevanjem v Enum hitro obdelujemo poizvedbe.
V ClickHouse so pospešitve za GROUP BY, IN, DISTINCT in optimizacije za nekatere funkcije, na primer za primerjavo s konstantnim nizom. Seveda se številke v nizu ne pretvarjajo, nasprotno, konstantni niz se pripelje do vrednosti Enum. Po tem se vse hitro primerja.
Toda obstajajo tudi slabosti. Tudi če poznamo natančen nabor nizov, ga je včasih treba dopolniti. Prišla je nova vrstica — moramo izvesti ALTER.
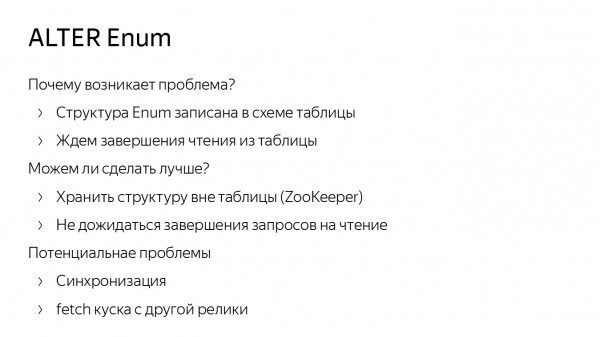
ALTER za Enum v ClickHouse je optimiziran. Ne prepisujemo podatke na disku, vendar pa lahko ALTER upočasni delovanje zaradi shranjevanja struktur Enum v shemi same tabele. Zato moramo počakati na zahteve za branje iz tabele, na primer.
Postavlja se vprašanje, ali lahko to izboljšamo? Verjetno ja. Strukturo Enum je mogoče shraniti ne v shemi tabele, ampak v ZooKeeperju. Vendar se lahko pojavijo težave s sinhronizacijo. Na primer, ena replika je prejela podatke, druga pa ne, in če ima starejši Enum, se lahko nekaj pokvari. (V ClickHouse smo skoraj končali z nebločečimi ALTER poizvedbami. Ko jih bomo dokončali, ne bo treba čakati na zahteve za branje.)
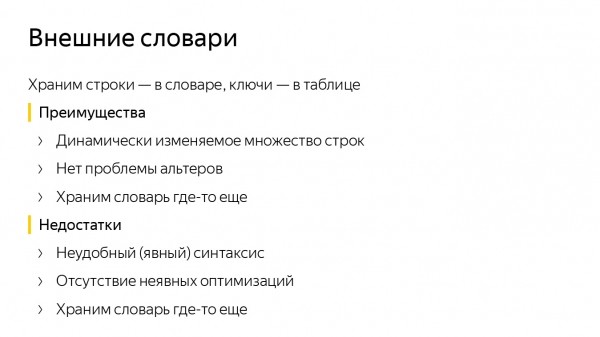
Da se izognemo težavam z ALTER Enum, lahko uporabimo zunanje slovarje ClickHouse. Spomnim, da je to struktura podatkov key-value znotraj ClickHouse, s katero lahko pridobimo podatke iz zunanjih virov, na primer iz tabel MySQL.
V slovarju ClickHouse shranjujemo več različnih nizov, v tabeli pa so njihovi identifikatorji v obliki številk. Če potrebujemo niz, pokličemo funkcijo dictGet in delamo z njim. Po tem nam ni treba izvesti ALTER. Da dodamo nekaj v Enum, ga vstavimo v isto tabelo MySQL.
Toda tu se pojavijo druge težave. Najprej neprijetna sintaksa. Če želimo pridobiti niz, moramo poklicati dictGet. Drugič, pomanjkanje nekaterih optimizacij. Primerjava s stalnim nizom za slovarje ni tako hitra.
Lahko pa se pojavijo težave z posodabljanjem. Predpostavimo, da smo zahtevali niz v slovarju s predpomnilnikom, vendar v predpomnilnik ni prišel. Takrat moramo počakati, da se podatki naložijo iz zunanjega vira.
Splošna pomanjkljivost obeh metod je, da vse ključe shranjujemo na enem mestu in jih sinhroniziramo. Zakaj ne bi shranili slovarjev lokalno? Brez sinhronizacije ni težav. Slovar lahko shranimo lokalno v delu na disku. Torej smo izvedli Insert, zapisali slovar. Če delamo s podatki v pomnilniku, lahko slovar zapišemo v blok podatkov, ali v del stolpca, ali v nekakšen predpomnilnik, da pospešimo izračune.
Slojno kodiranje nizov
Tako smo prišli do ustvarjanja novega tipa podatkov v ClickHouse - LowCardinality. To je format shranjevanja podatkov: kako se zapisujejo na disk in kako se berejo, kako so predstavljeni v pomnilniku in shema njihove obdelave.
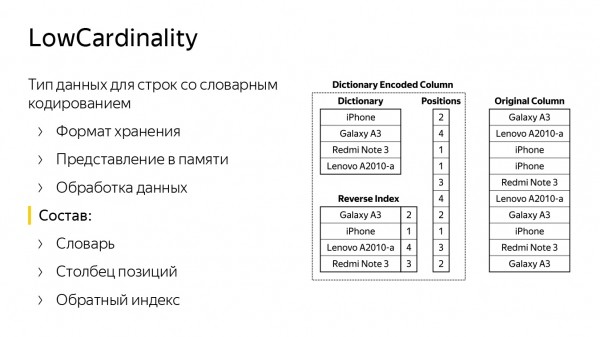
Na diapozitivu se nalaze dva stupca. Desno se redovi standardno pohranjuju kao String. Vidljivo je da su to neki modeli mobilnih telefona. S lijeve strane je identičan stupac, samo tipa LowCardinality. Sastoji se od rječnika s mnoštvom različitih redova (redovi iz desnog stupca) i popisa pozicija (brojevi redova).
Pomoću ove dvije strukture može se obnoviti izvorni stupac. Također postoji obratni indeks — hash-tablica koja pomaže pronaći poziciju u rječniku prema redu. Ona je potrebna za ubrzavanje nekih upita. Na primjer, ako želimo usporediti, potražiti red u našem stupcu ili ih spojiti.
LowCardinality je parametrijski tip podataka. Može biti ili broj, ili nešto što se pohranjuje u obliku broja, ili niz, ili Nullable od njih.
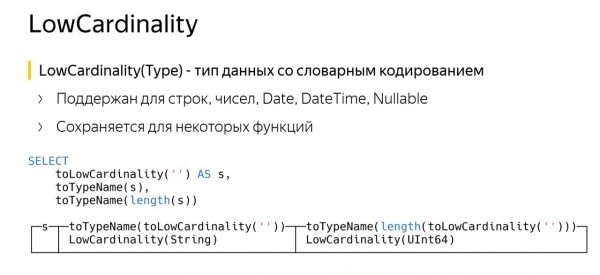
Posebnost LowCardinality je u tome što se može pohraniti za neke funkcije. Na diapozitivu je prikazan primjer upita. U prvom redu sam stvorio stupac tipa LowCardinality od String, nazvao ga S. Nadalje, upitao sam njegovo ime — ClickHouse je rekao da je to LowCardinality od String. Sve je točno.
Treći red je gotovo identičan, samo što smo pozvali funkciju length. U ClickHouse funkcija length vraća tip podataka UInt64. No, postali smo LowCardinality od UInt64. Koja je svrha?
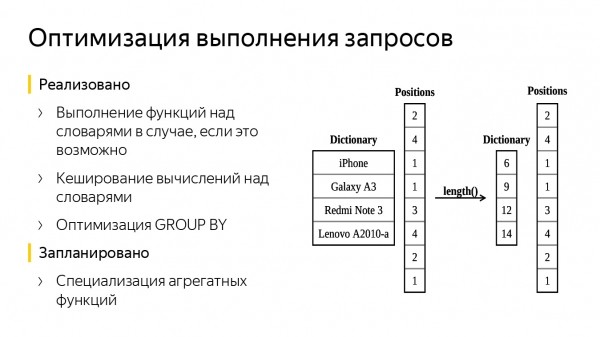
U rječniku su bila pohranjena imena mobilnih telefona, primijenili smo funkciju length. Sada imamo odgovarajući rječnik, sastavljen samo od brojeva — to su duljine nizova. Stupac s pozicijama nije se promijenio. Na kraju smo obradili manje podataka i uštedjeli na vremenu upita.
Mogu postojati i druge optimizacije, kao što je dodavanje jednostavnog cache-a. Tijekom izračunavanja vrijednosti funkcije može se zapamtiti i stvoriti ista, ne izračunavati ponovno.
Također se može napraviti optimizacija GROUP BY, jer je naš stupac s rječnikom već djelomično agregiran — može se brže izračunati vrijednost hash-funkcija i otprilike pronaći bucket u koji će se staviti sljedeći red. Također se mogu specijalizirati neke agregatne funkcije, poput uniq, jer se može poslati samo rječnik, dok pozicije ostaju netaknute — tako će sve raditi brže. Prve dvije optimizacije već smo dodali u ClickHouse.
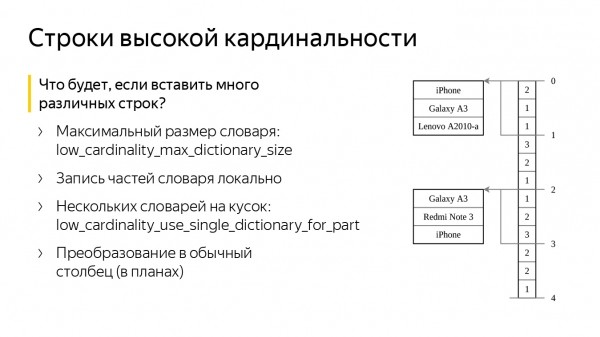
Kaj, če ustvarimo stolpec s našimi tipi podatkov in vanj vstavimo veliko slabih različnih vrstic? Ali se naša pomnilnika ne bo prepolnila? Ne, ClickHouse ima za to dve posebni nastavitvi. Prva je low_cardinality_max_dictionary_size. To je največja velikost slovarja, ki se lahko shrani na disk. Vstavljanje poteka tako, da, ko vstavljamo podatke, pride do nas tok vrstic, iz katerih oblikujemo velik skupni slovar. Ko slovar postane večji od vrednosti nastavitve, zapišemo trenutni slovar na disk, preostale vrstice pa shranimo nekje „na strani“, blizu indeksov. Tako nikoli ne preštejemo velikega slovarja in nimamo težav s pomnilnikom.
Druga nastavitev se imenuje low_cardinality_use_single_dictionary_for_part. Predstavljajte si, da se je v prejšnjem sistemu, ko smo vstavili podatke, naš slovar prepolnil in smo ga zapisali na disk. Pojavi se vprašanje, zakaj zdaj ne bi oblikovali še enega enakega slovarja?
Ko se bo prepolnil, ga spet zapišemo na disk in začnemo oblikovati tretjega. Ta nastavitev pravzaprav privzeto onemogoča to možnost.
Dejansko je veliko slovarjev lahko koristnih, če želimo vstaviti neko množico vrstic, a smo naključno vstavili "odpadke". Recimo, da smo najprej vstavili slabe vrstice, nato pa dobre. Takrat se bo slovar razdelil na veliko manjših slovarjev. Del njih bo z "odpadki", toda zadnji bodo z dobrimi vrsticami. In če preberemo, recimo, samo zadnjo granulo, bo vse še vedno delovalo hitro.
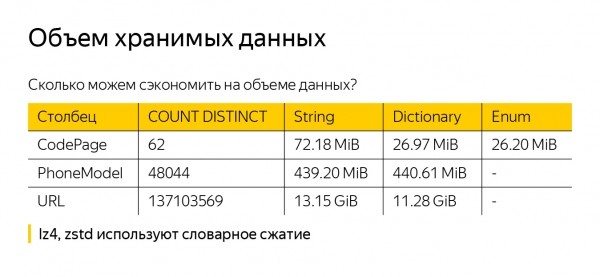
Preden govorimo o prednostih LowCardinality, takoj povem, da verjetno ne bomo dosegli zmanjšanja podatkov na disku (čeprav se to lahko zgodi), ker ClickHouse stisne podatke. Obstaja privzeta možnost — LZ4. Prav tako lahko izvedemo stiskanje z ZSTD. Toda oba algoritma že izvajata slovarsko stiskanje, zato naš zunanji slovar ClickHouse ne bo veliko pomagal.
Da ne bi bio neosnovan, uzeo sam neke podatke iz metrike — String, LowCardinality(String) i Enum — i sačuvao ih u različitim tipovima podataka. Rezultat su tri kolone u kojima je zabeleženo milijardu redova. U prvoj koloni, CodePage, ima ukupno 62 vrednosti. I vidimo da je LowCardinality(String) postigao bolje kompresovanje. String je nešto slabiji, ali to je verovatno zbog toga što su stringovi kratki, čuvamo njihove dužine, a one zauzimaju mnogo prostora, slabo se kompresuju.
Ako uzmemo PhoneModel, ima ih 48 hiljada — već više, i razlike između String i LowCardinality(String) gotovo da nema. Takođe, za URL smo uštedeli samo 2 GB — mislim da ne treba da se oslanjamo na to.
Procena brzine rada
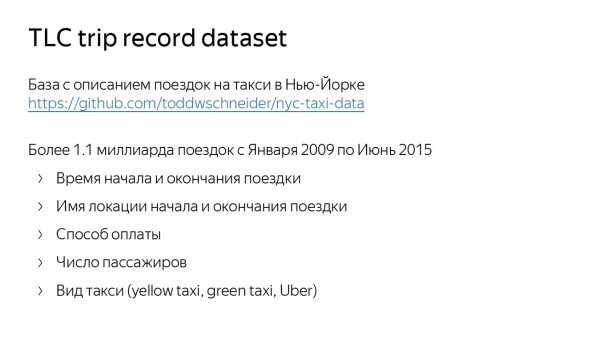
Sada ćemo proceniti brzinu rada. Da bismo to uradili, koristio sam dataset sa opisima taksi vožnji u Njujorku. To je na GitHub-u. U njemu je nešto više od milijardu vožnji. Tu su prikazane lokacija, vreme početka i završetka vožnje, način plaćanja, broj putnika i čak vrsta taksija — zelena, žuta i Uber.
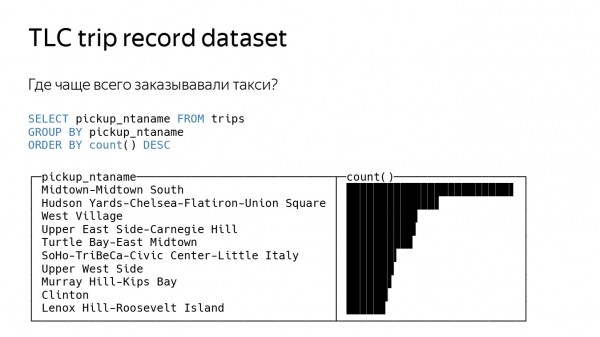
Prvi upit sam napravio prilično jednostavnim — pitao sam gde se najčešće naručuju taksiji. Za to je potrebno uzeti lokaciju sa koje su naručeni, grupisati je po njoj i prebrojati funkciju count. ClickHouse daje neki rezultat.
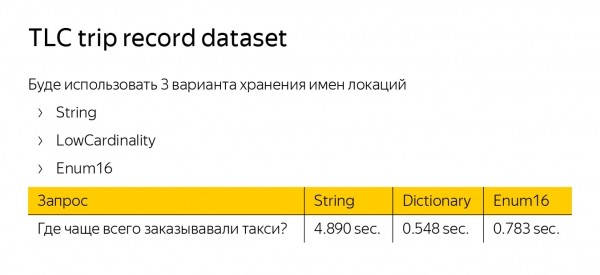
Da bismo izmerili brzinu obrade upita, napravio sam tri tabele sa istim podacima, ali za našu početnu lokaciju koristio tri različita tipa podataka — String, LowCardinality i Enum. LowCardinality i Enum su bili pet puta brži od String. Enum je brži zato što radi sa brojevima. LowCardinality — zato što je implementirana optimizacija GROUP BY.
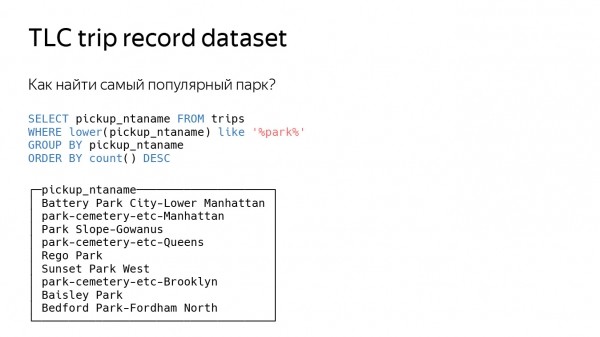
Hajde da još malo zakomplikujemo upit — pitamo gdje se nalazi najpopularniji park u Njujorku. Ponovo ćemo to meriti prema tome gde se najčešće naručuju taksiji, ali ćemo filtrirati samo one lokacije gde se nalazi reč "park". Takođe, dodajemo funkciju like.
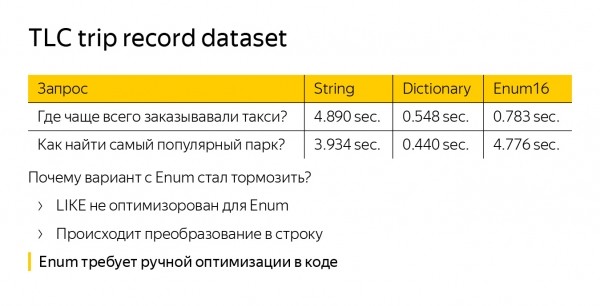
Gledamo vreme — vidimo da je Enum iznenada počeo usporavati. Uz to, radi još sporije od standardnog tipa podataka String. To se dešava zato što funkcija like nije optimizovana za Enum. Moramo da pretvaramo naše stringove iz Enum u obične stringove — radimo više posla. LowCardinality(String) nije takođe podrazumevano optimizovan, ali tu like radi nad rečnikom, pa je upit ubrzan u poređenju sa String.
Pri delu z Enum obstaja bolj globalen problem. Če ga želimo optimizirati, moramo to storiti na vsakem mestu v kodi. Recimo, da smo napisali novo funkcijo — nujno je potrebno razviti optimizacijo za Enum. V LowCardinality pa je vse privzeto optimizirano.
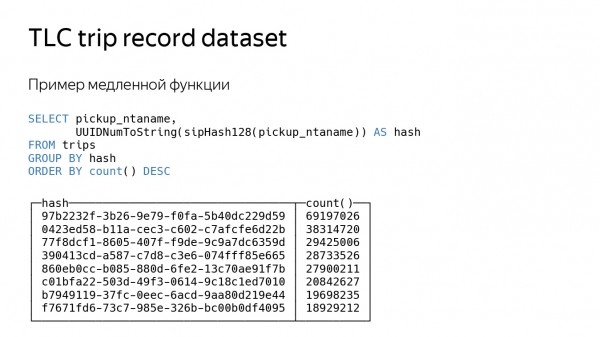
Poglejmo zadnji poizvedbo, ki je bolj umetna. Preprosto bomo izračunali hash funkcijo naše lokacije. Hash funkcija je precej počasen poizvedba, traja dolgo, zato se vse upočasni za približno trikrat.
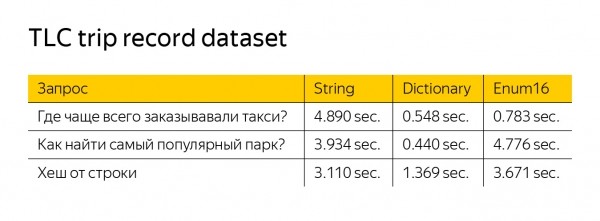
LowCardinality še vedno deluje hitreje, čeprav tukaj ni filtriranja. To se dogaja, ker naše funkcije delujejo samo nad slovarjem. Funkcija za izračun hasha ima en argument — obravnava lahko manj podatkov in tudi vrača LowCardinality.
Naš globalni načrt je doseči hitrost dela, ki ni nižja od String v vseh primerih, in ohraniti pospeške. In morda bomo enkrat zamenjali String z LowCardinality, vi boste posodobili ClickHouse in vse bo delovalo nekoliko hitreje.
Izvor: habr.com
