

Kako povečati število poizvedb v podatkovni bazi za 10-krat, ne da bi prešli na zmogljivejši strežnik, in ohraniti delovanje sistema? Povedal bom, kako smo se borili z upadom zmogljivosti naše baze podatkov in kako smo optimizirali SQL poizvedbe, da bi služili čim več uporabnikom, ne da bi povečali stroške računalniških virov.
Ustvarjam storitev za upravljanje poslovnih procesov v gradbenih podjetjih. Z nami sodeluje približno 3000 podjetij. Več kot 10.000 ljudi vsak dan uporablja naš sistem od 4 do 10 ur. Rešuje različne naloge načrtovanja, obveščanja, opozarjanja, validacije… Uporabljamo PostgreSQL 9.6. V naši podatkovni bazi je približno 300 tabel in vsak dan v njej obdelamo do 200 milijonov poizvedb (10.000 različnih). Povprečno imamo od 3000 do 4000 poizvedb na sekundo, v najaktivnejših trenutkih pa več kot 10.000 poizvedb na sekundo. Večina poizvedb je OLAP. Dodatkov, sprememb in brisanj je bistveno manj, torej je obremenitev OLTP relativno majhna. Te številke sem navedel, da lahko ocenite obseg našega projekta in razumete, kako koristen je lahko naš izkušnja za vas.
Prva slika. Lirična
Ko smo začeli z razvojem, nismo posebej razmišljali o tem, kakšna obremenitev bo na podatkovni bazi in kaj bomo storili, če strežnik ne bo zmogel. Pri načrtovanju podatkovne baze smo se držali splošnih priporočil in se trudili, da si ne bi streljali v koleno, vendar nismo šli dlje od splošnih nasvetov, kot je 'ne uporabljajte vzorca Nehali smo se ukvarjati. Načrtovali smo na osnovi načel normalizacije, ki so se izogibala odvečni podatkov in se nismo skrbeli za pospeševanje določenih poizvedb. Ko so prvi uporabniki prišli, smo se soočili s težavami produktivnosti. Kot ponavadi, nismo bili popolnoma pripravljeni na to. Prve težave so bile preproste. Običajno je vse rešila dodajanje novega indeksa. Toda prišel je trenutek, ko preproste popravke niso več delovale. Ko smo spoznali, da nam primanjkuje izkušenj in da postaja vse težje razumeti, v čem so težave, smo najeli strokovnjake, ki so nam pomagali pravilno nastaviti strežnik, povezati nadzor in nam pokazali, kam gledati, da bi dobili .
Druga slika. Statistična
Imamo približno 10.000 različnih poizvedb, ki se na naši bazi podatkov izvajajo na dan. Od teh 10.000 so 'monstri', ki se izvajajo 2-3 milijone krat s povprečnim časom izvajanja 0,1-0,3 ms, in so poizvedbe s povprečnim časom izvajanja 30 sekund, ki se izvajajo 100 krat na dan.
Optimizirati vseh 10.000 poizvedb ni bilo mogoče, zato smo se odločili, da ugotovimo, kam usmeriti prizadevanja za pravilno povečanje zmogljivosti baze podatkov. Po več iteracijah smo začeli razdeljevati poizvedbe na tipe.
TOP poizvedbe
To so najtežje poizvedbe, ki zahtevajo največ časa (skupni čas). To so poizvedbe, ki se bodisi zelo pogosto izvajajo ali poizvedbe, ki se zelo dolgo izvajajo (dolge in pogoste poizvedbe so bile optimizirane že v prvih iteracijah boja za hitrost). Končno za njihovo izvajanje strežnik porabi največ časa. Pomembno je ločiti top poizvedbe po skupnem času izvajanja in posebej po času IO. Načini optimizacije takih poizvedb so nekoliko različni.
Običajna praksa vseh podjetij je delo s TOP poizvedbami. Teh je malo; optimizacija tudi ene same poizvedbe lahko sprosti 5-10% virov. Vendar pa z 'odraščanjem' projekta optimizacija TOP poizvedb postaja vse bolj nenavadna naloga. Vse enostavne metode so že bile uporabljene, in najtežja poizvedba vzame 'samo' 3-5% virov. Če TOP poizvedbe skupaj zahtevajo manj kot 30-40% časa, ste verjetno že vložili trud, da delujejo hitro, in prišel je čas, da preidete na optimizacijo poizvedb iz naslednje skupine.
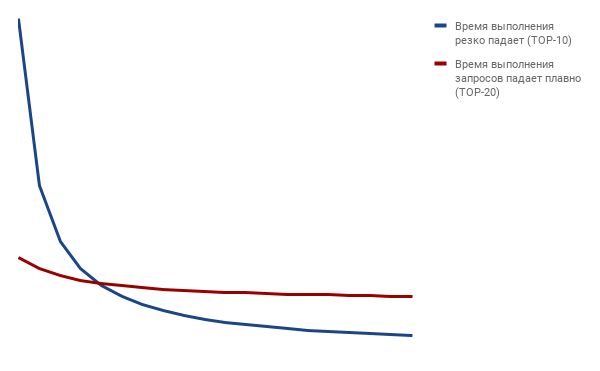
Ostaja odgovoriti na vprašanje, koliko vrhunskih poizvedb vključiti v to skupino. Običajno izberem najmanj 10, največ 20. Trudim se, da se čas prve in zadnje poizvedbe v TOP skupini ne razlikuje več kot 10-krat. To pomeni, da če čas izvajanja poizvedb močno pade s 1. mesta na 10., izberem TOP-10, če pa je padanje bolj postopno, povečam velikost skupine na 15 ali 20.
Srednjaki (medium)
To so vse poizvedbe, ki so takoj za TOP, razen zadnjih 5-10%. Običajno se v optimizaciji teh poizvedb skriva možnost, da močno povečate zmogljivost strežnika. Te poizvedbe lahko 'težo' do 80%. Vendar, če njihov delež preseže 50%, je čas, da se nanje povrnejo bolj pozorno.
Rep (tail)
Kot je bilo omenjeno, ti zahtevki prihajajo na koncu in zanje gre 5-10% časa. Nanje lahko pozabite, razen če ne uporabljate avtomatskih sredstev za analizo zahtevkov, takrat lahko tudi njihova optimizacija ostane nizkostroškovna.
Kako ovrednotiti vsako skupino?
Uporabljam SQL poizvedbo, ki pomaga doseči to oceno za PostgreSQL (prepričan sem, da lahko za mnoge druge DBMS napišemo podobno poizvedbo)
SQL poizvedba za oceno velikosti skupin TOP-MEDIUM-TAIL
SELECT sum(time_top) AS sum_top, sum(time_medium) AS sum_medium, sum(time_tail) FROM ( SELECT CASE WHEN rn 20 AND rn 800 THEN tt_percent ELSE 0 END AS time_tail FROM ( SELECT total_time / (SELECT sum(total_time) FROM pg_stat_statements) * 100 AS tt_percent, query, ROW_NUMBER () OVER (ORDER BY total_time DESC) AS rn FROM pg_stat_statements ORDER BY total_time DESC ) AS t ) AS ts
Rezultat poizvedbe so trije stolpci, od katerih vsak vsebuje delež časa, ki se porabi za obdelavo poizvedb iz te skupine. Znotraj poizvedbe sta dve številki (v mojem primeru 20 in 800), ki ločujeta poizvedbe ene skupine od druge.
Tako se približno razmerja deležev poizvedb na začetku optimizacijskih del in zdaj.
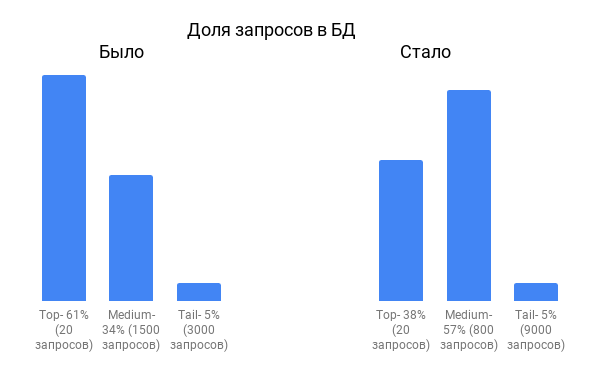
Iz grafa je razvidno, da se je delež TOP poizvedb močno zmanjšal, medtem ko so se »srednji« povečali.
Sprva so v TOP poizvedbe vstopali očitni napaki. Sčasoma so otroške bolezni izginile, delež TOP poizvedb pa se je zmanjšal, kar je zahtevalo vedno več truda za pospeševanje težkih poizvedb.
Da pridobimo besedilo poizvedb, uporabimo takšno poizvedbo
SELECT * FROM ( SELECT ROW_NUMBER () OVER (ORDER BY total_time DESC) AS rn, total_time / (SELECT sum(total_time) FROM pg_stat_statements) * 100 AS tt_percent, query FROM pg_stat_statements ORDER BY total_time DESC ) AS T WHERE rn 20 AND rn 800 -- TAIL
Tukaj je seznam najpogosteje uporabljenih metod, ki so nam pomagale pospešiti TOP poizvedbe:
- Redizajn sistema, na primer preklic logike obvestil na message broker namesto periodičnih poizvedb v DB.
- Dodajanje ali spreminjanje indeksov
- Prepisovanje ORM poizvedb na čisti SQL
- Prepisovanje logike načrtovane nalaganja podatkov
- Predpomnjenje prek denormalizacije podatkov. Na primer, imamo povezavo tabel Dostava -> Račun -> Poizvedba -> Vloga. To pomeni, da je vsaka dostava povezana z vlogo prek drugih tabel. Da ne bi povezovali vseh tabel v vsaki poizvedbi, smo podvojili povezavo na vlogo v tabeli Dostava.
- Keširanje statičnih tabel s referentnim podatků ter redko spreminjajočih se tabel v pomnilniku programa.
Nekatera sprememba je zahtevala obsežnejšo prenovo, a so prinesla 5-10% razbremenitve sistema in bila upravičena. Sčasoma se je izhod zmanjšal, prenova pa je postajala vse bolj zahtevna.
Takrat smo se osredotočili na drugo skupino poizvedb - skupino srednjerazrednih. V njej je bilo znatno več poizvedb in zdelovalo se je, da bo analiza cele skupine vzela precej časa. Vendar so se izkazale številne poizvedbe za zelo enostavne za optimizacijo, mnoge težave pa so se ponavljale v različnih različicah. Tukaj so primeri nekaterih tipičnih optimizacij, ki smo jih uporabljali za desetine podobnih poizvedb in vsaka skupina optimiziranih poizvedb je razbremenila DB za 3-5%.
- Namesto preverjanja obstoja zapisov s pomočjo COUNT in popolnega skeniranja tabele smo začeli uporabljati EXISTS.
- Znebili smo se DISTINCT (ni splošnega recepta, a ga je včasih mogoče enostavno odstraniti in tako pospešiti poizvedbo od 10 do 100-krat).
Na primer, namesto poizvedbe za izbiro vseh voznikov iz velike tabele dostav (DELIVERY)
SELECT DISTINCT P.ID, P.FIRST_NAME, P.LAST_NAME
FROM DELIVERY D JOIN PERSON P ON D.DRIVER_ID = P.ID
smo naredili poizvedbo po razmeroma majhni tabeli PERSON.
SELECT P.ID, P.FIRST_NAME, P.LAST_NAME
FROM PERSON
WHERE EXISTS(SELECT D.ID FROM DELIVERY WHERE D.DRIVER_ID = P.ID)
Zdelalo se je, da smo uporabili koreliran podpoizvedek, a ta prinaša pospešek več kot 10-krat.
- V mnogih primerih smo se sploh odpovedali COUNT in
- namesto
UPPER(s) LIKE 'JOHN%'koristimo
s ILIKE 'John%'
Vsako posebno poizvedbo smo lahko pospešili od 3 do 1000-krat. Kljub impresivnim rezultatom se nam je sprva zdelo, da ni smisla za optimizacijo poizvedbe, ki se izvaja 10 ms, spada v 300 najbolj obremenilnih poizvedb in v splošnem času obremenitve na DB zaseda stotinke odstotka. A s tem, da smo uporabili isti recept za skupino enako vrsto poizvedb, smo pridobili nekaj odstotkov. Da ne bi porabili časa za ročno pregledovanje vseh sto poizvedb, smo napisali nekaj preprostih skript, ki so s pomočjo regularnih izrazov našli podobne poizvedbe. V končni fazi je samodejno iskanje skupin poizvedb omogočilo še dodatno izboljšanje naše učinkovitosti ob skromnem naporu.
Na koncu smo že tri leta na istem strežniku. Povprečna dnevna obremenitev je okoli 30%, v vrhunskih trenutkih doseže do 70%. Število poizvedb in uporabnikov se je povečalo približno desetkrat. In vse to je zahvaljujoč konstantnemu spremljanju skupin poizvedb TOP-MEDIUM. Takoj, ko se nova poizvedba pojavi v skupini TOP, jo analiziramo in poskušamo pospešiti. Skupino MEDIUM enkrat na teden pregledamo s pomočjo analitičnih skriptov. Če naletimo na nove poizvedbe, za katere že vemo, kako optimizirati, jih hitro spremenimo. Občasno odkrijemo nove načine optimizacije, ki jih lahko takoj uporabimo na več poizvedbah.
Po naših napovedih trenutni strežnik še prenese povečanje števila uporabnikov od 3 do 5 krat. Imamo pa še en as v rokavu - še nismo prenesli SELECT poizvedb na ogledalo, kot je priporočeno. A tega ne delamo namerno, saj želimo najprej v celoti izkoristiti možnosti 'pametne' optimizacije, preden vključimo 'težko artilerijo'.
Kritičen pogled na opravljeno delo nam lahko svetuje, da uporabimo vertikalno skaliranje. Kupi močnejši strežnik, namesto da bi zapravljali čas strokovnjakov. Strežnik morda ni tako drag, še posebej ker naše meje vertikalnega skaliranja še niso izčrpane. Kljub temu se je le število poizvedb povečalo 10 krat. V zadnjih letih se je povečala funkcionalnost sistema in zdaj je raznolikost poizvedb večja. Tista funkcionalnost, ki je bila na voljo, se s pomočjo predpomnjenja izvaja z manj poizvedbami, in tudi učinkovitejšimi poizvedbami. To pomeni, da lahko navadno pomnožimo še s 5, da dobimo pravi koeficient pospešitve. Tako lahko po najbolj skromnih izračunih rečemo, da je pospešitev znašala 50 in večkrat. Vertikalno povišanje strežnika 50 krat bi bilo dražje. Še posebej ob upoštevanju, da optimizacija, ki je bila izvedena enkrat, deluje ves čas, medtem ko račun za najet strežnik prihaja vsak mesec.
Izvor: habr.com
