

Kaj lahko tako veliko podjetje, kot je Lamoda, s prefinjenim procesom in desetimi medsebojno povezanimi storitvami, preoblikuje svoj pristop? Motivacija je lahko povsem različna: od zakonodajnih sprememb do inherentne želje vseh programerjev po eksperimentiranju.
Vendar to ne pomeni, da ni mogoče računati na dodatne koristi. O tem, kaj konkretno lahko pridobimo z uvedbo events-driven API na Kafka, bo spregovoril Sergey Zaika (). O preizkušnjah in zanimivih odkritjih bo prav tako nujno govora – eksperimenti se ne morejo izogniti temu.
Omejitev: Ta članek temelji na gradivu s srečanja, ki ga je Sergey izvedel novembra 2018 na HighLoad++. Živahna izkušnja Lamoda pri delu s Kafka je privabila poslušalce enako kot druge predstavitve v razporedu. Mislimo, da je to odličen primer, da vedno lahko in je treba najti somišljenike, organizatorji HighLoad++ pa se bodo še naprej trudili ustvarjati vzdušje, ki to spodbuja.
O procesu
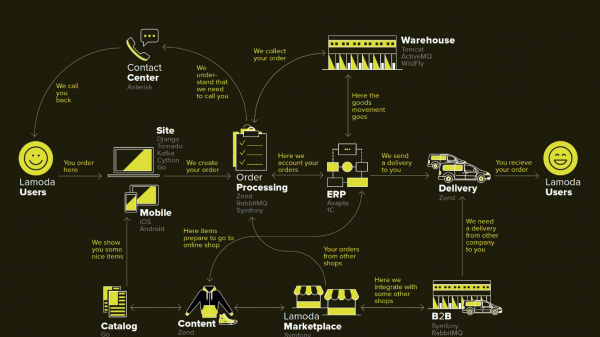
Lamoda je velika e-commerce platforma, ki ima svoj kontaktni center, dostavno službo (in številne partnerje), fotografski studio, ogromno skladišče in vse to deluje na svoji programski opremi. Obstaja na desetine načinov plačila, B2B partnerji, ki lahko uporabljajo del teh ali vseh storitev in želijo vedeti aktualne informacije o svojih izdelkih. Poleg tega Lamoda deluje v treh državah poleg RF, kjer je vse rahlo drugače. Na voljo je verjetno več sto načinov konfiguracije novega naročila, ki ga je treba obravnavati na svoj način. Vse to deluje s pomočjo desetine storitev, ki se med seboj pogosto sporazumevajo na način, ki ni vedno očiten. Obstaja tudi osrednji sistem, katerega glavna odgovornost so statusi naročil. Imenujemo ga BOB, jaz delam zanj.
Orodje za vračilo z events-driven API
Beseda events-driven je precej zveličavna, kasneje bomo podrobneje opredelili, kaj to pomeni. Začel bom s kontekstom, v katerem smo se odločili preizkusiti pristop events-driven API na Kafka.
V vsakem trgovini, poleg naročil, za katera kupci plačujejo, pridejo trenutki, ko od trgovine zahtevajo vračilo denarja, ker izdelek ni ustrezal željam kupca. Ta relativno kratek proces vključuje pojasnitev informacij, če je to potrebno, in vračilo denarja.
Vendar se je proces vračila zapletel zaradi spremembe zakonodaje, zato smo morali razviti ločen mikroservis.
Naša motivacija:
- Zakon FZ-54 — na kratko, zakon zahteva, da se o vsaki denarni transakciji poroča davčni upravi, naj bo to vračilo ali prihod, v zelo kratkem času, ki običajno ne presega nekaj minut. Mi, kot e-trgovina, izvajamo precej veliko transakcij. Tehnično to pomeni novo odgovornost (kar pomeni nov servis) in dopolnila v vseh povezanih sistemih.
- BOB split — interni projekt podjetja za osvoboditev BOB-a velikega števila nepriproductivnih odgovornosti in zmanjšanje njegove skupne kompleksnosti.
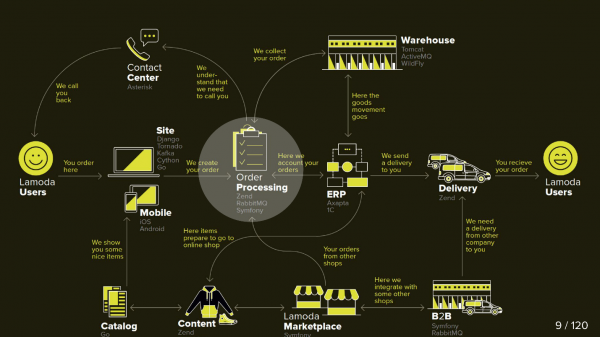
Na tej shemi so prikazani glavni sistemi Lamoda. Zdaj večina od njih predstavlja bolj zvezdnato nebo 5-10 mikroservisov okoli zmanjšujočega se monolita. Počasi rastejo, a trudimo se, da jih je manj, ker je zastrašujoče, ko je treba v sredino potisniti nov segment – ne smemo dovoliti, da pade. Vsa izmenjava (puščice) mora biti rezervirana, saj se moramo zanašati, da je lahko katera od njih nedostopna.
Tudi v BOB-u je precej izmenjav: plačne sisteme, dostava, obvestila itd.
Tehnično je BOB:
- ~150k vrstic kode + ~100k vrstic testov;
- php7.2 + Zend 1 & Symfony Komponente 3;
- >100 API & ~50 odhodnih integracij;
- 4 države s svojo poslovno logiko.
Zagon BOB-a je drag in boleč, količina kode in nalog, ki jih rešuje, je taka, da jih nihče ne more imeti v celoti v mislih. Na splošno je veliko razlogov za poenostavitev.
Postopek vračila
Sprva sta v proces vključeni dve sistemi: BOB in Payment. Zdaj se pojavita še dve:
- Fiscalization Service, ki bo prevzel težave s fiskalizacijo in komunikacijo z zunanjimi storitvami.
- Refund Tool, v katerega se preprosto prenesejo nove izmenjave, da ne bi povečevali BOB-a.
Zdaj postopek izgleda takole:
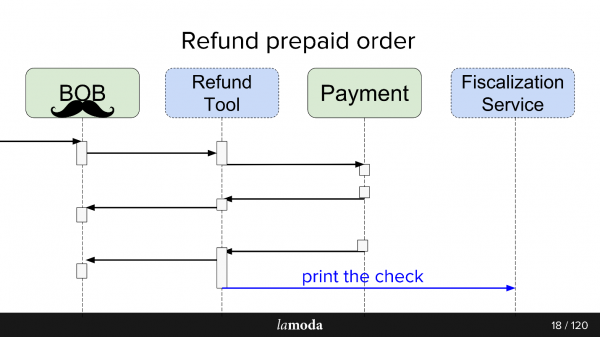
- BOB prejme zahtevo za vračilo denarja.
- BOB o tem obvesti Refund Tool.
- Refund Tool pove Payment: 'Vrni denar'.
- Payment vrne denar.
- Refund Tool in BOB usklajujeta statusa, ker ju trenutno oba potrebujeta. Še nismo pripravljeni popolnoma preklopiti na Refund Tool, ker ima BOB UI, poročila za računovodstvo in na splošno veliko podatkov, katerih tako enostavno ne moremo prenesti. Tako je treba sedeti na dveh stolih.
- Zahteva za fiskalizacijo gre naprej.
Tako smo ustvarili nekakšno dogodkovno kolektivno omrežje na Kafka, na katerem se vse temelji. Hura, zdaj imamo eno točko odpovedi (sarkazem).
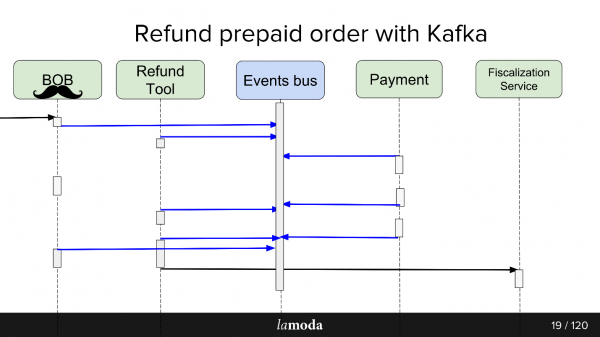
Prednosti in slabosti so precej očitne. Ustvarili smo kolektivno omrežje, kar pomeni, da zdaj vsi storitve nanj računajo. To poenostavi načrtovanje, a prinaša v sistem eno točko odpovedi. Če Kafka odpove, postopek stoji.
Kaj je API, ki temelji na dogodkih
Dober odgovor na to vprašanje najdemo v poročilu Martina Fowlersa (GOTO 2017) .
Na kratko, kar smo naredili:
- Obvili smo vse asinkrone izmenjave preko shramba dogodkov. Namesto da bi vsakemu zainteresiranemu uporabniku sporočili spremembo stanja po omrežju, zapisujemo v centralizirano shrambo dogodek o spremembi stanja, zainteresirani uporabniki pa berejo vse, kar se tam pojavi.
- Dogodek (event) v tem primeru je obvestilo (obvestila) o tem, da se je nekaj nekje spremenilo. Na primer, spremenil se je status naročila. Uporabnik, ki mu so pomembni določeni spremljajoči podatki o spremembi statusa in katerih ni v obvestilu, lahko sam preveri njihovo stanje.
- Maksimalna različica je popoln event sourcing, prenos stanja, pri katerem dogodek vsebuje vse informacije, potrebne za obdelavo: od kod in v kateri status prešli, kako so se podatki spremenili in tako naprej. Vprašanje je le smiselnost in količina informacij, ki jih lahko shranite.
V okviru zagonnega orodja za vračilo sredstev smo uporabili tretjo možnost. To je poenostavilo obdelavo dogodkov, saj ni bilo treba pridobivati podrobnih informacij, poleg tega pa je izključilo scenarij, kjer vsako novo dogodek povzroči povečanje natančnih get-poizvedb s strani uporabnikov.
Storitveno orodje za vračilo sredstev ni obremenjeno, zato je Kafka tam bolj neka preizkušnja skrivnosti kot nuja. Ne mislim, da bi bil poslovni svet vesel, če bi postala storitev vračila sredstev projekt z visokim obremenitvami.
Asinkroni izmenjave AS IS
Za asinkrone izmenjave PHP oddelek običajno uporablja RabbitMQ. Zbiramo podatke za zahtevo, jih postavimo v čakalno vrsto, in uporabnik iste storitve jih prebere in pošlje (ali ne pošlje). Za samo API Lamoda aktivno uporablja Swagger. Načrtujemo API, opisujemo ga v Swaggerju, generiramo odjemalsko in strežniško kodo. Še uporabljamo nekoliko razširjen JSON RPC 2.0.
Nekje se uporabljajo esb-omrežja, nekdo živi na activeMQ, a na splošno, RabbitMQ — standard.
Async exchange TO BE
When designing exchange through events-bus, there is an analogy. We describe future data exchange similarly through event structure descriptions. We had to implement the YAML format and code generation ourselves; the generator creates DTO according to the specification and teaches clients and servers to work with them. Generation is done in two languages — golang and php. This allows us to keep the libraries consistent. The generator is written in golang, which is why it received the name gogi.
Event-sourcing on Kafka is typical. There is a solution from the main enterprise version Kafka Confluent, and there is , a solution from our 'brothers' in the domain area, Zalando. Our motivation to start with vanilla Kafka — is to keep the solution free until we decide whether we will use it universally, as well as to allow ourselves some room for maneuver and improvements: we want support for our JSON RPC 2.0, generators for two languages, and we will see what else.
Ironically, even in such a fortunate case, where there is a fairly similar business, Zalando, which made a similar solution, we cannot effectively utilize it.
Architecturally, at launch, the pattern is as follows: we read directly from Kafka but write only through the events-bus. For reading from Kafka, there are many ready-made solutions: brokers, load balancers, and it is more or less ready for horizontal scaling, which we wanted to preserve. For writing, we wanted to wrap it through one Gateway aka Events-bus, and here’s why.
Events-bus
Or event bus. This is just a stateless HTTP gateway that takes on several important roles:
- Validation of producing — we check that the events meet our specification.
- Master system for events, meaning this is the main and only system in the company that answers the question of which events with which structures are considered valid. Validation includes just data types and enums for strict content specification.
- Hash function for sharding — the structure of the Kafka message is key-value, and here the hash of the key is calculated to determine where to place it.
Why
We work in a large company with an established process. Why change anything? This is an experiment, and we expect to gain several advantages.
1:n+1 exchanges (one to many)
With Kafka, connecting new consumers to the API is very simple.
Recimo da imate imenik koji treba održavati ažurnim u nekoliko sistema odjednom (i u nekim novim). Nekada smo izmišljali bundle koji je implementirao set-API, a majstor-sistemu smo javljali adrese korisnika. Sada majstor-sistema šalje ažuriranja na temu, a svi koji su zainteresovani čitaju. Pojavila se nova sistema - prijavili smo je na temu. Da, opet bundle, ali jednostavnije.
U slučaju refund-alata, koji je u suštini deo BOB-a, zgodno nam je da ih održavamo sinhronizovanim putem Kafke. Payment kaže da je novac vraćen: BOB, RT su o tome obavešteni, promenili su svoje statuse, a Fiscalization Service je saznao i izdao fiskalni ček.
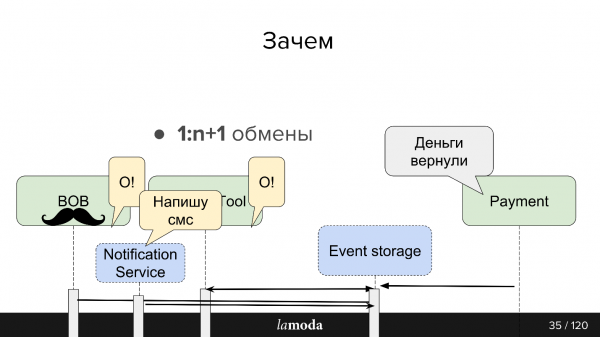
Imamo planove da napravimo jedinstveni Notifications Service, koji bi obaveštavao klijenta o novostima vezanim za njegovu porudžbinu/vratiti. Sada je ta odgovornost raspršena između sistema. Biće dovoljno da naučimo Notifications Service da hvata relevantne informacije iz Kafke i reaguje na njih (i isključimo ove obaveštenja u ostalim sistemima). Nema potrebe za novim direktnim razmenama.
Podaci vođeni
Informacije između sistema postaju transparentne - kakav god 'krvavi enterprise' da imate i kakav god debeli backlog da imate. U Lamodi postoji odeljenje za analizu podataka koje prikuplja podatke iz sistema i pretvara ih u ponovo upotrebljiv oblik, kako za biznis, tako i za inteligentne sisteme. Kakfa omogućava brzo pružanje velikih podataka i održavanje ovog informativnog toka aktuelnim.
Replikacijski log
Poruke ne nestaju nakon čitanja, kao u RabbitMQ-u. Kada događaj sadrži dovoljno informacija za obradu, dobijamo istoriju poslednjih promena po objektu, i, ako to želimo, mogućnost da te promene primenimo.
Rok čuvanja replikacijskog loga zavisi od intenziteta zapisa u ovu temu, Kafka omogućava fleksibilno podešavanje granica po vremenskom periodu i po obimu podataka. Za intenzivne teme važno je da svi potrošači stignu da pročitaju informacije pre nego što nestanu, čak i u slučaju kratkotrajnog nefunkcionisanja. Obično uspevamo da čuvamo podatke za jedinice dana, što je sasvim dovoljno za podršku.
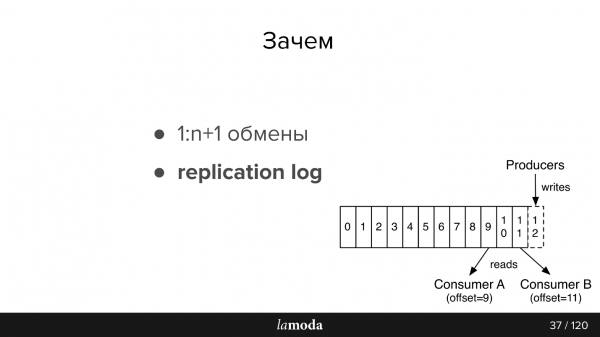
Dalje sledeći malo prepričane dokumentacije, za one koji nisu upoznati sa Kafka (slika je takođe iz dokumentacije)
V AMQP so vrste, ki jih pišemo v čakalno vrsto za porabnika. Običajno eno čakalno vrsto obdeluje en sistem z enako poslovno logiko. Če je potrebno obvestiti več sistemov, lahko aplikacijo naučimo pisati v več čakalnih vrst ali pa nastavimo exchange z mehanizmom fanout, ki jih sam klonira.
V Kafki obstaja podobna abstrakcija topic, v katero pišete sporočila, vendar ta ne izginejo po branju. Privzeto, ko se povežete s Kafko, prejmete vsa sporočila, hkrati pa imate možnost ohraniti mesto, kjer ste prenehali. Torej berete zaporedno, lahko ne označite sporočila kot prebranega, ampak ohranite id, s katerega boste nato nadaljevali z branjem. Id, na katerem ste prenehali, se imenuje offset, mehanizem pa commit offset.
Ustrezno lahko izvedemo različne logike. Na primer, naš BOB deluje v 4 instancah za različne države – Lamoda je prisotna v Rusiji, Kazahstanu, Ukrajini in Belorusiji. Ker se te delijo ločeno, imajo nekoliko svoje konfiguracije in svojo poslovno logiko. V sporočilu navedemo, kateri državi pripada. Vsak porabnik BOB v vsaki državi bere z različnimi groupId, in če sporočilo ni zanj, ga preskoči, tj. takoj zaključi offset +1. Če isti topic bere naš Payment Service, to stori z ločeno skupino, zato offseti ne sovpadajo.
Zahteve za dogodke:
- Popolnost podatkov. Želeli bi, da bi imel dogodek dovolj podatkov, da ga je mogoče obdelati.
- Celovitost. Deležujemo Events-bus preverjanje, da je dogodek dosleden in ga lahko obdelajo.
- Vrstni red je pomemben. V primeru vračila smo prisiljeni delati s zgodovino. Pri obvestilih vrstni red ni pomemben, če so to enotna obvestila, email bo enak ne glede na to, kateri naročilo je prišlo prvo. V primeru vračila pa imamo jasen postopek, sprememba vrstnega reda lahko privede do izjem, refund ne bo ustvarjen ali obdelan – prišli bomo v drug status.
- Konsistentnost. Imamo skladište, in zdaj namesto API-jev kreiramo dogodke. Potrebujemo način, kako hitro in poceni prenašati informacije o novih dogodkih in spremembah obstoječih v naše storitve. To dosežemo s skupno specifikacijo v posebnem git repozitoriju in generatorjih kode. Zato so naši odjemalci in strežniki v različnih storitvah usklajeni.
Kafka v Lamodi
Imamo tri namestitve Kafke:
- Dnevniki;
- R&D;
- Dogodkovna vozila.
Danes govorimo samo o zadnji točki. V dogodkovnem vozilu imamo relativno majhne namestitve – 3 posrednike (strežnike) in skupaj 27 tem. Na splošno je ena tema en proces. Ampak to je občutna zadeva, in sedaj se ji bomo posvetili.
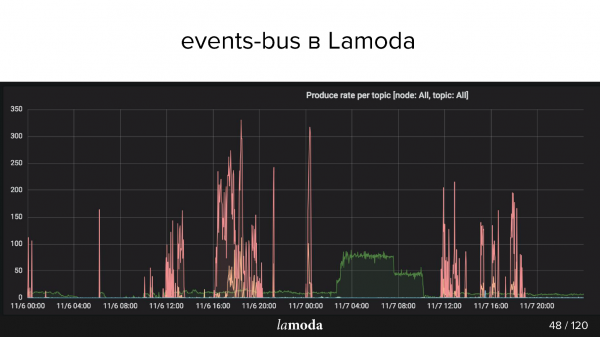
Zgoraj je graf rps. Proces vračil je označen s turkizno črto (ja, tisto, ki leži na osi X), roza pa proces posodabljanja vsebin.
Katalog Lamoda vsebuje milijone izdelkov, podatki pa se neprestano posodabljajo. Nekatere kolekcije izstopajo iz mode, na njihovo mesto pa prihajajo nove, v katalogu nenehno nastajajo novi modeli. Trudimo se napovedati, kaj bo zanimivo našim strankam jutri, zato nenehno kupujemo nove stvari, jih fotografiramo in posodabljamo izložbo.
Roza vrhovi so posodobitve izdelkov, torej spremembe glede izdelkov. Vidimo, da so fantje fotografirali, fotografirali, nato pa bum! — naložili paket dogodkov.
Uporabni primeri Lamoda dogodkov
Zgrajeno arhitekturo uporabljamo za takšne operacije:
- Spremljanje statusov vračil: poziv k akciji in sledenje statusom iz vseh vpletenih sistemov. Plačilo, statusi, fiskalizacija, obvestila. Tukaj smo preizkusili pristop, naredili orodja, zbrali vse napake, napisali dokumentacijo in povedali kolegom, kako to uporabljati.
- Posodobitev kartic izdelkov: konfiguracija, meta-podatki, lastnosti. En sistem bere (ki prikazuje), več njih pa piše.
- Email, push in SMS: naročilo je bilo zbrano, naročilo je prispelo, vračilo je sprejeto itd., veliko jih je.
- Zaloga, posodobitev skladišča — kvantitativna posodobitev nazivov, samo številke: prejeme na skladišče, vračila. Vse sisteme, povezane z rezervacijo izdelkov, je potrebno obveščati z najboljšimi aktualnimi podatki. Trenutno je sistem posodabljanja zaloge precej zapleten, Kafka pa ga bo poenostavila.
- Analiza podatkov (R&D oddelek), ML orodja, analitika, statistika. Želimo, da je informacija pregledna - za to je Kafka dobro rešitev.
Zdaj pa zanimivejši del o prehojenih potkah in zanimivih odkritjih, ki so se zgodila v pol leta.
Problemi s dizajnom
Recimo, da želimo narediti novo stvar - na primer, prenesti celoten postopek dostave na Kafka. Trenutno je del procesa realiziran v Order Processing v BOB. Za prenos naročila v dostavno službo, premikanje na vmesno skladišče in druge stvari stoji statusna model. Imajo celoten monolit, celo dva, plus kup API-jev, posvečenih dostavi. Vse to ve o dostavi veliko več.
Zdi se, da so to podobna področja, a za Order Processing v BOB in dostavni sistem se statusi razlikujejo. Na primer, nekatere kurirske službe ne posredujejo vmesnih statusov, temveč le končne: 'dostavljeno' ali 'izgubljeno'. Druge pa zelo podrobno poročajo o premikanju blaga. Vsaka ima svoja pravila validacije: za nekatere je veljaven email, kar pomeni, da ga bodo obdelali; za druge je neveljaven, a bo naročilo vseeno obdelano, ker je na voljo telefon za stik, nekdo drug pa bo dejal, da takega naročila sploh ne bodo obdelali.
Tok podataka
V primeru Kafka se poraja vprašanje organizacije pretoka podatkov. Ta naloga je povezana z izbiro strategije po več točkah, poglejmo jih vse.
V eno temo ali v različne?
Imamo specifikacijo dogodka. V BOB pišemo, da je treba dostaviti določeno naročilo, in navedemo: številko naročila, njegovo vsebino, različne SKU in črtne kode itd. Ko blago prispe v skladišče, lahko dostava pridobi statuse, časovne oznake in vse, kar je potrebno. A nato želimo v BOB prejemati posodobitve o teh podatkih. Tu se pojavi obratni proces pridobivanja podatkov iz dostave. Ali je to isti dogodek? Ali gre za ločeno izmenjavo, ki si zasluži ločeno temo?
Najverjetneje bodo močno podobni in skušnjava, da ustvarimo eno temo, ni neutemeljena, saj ločena tema pomeni ločene potrošnike, ločene nastavitve, ločeno generiranje vsega tega. A to ni nujno.
Novo polje ali nov dogodek?
Če pa uporabimo ista dogodka, se pojavi drug problem. Na primer, ne vse dostavne sisteme lahko generirajo tak DTO, ki bi lahko generiral BOB. Pošiljamo jim id, oni pa ga ne shranijo, ker ga ne potrebujejo, kar pa je z vidika začetka procesa event-bus obvezno polje.
Če za event-bus vpeljemo pravilo, da je to polje obvezno, smo prisiljeni v BOB ali v obdelovalcu začetnega dogodka dodati dodatna pravila za validacijo. Validacija se začne širiti po storitvi, kar ni zelo priročno.
Še en problem je skušnjava inkrementalnega razvoja. Pravijo nam, da moramo dodati nekaj v dogodek in, morda, če dobro razmislimo, bi to moralo biti poseben dogodek. V naši shemi je poseben dogodek poseben topic. Poseben topic pomeni celoten proces, ki sem ga opisal zgoraj. Razvijalcu nastane skušnjava, da enostavno doda še eno polje v JSON shemo in ponovno generira.
V primeru refunds smo tako po šestih mesecih prišli do dogodka dogodkov. Imeli smo eno meta-dogodke, ki se imenuje refund update, v katerem je bilo polje type, ki opisuje, v čem ta update sploh je. Imeli smo "čudovite" preklopnike z validatorji, ki so govorili, kako je treba validirati ta dogodek s tem type.
Versioniranje dogodkov
Za validacijo sporočil v Kafka lahko uporabimo , a takoj je bilo treba to vključiti in uporabiti Confluent. V našem primeru z versioniranjem moramo biti previdni. Ni vedno mogoče ponovno prebrati sporočil iz replication log, ker je model "odšel". Na splošno se trudimo zgraditi različice tako, da je model povratno združljiv: na primer, da začasno naredimo polje neobvezno. Če so razlike prevelike, začnemo pisati v nov topic, stranke pa preselimo, ko preberejo starega.
Jamstvo o vrstnem redu branja partitions
Topics znotraj Kafka so razdeljeni na partitions. To ni zelo pomembno, dokler projektiramo entitete in izmenjave, je pa pomembno, ko odločamo, kako to porabiti in razširiti.
V običajnem primeru napišete en topic v Kafka. Privzeto se uporablja en partition, in vse sporočila tega topica gredo vanj. Končna porabnik posledično to sporočilo bere zaporedno. Recimo, da zdaj morate razširiti sistem, tako da sporočila berejo dva različna končna porabnika. Če, na primer, pošiljate SMS, lahko rečete Kafki, da naredi dodaten partition, in Kafka bo začela razporejati sporočila v dve enoti - polovico tja, polovico sem.
Kako Kafka deli sporočila? Vsako sporočilo ima telo (v katerem hranimo JSON) in ima ključ. Na ta ključ lahko uporabite hash funkcijo, ki bo določila, v kateri partition bo sporočilo pristalo.
V našem primeru z refundacijami je to pomembno, če vzamemo dva partition, obstaja možnost, da bo paralelni končni porabnik obdelal drugo dogajanje pred prvim in bo prišlo do težav. Hash funkcija zagotavlja, da sporočila z enakim ključem pridejo v enako partition.
Dogodki vs ukazi
To je še ena težava, s katero se srečujemo. Dogodek je neko dogajanje: pravimo, da se je nekaj zgodilo (something_happened), na primer, item je bil preklican ali je nastala refundacija. Če ta dogodka nekdo posluša, bo ob 'item preklican' entiteta refundacija ustvarjena, medtem ko se ob 'nastala refundacija' zabeleži nekje v nastavitvah.
Toda običajno, ko načrtujete dogodke, nočete pisati brez pomisleka - predvidevate, da jih bo nekdo bral. Velika skušnjava je zapisati ne something_happened (item_canceled, refund_refunded), ampak something_should_be_done. Na primer, item je pripravljen za vračilo.
Z ene strani to nakazuje, kako bo dogodek uporabljen. Z druge strani pa to veliko manj spominja na običajno ime dogodka. Poleg tega, tukaj že ni daleč do ekipe do_something. Vendar pa nimate zagotovila, da je ta dogodek nekdo prebral; in če je prebral, je bil uspešno prebran; in če je bil uspešno prebran, je naredil nekaj, in to nekaj je potekalo uspešno. V trenutku, ko dogodek postane do_something, postane potrebna povratna informacija, in to je težava.
V asinhronem izmenjavanju v RabbitMQ, ko preberete sporočilo, greste na http, imate odgovor - vsaj, da je bilo sporočilo sprejeto. Ko zapišete v Kafka, dobite sporočilo, da ste zapisali v Kafka, vendar o tem, kako je bilo obdelano, ne veste nič.
Zato smo v našem primeru morali vnesti odzivni dogodek in nastaviti nadzor na to, da če se zgodi toliko dogodkov, bi moralo skozi tolikšno časovno obdobje priti enako število odzivnih dogodkov. Če se to ne zgodi, izgleda, da je šlo nekaj narobe. Na primer, če pošljemo dogodek „item_ready_to_refund“, pričakujemo, da se bo refundacija ustvarila, stranki se bodo vrnili denar, prejet bo dogodek „money_refunded“. Ampak to ni nujno, zato potrebujemo nadzor.
Nianse
Obstaja precej očiten problem: če berete zaporedoma z vrstice, in imate kakšno slabo sporočilo, potrošnik pade in naprej ne morete. Potrebno je ustaviti vse potrošnike, nadaljevati s komitiranjem offseta, da lahko nadaljujete z branjem.
Vedeli smo za to, predvideli smo to in kljub temu se je zgodilo. To se je zgodilo, ker je bilo sporočilo veljavno z vidika events-bus, sporočilo je bilo veljavno z vidika validatorja aplikacije, vendar ni bilo veljavno z vidika PostgreSQL, ker imamo v enem sistemu MySQL z UNSIGNED INT, v sveže napisanem sistemu pa je bil PostgreSQL preprosto z INT. Njegova velikost je nekoliko manjša, in Id ni ustrezal. Symfony je umrl s izjemo. Seveda smo ulovili izjemo, ker smo se nanjo pripravili, in želeli smo komitirati ta offset, toda pred tem smo želeli inkrementirati števec težav, saj se je sporočilo obdelalo neuspešno. Števec v tem projektu je prav tako shranjen v bazi, Symfony pa je že prenehal komunicirati z bazo, in druga izjema je uničila celoten postopek brez možnosti komitiranja offseta.
Nekaj časa je storitev stala - na srečo s Kafka to ni tako strašljivo, ker ostanejo sporočila. Ko se delo obnovi, jih bo mogoče prebrati. To je priročno.
Kafka omogoča preko orodij nastaviti poljuben offset. Vendar pa je za to potrebno ustaviti vse potrošnike - v našem primeru pripraviti posebno različico, v kateri ne bo potrošnikov, redeployments. Takrat lahko preko orodij v Kafka premaknemo offset, in sporočilo bo prešlo.
Druga niansa je replication log vs rdkafka.so — povezana je s specifičnostima našeg projekta. Imamo PHP, a u PHP-u, kao pravilo, sve biblioteke komuniciraju s Kafka putem repozitorija rdkafka.so, a dalje ide neka oblaganje. Možda su to naše lične poteškoće, ali se pokazalo da jednostavno pročitati deo već pročitano nije tako lako. Uglavnom, bilo je programskih problema.
Vraćajući se na osobitosti rada s partitions, direktno u dokumentaciji piše consumers >= topic partitions. Ali sam o tome saznao mnogo kasnije nego što bih želeo. Ako želite da se skalirate i imate dva konzumer, potrebno je najmanje dva partitions. To jest, ako ste imali jedan partition, u kojem se skupilo 20.000 poruka, i napravili ste novi, broj poruka neće se izjednačiti uskoro. Dakle, da biste imali dva paralelna konzumer, morate se pozabaviti partitions.
Nadzor
Mislim da će po načinu na koji pratimo biti još jasnije koje probleme imamo s postojećim pristupom.
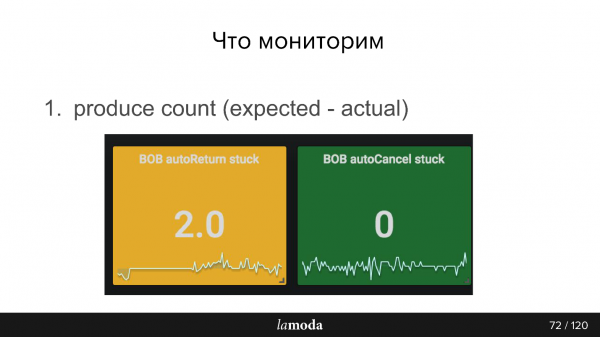
Na primer, brojićemo koliko je proizvoda u bazi nedavno promenilo status, i, prema tim promenama, trebali su se dogoditi događaji, i šaljemo ovaj broj u naš sistem praćenja. Zatim iz Kafke dobijamo drugi broj, koliko je zapravo zabeleženo događaja. Očigledno, razlika između ova dva broja uvek bi trebala biti nulta.
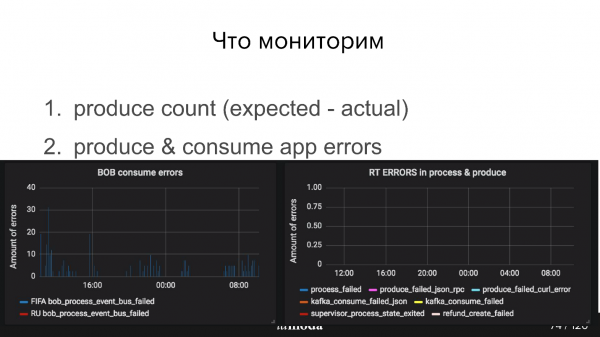
Pored toga, treba pratiti kako je kod producenta, je li events-bus primio poruke, i kako stoji kod konzumer. Na primer, na grafikonima ispod, kod Refund Tool sve je u redu, dok kod BOB-a očigledno postoje neki problemi (plavi vrhovi).
Već sam pomenuo consumer-group lag. Grubo rečeno, to je broj nepročitanih poruka. Uglavnom naši konzumeri rade brzo, tako da je lag obično 0, ali ponekad može biti kratkotrajni vrhunac. Kafka to može iz kutije, ali treba postaviti neki interval.
Postoji projekat , koji će vam dati više informacija o Kafki. On jednostavno putem API-ja po consumer-group daje status, kako se toj grupi prolazi. Pored OK i Failed, tu je i warning, i možete saznati da vaši konzumeri ne uspevaju da drže tempo produkcije — ne stignu da obradi ono što se piše. Sistem je prilično pametan, lako ga je koristiti.
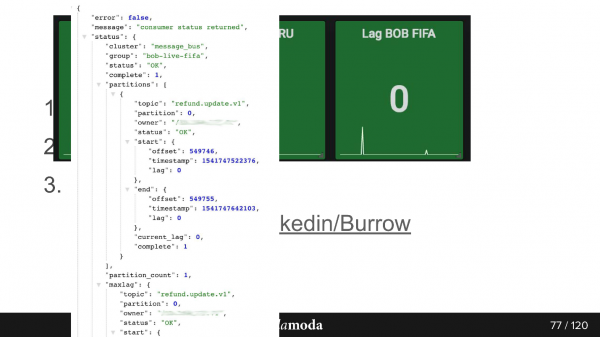
Ovako izgleda odgovor putem API-ja. Ovde je grupa bob-live-fifa, partition refund.update.v1, status OK, lag 0 — poslednji konačni offset je takav.
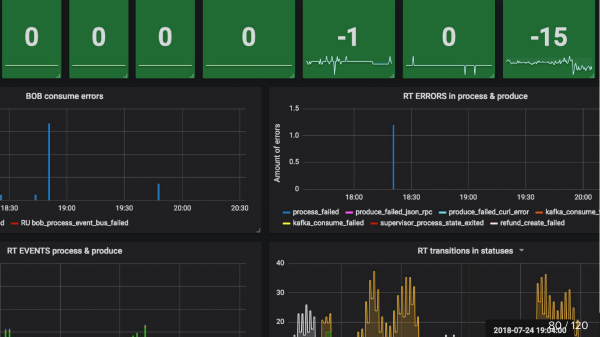
Nadzor updated_at SLA (stuck) Že sem že omenil. Na primer, izdelek je prešel v stanje, da je pripravljen za vračilo. Nastavimo Cron, ki pove, da če ta predmet v 5 minutah ne preide v refund (denar vrnemo prek plačilnih sistemov zelo hitro), potem nekaj zagotovo ni v redu in to je zagotovo primer za podporo. Zato preprosto vzamemo Cron, ki bere take stvari, in če so večje od 0, pošlje opozorilo.
Za zaključek, uporaba dogodkov je priročna, kadar:
- informacije potrebujemo več sistemom;
- rezultat obdelave ni pomemben;
- je dogodkov malo ali so dogodki majhni.
Zdi se, da ima članek precej konkretno temo - asinhroni API na Kafka, vendar v zvezi s tem želim takoj priporočiti veliko stvari.
Najprej, naslednji na treba čakati do novembra, že aprila bo njegova peterška različica, junija pa se bomo pogovarjali o visokih obremenitvah v Novosibirsku.
Drugič, avtor poročila Sergej Zaika je član Programskega odbora naše nove konference o upravljanju znanja. Konferenca traja en dan, potekala bo 26. aprila, a program je zelo bogat.
In še maja bo in (s DevOpsConf v sestavi) - tam je še vedno mogoče predložiti svojo temo, spregovoriti o svoji izkušnji in se pritožiti nad svojimi izkušnjami.
Izvor: habr.com
