

Pozdravljeni, prijatelji. Pred odhodom na drugo polovico majskih praznikov z vami delimo gradivo, ki smo ga prevedli pred začetkom novega tečaja .
Razvijalci aplikacij porabijo veliko časa za primerjavo več operativnih baz podatkov, da bi izbrali tisto, ki najbolje ustreza predvidenemu delovnemu obremenitvi. Potrebe lahko vključujejo poenostavljeno modeliranje podatkov, transakcijske garancije, uspešnost branja/pisanja, horizontalno skaliranje in odpornost na napake. Tradicionalno se izbira začne s kategorijo baze podatkov, SQL ali NoSQL, saj vsaka kategorija ponuja jasen niz kompromisov. Visoka učinkovitost v smislu nizke latence in visoke propustnosti se običajno obravnava kot zahteva, ki ne priznava kompromisov, in je zato potrebna za katero koli bazo podatkov iz izbora.
Cilj tega članka je pomagati razvijalcem aplikacij pri pravilni izbiri med SQL in NoSQL v kontekstu modeliranja podatkov aplikacije. Obdelali bomo eno SQL bazo podatkov, in sicer PostgreSQL, ter dve NoSQL bazi podatkov – Cassandro in MongoDB, da bomo razložili osnove oblikovanja baz podatkov, kot so ustvarjanje tabel, njihovo polnjenje, branje podatkov iz tabel in njihovo brisanje. V naslednjem članku bomo zagotovo obravnavali indekse, transakcije, JOIN, direktive TTL in oblikovanje baz podatkov na podlagi JSON.
Kakšna je razlika med SQL in NoSQL?
SQL baze podatkov povečujejo fleksibilnost aplikacije zaradi transakcijskih garancij ACID, prav tako pa zaradi svoje sposobnosti poizvedovanja po podatkih s pomočjo JOIN na nepričakovane načine nad obstoječimi normaliziranimi modeli relacijskih baz podatkov.
Zaradi svoje monolitne/eno vozlične arhitekture in uporabe modela replikacije master-slave za redundanco tradicionalne SQL baze podatkov nimajo dveh pomembnih lastnosti: linearne skalabilnosti zapisov (tj. samodejnega razdeljevanja na več vozlišč) in samodejnega/ničelnega izgube podatkov. To pomeni, da obseg prejetih podatkov ne more presegati največje propustnosti zapisa enega vozlišča. Poleg tega je treba upoštevati določeno časovno izgubo podatkov pri odpornosti na napake (v arhitekturi brez delitve virov). Tukaj je treba upoštevati, da nedavni potrditve še niso odraženi v podrejenem (slave) kopiji. Posodobitve brez izpadov so prav tako težko dosegljive v SQL bazah podatkov.
NoSQL baze podatkov so po svoji naravi običajno distribuirane, tj. podatki se razdelijo na sekcije in porazdelijo po več vozliščih. Zahtevajo denormalizacijo. To pomeni, da morajo biti vneseni podatki kopirani večkrat za odgovarjanje na specifične poizvedbe, ki jih pošiljate. Skupni cilj je doseči visoko zmogljivost z zmanjšanjem števila shardov, ki so na voljo med branjem. Iz tega sledi trditev, da NoSQL zahteva, da modelirate svoje poizvedbe, medtem ko SQL zahteva, da modelirate svoje podatke.
NoSQL se osredotoča na dosego visoke zmogljivosti v distribuiri izvedbi in to je osnovno utemeljitev številnih kompromisov pri načrtovanju baz podatkov, ki vključujejo izgubo transakcij ACID, JOIN-e in usklajene globalne sekundarne indekse.
Obstaja mnenje, da čeprav NoSQL baze podatkov zagotavljajo linearno skalabilnost zapisov in visoko odpornost na napake, izguba transakcijskih jamstev naredi jih neprimernimi za kritične podatke.
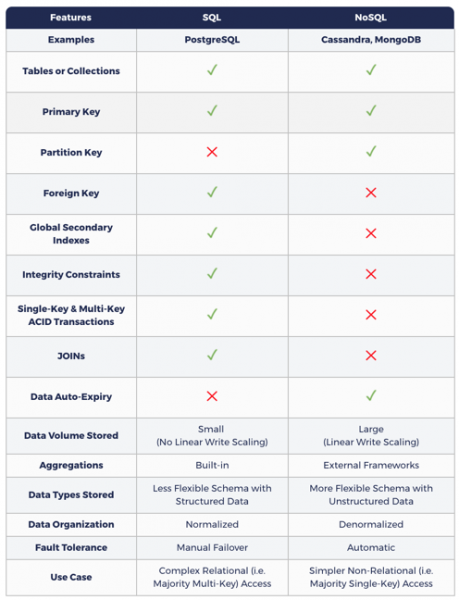
Naslednja tabela prikazuje, kako se modeliranje podatkov v NoSQL razlikuje od SQL.
SQL in NoSQL: Zakaj potrebujemo oboje?
Na realnih aplikacijah z veliko število uporabnikov, kot so Amazon.com, Netflix, Uber in Airbnb, leži izvedba zapletenih nalog različnih vrst. Na primer, e-trgovina, podobna Amazon.com, mora shranjevati lahke, visoko kritične podatke, kot so informacije o uporabnikih, izdelkih, naročilih in računih, skupaj s težkimi, a manj občutljivimi podatki, kot so ocene izdelkov, sporočila podpore strankam, aktivnost uporabnikov, mnenja in priporočila uporabnikov. Seveda te aplikacije temeljijo vsaj na eni SQL bazi podatkov skupaj z vsaj eno NoSQL bazo podatkov. V medregionalnih in globalnih sistemih NoSQL baza podatkov deluje kot georazporejen predpomnilnik za podatke, shranjene v zanesljivem viru, SQL baza podatkov, delujoča v eni sami regiji.
Kako YugaByte DB združuje SQL in NoSQL?
Zgrajena na mehanizmu shranjevanja, usmerjenem na dnevniške podatke, samodejnem deljenju obremenitve, replikaciji s soglasjem razdeljenih transakcij ACID (inspiriranih z Google Spanner), je YugaByte DB prva odprtokodna baza podatkov na svetu, ki je hkrati združljiva z NoSQL (Cassandra & Redis) in SQL (PostgreSQL). Kot prikazuje spodnja tabela, YCQL, API YugaByte DB združljiv s Cassandro, dodaja pojme enoključnih in večključnih ACID transakcij ter globalne sekundarne indekse v API NoSQL, kar odpira dobo transakcijskih NoSQL baz podatkov. Poleg tega YCQL, API YugaByte DB združljiv s PostgreSQL, dodaja pojme linearne razširljivosti pisanja in samodejne odpornosti na napake k SQL API, s čimer svetu predstavlja razdeljene SQL baze podatkov. Ker je baza podatkov YugaByte DB v svoji osnovi transakcijska, se sedaj API NoSQL lahko uporablja v kontekstu kritičnih podatkov.
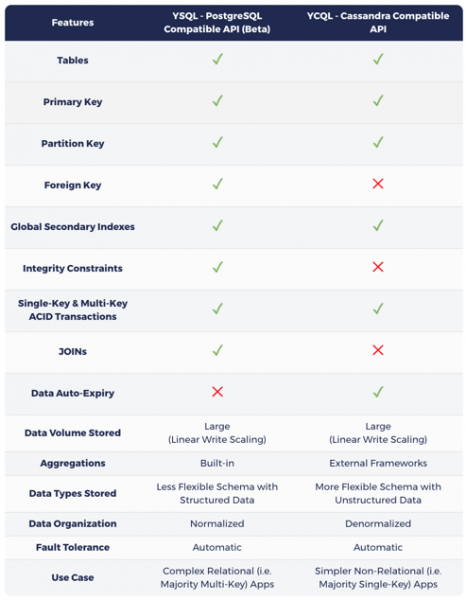
Kot je bilo prej omenjeno v članku , izbira med SQL ali NoSQL v YugaByte DB je popolnoma odvisna od značilnosti osnovne delovne obremenitve:
- Če je osnovna delovna obremenitev večključne operacije z JOIN-i, potem pri izbiri YSQL upoštevajte, da so lahko vaši ključi razporejeni po več vozliščih, kar lahko privede do večje zakasnitve in/ali zmanjšane prepustnosti v primerjavi z NoSQL.
- V nasprotnem primeru izberite katero koli od dveh NoSQL API, pri čemer imejte v mislih, da boste dosegli višje zmogljivosti pri poizvedbah, ki jih obravnava en sam vozlišč naenkrat. YugaByte DB lahko služi kot edina operativna baza podatkov za resne kompleksne aplikacije, ki potrebujejo upravljanje več delovnih obremenitev hkrati.
Osnova laboratorija za modeliranje podatkov (Data modeling lab) v naslednjem razdelku so podatkovne baze YugaByte DB, združljive s PostgreSQL in Cassandra API, v nasprotju z izvorno podatkovno bazo. Ta pristop poudarja enostavnost interakcije z dvema različnima API-ema (na dveh različnih vratih) istega klasterja podatkovnih baz v nasprotju z uporabo popolnoma neodvisnih klasterjev dveh različnih podatkovnih baz.
V naslednjih razdelkih se bomo seznanili z laboratorijem za modeliranje podatkov, da bi ponazorili razlike in nekatere skupne značilnosti obravnavanih podatkovnih baz.
Laboratorij za modeliranje podatkov
Namestitev podatkovnih baz
S poudarkom na oblikovanju modela podatkov (namesto na zapletenih architekturah namestitev) bomo namestili podatkovne baze v Dockerjeve kontejnerje na lokalnem računalniku, nato pa bomo z njimi komunicirali z ustreznimi ukaznimi lupinami.
Združljiva s PostgreSQL & Cassandra, podatkovna baza YugaByte DB
mkdir ~/yugabyte && cd ~/yugabyte
wget https://downloads.yugabyte.com/yb-docker-ctl && chmod +x yb-docker-ctl
docker pull yugabytedb/yugabyte
./yb-docker-ctl create --enable_postgres
MongoDB
docker run --name my-mongo -d mongo:latestDostop preko ukazne vrstice
Poglejmo se povezati s podatkovnimi bazami, z uporabo ukazne lupine za ustrezne API.
PostgreSQL
— je ukazna lupina za komunikacijo s PostgreSQL. Zaradi enostavnosti uporabe YugaByte DB prinaša psql neposredno v mapi bin.
docker exec -it yb-postgres-n1 /home/yugabyte/postgres/bin/psql -p 5433 -U postgresCassandra
— je ukazna lupina za komunikacijo s Cassandro in njenimi združljivimi podatkovnimi bazami preko CQL (Cassandra Query Language). Zaradi enostavne uporabe YugaByte DB prinaša cqlsh v imeniku bin.
Upoštevajte, da je bil CQL navdihnjen z SQL in ima podobne konceptne tabele, vrstice, stolpce in indekse. Vendar pa kot NoSQL jezik dodaja določen niz omejitev, od katerih jih bomo več obravnavali tudi v drugih člankih.
docker exec -it yb-tserver-n1 /home/yugabyte/bin/cqlshMongoDB
– je ukazatel za lokalni terminal za interakciju s MongoDB. Možete ga pronaći u bin direktoriju instalacije MongoDB.
docker exec -it my-mongo bash
cd bin
mongo
Kreiranje tablice
Sada možemo komunicirati s bazom podataka radi izvođenja raznih operacija putem komandne linije. Počnimo s kreiranjem tablice koja će pohranjivati informacije o pjesmama različitih izvođača. Ove pjesme mogu biti dio albuma. Također, opcionalni atributi za pjesmu su godina izdanja, cijena, žanr i ocjena. Moramo uzeti u obzir dodatne atribute koji mogu zatrebati u budućnosti, putem polja „tagovi“. Ono može pohranjivati polustrukturirane podatke u obliku parova ključ-vrijednost.
PostgreSQL
CREATE TABLE Music (
    Artist VARCHAR(20) NOT NULL,
    SongTitle VARCHAR(30) NOT NULL,
    AlbumTitle VARCHAR(25),
    Year INT,
    Price FLOAT,
    Genre VARCHAR(10),
    CriticRating FLOAT,
    Tags TEXT,
    PRIMARY KEY(Artist, SongTitle)
);
Cassandra
Kreiranje tablice u Cassandra-i vrlo je slično onome u PostgreSQL-u. Jedna od glavnih razlika je nedostatak ograničenja integriteta (npr. NOT NULL), ali to pada pod odgovornost aplikacije, a ne NoSQL baze podataka.. Primarni ključ sastoji se od ključa particije (stupac Artist u donjem primjeru) i skupa klasterizacijskih stupaca (stupac SongTitle u navedenom primjeru). Ključ particije određuje u koju particiju/shard staviti redak, dok klasterizacijski stupci označavaju kako bi podaci trebali biti organizirani unutar trenutnog shard-a.
CREATE KEYSPACE myapp;
USE myapp;
CREATE TABLE Music (
    Artist TEXT,
    SongTitle TEXT,
    AlbumTitle TEXT,
    Year INT,
    Price FLOAT,
    Genre TEXT,
    CriticRating FLOAT,
    Tags TEXT,
    PRIMARY KEY(Artist, SongTitle)
);
MongoDB
MongoDB organizira podatke u baze podataka (Database) (analogno Keyspace-u u Cassandra-i), gdje postoje kolekcije (Collections) (analogno tablicama) u kojima se nalaze dokumenti (Documents) (analogno redovima u tablici). U MongoDB-u nije potrebno definirati početnu shemu. Komanda „use database“, prikazana u nastavku, stvara instancu baze podataka pri prvom pozivu i mijenja kontekst za novonastalu bazu podataka. Čak se ni kolekcije ne moraju izričito kreirati, one se automatski kreiraju jednostavno dodavanjem prvog dokumenta u novu kolekciju. Imajte na umu da MongoDB prema zadanim postavkama koristi testnu bazu podataka, stoga će svaka operacija na razini kolekcija bez navođenja konkretne baze biti izvođena u njoj prema zadanim postavkama.
use myNewDatabase;Dobivanje informacija o tablici
PostgreSQL
d Music
Table "public.music"
    Column    |         Type          | Collation | Nullable | Default
--------------+-----------------------+-----------+----------+--------
 artist       | character varying(20) |           | not null |
 songtitle    | character varying(30) |           | not null |
 albumtitle   | character varying(25) |           |          |
 year         | integer               |           |          |
 price        | double precision      |           |          |
 genre        | character varying(10) |           |          |
 criticrating | double precision      |           |          |
 tags         | text                  |           |          |
Indexes:
    "music_pkey" PRIMARY KEY, btree (artist, songtitle)
Cassandra
DESCRIBE TABLE MUSIC;
CREATE TABLE myapp.music (
    artist text,
    songtitle text,
    albumtitle text,
    year int,
    price float,
    genre text,
    tags text,
    PRIMARY KEY (artist, songtitle)
) WITH CLUSTERING ORDER BY (songtitle ASC)
    AND default_time_to_live = 0
    AND transactions = {'enabled': 'false'};
MongoDB
use myNewDatabase;
show collections;
Вставка данных в таблицу
PostgreSQL
INSERT INTO Music
    (Artist, SongTitle, AlbumTitle,
    Year, Price, Genre, CriticRating,
    Tags)
VALUES(
    'No One You Know', 'Call Me Today', 'Somewhat Famous',
    2015, 2.14, 'Country', 7.8,
    '{"Composers": ["Smith", "Jones", "Davis"],"LengthInSeconds": 214}'
);
INSERT INTO Music
    (Artist, SongTitle, AlbumTitle,
    Price, Genre, CriticRating)
VALUES(
    'No One You Know', 'My Dog Spot', 'Hey Now',
    1.98, 'Country', 8.4
);
INSERT INTO Music
    (Artist, SongTitle, AlbumTitle,
    Price, Genre)
VALUES(
    'The Acme Band', 'Look Out, World', 'The Buck Starts Here',
    0.99, 'Rock'
);
INSERT INTO Music
    (Artist, SongTitle, AlbumTitle,
    Price, Genre,
    Tags)
VALUES(
    'The Acme Band', 'Still In Love', 'The Buck Starts Here',
    2.47, 'Rock',
    '{"radioStationsPlaying": ["KHCR", "KBQX", "WTNR", "WJJH"], "tourDates": { "Seattle": "20150625", "Cleveland": "20150630"}, "rotation": Heavy}'
);
Cassandra
В общем, выражение INSERT в Cassandra выглядит довольно похоже на аналогичное в PostgreSQL. Однако есть одно значительное различие в семантике. В Cassandra INSERT фактически представляет собой операцию UPSERT, где в строку добавляются последние значения, если строка уже существует.
Ввод данных происходит аналогично PostgreSQL
INSERTвыше
.
MongoDB
Несмотря на то, что MongoDB является NoSQL базой данных, подобно Cassandra, ее операция внесения данных не имеет ничего общего с семантическим поведением в Cassandra. В MongoDB не имеет возможностей UPSERT, что делает его похожим на PostgreSQL. Добавление данных по умолчанию без _idspecified приведет к добавлению нового документа в коллекцию.
db.music.insert( {
 artist: "Nihče, ki ga poznate",
 songTitle: "Pokliči me danes",
 albumTitle: "Rahlo znan",
 year: 2015,
 price: 2.14,
 genre: "Državni",
 tags: {
 Composers: ["Smith", "Jones", "Davis"],
 LengthInSeconds: 214,
 }
 }
 );
 db.music.insert( {
 artist: "Nihče, ki ga poznate",
 songTitle: "Moj pes Spot",
 albumTitle: "Hej zdaj",
 price: 1.98,
 genre: "Državni",
 criticRating: 8.4,
 }
 );
 db.music.insert( {
 artist: "Banda Acme",
 songTitle: "Pazi, svet",
 albumTitle:"Zatočki začenjajo tukaj",
 price: 0.99,
 genre: "Rock",
 }
 );
 db.music.insert( {
 artist: "Banda Acme",
 songTitle: "Še vedno zaljubljen",
 albumTitle:"Zatočki začenjajo tukaj",
 price: 2.47,
 genre: "Rock",
 tags: {
 radioStationsPlaying:["KHCR", "KBQX", "WTNR", "WJJH"],
 tourDates: {
 Seattle: "20150625",
 Cleveland: "20150630",
 },
 rotation: "Intenzivno"
 }
 }
 );
Запрос таблицы
Возможно, наиболее значительное различие между SQL и NoSQL с точки зрения составления запросов заключается в использовании формулировок FROM in WHERE. SQL позволяет после выражения FROM выбирать несколько таблиц, а выражение с WHERE может быть любой сложности (включая операции JOIN между таблицами). Однако NoSQL имеет тенденцию накладывать строгие ограничения на FROM, и работает только с одной указанной таблицей, а в WHERE, vedno je treba navesti primarni ključ. To je povezano z željo po povečanju učinkovitosti NoSQL, o kateri smo govorili prej. Ta želja vodi do zmanjšanja vsega križnega in ključnega prekrivanja. To lahko povzroči veliko zakasnitve pri povezovanju med vozli, ko odgovarjamo na poizvedbe, zato se takšnim situacijam najbolje izogniti. Na primer, Cassandra zahteva, da so poizvedbe omejene na določene operaterje (dovoljeni so samo =, IN, , =>, <=) na ključih delov, razen v primerih, ko gre za poizvedbo sekundarnega indeksa (tukaj je dovoljen le operater =).
PostgreSQL
Nato bodo predstavljeni trije primeri poizvedb, ki jih lahko SQL baza podatkov zlahka izvede.
- Prikaz vseh pesmi izvajalca;
- Prikaz vseh pesmi izvajalca, ki se ujemajo z prvo polovico naslova;
- Prikaz vseh pesmi izvajalca, ki vsebujejo določeno besedo v naslovu in imajo ceno manj kot 1.00.
SELECT * FROM Music
WHERE Artist='No One You Know';
SELECT * FROM Music
WHERE Artist='No One You Know' AND SongTitle LIKE 'Call%';
SELECT * FROM Music
WHERE Artist='No One You Know' AND SongTitle LIKE '%Today%'
AND Price > 1.00;
Cassandra
Od zgoraj navedenih poizvedb bo v Cassandri delovala samo prva brez sprememb, saj operater LIKE ni mogoče uporabiti na stolpcih klasterizacije, kot je SongTitle. V tem primeru so dovoljeni le operaterji = in IN.
SELECT * FROM Music
WHERE Artist='No One You Know';
SELECT * FROM Music
WHERE Artist='No One You Know' AND SongTitle IN ('Call Me Today', 'My Dog Spot')
AND Price > 1.00;
MongoDB
Kot je bilo prikazano v prejšnjih primerih, je glavni način ustvarjanja poizvedb v MongoDB . Ta metoda izrecno vsebuje ime zbirke (music v spodnjem primeru), zato je poizvedba po več zbirkah prepovedana.
db.music.find( {
  artist: "No One You Know"
 }
);
db.music.find( {
  artist: "No One You Know",
  songTitle: /Call/
 }
);
Branje vseh vrstic tabele
Branje vseh vrstic je preprosto posebna različica tistega predloge poizvedbe, ki smo jo obravnavali prej.
PostgreSQL
SELECT *
FROM Music;
Cassandra
Podobno kot primer v PostgreSQL zgoraj.
MongoDB
db.music.find( {} );Urejanje podatkov v tabeli
PostgreSQL
PostgreSQL ponuja ukaz UPDATE za spreminjanje podatkov. Ta nima možnosti UPSERT, zato bo izvajanje tega ukaza povzročilo napako, če vrstic v bazi podatkov ni več.
UPDATE Music
SET Genre = 'Disco'
WHERE Artist = 'The Acme Band' AND SongTitle = 'Still In Love';
Cassandra
V Cassandri je UPDATE podoben PostgreSQL. UPDATE ima isto semantiko UPSERT, podobno INSERT.
Podobno kot primer v PostgreSQL zgoraj.
MongoDB
Operacija V MongoDB lahko popolnoma posodobite obstoječi dokument ali posodobite le določena polja. Privzeto posodobi samo en dokument brez semantike. UPSERT. Posodobitev več dokumentov in vedeneje je podobno. UPSERT lahko uporabite, tako da za operacijo nastavite dodatne zastavice. Na primer, v spodnjem primeru se posodablja žanr določenega izvajalca po njegovi pesmi.
db.music.update(
  {"artist": "The Acme Band"},
  {
    $set: {
      "genre": "Disco"
    }
  },
  {"multi": true, "upsert": true}
);
Brisanje podatkov iz tabele
PostgreSQL
DELETE FROM Music
WHERE Artist = 'The Acme Band' AND SongTitle = 'Look Out, World';
Cassandra
Podobno kot primer v PostgreSQL zgoraj.
MongoDB
V MongoDB sta dva tipa operacij za brisanje dokumentov — in . Obe vrsti brišeta dokumente, a vračata različne rezultate.
db.music.deleteMany( {
        artist: "The Acme Band"
    }
);
Brisanje tabele
PostgreSQL
DROP TABLE Music;Cassandra
Podobno kot primer v PostgreSQL zgoraj.
MongoDB
db.music.drop();Zaključek
Razprave o izbiri med SQL in NoSQL trajajo že več kot 10 let. Obstajata dva glavna vidika te razprave: arhitektura jedra baze podatkov (monolitni, transakcijski SQL proti porazdeljenemu, netransakcijskemu NoSQL) in pristop k načrtovanju baze podatkov (modeliranje podatkov v SQL proti modeliranju vaših poizvedb v NoSQL).
S porazdeljeno transakcijsko bazo podatkov, kot je YugaByte DB, lahko razprave o arhitekturi baze podatkov zlahka razjasnimo. Ko količina podatkov preseže to, kar je mogoče zapisati v en vozlišče, postane popolnoma porazdeljena arhitektura, ki podpira linearno skalabilnost zapisovanja z avtomatskim shardanjem/premikanjem, nujna.
Poleg tega, kar je zapisano v enem od člankov , transakcijske, strogo usklajene arhitekture se zdaj širše uporabljajo za zagotavljanje boljše fleksibilnosti pri razvoju, kot netransakcijske, končno usklajene arhitekture.
Ko se vrnemo k razpravi o načrtovanju baz podatkov, je pravično reči, da sta oba pristopa k načrtovanju (SQL in NoSQL) potrebna za vsako zapleteno resnično aplikacijo. SQL pristop 'modeliranja podatkov' omogoča razvijalcem lažje izpolnjevanje spreminjajočih se poslovnih zahtev, medtem ko pristop NoSQL 'modeliranja poizvedb' omogoča istim razvijalcem upravljanje velikih količin podatkov z majhno zakasnitvijo in visoko prepustnostjo. Zato YugaByte DB nudi SQL in NoSQL API v skupnem jedru, namesto da bi promoviral enega izmed pristopov. Poleg tega, s skladnostjo s priljubljenimi jeziki baz podatkov, vključno s PostgreSQL in Cassandro, YugaByte DB zagotavlja, da razvijalci ne bodo potrebovali učenja drugega jezika, da bi delali z razdeljenim strogo doslednim jedrom baz podatkov.
V tem članku smo raziskali, kako se osnove načrtovanja baz podatkov razlikujejo med PostgreSQL, Cassandro in MongoDB. V naslednjih člankih se bomo poglobili v napredne koncepte načrtovanja, kot so indeksi, transakcije, JOIN-i, direktive TTL in JSON-dokumenti.
Želimo vam, da preživite čudovit preostanek vikenda in vas vabimo na , ki bo potekal že 14. maja.
Izvor: habr.com
