

U Linux-u postoji mnogo alata za debagovanje jezgra i aplikacija. Većina njih negativno utiče na performanse aplikacija i ne može se koristiti u produkciji.
Pre nekoliko godina je razvijen još jedan alat Trenutno već postoji mnogo aplikativnih alata koji koriste eBPF, a u ovom članku ćemo razmotriti kako da napišemo sopstveni alat za profilisanje zasnovan na biblioteci
PythonBCC Ceph je spor
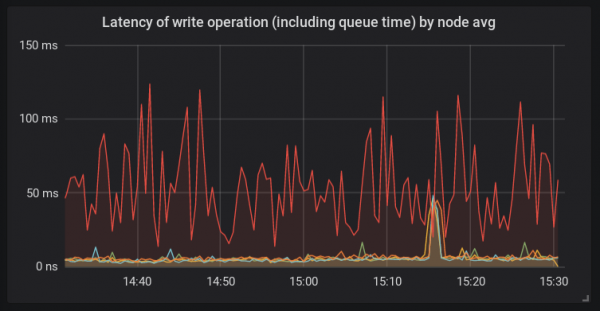
U Ceph klaster je dodat novi host. Nakon migracije dela podataka na njega, primetili smo da je brzina obrade zahteva za zapis puno niža nego na ostalim serverima.
Za razliku od drugih platformi, na ovom hostu je korišćen bcache i novo jezgro linux 4.15. Ova konfiguracija hosta se ovde koristila po prvi put. I tada je bilo jasno da je koren problema teoretski mogao biti bilo šta.
Istraživanje hosta
Počećemo sa tim da pogledamo šta se dešava unutar procesa ceph-osd. Za to ćemo koristiti
perf in Slika nam govori da je funkcija ):
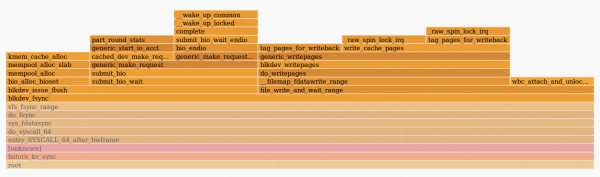
potrošila mnogo vremena pri slanju zahteva u funkciji fdatasync() generic_make_request() . To znači da su verovatno problemi negde van samog osd demona. To može biti ili jezgro ili diskovi. iostat izlaz je pokazivao visoku latenciju obrade zahteva od strane bcache diskova.U proveri hosta otkrili smo da demon systemd-udevd troši veliku količinu CPU vremena — oko 20% na nekoliko jezgara. Ovo bizarno ponašanje zahteva istraživanje. Pošto systemd-udevd radi sa uevent-ima, odlučili smo da ih pratimo putem
udevadm monitor . Iskristalizovalo se da se generiše velika količina change događaja za svaki blok uređaja u sistemu. To je prilično neobično, pa ćemo morati da istražimo šta generiše sve te događaje.Korišćenje BCC alata
Uporaba BCC orodja
Kot smo že ugotovili, jedro (in demon ceph v sistemskem klicu) porabi veliko časa pri . To znači da su verovatno problemi negde van samog osd demona. To može biti ili jezgro ili diskovi. iostat izlaz je pokazivao visoku latenciju obrade zahteva od strane bcache diskova.. Poskusimo izmeriti hitrost dela te funkcije. V že obstaja osupljiva utilita — funclatency. Sledili bomo demon po njegovem PID z intervalom med izhodi informacij 1 sekundo in izpisovali rezultate v milisekundah.
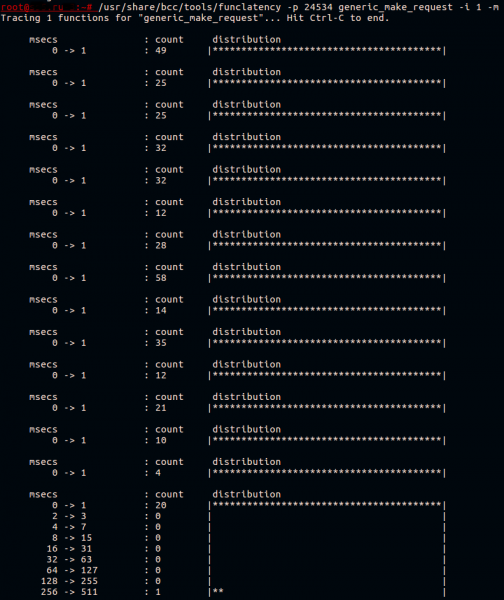
Običajno ta funkcija deluje hitro. Vse, kar počne — pošilja zahtevo v čakalno vrsto naprave.
Bcache je kompleksen sistem, ki v resnici sestavlja tri diske:
- backing device (disk, ki ga je mogoče predpomniti), v tem primeru je to počasen HDD;
- caching device (predpomnilni disk), tukaj je to ena particija na NVMe napravi;
- virtualna naprava bcache, s katero deluje aplikacija.
Vemo, da prenos zahteve upočasnjuje, toda za katero izmed teh naprav? O tem se bomo pogovorili malo kasneje.
Zdaj vemo, da ueventi verjetno povzročajo težave. Ugotoviti, kaj natančno povzroča njihovo generacijo, ni tako preprosto. Predpostavimo, da je to kakšen program, ki se izvaja občasno. Poglejmo, kateri programi se zaženejo v sistemu, s pomočjo skripta execsnoop iz istega . Zaženimo ga in preusmerimo izhod v datoteko.
Na primer tako:
/usr/share/bcc/tools/execsnoop | tee ./execdump
Tukaj ne bomo priložili celotnega izhoda execsnoop, vendar je ena zanimiva vrstica izgledala takole:
sh 1764905 5802 0 sudo arcconf getconfig 1 AD | grep Temperature | awk -F '[:\/]' '{print $2}' | sed 's\/^ ([0-9]*) C.*\/1\/'
Tretja kolona je PPID (parent PID) procesa. Proces z PID 5802 se je izkazal za eno od niti našega nadzornega sistema. Pri preverjanju konfiguracije nadzornega sistema so bile ugotovljene napačne nastavitve. Temperatura HBA-adapterja se je merila vsakih 30 sekund, kar je bistveno pogosteje, kot je potrebno. Po spremembi intervala preverjanja na daljši, smo ugotovili, da zamik obdelave zahtevkov na tej gostiteljski napravi ni več izstopal v primerjavi z drugimi gostiteljskimi napravami.
Toda še vedno ni jasno, zakaj je bcache naprava tako upočasnila. Pripravili smo testno platformo z identično konfiguracijo in poskusili reproducirati težavo, tako da smo zagnali fio na bcache, občasno zagnali udevadm trigger za generacijo uevents.
Pisanje orodij na osnovi BCC
Poskusimo napisati preprosto utilito za sledenje in izpis na ekran najpočasnejših klicev . To znači da su verovatno problemi negde van samog osd demona. To može biti ili jezgro ili diskovi. iostat izlaz je pokazivao visoku latenciju obrade zahteva od strane bcache diskova.. Zanimivo nam je tudi ime diska, za katerega je bila ta funkcija poklicana.
Načrt je preprost:
- Registriramo kprobe na . To znači da su verovatno problemi negde van samog osd demona. To može biti ili jezgro ili diskovi. iostat izlaz je pokazivao visoku latenciju obrade zahteva od strane bcache diskova.:
- Shranjujemo v spomin ime diska, ki je dostopno prek argumenta funkcije;
- Shranjujemo časovni žig.
- Registriramo kretprobe na povratku iz . To znači da su verovatno problemi negde van samog osd demona. To može biti ili jezgro ili diskovi. iostat izlaz je pokazivao visoku latenciju obrade zahteva od strane bcache diskova.:
- Pridobimo trenutni časovni žig;
- Iščemo shranjen časovni žig in ga primerjamo s trenutnim;
- Če je rezultat večji od nastavljene vrednosti, poiščemo shranjeno ime diska in ga prikažemo na terminalu.
Kprobes in kretprobes uporabljajo mehanizem točk za zaustavitev za dinamično spreminjanje kode funkcij. Preberete lahko in članek na to temo. Če pogledamo kodo različnih orodij v , opazimo, da imajo identično strukturo. V tem članku bomo preskočili razčlenjevanje argumentov skripte in prešli k sami BPF programu.
Besedilo eBPF znotraj python skripte izgleda takole:
bpf_text = """ # Tu bo koda bpf programa """
Za izmenjavo podatkov med funkcijami, eBPF programi uporabljajo . Tudi mi bomo to storili. Kot ključ bomo uporabili PID procesa, vrednost pa bomo definirali kot strukturo:
struct data_t {
	u64 pid;
	u64 ts;
	char comm[TASK_COMM_LEN];
	u64 lat;
	char disk[DISK_NAME_LEN];
};

BPF_HASH(p, u64, struct data_t);
BPF_PERF_OUTPUT(events);
Tukaj registriramo hash-tabelo, ki se imenuje p, s ključem tipa u64 in vrednostjo tipa struct data_t. Tabela bo dostopna v kontekstu naše BPF-programa. Makro BPF_PERF_OUTPUT registrira drugo tabelo, ki se imenuje events, ki se uporablja za v uporabniški prostor.
Pri merjenju zamud med klicem funkcije in povratkom iz nje, ali med klici različnih funkcij, je treba upoštevati, da morajo pridobljeni podatki pripadati enemu kontekstu. Drugimi besedami, treba je paziti na morebiten vzporedni zagon funkcij. Imamo možnost izmeriti zamudo med klicem funkcije v okviru enega procesa in povratkom iz te funkcije v okviru drugega procesa, vendar to verjetno ni zelo koristno. Dober primer tu je , kjer je kot ključ hash-tabele določen kazalec na struct request, ki odraža en zahtevek za disk.
Nato moramo napisati kodo, ki se bo izvajala ob klicu preučevane funkcije:
void start(struct pt_regs *ctx, struct bio *bio) {
	u64 pid = bpf_get_current_pid_tgid();
	struct data_t data = {};
	u64 ts = bpf_ktime_get_ns();
	data.pid = pid;
	data.ts = ts;
	bpf_probe_read_str(&data.disk, sizeof(data.disk), (void*)bio->bi_disk->disk_name);
	p.update(&pid, &data);
}
Tukaj bomo kot drugi argument vstavili prvi argument poklicane funkcije . Po tem dobimo PID procesa, v okviru katerega delujemo, in trenutno časovno oznako v nanosekundah. Vse to zapišemo v sveže dodeljeno struct data_t data. Ime diska dobimo iz strukture bio, ki se prenese ob klicu . To znači da su verovatno problemi negde van samog osd demona. To može biti ili jezgro ili diskovi. iostat izlaz je pokazivao visoku latenciju obrade zahteva od strane bcache diskova., in ga shranimo v isto strukturo data. Zadnji korak je dodajanje zapisa v hash tabelo, o kateri smo govorili prej.
Naslednja funkcija se bo klicala ob vrnitvi iz . To znači da su verovatno problemi negde van samog osd demona. To može biti ili jezgro ili diskovi. iostat izlaz je pokazivao visoku latenciju obrade zahteva od strane bcache diskova.:
void stop(struct pt_regs *ctx) {
    u64 pid = bpf_get_current_pid_tgid();
    u64 ts = bpf_ktime_get_ns();
    struct data_t* data = p.lookup(&pid);
    if (data != 0 && data->ts > 0) {
        bpf_get_current_comm(&data->comm, sizeof(data->comm));
        data->lat = (ts - data->ts)/1000;
        if (data->lat > MIN_US) {
            FACTOR
            data->pid >>= 32;
            events.perf_submit(ctx, data, sizeof(struct data_t));
        }
        p.delete(&pid);
    }
}
Ta funkcija je podobna prejšnji: izvemo PID procesa in časovno oznako, vendar ne dodelimo pomnilnika za novo strukturo data. Namesto tega poiščemo v hash tabeli že obstoječo strukturo po ključu == trenutni PID. Če struktura najdemo, izvemo ime zagnanega procesa in ga dodamo vanjo.
Binarno premikanje, ki ga tu uporabljamo, je potrebno, da pridobimo thread GID, tj. PID glavnega procesa, ki je zagnal nit, v okviru katere delamo. Kličemo funkcijo vrne tako GID niti kot tudi njen PID v eni 64-bitni vrednosti.
Ob izpisu v terminal nas sedaj ne zanima nit, ampak glavni proces. Po primerjavi pridobljene zamude z določenim pragom prenesemo našo strukturo data v prostor uporabnika preko tabele events, nato pa odstranimo zapis iz p.
V python skripti, ki bo naložila to kodo, moramo zamenjati MIN_US in FACTOR z pragovi zamude in enotami časa, ki jih bomo posredovali preko argumentov:
bpf_text = bpf_text.replace('MIN_US',str(min_usec))
if args.milliseconds:
	bpf_text = bpf_text.replace('FACTOR','data->lat /= 1000;')
	label = "msec"
else:
	bpf_text = bpf_text.replace('FACTOR','')
	label = "usec"
Zdaj moramo pripraviti BPF program preko in registrirati probe:
b = BPF(text=bpf_text)
b.attach_kprobe(event="generic_make_request",fn_name="start")
b.attach_kretprobe(event="generic_make_request",fn_name="stop")
Prav tako bomo morali definirati struct data_t v naši skripti, sicer ne bomo mogli nič prebrati:
TASK_COMM_LEN = 16	# linux/sched.h
DISK_NAME_LEN = 32	# linux/genhd.h
class Data(ct.Structure):
	_fields_ = [("pid", ct.c_ulonglong),
            	("ts", ct.c_ulonglong),
            	("comm", ct.c_char * TASK_COMM_LEN),
            	("lat", ct.c_ulonglong),
            	("disk",ct.c_char * DISK_NAME_LEN)]
Poslednji korak — izlaz podataka na terminal:
def print_event(cpu, data, size):
    global start
    event = ct.cast(data, ct.POINTER(Data)).contents
    if start == 0:
        start = event.ts
    time_s = (float(event.ts - start)) / 1000000000
    print("%-18.9f %-16s %-6d   %-1s %s   %s" % (time_s, event.comm, event.pid, event.lat, label, event.disk))

b["events"].open_perf_buffer(print_event)
# format output
start = 0
while 1:
    try:
        b.perf_buffer_poll()
    except KeyboardInterrupt:
        exit()
Sam skript je dostupan na . Pokušajmo ga pokrenuti na testnoj platformi gde se pokreće fio, koji piše na bcache, i pozvati udevadm monitor:
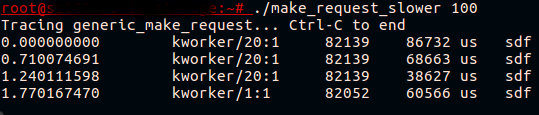
Napokon! Sada vidimo da ono što se činilo kao usporavajuće bcache uređaj, zapravo je usporavajući poziv . To znači da su verovatno problemi negde van samog osd demona. To može biti ili jezgro ili diskovi. iostat izlaz je pokazivao visoku latenciju obrade zahteva od strane bcache diskova. za keširani disk.
Istraži kernel
Šta tačno usporava tokom prenosa zahteva? Vidimo da kašnjenje nastaje čak i pre početka obračuna zahteva, tj. praćenje konkretnog zahteva za dalju statistiku ( /proc/diskstats ili iostat) još nije počelo. To se lako može proveriti pokretanjem iostat-a tokom reprodukcije problema, ili , koji se oslanja na početak i kraj obračuna zahteva. Nijedna od ovih alatki neće pokazati probleme za zahteve ka keširanom disku.
Ako pogledamo funkciju . To znači da su verovatno problemi negde van samog osd demona. To može biti ili jezgro ili diskovi. iostat izlaz je pokazivao visoku latenciju obrade zahteva od strane bcache diskova., videćemo da pre nego što počne obračun zahteva, pozivaju se još dve funkcije. Prva — generic_make_request_checks(), vrši provere legitimnosti zahteva u odnosu na postavke diska. Druga — , koja ima interesantan poziv :
ret = wait_event_interruptible(q->mq_freeze_wq,
	(atomic_read(&q->mq_freeze_depth) == 0 &&
	(preempt || !blk_queue_preempt_only(q))) ||
	blk_queue_dying(q));
U njemu kernel čeka odmrzavanje reda. Izmerimo kašnjenje blk_queue_enter():
~# /usr/share/bcc/tools/funclatency  blk_queue_enter -i 1 -m
Praćenje 1 funkcija za "blk_queue_enter"... Pritisnite Ctrl-C za kraj.

 	msecs           	: count 	distribution
     	0 -> 1      	: 341  	|****************************************|

 	msecs           	: count 	distribution
     	0 -> 1      	: 316  	|****************************************|

 	msecs           	: count 	distribution
     	0 -> 1      	: 255  	|****************************************|
     	2 -> 3      	: 0    	|                                    	|
     	4 -> 7      	: 0    	|                                    	|
     	8 -> 15     	: 1    	|                                    	|
Čini se da smo blizu razjašnjenja. Funkcije koje se koriste za „zamrzavanje/odmrzavanje“ reda su in . Se uporabljajo, ko je potrebno spremeniti nastavitve čakalne vrste zahtevkov, kar lahko predstavlja potencialno nevarnost za zahtevke v tej čakalni vrsti. Ob klicu blk_mq_freeze_queue() funkcija se poveča števec q->mq_freeze_depth. Po tem jedro čaka na praznjenje čakalne vrste v .
Čas čakanja za praznjenje te čakalne vrste je enak zakasnitvi diska, saj jedro čaka na dokončanje vseh operacij, ki so bile postavljene v čakalno vrsto. Ko je čakalna vrsta prazna, se uporabijo spremenjene nastavitve. Nato se pokliče , ki zmanjša števec freeze_depth.
Zdaj vemo dovolj, da popravimo situacijo. Ukaz udevadm trigger vodi do uporabe nastavitev za blok napravo. Te nastavitve so opisane v pravilih udev. Lahko ugotovimo, katere natančne nastavitve „zamrznejo“ čakalno vrsto, če jih poskusimo spremeniti prek sysfs ali si ogledamo izvorno kodo jedra. Poleg tega lahko poskusimo z orodjem BCC , ki bo na terminal izpisalo sledi jedrskega in uporabniškega prostora za vsak klic blk_freeze_queue, na primer:
~# /usr/share/bcc/tools/trace blk_freeze_queue -K -U
PID 	TID 	COMM        	FUNC
3809642 3809642 systemd-udevd   blk_freeze_queue
    	blk_freeze_queue+0x1 [kernel]
    	elevator_switch+0x29 [kernel]
    	elv_iosched_store+0x197 [kernel]
    	queue_attr_store+0x5c [kernel]
    	sysfs_kf_write+0x3c [kernel]
    	kernfs_fop_write+0x125 [kernel]
    	__vfs_write+0x1b [kernel]
    	vfs_write+0xb8 [kernel]
    	sys_write+0x55 [kernel]
    	do_syscall_64+0x73 [kernel]
    	entry_SYSCALL_64_after_hwframe+0x3d [kernel]
    	__write_nocancel+0x7 [libc-2.23.so]
    	[unknown]

3809631 3809631 systemd-udevd   blk_freeze_queue
    	blk_freeze_queue+0x1 [kernel]
    	queue_requests_store+0xb6 [kernel]
    	queue_attr_store+0x5c [kernel]
    	sysfs_kf_write+0x3c [kernel]
    	kernfs_fop_write+0x125 [kernel]
    	__vfs_write+0x1b [kernel]
    	vfs_write+0xb8 [kernel]
    	sys_write+0x55 [kernel]
    	do_syscall_64+0x73 [kernel]
    	entry_SYSCALL_64_after_hwframe+0x3d [kernel]
    	__write_nocancel+0x7 [libc-2.23.so]
    	[unknown]
Udev pravila se redko spreminjajo in običajno potekajo pod nadzorom. Tako vidimo, da tudi uporaba že določenih vrednosti povzroči skok v zakasnitvi prenosa zahtevka iz aplikacije na disk. Seveda generiranje udev dogodkov, ko ni nobenih sprememb v konfiguraciji diskov (na primer, če naprava ni priključena/odklopljena), ni najboljša praksa. Kljub temu lahko pomagamo jedru, da ne dela nepotrebnega dela in ne „zamrzne“ čakalne vrste zahtevkov, če to ni potrebno. odpravljajo situacijo.
Zaključek
eBPF je izjemno prilagodljivo in zmogljivo orodje. V članku smo obravnavali en praktičen primer in pokazali majhen delček tistega, kar je mogoče doseči. Če vas zanima razvoj BCC orodij, si oglejte , ki dobro opisuje osnove delovanja.
Obstajajo tudi druga zanimiva orodja za odpravljanje napak in profiliranje, ki temeljijo na eBPF. Eden izmed njih je , ki omogoča pisanje zmogljivih enovrstičnih in majhnih programov v jeziku, podobnem awku. Drugo je , ki omogoča zbiranje nizko nivojskih metrik visoke ločljivosti neposredno na vašem prometheus strežniku, z možnostjo poznejše pridobitve lepe vizualizacije in celo opozoril.
Izvor: habr.com
