

Hello, Habr!
Pripominjamo, da smo izdali novo izredno zanimivo in uporabno o vzorcih Kubernetes. Vse se je začelo z "" Brendanovega Burnsa, in seveda, naše delo na tem segmentu . Danes vam ponujamo, da preberete članek iz bloga MinIO, ki na kratko povzema trende in posebnosti vzorcev shranjevanja podatkov v Kubernetes.
Kubernetes je temeljito spremenil tradicionalne vzorce razvoja in uvajanja aplikacij. Zdaj lahko ekipa v le nekaj dneh razvije, testira in uvaja aplikacijo – v različnih okoljih, vse to znotraj Kubernetes grozdov. Takšna delo s tehnologijami prejšnjih generacij običajno je zahtevalo tedne, če ne mesece.
Takšno pospeševanje je postalo mogoče zaradi abstrakcije, ki jo zagotavlja Kubernetes — to je, zahvaljujoč temu, da Kubernetes sam obravnava interakcije z nizkotnim tehničnim specifikacijam fizičnih ali virtualnih strojev, kar uporabnikom omogoča, da na primer določijo potreben procesor, potrebne količine pomnilnika in število primerkov kontejnerjev. Ker je za podporo Kubernetes angažirana ogromna skupnost, ter ker se obseg uporabe Kubernetes nenehno širi, vodi daleč pred vsemi platformami za orkestracijo kontejnerjev.
S širjenjem uporabe Kubernetes se povečuje tudi zmeda glede vzorcev shranjevanja podatkov, ki se uporabljajo..
Pri vsej konkurenci za kos pite Kubernetes (tj. za shranjevanje podatkov), ko gre za shranjevanje podatkov, se signal tukaj potopi v močan šum.
Kubernetes predstavlja sodobni model razvoja, uvajanja in upravljanja aplikacij. Ta sodoben model ločuje shranjevanje podatkov od obdelave. Da bi popolnoma razumeli to ločitev v kontekstu Kubernetes, je treba prav tako razumeti, kaj so aplikacije, ki delujejo s trajnimi in netrajnimi shranjevanjem, ter kako se to usklajuje s shranjevanjem podatkov. Tu ima pristop REST API, ki se uporablja v S3, jasne prednosti v primerjavi s pristopom POSIX/CSI, ki je značilen za druge rešitve.
V tem članku se bomo pogovorili o vzorcih shranjevanja podatkov v Kubernetesu in posebej obravnavali razpravo o aplikacijah, ki delujejo z shranjevanjem in brez shranjevanja stanja, da bomo temeljito razumeli, v čem je razlika med njimi in zakaj je ta razlika pomembna. V nadaljevanju besedila bodo obravnavane aplikacije in vzorci shranjevanja podatkov, ki se uporabljajo v skladu z najboljšimi praksami dela s posodami in Kubernetesom.
Posode brez shranjevanja stanja
Posode so po naravi lahke in efemerne. Lahko jih enostavno ustavimo, izbrišemo ali prenesemo na drugo vozlišče – to traja le sekunde. V velikem sistemu orkestracije posod se takšne operacije nenehno dogajajo, uporabniki pa teh sprememb pogosto ne opazijo. Vendar pa so premiki možni le, če posoda nima nobenih odvisnosti od vozlišča, na katerem se nahaja. O takšnih posodah pravimo, da delujejo brez shranjevanja stanja.
Posode s shranjevanjem stanja
Če posoda shranjuje podatke na lokalno priključenih napravah (ali na blokovni napravi), bo treba shranjevanje podatkov, na katerem se nahaja, prenesti na novo vozlišče skupaj s samo posodo – v primeru okvare. To je pomembno, saj v nasprotnem primeru aplikacija, ki teče v posodi, ne bo mogla pravilno delovati, saj mora dostopati do podatkov, shranjenih na lokalnih medijih. O takšnih posodah pravimo, da delujejo s shranjevanjem stanja.
Z čist tehničnega vidika je mogoče tudi posode s shranjevanjem stanja premikati na druga vozlišča. To se običajno zagotavlja s pomočjo porazdeljenih datotečnih sistemov ali blokovnih omrežnih shranjevanj podatkov, pritrjenih na vsa vozlišča, na katerih delujejo posode. Tako posode dobijo dostop do volumov za trajno shranjevanje podatkov, informacije pa se shranjujejo na diskih, razporejenimi po celotnem omrežju. Ta način bom poimenoval ‘pristop posod s shranjevanjem stanja’, in v preostanku članka ga bom tako imenoval za enotnost.
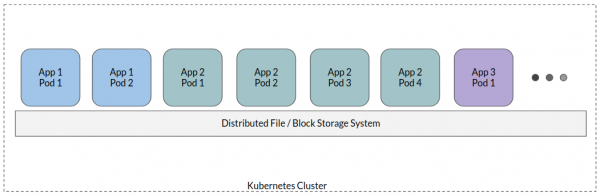
V tipičnem pristopu kontejnerne tehnologije s shranjevanjem stanja so vse aplikacijske posode pripete na en razdeljen datotečni sistem – ustvarja se nekakšen skupni prostor za shranjevanje, kjer se zbirajo vse podatke aplikacij. Čeprav so možne določene variacije, gre za visok nivo pristopa.
Zdaj pa se podučimo, zakaj je pristop kontejnerne tehnologije s shranjevanjem stanja v svetu, usmerjenem v oblak, antipateren.
Oblačno usmerjeno načrtovanje aplikacij
Tradicionalno so aplikacije uporabljale baze podatkov za strukturirano shranjevanje informacij ter lokalne diske ali razdeljene datotečne sisteme, kamor so shranjevali vse nestrukturirane ali celo polstrukturirane podatke. Ko so se količine nestrukturiranih podatkov povečale, so razvijalci spoznali, da je POSIX prenagljen, povezan z znatnimi stroški in na koncu ovira delovanje aplikacije pri prehodu na resnično velike razsežnosti.
To je v veliki meri prispevalo k nastanku novega standarda shranjevanja podatkov, torej oblačno usmerjenih shranjevanj, ki delujejo predvsem na osnovi REST API in razbremenjujejo aplikacijo napornih nalog lokalnega shranjevanja podatkov. V takem primeru aplikacija pravzaprav prehaja v način delovanja brez shranjevanja stanja (ker je stanje v oddaljenem shranjevanju). Sodobne aplikacije so zasnovane od samega začetka upoštevajoč ta dejavnik. Na splošno je vsaka sodobna aplikacija, ki obdeluje podatke različnih vrst (dnevniki, metapodatki, blobi itd.), zgrajena po oblačno usmerjeni paradigmi, kjer se stanje prenese v posebno programsko opremo, namenjeno shranjevanju.
Kontejnerski pristop s shranjevanjem stanja prisili celotno to paradigmo, da se vrne nazaj točno tja, kjer se je začela!
Pri uporabi POSIX vmesnikov za shranjevanje podatkov aplikacije delujejo tako, kot da bi ohranjale stanje, kar jih oddaljuje od najpomembnejših načel oblikovanja v oblaku, tj. možnosti prilagajanja velikosti delovnih tokov aplikacije glede na prihajajočo obremenitev, premikanja na nov vozlišče takoj, ko trenutno vozlišče odpove, in tako naprej.
Ko se natančneje osredotočimo na to situacijo, ugotovimo, da se pri izbiri shranjevanja podatkov znova in znova soočamo z dilemo "POSIX proti REST API", VENDAR s dodatnim otežnjem težav POSIX, ki izhajajo iz porazdeljene narave okolij Kubernetes. Zlasti,
- POSIX pripoveden: semantika POSIX zahteva, da se z vsako operacijo povežejo metapodatki in opisniki datotek, ki pomagajo ohranjati stanje operacije. To privede do znatnih stroškov, ki nimajo nobene resnične vrednosti. API-ji za shranjevanje objektov, zlasti S3 API, so se znebili teh zahtev, kar omogoča aplikaciji, da izvede dejanje in nato "pozabi" na klic. Odgovor sistema za shranjevanje podatkov pove, ali je bila ta operacija uspešno zaključena ali ne. V primeru neuspeha lahko aplikacija izvede ponovni poskus.
- Omrežne omejitve: V porazdeljenem sistemu je predvideno, da lahko obstaja več aplikacij, ki poskušajo zapisati podatke na isti priložen nosilec. Zato ne le, da se aplikacije med seboj borijo za pasovno širino (da bi posredovale podatke na nosilec), temveč se tudi sama sistema shranjevanja podatkov bori za to pasovno širino, razdeljuje podatke po fizičnih diskih. Zaradi besedne razsipnosti POSIX se število omrežnih klicev poveča večkrat. Po drugi strani pa S3 API zagotavlja jasno ločitev omrežnih klicev med tistimi, ki prihajajo od stranke do strežnika, in tistimi, ki se dogajajo znotraj strežnika.
- Sigurnost: Model varnosti POSIX predvideva aktivno sodelovanje človeka: skrbniki konfigurirajo specifične ravni dostopa za vsakega uporabnika ali skupino. Takšna paradigma se težko prilagodi oblačnemu svetu. Sodobne aplikacije so odvisne od modelov varnosti, ki temeljijo na API-ju, kjer se pravice dostopa določajo kot niz politik, dodeljujejo se servisni računi, začasni poverilniki itd.
- Upravljivost: Kontejnerji s shranjevanjem stanja prinašajo določene stroške, povezane z upravljanjem. Gre za sinhronizacijo vzporednega dostopa do podatkov, zagotavljanje doslednosti podatkov, vse to zahteva skrbno premislek o tem, katere vzorce dostopa do podatkov uporabiti. Treba je namestiti, nadzorovati in konfigurirati dodatne programe, ne govorimo že o dodatnem delu, ki ga je treba vložiti v razvoj.
Vmesnik kontejnerskega shranjevanja podatkov
Medtem ko je vmesnik kontejnerskega shranjevanja podatkov (CSI) odlično pomagal pri širjenju ravni volumenov Kubernetes, delno prenesejočega na zunanje dobavitelje shranjevanja podatkov, je hkrati slučajno prispeval k prepričanju, da je kontejnerski pristop s shranjevanjem stanja priporočena metoda shranjevanja podatkov v Kubernetes.
CSI je bil razvit kot standard za zagotavljanje poljubnih sistemov blokovnega in datotečnega shranjevanja za dediščinske aplikacije pri delu s Kubernetes. In kot je bilo prikazano v tem članku, je edina situacija, v kateri je kontejnerski pristop s shranjevanjem stanja (in CSI v svoji trenutni obliki) smiselna, kadar je sama aplikacija dediščinski sistem, v katerem ni mogoče dodati podpore za API sistemov objektnega shranjevanja podatkov.
Pomembno je razumeti, da ob uporabi CSI v njegovi trenutni obliki, torej ob montiranju volumenov pri delu s sodobnimi aplikacijami, naletimo na približno enake težave, kot so se pojavile v sistemih, kjer je shranjevanje podatkov organizirano v slogu POSIX.
Bolj kakovosten pristop
V tem primeru je pomembno razumeti, da večina aplikacij sama po sebi ni zasnovana za delo z ohranjanjem ali brez ohranjanja stanja. Takšno vedenje je odvisno od splošne arhitekture sistema in konkretnih možnosti, izbranih pri načrtovanju. Malo se bomo pogovorili o aplikacijah, ki ohranjajo stanje.
Na splošno lahko vse podatke aplikacij razdelimo v več širokih kategoriij:
- Podatki o dnevnikih
- Podatki o časovnih žigih
- Podatki o transakcijah
- Metapodatki
- Slikovni kontejnrji
- Podatki o blobih (velikih binarnih objektih)
Vse te vrste podatkov se odlično podpirajo na sodobnih platformah za shranjevanje podatkov, in obstaja več oblačno usmerjenih platform, prilagojenih za dostavljanje podatkov v vsakem od teh specifičnih formatov. Na primer, podatki o transakcijah in metapodatki so lahko shranjeni v sodobni oblačno usmerjeni bazi podatkov, kot sta CockroachDB, YugaByte itd. Slikovni kontejnri ali podatki o blobih lahko shranimo v MinIO-ju osnovani docker registru. Podatki o časovnih žigih se lahko shranijo v bazo podatkov časovnih serij, kot je InfluxDB itd. Ne bomo se spuščali v podrobnosti vsake vrste podatkov in pripadajočih aplikacij, ampak osnovna ideja je, da se izognemo trajnemu shranjevanju podatkov, ki temelji na lokalnem montiranju diskov.
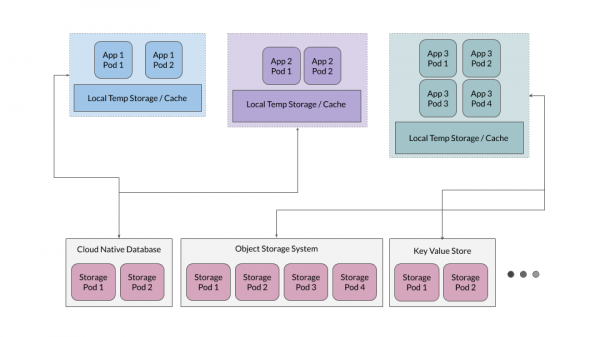
Poleg tega se pogosto izkaže, da je učinkovito nuditi raven začasnega predpomnjenja, ki služi aplikacijam kot nekakšno shranjevanje začasnih datotek, vendar aplikacije ne bi smele biti odvisne od te ravni kot od vira resnice.
Shranjevanje za aplikacije z ohranjanjem stanja
Medtem ko je v večini primerov koristno ohranjati aplikacije brez ohranjanja stanja, morajo tiste aplikacije, ki so namenjene shranjevanju podatkov – kot so baze podatkov, objektna shranjevanja, shranjevanja ključ-vrednost – ohranjati stanje. Poglejmo, zakaj te aplikacije nameščajo na Kubernetes. Kot primer bomo vzeli MinIO, vendar so podobna načela uporabna tudi za katere koli druge velike oblačno usmerjene sisteme shranjevanja podatkov.
Oblačno usmerjene aplikacije so zasnovane za maksimalno učinkovito izkoriščanje prilagodljivosti, značilne za kontejnere. To pomeni, da ne predvidevajo nobenega okolja, v katerem bodo nameščene. Na primer, MinIO uporablja notranji mehanizem za redundantno kodiranje (erasure coding), ki zagotavlja sistemu ustrezno odpornost, da ostane delujoč tudi ob okvari polovice diskov. Poleg tega MinIO upravlja celovitost in varnost podatkov z lastno hashešnjo in šifriranjem na strani strežnika.
Za takšne oblačno usmerjene aplikacije so lokalni persistentni volumni (PV) najbolj primerni kot rezervno skladišče. Lokalni PV omogoča shranjevanje surovih podatkov, medtem ko aplikacije, ki delujejo na teh PV, samostojno zbirajo informacije, ki omogočajo skaliranje podatkov in upravljanje rastočih zahtev po podatkih.
Taj pristop je veliko preprostejši in se bistveno bolje skalira v primerjavi s PV, ki temeljijo na CSI, ki v sistem prinašajo lastne ravni upravljanja podatkov in redundance; težava je v tem, da ta raven običajno konfliktira z aplikacijami, zasnovanimi po načelu ohranjanja stanja.
Zanesljiv premik k ločevanju podatkov od izračunov
V tem članku smo se pogovarjali o tem, kako se aplikacije preusmerjajo na delovanje brez ohranjanja stanja, oziroma, drugače povedano, shranjevanje podatkov je ločeno od izračunov nad njimi. Na koncu razmislimo o nekaj resničnih primerih te usmeritve.
, znana platforma za analizo podatkov, je bila tradicionalno uporabljena s ohranjanjem stanja in nameščanjem v datotečni sistem HDFS. Vendar pa se, ko se Spark seli v oblačno usmerjen svet, ta platforma vse bolj uporablja brez ohranjanja stanja z uporabo `s3a`. Spark uporablja s3a za prenos stanja v druge sisteme, medtem ko samotne kontejnerje Spark delujejo v celoti brez ohranjanja stanja. Drugi veliki podjetniški igralci na področju analitike velikih podatkov, zlasti , , prav tako prehajajo k delu z ločevanjem shranjevanja podatkov in izračunov nad njimi.
Podobni vzorci se pojavljajo tudi na drugih velikih analitičnih platformah, med katerimi so Presto, Tensorflow to R, Jupyter. Z izvozom stanja v oddaljene oblačne sisteme za shranjevanje podatkov je upravljanje vašega aplikacije in njeno širjenje veliko lažje. Poleg tega to spodbuja prenosljivost aplikacije v različna okolja.
Izvor: habr.com
