

Standard ASCII je bil sprejet leta 1963 in danes težko najdemo koga, ki bi uporabljal kodiranje, katerih prvih 128 znakov se razlikuje od ASCII. Kljub temu pa je do konca prejšnjega stoletja EBCDIC ostal aktivno uporabljen – standardno kodiranje za IBM glavne računalnike in njihove sovjetske klone ES EVM. EBCDIC ostaja osnovno kodiranje v z/OS – standardnem operacijskem sistemu za sodobne IBM Z glavne računalnike.
Prva stvar, ki pade v oči ob pogledu na EBCDIC, je, da črke niso razporejene zaporedno: med I in J in med R in S so ostale neizkoriščene pozicije (na ES EVM so med temi vrzeli znake cirilice). Kdo bi lahko pomislil, da bi kodiral črke z neenakomernimi presledki med sosednjimi črkami?
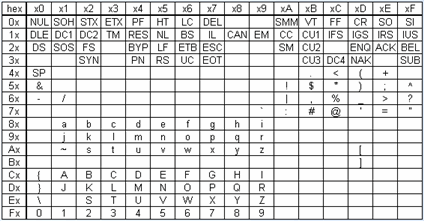
Sam izraz EBCDIC ("Extended BCDIC") namiguje, da je bila ta kodiranje – za razliko od ASCII – ustvarjena ne iz nič, temveč na podlagi šest-bitne kodiranja BCDIC, ki se je uporabljala od (1954):
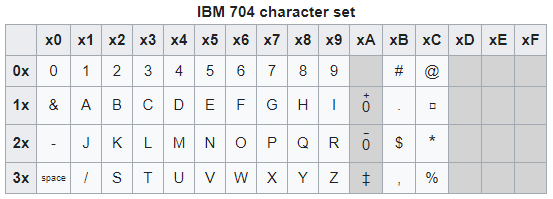
Neposredne združljive oblike ni: priročna značilnost BCDIC, ki je izgubljena ob prehodu na EBCDIC, je bila, da številkam 0—9 ustrezajo kode 0-9. Vendar so že obstajali premori s sedmimi kodi med I in J in z osmimi kodi med R in S v BCDIC. Kje so se torej pojavili?
Zgodovina (E)BCDIC se začne hkrati z zgodovino IBM – dolgo pred elektronskimi računalniki. IBM je nastal z združitvijo štirih podjetij, od katerih je bilo tehnološko najsodobnejše podjetje "Tabulating Machine Company", ki ga je leta 1896 ustanovil Herman Hollerith – izumitelj . Prvi tabulatorji so preprosto šteli število perforiranih kartic, ki so bile prebite na določenem mestu; toda leta 1905 je Hollerith začel s proizvodnjo desetičnih tabulatorjev. Vsaka kartica za desetični tabulator je bila sestavljena iz polj poljubne dolžine, in številke, zapisane v teh poljih v običajni decimalni obliki, so se seštevale čez celotno škatlo. Razdelitev kartice na polja je bila določena s povezovanjem žic na vezni plošči tabulatorja. Na tej perforirani kartici Holleritha, v Kongresni knjižnici, je očitno izpisano število 23456789012345678, neznano kako razdeljeno na polja:
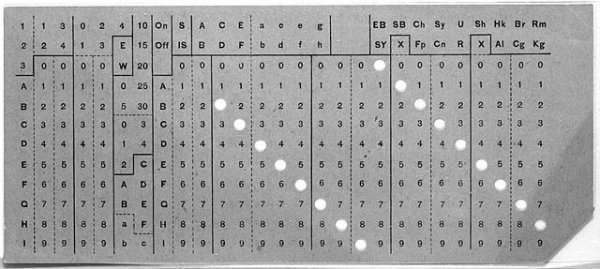
Najbolj pozorni so lahko opazili, da ima kartica Holleritha 12 vrst odprtin, čeprav so za številke zadostne deset. V BCDIC pa za vsako vrednost najvišjih dveh bitov uporabljamo le 12 kod od 16 možnih.
Seveda to ni naključje. Sprva je Hollerith namenil dodatne vrstice za "posebne oznake", ki niso bile seštete, temveč preprosto preštete – kot v najstarejših tabulatorjih. (Danes bi jih imenovali "bitna polja".) Poleg tega je bilo med "posebnimi oznakami" mogoče nastaviti group indicators: če so bili pri tabulaciji potrebni ne le končni seštevki, temveč tudi vmesni, je tabulator ustavil, ko je zaznal spremembo katerega od group indicators, in operater je moral ponovno zabeležiti vmesne zneske z digitalnih tabel na papir, ponastaviti tabelo in nadaljevati s tabulacijo. Na primer, pri štetju računovodskih bilanc je skupina kart lahko ustrezala enemu datumu ali enemu partnerju.
Do leta 1920, ko je Hollerith že odšel v pokoj, so v uporabo prišli "tiskalni tabulatorji", ki so se povezovali s teletipom in so lahko sami tiskali vmesne zneske, ne da bi potrebovali posredovanje operaterja. Kompleksnost je bila zdaj v tem, da je bilo treba določiti, na kaj se nanaša vsako od odtiskanih številk. Leta 1931 je IBM odločil, da bo s pomočjo "posebnih oznak" označeval črke: oznaka v 12. vrstici je označevala črko od A do I, v 11. vrstici – od J do R, v ničli – od S do Z. Nov "alfabetski tabulator" je lahko tiskal imeni vsake skupine kart skupaj z medsebnimi zneski; pri tem je nepokrit stolpec postal presledek med simboli. Upoštevajte, da S je označeno s kombinacijo lukenj 0+2, medtem ko je bila kombinacija 0+1 prvotno neuporabljena zaradi strahu, da bi lahko dve luknji v enem stolpcu povzročili mehanske težave pri bralniku.
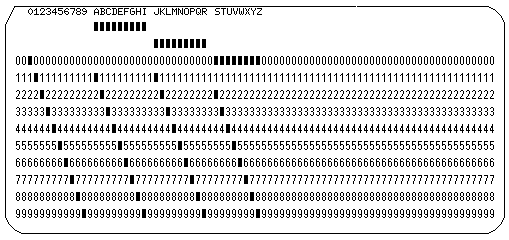
Zdaj lahko na tabelo BCDIC pogledamo nekoliko drugače:
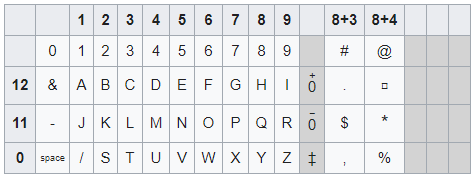
Razlika je le ta, da sta 0 in presledek zamenjana, starejša dva bita določata "posebno oznako", ki se od leta 1931 pritisne v perforirano kartico za ustrezni simbol; mlajša štiri bita pa določata številko, ki se pritisne v glavnem delu kartice. Podpora simbolov & - / V 30. letih prejšnjega stoletja so se začeli uporabljati v IBM-ovih tabulatorjih, kodiranje teh znakov v BCDIC pa ustreza kombinacijam lukenj, ki so jih izbirali. Ko je bila potrebna podpora za še več znakov, so za dodatno 'posebno oznako' začeli prebiti vrsto 8 — tako je bilo v eni stolpci lahko do tri luknje. Ta format perforiranih kartic je ostal praktično nespremenjen do konca stoletja. V ZSSR so ohranili IBM-ove kodiranja latinice in interpunkcije, za cirilico pa so prebili več 'posebnih oznak' v vrsticah 12, 11, 0 — ne omejujoč se na tri luknje v enem stolpci.
Ko so izdelovali računalnik IBM 704, o kodiranju znakov niso dolgo razmišljali: preprosto so vzeli kodiranje, ki se je že uporabljalo v perforiranih karticah, in samo '0' so 'postavili na svoje mesto'. Leta 1964, ko so prešli z BCDIC na EBCDIC, so spodnje štiri bite vsakega znaka pustili nespremenjene, čeprav so nekoliko premešali zgornje bite. Tako je imel format perforiranih kartic, ki ga je na začetku prejšnjega stoletja izbral Hollerith, vpliv na arhitekturo vseh IBM-ovih računalnikov, vključno z IBM Z.
Izvor: habr.com
