

TL;DR: Pred štirimi leti sem zapustil Google z idejo o novem orodju za spremljanje strežnikov. Ideja je bila združiti običajno izolirane funkcije v eno storitev. in analize dnevnikov, zbiranja metrik, in nadzornih plošč. Eden od načel je, da mora biti storitev resnično hitro, kar devopsom omogoča enostavno, interaktivno in prijetno delo. To zahteva obdelavo nizov podatkov po več gigabajtov v delčkih sekunde, ne da bi šli čez proračun. Obstoječa orodja za delo z dnevniki so pogosto počasna in okorna, zato smo naleteli na dobro nalogo: pametno razviti orodje, ki bi uporabnikom ponudilo novo izkušnjo dela.
V tem članku opisujemo, kako smo v Scalyrju rešili ta problem s pomočjo starih šolskih metod, pristopa surove sile, odpravljanjem nepotrebnih plasti in izogibanjem zapletenim podatkovnim strukturam. Te lekcije lahko uporabite pri svojih inženirskih izzivih.
Moč stare šole
Analiza dnevnikov se običajno začne z iskanjem: najti vse sporočile, ki ustrezajo določenemu vzorcu. V Scalyrju to pomeni desetine ali stotine gigabajtov dnevnikov z več strežnikov. Sodobni pristopi običajno predvidevajo gradnjo neke zapletene podatkovne strukture, optimizirane za iskanje. Seveda sem takšne stvari videl v Googlu, kjer so precej dobri v teh stvareh. Ampak ustavili smo se pri precej bolj grobem pristopu: linearno skeniranje dnevnikov. In to je delovalo — zagotavljamo vmesnik z iskanjem, ki je red velikosti hitrejši od konkurence (glejte animacijo na koncu).
Ključna spoznanja so, da so današnji procesorji pravzaprav zelo hitri pri preprostih, neposrednih operacijah. Enostavno je to spregledati v zapletenih, večplastnih sistemih, ki so odvisni od hitrosti I/O in omrežnih operacij, katere danes zelo pogosto uporabljamo. Tako smo razvili zasnovo, ki minimalizira število plasti in odvečnega napuha. S štirimi procesorji in strežniki hkrati hitrost iskanja doseže 1 TB na sekundo.
Ključni zaključki iz tega članka:
- Grobo iskanje je povsem izvedljiv pristop za reševanje realnih, obsežnih težav.
- Brute force is a design technique, not a way to avoid work. Like any technique, it is better suited for some problems than others, and it can be implemented poorly or well.
- Brute force is especially good for achieving stabilni performance.
- Effective use of brute force requires code optimization and timely application of sufficient resources. It is suitable if your servers are under significant load unrelated to users, while user operations remain a priority.
- Performance depends on the design of the entire system, not just the internal loop algorithm.
(This article describes data retrieval from memory. In most cases when a user searches through logs, the Scalyr servers have already cached them. In the next article, we will discuss searching through uncached logs. The same principles apply: efficient code, brute force method with substantial computational resources).
Brute force method
Traditionally, searching in a large dataset is done using a keyword index. In the context of server logs, this means searching for each unique word in the log. A list of all occurrences needs to be compiled for each word. This allows easy retrieval of all messages containing that word, such as ‘error’, ‘firefox’, or ‘transaction_16851951’ — we simply look it up in the index.
I used this approach at Google, and it worked well. But at Scalyr, we search the logs byte by byte.
Why? From an abstract algorithmic standpoint, keyword indexes are much more efficient than brute search. However, we do not sell algorithms; we sell performance. And performance is not only about algorithms but also about system engineering. We must take everything into account: data volume, search type, available hardware, and software context. We decided that for our specific problem, a solution like ‘grep’ is better suited than an index.
Indexes are great, but they have limitations. Finding a single word is easy. However, searching for messages containing multiple words, such as ‘googlebot’ and ‘404’, is much more complicated. Searching for a phrase like ‘uncaught exception’ requires a bulkier index that logs not only all messages containing that word but also the specific location of the word.
Najnovejša težava se pojavi, ko iščete ne besede. Predpostavimo, da želite preveriti, koliko prometa prihaja od botov. Prva misel je iskati v dnevnikih po besedi 'bot'. Tako boste našli nekatere bote: Googlebot, Bingbot in mnoge druge. Ampak tukaj 'bot' ni beseda, ampak njen del. Če iščete 'bot' v indeksu, ne bomo našli vnosov s besedo 'Googlebot'. Če preverimo vsako besedo v indeksu in nato skeniramo indeks po najdenih ključnih besedah, se iskanje precej upočasni. Posledično nekateri programi za delo z dnevniki ne dovolijo iskanja po delih besed ali (v najboljšem primeru) omogočajo uporabo posebne sintakse z manjšo zmogljivostjo. Temu se želimo izogniti.
Še en problem je ločila. Želite najti vse poizvedbe od 50.168.29.7? Что насчёт отладки логов, содержащих [error]? Индексы обычно пропускают пунктуацию.
Nazadnje, inženirji obožujejo močna orodja, včasih pa je težavo mogoče rešiti le z regularnimi izrazами. Indeks ključnih besed ni najbolj primeren za to.
Poleg tega so indeksi zapleteni. Vsako sporočilo je treba dodati v več seznamov ključnih besed. Te sezname je treba stalno vzdrževati v iskanju prijaznem formatu. Poizvedbe s frazami, deli besed ali regularnimi izrazi je treba pretvoriti v operacije z več seznami, nato pa rezultate skenirati in združiti za pridobitev izhodnega sklopa. V kontekstu obsežno razširjene večuporabniške storitve ta kompleksnost povzroča težave s zmogljivostjo, ki niso vidne pri analizi algoritmov.
Indeksi ključnih besed prav tako zavzemajo veliko prostora, shranjevanje pa je glavni strošek v sistemu za upravljanje dnevnikov.
Z druge strani pa lahko porabimo veliko računalniške moči za vsak iskalni poizvedbo. Naši uporabniki cenijo hitro iskanje po edinstvenih poizvedbah, ki pa se dogajajo razmeroma redko. Za tipične iskalne poizvedbe, kot je nadzorna plošča, uporabljamo posebne tehnike (te bomo opisali v naslednjem članku). Druge poizvedbe so dovolj redke, tako da redko obdelujemo več kot eno naenkrat. Vendar to ne pomeni, da naši strežniki niso zasedeni: obremenjeni so z delom sprejemanja, analize in stiskanja novih sporočil, ocenjevanja obvestil, stiskanja starih podatkov in podobno. Tako imamo precejšen presežek procesorjev, ki jih lahko uporabimo za obdelavo poizvedb.
Brutalna sila deluje, če imate brutalni problem (in veliko sile).
Brutalna sila najbolje deluje pri preprostih nalogah z majhnimi notranjimi cikli. Pogosto lahko optimizirate notranji cikel za delovanje pri zelo visokih hitrostih. Če je koda zapletena, jo je veliko težje optimizirati.
Sprva je bila naša koda za iskanje precej obsežna notranja zanka. Shranjujemo sporočila na straneh po 4K; vsaka stran vsebuje nekatera sporočila (v UTF-8) in metapodatke za vsako sporočilo. Metapodatki so struktura, v kateri so kodirane dolžine vrednosti, notranji ID sporočila in druga polja. Zanka iskanja je izgledala tako:
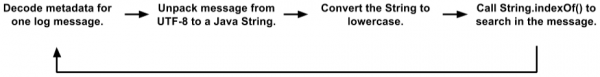
To je poenostavljena različica v primerjavi z dejansko kodo. Vendar pa je že tukaj vidnih več dodelitev objektov, kopij podatkov in klicev funkcij. JVM dokaj dobro optimizira klice funkcij in dodeljuje efemerne objekte, zato je ta koda delovala bolje, kot bi si zaslužila. Med testiranjem so jo stranke precej uspešno uporabljale. A na koncu smo prešli na novo raven.
(Lahko se sprašujete, zakaj hranimo sporočila v takšni obliki na straneh po 4K, z besedilom in metapodatki, namesto da bi delali neposredno z dnevniki. Obstaja veliko razlogov, ki se nanašajo na to, da je notranji mehanizem Scalyr bolj podoben porazdeljeni bazi podatkov kot datotečnemu sistemu. Iskanje besedila je pogosto kombinirano s filtri v slogu DBMS na poljih po razčlenitvi dnevnikov. Hkrati lahko iščemo po številnih tisoč dnevnikov, preproste besedilne datoteke pa ne ustrezajo našemu transakcijskemu, repliciranemu, porazdeljenemu upravljanju podatkov.)
Sprva se je zdelo, da ta koda ni preveč primerna za optimizacijo s pomočjo metode grobe sile. 'Pravo delo' v String.indexOf() se niti ni dominirala v profiliranju CPU. To pomeni, da optimizacija le-tega metoda ne bi prinesla pomembnega učinka.
Izkazalo se je, da hranimo metapodatke na začetku vsake strani, besedilo vseh sporočil pa v UTF-8 je pakirano na drugem koncu. Z izkoriščanjem tega smo prepisali zanko za iskanje po celotni strani:
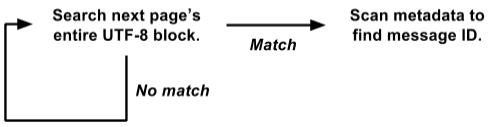
Ta različica deluje neposredno na predstavitvi raw byte[] in izvaja iskanje vseh sporočil hkrati na celotni strani 4K.
To je veliko lažje optimizirati za metodo grobe sile. Notranja iskalna zanka se kliče hkrati za celo stran 4K, ne pa posebej za vsako sporočilo. Ni kopiranja podatkov, ni dodeljevanja predmetov. In bolj kompleksne operacije z metapodatki se kličejo le ob pozitivnem rezultatu, ne pa za vsako sporočilo. Tako smo izključili tono odvečnih stroškov, preostala obremenitev pa je osredotočena v majhni notranji iskalni zanki, ki je dobro primerna za nadaljnjo optimizacijo.
Naš dejanski iskalni algoritem temelji na . Podoben je Boyer-Moorejevi metodi z preskočitvijo približno dolžine iskalnega niza pri vsakem koraku. Glavna razlika je, da preverja dva bajta hkrati, da minimizira lažne avtomatizme.
Naša implementacija zahteva ustvarjanje iskalne tabele 64K za vsak iskalni postopek, vendar je to malenkost v primerjavi z gigabajti podatkov, v katerih iščemo. Notranja zanka obdela več gigabajtov na sekundo na eni jedri. V praksi stabilna zmogljivost znaša približno 1,25 GB na sekundo na jedro, in obstaja potencial za izboljšave. Nekatere stroške zunaj notranje zanke lahko odstranimo, prav tako načrtujemo eksperimentiranje z notranjo zanko v C namesto Java.
Uporabimo moč
Pogovarjali smo se, da je iskanje po dnevnikih mogoče izvesti »grobo«, vendar koliko »moči« imamo? Ni malo.
1 jedro: ob pravilni uporabi je eno jedro modernega procesorja kar precej močno samo po sebi.
8 jeder: trenutno delamo na strežnikih Amazon hi1.4xlarge in i2.4xlarge SSD, na vsakem od katerih je 8 jeder (16 niti). Kot je bilo omenjeno, so ta jedra običajno zasedena z ozadjnimi operacijami. Ko uporabnik izvede iskanje, se ozadne operacije ustavijo, kar osvobodi vseh 8 jeder za iskanje. Iskanje se običajno zaključi v delčku sekunde, nato se ozadnje delo nadaljuje (program regulater zagotavlja, da val iskalnih poizvedb ne ovira pomembnega ozadnega dela).
16 jeder: za zanesljivost organiziramo strežnike v skupine master/slave. Vsak master ima podrejeni SSD strežnik in en EBS. Če glavni strežnik pade, podrejeni SSD strežnik takoj prevzame njegovo mesto. Večinoma master in slave delujeta normalno, tako da je vsak blok podatkov dostopen za iskanje na dveh različnih strežnikih (podrejeni strežnik EBS ima šibek procesor, zato ga ne obravnavamo). Nalogo razdelimo med njiju, tako da imamo na voljo skupno 16 jeder.
Mnogo jeder: v prihodnosti bomo razporedili podatke po strežnikih tako, da bodo vsi sodelovali pri obdelavi vsakega netrivialnega poizvedovanja. Vsako jedro bo delovalo. [Opomba: implementirali smo načrt in povečali hitrost iskanja na 1 TB/s, glej opombo na koncu članka].
Enostavnost zagotavlja zanesljivost
Še ena prednost metode grobe sile je precej stabilna zmogljivost. Na splošno iskanje ni preveč občutljivo na podrobnosti naloge in nabor podatkov (mislimo, da ga prav zato imenujejo 'groba').
Indeks ključnih besed včasih prinese neverjetno hitro rešitev, v drugih primerih pa ne. Recimo, da imate 50 GB dnevnikov, v katerih se izraz 'customer_5987235982' pojavi točno trikrat. Iskanje po tem izrazu neposredno iz indeksa obravnava tri lokacije in se zaključi takoj. Toda zapleteno iskanje z opozorilnimi znaki lahko skenira tisoče ključnih besed in traja veliko časa.
Z druge strani se iskanje z grobo silo za katerikoli poizvedbo izvaja s približno enako hitrostjo. Iskanje dolgih besed je boljše, vendar tudi iskanje enega znaka poteka kar hitro.
Enostavnost metode grobe sile pomeni, da je njena zmogljivost blizu teoretične maksime. Tukaj je manj možnosti za nepričakovano preobremenitev diskov, konflikte pri zaklepanju, sledenje kazalcem in tisoče drugih razlogov za napake. Pravkar sem pogledal na poizvedbe, ki so jih uporabniki Scalyr posredovali prejšnji teden na našem najbolj obremenjenem strežniku. Bilo je 14.000 poizvedb. Točno osem od njih je trajalo več kot eno sekundo; 99% jih je bilo izvedenih v 111 milisekundah (če niste uporabljali orodij za analizo dnevnikov, verjemite: to je hitro).
Stabilna, zanesljiva zmogljivost je pomembna za uporabniško izkušnjo storitve. Če občasno zastaja, bodo uporabniki to dojemali kot nezanesljivo in se ne bodo radi prijavili.
Iskanje po dnevnikih v praksi
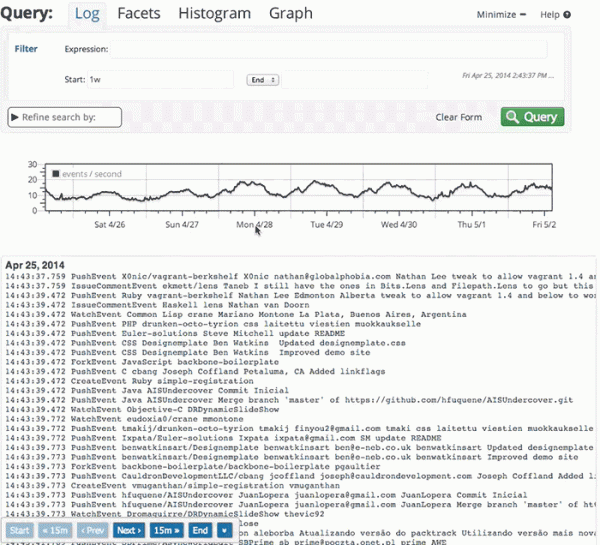
Tukaj je majhna animacija, ki prikazuje iskanje Scalyr v praksi. Imamo demo račun, kjer uvažamo vsako dogajanje iz vsake javne repozitorije Github. V tej predstavitvi preučujem podatke iz prejšnjega tedna: približno 600 MB neobdelanih dnevnikov.
Video je bil posnet v živo, brez posebne priprave, na mojem namizju (približno 5000 kilometrov od strežnika). Zmogljivost, ki jo boste videli, je v veliki meri posledica , kot tudi hitrega in zanesljivega ozadja. Vedno, ko pride do zaustavitve brez kazalnika 'nalagam', jaz ustavim, da imate čas prebrati, kaj bom pritisnil.
Na záver
Pri obdelavi velikih količin podatkov je pomembno izbrati dober algoritem, vendar "dober" ne pomeni "zapleten". Razmislite o tem, kako bo vaš kod deloval v praksi. Nekateri faktorji, ki lahko igrajo veliko vlogo v realnem svetu, padejo iz teoretične analize algoritemov. Enostavnejši algoritmi so lažje optimizirani in so bolj stabilni v mejnih situacijah.
Prav tako razmislite o kontekstu, v katerem se bo kod izvajal. V našem primeru potrebujemo dovolj zmogljive strežnike za obvladovanje ozadja nalog. Uporabniki relativno redko začnejo iskanje, zato lahko na kratko pošljemo celo skupino strežnikov, ki je potrebna za izvedbo vsakega iskanja.
Z metodo brutalne sile smo implementirali hiter, zanesljiv in prilagodljiv iskalnik po naboru dnevnikov. Upamo, da bodo te ideje koristne za vaše projekte.
Ureditev: naslov in besedilo sta se spremenila z "Iskanje pri hitrosti 20 GB na sekundo" na "Iskanje pri hitrosti 1 TB na sekundo", da bi odražala povečanje zmogljivosti v zadnjih nekaj letih. To povečanje hitrosti je predvsem posledica spremembe vrste in števila strežnikov EC2, ki jih danes postavljamo za zadovoljitev povečane baze strank. V bližnji prihodnosti pričakujemo spremembe, ki bodo zagotovile še eno ostro povečanje učinkovitosti in z nestrpnostjo čakamo, ko bomo imeli priložnost o tem poročati.
Izvor: habr.com
