

Nadaljevanje prevoda majhne knjige:
«Razumevanje sporočilnih posrednikov»
avtor: Jakub Korab, založba: O’Reilly Media, Inc., datum izdaje: junij 2017, ISBN: 9781492049296.
Prejšnji prevedeni del:
POGLAVJE 3
Kafka
Kafka je bila zasnovana v LinkedInu, da bi obšla nekatere omejitve tradicionalnih sporočilnih posrednikov in se izognila potrebi po konfiguraciji več sporočilnih posrednikov za različne interakcije 'točka-točka', kar je opisano v tej knjigi v razdelku 'Vertikalno in horizontalno skaliranje' na strani 28. Uporabniški scenariji v LinkedInu so se večinoma osredotočali na enosmerno absorpcijo zelo velikih količin podatkov, kot so kliki na straneh in dnevniki dostopa, pri čemer so omogočili uporabo teh podatkov več sistemom, ne da bi vplivali na zmogljivost producentov ali drugih potrošnikov. Dejansko je razlog za obstoj Kafke, da zagotavlja tako arhitekturo izmenjave sporočil, kot jo opisuje Univerzalna podatkovna cev.
Ob upoštevanju te končne cilje so se naravno pojavile tudi druge zahteve. Kafka mora:
- Biti izjemno hitra
- Zagotavljati visoko prepustnost pri obdelavi sporočil
- Podpirati modele 'Založnik-Naročnik' in 'Točka-Točka'
- Ne upočasniti se z dodajanjem potrošnikov. Na primer, zmogljivost tako vrstic kot tudi topicov v ActiveMQ se poslabša z naraščanjem števila potrošnikov na naslovniku
- Biti horizontalno skalabilna; če lahko en broker, ki shranjuje sporočila, to počne le z največjo hitrostjo diska, ima smisel, da presežemo en sam primer brokerja, da povečamo zmogljivost
- Razmejiti dostop do shranjevanja in ponovnega pridobivanja sporočil
Da bi dosegli vse to, je v Kafki sprejeta arhitektura, ki je spremenila vloge in odgovornosti odjemalcev in posrednikov za izmenjavo sporočil. Model JMS je zelo usmerjen v posrednika, ki je odgovoren za širjenje sporočil, medtem ko se morajo odjemalci osredotočiti le na pošiljanje in prejemanje sporočil. Kafka pa je usmerjena k odjemalcu, pri čemer odjemalec prevzema številne funkcije tradicionalnega posrednika, kot je pravična porazdelitev ustreznih sporočil med potrošniki, v zameno pa pridobiva izjemno hitro in razširljivo storitev posredovanja. Za ljudi, ki so delali s tradicionalnimi sistemi za izmenjavo sporočil, delo s Kafko zahteva temeljne spremembe v pogledu.
Ta inženirski pristop je privedel do nastanka infrastrukture za izmenjavo sporočil, sposobne povečati prepustnost za več vrst po vrstah v primerjavi s tradicionalnim posrednikom. Kot bomo videli, je ta pristop povezan s kompromisi, ki pomenijo, da Kafka ni primerna za določene vrste obremenitev in obstoječih programske opreme.
Enotna model naslovnika
Da bi izpolnili zgoraj opisane zahteve, je Kafka združila izmenjavo sporočil tipa "objava-naročanje" in "točka-točka" v okviru ene vrste naslovnika — teme. To zmede ljudi, ki so delali s sistemi izmenjave sporočil, kjer beseda "tema" pomeni širokomehanizem, iz katerega branje (iz teme) ni zanesljivo (je nezanesljivo). Temam Kafke je treba gledati kot na hibridno vrsto naslovnika, v skladu s definicijo, dano v uvodu te knjige.
V preostalem delu te poglavja, razen če izrecno navedemo drugače, bo izraz "tema" nanašal na temo Kafke.
Da bi popolnoma razumeli, kako se teme obnašajo in katere garancije ponujajo, moramo najprej obravnavati, kako so implementirane v Kafki.
Vsaka tema v Kafki ima svoj dnevnik.
Producenci, którzy wysyłają komunikaty do Kafki, zapisują je w tym dzienniku, a konsumenci odczytują z dziennika za pomocą wskaźników, które nieustannie przesuwają się do przodu. Okresowo Kafka usuwa najstarsze części dziennika, niezależnie od tego, czy komunikaty w tych częściach zostały odczytane, czy nie. Centralnym elementem projektu Kafki jest to, że broker nie przejmuje się tym, czy komunikaty zostały odczytane, czy nie — to jest odpowiedzialność klienta.
Terminy „dziennik” i „wskaźnik” nie występują w . Te dobrze znane terminy są używane tutaj, aby ułatwić zrozumienie.
Ten model różni się całkowicie od ActiveMQ, gdzie komunikaty z wszystkich kolejek są przechowywane w jednym dzienniku, a broker oznacza komunikaty jako usunięte po ich odczytaniu.
Przyjrzyjmy się teraz nieco bliżej dziennikowi tematu.
Dziennik Kafki składa się z kilku partycji (). Kafka gwarantuje ścisłą kolejność w każdej partycji. Oznacza to, że komunikaty zapisane w partycji w określonym porządku będą odczytywane w tym samym porządku. Każda partycja zrealizowana jest w postaci cyklicznego pliku dziennika, który zawiera podzbiór (subset) wszystkich komunikatów wysłanych do tematu przez jego producentów. Utworzony temat domyślnie zawiera jedną partycję. Pomysł partycji jest centralnym pomysłem Kafki na poziome skalowanie.
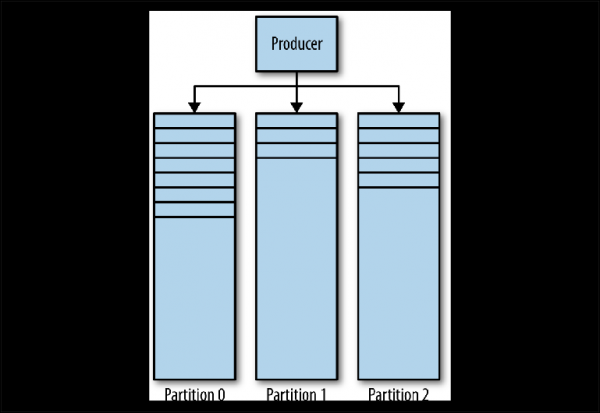
Rysunek 3-1. Partycje Kafki
Gdy producent wysyła komunikat do tematu Kafki, decyduje, do której partycji wysłać komunikat. Przyjrzymy się temu bardziej szczegółowo później.
Čitanje poruka
Klient, który chce odczytać komunikaty, zarządza nazwanym wskaźnikiem, zwanym grupą konsumentów (consumer group), który wskazuje na offset komunikatu w partycji. Offset to pozycja z rosnącym numerem, która zaczyna się od 0 na początku partycji. Ta grupa konsumentów, na którą wskazuje się w API przez definiowany przez użytkownika identyfikator group_id, odpowiada jednemu logicznemu konsumentowi lub systemowi..
Większość systemów korzystających z wymiany komunikatów odczytuje dane z adresata za pomocą kilku instancji i wątków w celu równoległego przetwarzania komunikatów. Dlatego zazwyczaj będzie wiele instancji konsumentów współdzielących tę samą grupę konsumentów.
Težavo branja lahko predstavimo na naslednji način:
- Tematika ima več particij.
- Tematika lahko hkrati uporablja več skupin porabnikov.
- Skupina porabnikov lahko ima več ločenih instanc.
To je netrivialen problem "mnoge proti mnogim". Da bi razumeli, kako Kafka obravnava odnose med skupinami porabnikov, instancami porabnikov in particijami, si poglejmo vrsto postopoma zahtevnejših scenarijev branja.
Porabniki in skupine porabnikov
Vzemimo za izhodišče tematiko z eno particijo ().
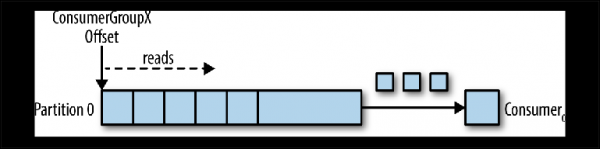
Slika 3-2. Porabnik bere iz particije
Ko se instanca porabnika poveže s svojim lastnim group_id na to tematiko, ji je dodeljena particija za branje in offset v tej particiji. Položaj tega offseta je konfiguriran v odjemalcu kot kazalec na najnovejšo pozicijo (najnovejša sporočila) ali najstarejšo pozicijo (najstarejša sporočila). Porabnik zahteva (polls) sporočila iz tematike, kar privede do njihovega zaporednega branja iz dnevnika.
Položaj offseta se redno potrjuje nazaj v Kafka in se shrani kot sporočila v notranji tematiki _consumer_offsets. Prebrana sporočila se vseeno ne izbrišejo, za razliko od običajnega posrednika, in stranka lahko previje (rewind) offset, da ponovno obdeluje že pregledana sporočila.
Ko se poveže drugi logični porabnik, ki uporablja drug group_id, upravlja z drugim kazalcem, ki ni odvisen od prvega (). Tako tematika Kafka deluje kot vrsta, v kateri obstaja en porabnik, in kot običajna tematika založnik-naročnik (pub-sub), na katero se naroči več porabnikov, s dodatno prednostjo, da se vsa sporočila shranijo in jih je mogoče obdelovati večkrat.
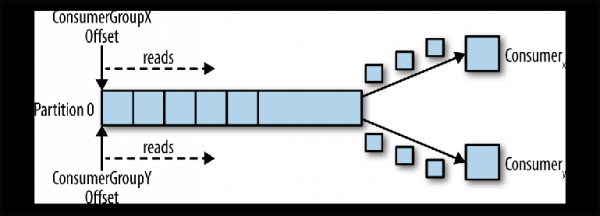
Slika 3-3. Dva porabnika v različnih skupinah porabnikov bereta iz ene particije
Porabniki v skupini porabnikov
Ko ena instanca porabnika bere podatke iz particije, popolnoma nadzira kazalec in obdeluje sporočila, kot je opisano v prejšnjem razdelku.
Če so bili več primerkov potrošnikov povezani z istim group_id s temo z eno particijo, bo zadnjemu povezanemu primeru dodeljena kontrola nad kazalnikom, in od tega trenutka naprej bo prejemal vse sporočila ().
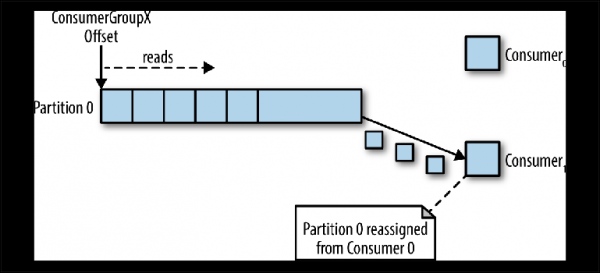
Slika 3-4. Dva potrošnika v isti skupini potrošnikov bereta iz ene particije
Ta način obdelave, v katerem število primerkov potrošnikov presega število particij, se lahko obravnava kot vrsta monopolnega potrošnika. To je lahko koristno, če potrebujete 'aktivno-pasivno' (ali 'vročo-toplo') klasterizacijo vaših primerkov potrošnikov, čeprav je hkratno delovanje več potrošnikov ('aktivno-aktivno' ali 'vroče-vroče') precej bolj običajno kot potrošniki v načinu čakanja.
Takšno vedenje porazdelitve sporočil, opisano zgoraj, lahko preseneti v primerjavi s tem, kako se obnaša običajen JMS čakalni red. V tem modelu se sporočila, poslana v čakalni red, enakomerno razporedijo med dvema potrošnikoma.
Najpogosteje, ko ustvarimo več primerkov potrošnikov, to počnemo bodisi za paralelno obdelavo sporočil, bodisi za povečanje hitrosti branja, bodisi za povečanje odpornosti postopka branja. Ker lahko podatke iz particije hkrati bere le en primer potrošnika, kako to dosežejo v Kafki?
Eden od načinov za to je uporaba enega primerka potrošnika, da prebere vsa sporočila in jih prenese v skupino niti. Čeprav ta pristop povečuje prepustnost obdelave, povečuje težavnost logike potrošnikov in ne povečuje odpornosti bralnega sistema. Če se en primer potrošnika izključi zaradi izpada električne energije ali podobnega dogodka, prebiranje preneha.
Kanoničen način reševanja tega problema v Kafki je uporaba večOparticij.
Particioniranje
Particije so glavni mehanizem za razprševanje branja in skaliranje teme onkraj prepustnosti enega brokera. Da bi bolje razumeli to, si poglejmo situacijo, kjer obstaja tema z dvema particijama in na to temo se prijavi en potrošnik ().
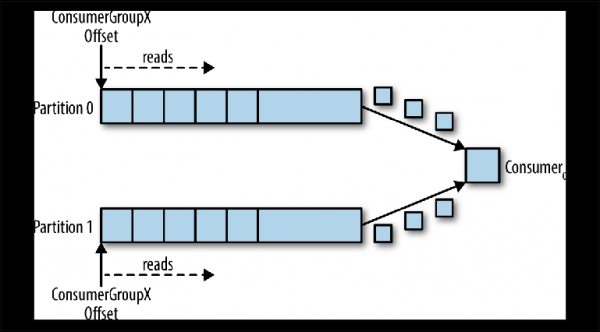
Рисунок 3-5. Один консюмер читает из нескольких партиций
В этом сценарии консюмер получает контроль над указателями, соответствующими его group_id в обеих партициях, и начинает чтение сообщений из обеих партиций.
Когда в этот топик добавляется дополнительный консюмер для того же group_id, Kafka переназначает (reallocate) одну из партиций с первого на второй консюмер. После чего каждый экземпляр консюмера будет читаться из одной партиции топика ().
Чтобы обеспечить обработку сообщений параллельно в 20 потоков, вам потребуется как минимум 20 партиций. Если партиций будет меньше, у вас останутся консюмеры, которым не над чем работать, что уже обсуждалось ранее в контексте монопольных консюмеров.
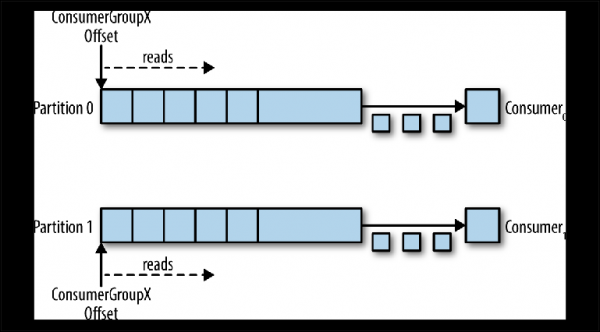
Рисунок 3-6. Два консюмера в одной и той же группе консюмеров читают из разных партиций
Эта схема значительно снижает сложность работы брокера Kafka по сравнению с распределением сообщений, необходимым для поддержки очереди JMS. Здесь не нужно заботиться о следующих моментах:
- Какой консюмер должен получить следующее сообщение, основываясь на циклическом (round-robin) распределении, текущей емкости буферов предварительной выборки или предыдущих сообщениях (как в случае групп сообщений JMS).
- Какие сообщения отправлены каким консюмерам и должны ли они быть доставлены повторно в случае сбоя.
Все, что должен сделать брокер Kafka — это последовательно передавать сообщения консюмеру, когда последний запрашивает их.
Однако, требования к распараллеливанию вычитки и повторной отправке неудачных сообщений никуда не деваются — ответственность за них просто переходит от брокера к клиенту. Это означает, что они должны быть учтены в вашем коде.
Отправка сообщений
Ответственность за то, в какую партицию отправить сообщение, возлагается на продюсера этого сообщения. Чтобы понять механизм, с помощью которого это делается, сначала нужно рассмотреть, что именно мы на самом деле отправляем.
В то время как в JMS мы используем структуру сообщения с метаданными (заголовками и свойствами) и телом, содержащим полезную нагрузку (payload), в Kafka сообщение является парой «ключ-значение»Navozna obvestila se pošilja kot vrednost (value). Ključ pa se uporablja predvsem za partitioning in mora vsebovati ključ specifičen za poslovno logiko, da se povezana obvestila postavijo v isto particijo.
V Poglavju 2 smo obravnavali scenarij spletnih stav, kjer morajo biti povezana dogodka obdelana zaporedno z enim porabnikom:
- Uporabniški račun je nastavljen.
- Denar je nakazan na račun.
- Uveljavljen je stavek, ki dvigne denar z računa.
Če vsak dogodek predstavlja sporočilo, poslano v temo, potem bo v tem primeru naravni ključ identifikator računa.
Ko se sporočilo pošlje z uporabo Kafka Producer API, se prenese na funkcijo partitioniranja, ki, upoštevajoč sporočilo in trenutno stanje Kafka klasterja, vrne identifikator particije, v katero mora biti sporočilo poslano. Ta funkcija je implementirana v Javi preko vmesnika Partitioner.
Ta vmesnik izgleda takole:
interface Partitioner {
    int partition(String topic,
        Object key, byte[] keyBytes, Object value, byte[] valueBytes, Cluster cluster);
}
Implementacija Partitioner za določitev particije uporablja privzeto algoritme hashiranja ključa (general-purpose hashing algorithm over the key) ali krožno premoščanje (round-robin), če ključ ni naveden. Ta privzeta vrednost deluje dobro v večini primerov. Vendar pa boste morda želeli v prihodnosti napisati svojo.
Pisanje lastne strategije partitioniranja
Poglejmo primer, kjer želite poslati metapodatke skupaj s koristno obremenitvijo sporočila. Koristna obremenitev v našem primeru je navodilo za polog na igralni račun. Navodilo je tisto, kar bi želeli zagotovo ne spremeniti med prenosom in želimo biti prepričani, da lahko to navodilo sproži le zaupanja vredni višji sistem. V tem primeru se pošiljateljske in sprejemne sisteme dogovorijo o uporabi podpisa za preverjanje pristnosti sporočila.
V običajnem JMS preprosto definiramo lastnost "podpis sporočila" in jo dodamo sporočilu. Vendar pa Kafka ne nudi mehanizma za prenos metapodatkov — le ključ in vrednost.
Ker ker je vrednost — to prozračna obdelava bančnega prenosa (bank transfer payload), katere celovitost želimo ohraniti, nimamo druge izbire, kot da določimo strukturo podatkov, ki jo bomo uporabili v ključu. Predpostavljamo, da potrebujemo identifikator računa za particioniranje, saj morajo biti vse povezana sporočila povezana z računom obdelana v vrstnem redu, zato bomo zasnovali naslednjo JSON strukturo:
{
  "signature": "541661622185851c248b41bf0cea7ad0",
  "accountId": "10007865234"
}
Ker se bo vrednost podpisa spreminjala glede na obdelavo, privzeta strategija hashiranja vmesnika Partitioner ne bo zanesljivo združevala povezanih sporočil. Zato bomo morali napisati svojo strategijo, ki bo analizirala ta ključ in razdelila (partition) vrednost accountId.
Kafka vključuje kontrolne vsote za odkrivanje poškodb sporočil v shranjevanju in ima popoln nabor funkcij varnosti. Kljub temu se včasih pojavijo specifične zahteve za industrijo, kot je zgoraj navedeno.
Uporabniška strategija particioniranja mora zagotavljati, da se vsa povezana sporočila znajdejo v eni particiji. Čeprav se to zdi enostavno, se lahko zahteva zaplete zaradi pomembnosti ohranjanja zaporedja povezanih sporočil in količine particij v temi, ki mora biti fiksna.
Število particij v temi se lahko sčasoma spreminja, saj jih je mogoče dodati, če promet preseže prvotna pričakovanja. Tako so lahko ključi sporočil povezani s particijo, v katero so bila prvotno poslana, kar implicira del stanja, ki ga je treba razporediti med primerki proizvajalca.
Drug dejavnik, ki ga je treba upoštevati, je enakomernost porazdelitve sporočil med particijami. Na splošno se ključi ne porazdelijo enakomerno med sporočili, in hash funkcije ne zagotavljajo pravične porazdelitve sporočil za majhen nabor ključev.
Pomembno je omeniti, da, ne glede na to, kako se odločite razdeliti sporočila, bo morda treba razdelilnik ponovno uporabiti.
Razmotrimo zahtevanje replikacije podataka između Kafka klastera na različitim geografskim lokacijama. U te svrhe, Kafka dolazi sa alatkom komandne linije pod nazivom MirrorMaker, koja se koristi za čitanje poruka iz jednog klastera i njihov prenos u drugi.
MirrorMaker mora razumeti ključeve replikovanog topika kako bi održavao relativnu pravila između poruka prilikom replikacije između klastera, pošto broj particija za ovaj topik može da se ne poklapa u dva klastera.
Korisničke strategije particionisanja se relativno retko sreću, jer defaultne heširanje ili ciklički iterirajući pristup uspešno funkcionišu u većini scenarija. Međutim, ako su vam potrebna stroga obezbeđenja redosleda ili trebate izvući metapodatke iz opterećenja, particionisanje je nešto čemu biste trebali posvetiti više pažnje.
Prednosti skalabilnosti i performansi Kafke su rezultat premestanja nekih obaveza tradicionalnog brokera na klijenta. U ovom slučaju, donosi se odluka o raspodeli potencijalno povezanih poruka među više potrošača koji rade paralelno.
JMS brokeri se takođe moraju nositi sa sličnim zahtevanjima. Zanimljivo je da mehanizam slanja povezanih poruka istom potrošaču, implementiran kroz JMS Message Groups (vrsta strategije balansiranja opcija sticky load balancing (SLB)), takođe zahteva da pošiljalac označi poruke kao povezane. U slučaju JMS, broker je odgovoran za slanje ove grupe povezanih poruka jednom potrošaču od mnogih i prenos prava vlasništva nad grupom ukoliko potrošač otpadne.
Dogovori o producentu
Particionisanje nije jedino što treba razmotriti prilikom slanja poruka. Pogledajmo metode send() klase Producer u Java API:
Future  send(ProducerRecord  record);
Future  send(ProducerRecord  record, Callback callback);
Takoj je pomembno omeniti, da oba metoda vračata Future, kar pomeni, da operacija pošiljanja ni izvedena takoj. Rezultat je, da se sporočilo (ProducerRecord) zapiše v pošiljateljski pomnilnik za vsako aktivno particijo in se prenese brokerju v ozadju v knjižnici odjemalca Kafka. Čeprav to delo neverjetno pospeši, to pomeni, da slabo zasnovana aplikacija lahko izgubi sporočila, če se njen proces ustavi.
Kot vedno je način, da pošiljanje naredimo bolj zanesljivo, na račun zmogljivosti. Velikost te pomnilniške konstrukcije lahko nastavite na 0, kar bo prisililo tok pošiljajoče aplikacije, da čaka, dokler prenosa sporočila brokerju ne bo končana, in sicer takole:
RecordMetadata metadata = producer.send(record).get();Še enkrat o branju sporočil
Branje sporočil ima dodatne zapletenosti, o katerih je treba razmisliti. V nasprotju z API JMS, ki lahko zažene poslušalca sporočil (message listener) kot odgovor na prejem sporočila, vmesnik Consumer Kafka le vpraša (polling). Poglejmo podrobneje metodo poll (), uporabljeno za ta namen:
ConsumerRecords poll(long timeout);Vrnjena vrednost metode je struktura, ki vsebuje več objektov ConsumerRecord iz potencialno več particij. ConsumerRecord sama je objekt, ki hrani par ključ-vrednost skupaj z ustreznimi metapodatki, kot je particija, iz katere je pridobljena.
Kot je bilo razloženo v poglavju 2, se moramo nenehno spominjati, kaj se zgodi s sporočili po uspešni ali neuspešni obdelavi, na primer, če stranka ne more obdelati sporočila ali če pride do prekinitve delovanja. V JMS je bilo to obravnavano preko načina potrjevanja (acknowledgement mode). Broker bodisi izbriše uspešno obdelano sporočilo bodisi ponovno dostavi neobdelano ali neuspelo (ob predpostavki, da so bile uporabljene transakcije).
Kafka deluje povsem drugače. Sporočila se ne izbrišejo na brokerju po branju in odgovornost za to, kar se zgodi ob napaki, leži na samem bralnem kodu.
Kot smo že omenili, je skupina potrošnikov povezana z odklonom v dnevniku. Položaj v dnevniku, povezan s tem odklonom, ustreza naslednjemu sporočilu, ki bo izdan kot odgovor na poll (). Ključno pri branju je trenutek, ko se ta odmik povečuje.
Vrnjeni k modelu branja, obravnavanemu prej, obdelava sporočila sestavlja tri korake:
- Izvleči sporočilo za branje.
- Obdelati sporočilo.
- Potrditev sporočila.
Kafka potrošnik prihaja z možnostjo konfiguracije enable.auto.commit. To je pogosto uporabljena privzeta nastavitev, kot je običajno pri nastavitvah, ki vsebujejo besedo 'avto'.
Pred Kafka 0.10 je stranka, ki je uporabljala to možnost, poslala odmik zadnjega prebranega sporočila pri naslednjem klicu poll () po obdelavi. To je pomenilo, da so lahko bila vsa sporočila, ki so bila že izvlečena, ponovno obdelana, če jih je stranka že obdelala, vendar je bila nepričakovano uničena pred klicem poll (). Ker posrednik ne shranjuje nobenega stanja glede tega, koliko časa je bilo sporočilo prebrano, naslednji potrošnik, ki izvleče to sporočilo, ne bo vedel, da je prišlo do napake. To vedenje je bilo pseudo-transakcijsko. Odklepanje je bilo samo v primeru uspešne obdelave sporočila, vendar, če je stranka prekinila delo, je posrednik ponovno poslal isto sporočilo drugemu potrošniku. Takšno vedenje je ustrezalo garanciji dostave sporočil ''vsaj enkrat'«.
V Kafka 0.10 je bil koda stranke spremenjena tako, da se je komit periodično izvajal s strani knjižnice stranke, v skladu z nastavitvijo auto.commit.interval.ms. To vedenje se nahaja nekje med načini JMS AUTO_ACKNOWLEDGE in DUPS_OK_ACKNOWLEDGE. Pri uporabi avtokomita so lahko bila sporočila potrjena ne glede na to, ali so bila dejansko obdelana — to se je lahko zgodilo v primeru počasnega potrošnika. Če je potrošnik prekinil delo, so sporočila bila izvlečena naslednjim potrošnikom, začenši s potrjeno pozicijo, kar je lahko povzročilo, da je sporočilo manjkalo. V tem primeru Kafka ni izgubila sporočil, kod, ki bere, jih preprosto ni obdelal.
Ta način ima enake perspektive kot v različici 0.9: sporočila so lahko obdelana, vendar v primeru okvare, odmik morda ni bil potrjen, kar potencialno lahko vodi do podvajanja dostave. Več sporočil kot izvlečete pri izvajanju poll (), večja bo ta težava.
Kot je obravnavano v razdelku „Bralni sporočil iz čakalne vrste“ na strani 21, v sistemu za izmenjavo sporočil ne obstaja koncept enkratne dostave sporočila, če upoštevamo pogoje napak.
V Kafki obstajata dva načina za zabeležitev (potrditev) offseta: samodejno in ročno. V obeh primerih je možno, da se sporočila obdelajo večkrat, če je bilo sporočilo obdelano, vendar je prišlo do napake pred potrditvijo. Prav tako lahko sporočila sploh ne obdelate, če je bila potrditev opravljena v ozadju, predno se vaša koda začne obdelovati (morda v Kafki 0.9 in starejših različicah).
Rokovanje s postopkom potrjevanja offseta je lahko ročno v API-ju porabnika Kafke z nastavitvijo parametra enable.auto.commit na false in z izrecnim klicem ene od naslednjih metod:
void commitSync();
void commitAsync();
Če želite obdelati sporočilo „vsaj enkrat“, morate ročno potrditi offset z uporabo commitSync(), tako da to naslednjo ukaz izvedete takoj po obdelavi sporočil.
Te metode ne omogočajo potrjevanja (acknowledged) sporočil, preden so obdelana, vendar ne rešujejo mogoče podvajanja obdelave, hkrati pa ustvarjajo videz transakcijskosti. V Kafki ni transakcij. Stranka nima možnosti narediti naslednjega:
- Samodejno preklicati (roll back) neuspelo sporočilo. Porabniki morajo sami obravnavati izjeme, ki nastanejo zaradi problematičnih payloadov in izklopov backend-a, saj ne morejo zaupati ponovni dostavi sporočil s strani posrednika.
- Pošiljati sporočila v več tematskih sklopih v okviru ene atomske operacije. Kot bomo kmalu videli, lahko nadzor nad različnimi tematskimi sklopi in particijami ostane na različnih napravah v Kafkinem klasterju, ki ne usklajujejo transakcij pri pošiljanju. Ob času pisanja tega članka je bilo narejenega nekaj dela, da bi to omogočili s KIP-98.
- Povezati branje enega sporočila iz enega tematskega sklopa s pošiljanjem drugega sporočila v drug tematski sklop. Spet, arhitektura Kafke temelji na številnih neodvisnih napravah, ki delujejo kot en sistem in ne poskušajo skriti te povezanosti. Na primer, ne obstajajo API komponente, ki bi omogočale povezovanje Porabnika in Producenta v transakciji. V JMS to zagotavlja objekt Session, iz katerega se ustvarjajo MessageProducers in MessageConsumers.
Če se ne moremo zanašati na transakcije, kako lahko zagotovimo semantiko, ki je bližje tisti, ki jo zagotavljajo tradicionalni sistemi za izmenjavo sporočil?
Če obstaja verjetnost, da se lahko offset potrošnika poveča pred obdelavo sporočila, na primer v primeru okvare potrošnika, potem potrošnik nima načina, da bi vedel, ali je njegova skupina potrošnikov pri dodeljevanju particije preskočila sporočila. Tako je ena od strategij, da se offset pomakne (rewind) na prejšnjo pozicijo. Kafka API potrošnika ponuja naslednje metode za to:
void seek(TopicPartition partition, long offset);
void seekToBeginning(Collection  partitions);
Metod seek () lahko se uporablja z metodo
offsetsForTimes (Map timestampsToSearch) za pomik v stanje v nekem določenem trenutku v preteklosti.
Neposredno, uporaba tega pristopa pomeni, da je zelo verjetno, da bodo nekatera sporočila, ki so bila prej obdelana, ponovno prebrana in obdelana. Da bi se temu izognili, lahko uporabimo idempotentno branje, kot je opisano v Poglavju 4, za sledenje prej pregledanim sporočilom in izključitev podvojitev.
Alternativno lahko koda vašega potrošnika ostane preprosta, če je izguba ali podvajanje sporočil sprejemljivo. Ko razmišljamo o scenarijih, v katerih se običajno uporablja Kafka, na primer, obdelava dogodkov dnevnikov, metrik, sledenje klikom itd., razumemo, da bo izguba posameznih sporočil verjetno imela malo pomembnega vpliva na sosednje aplikacije. V takih primerih so privzete vrednosti povsem sprejemljive. Po drugi strani, če vaše aplikacije potrebujejo prenos plačil, morate skrbno obravnavati vsako posamezno sporočilo. Vse se vrti okoli konteksta.
Osebne opazke kažejo, da z naraščanjem intenzivnosti sporočil vrednost vsakega posameznega sporočila upada. Sporočila velikega obsega postanejo običajno dragocena, če jih obravnavamo v agregirani obliki.
Visoka razpoložljivost (High Availability)
Kafka pristop za visoko razpoložljivost se znatno razlikuje od pristopa ActiveMQ. Kafka je zasnovana na horizontalno skalabilnih grozdi, kjer vsi primerki posrednika hkrati sprejemajo in pošiljajo sporočila.
Grozdi Kafka sestavljajo številni primerki posrednika, ki delujejo na različnih strežnikih. Kafka je bila zasnovana za delovanje na običajni samostojni strojni opremi, kjer ima vsaka vozlišče svoj lastni dodeljeni prostor za shranjevanje. Uporaba omrežnih shranjevanj (SAN) ni priporočljiva, saj lahko številni računalniški vozli konkurirajo za obdobja shranjevanja in ustvarjajo konflikte.ЫKafka je
nenehno aktivirana sistem. Mnogi veliki uporabniki Kafke nikoli ne izklopijo svojih grozdov in programska oprema vedno zagotavlja posodobitev z zaporednim ponovnim zagonom. To se doseže z zagotavljanjem združljivosti s prejšnjimi različicami sporočil in interakcijami med posredniki. Posredniki so povezani z grozdom strežnikov
ZooKeeper kvora. V osnovnem primeru se tema ustvari v grozdu Kafka z naslednjimi lastnostmi:.
Število particij. Kot je bilo prej omenjeno, natančna vrednost, ki se tu uporablja, določa želeni nivo paralelnega branja.
- Delež (faktor) replikacije določa, koliko primerkov posrednika v grozdu mora vsebovati dnevnike za to particijo.
- Z uporabo ZooKeeperja za usklajevanje, Kafka poskuša pošteno razdeliti nove particije med posrednike v grozdu. To stori en primerek, ki opravlja vlogo kontrolerja.
Med izvajanjem
vsaki particiji teme dodeli posredniku vloge Krmilnik vodje (leader, master, vodilni) in sledilcev. последователей (followers, slaves, podređeni). Broker koji djeluje kao vođa za ovu particiju odgovara za primanje svih poruka koje mu šalju producenti i za distribuciju poruka potrošačima. Kada se šalju poruke u particiju teme, one se repliciraju na sve nodove brokera koji su trenutni za ovu particiju. Svaki nod koji sadrži logove za particiju naziva se replikom. Broker može biti vođa za neke particije, dok za druge može biti sledbenik.
Sledbenik koji sadrži sve poruke koju čuva vođa naziva se sinhronizovana replika (replika koja je u sinhronizovanom stanju, in-sync replica). Ako se broker koji je vođa za particiju isključi, bilo koji broker koji je ažuriran ili sinhronizovan za ovu particiju može preuzeti ulogu vođe. Ovo je izuzetno otporan dizajn.
Deo konfiguracije producenta je parametar acks, koji definiše koliko replik mora potvrditi (acknowledge) prijem poruke pre nego što aplikacioni tok nastavi sa slanjem: 0, 1 ili sve. Ako je postavljena vrednost all, tada će prilikom primanja poruke vođa poslati potvrdu (confirmation) nazad producentu čim primi potvrde (acknowledgements) zapisa od više replik (uključujući i sebe), kako je određeno podešavanjem teme min.insync.replicas (podrazumevano 1). Ako poruku nije moguće uspešno replicirati, producent će pokrenuti izuzetak za aplikaciju (NotEnoughReplicas ili NotEnoughReplicasAfterAppend).
U tipičnoj konfiguraciji kreira se tema sa faktorom replike 3 (1 vođa, 2 sledbenika za svaku particiju) i parametar min.insync.replicas se postavlja na vrednost 2. U tom slučaju, klaster će dozvoliti da jedan od brokera koji upravljaju particijom teme može biti isključen bez uticaja na klijentske aplikacije.
Ovo nas vraća na već poznati kompromis između performansi i pouzdanosti. Replikacija se dešava zbog dodatnog vremena čekanja potvrda (acknowledgments) od sledbenika. Iako se vrši paralelno, replikacija, barem na tri nodova, ima istu performansu kao i na dva (zanemarujući povećanu potrošnju mrežnog propusta).
Z uporabo te replicirne sheme Kafka spretno preprečuje potrebo po fizičnem zapisovanju vsakega sporočila na disk prek operacije sync (). Vsako sporočilo, poslano od proizvajalca, bo zabeleženo v dnevniku particije, vendar, kot je razpravljano v Poglavju 2, se zapis v datoteko sprva izvede v predpomnilnik operacijskega sistema. Če je to sporočilo replicirano na drugo instanco Kafke in je v njenem pomnilniku, izguba vodje ne pomeni, da je samo sporočilo izgubljeno — to lahko prevzame sinhronizirana replika.
Opustitev potrebe po izvajanju operacije sync () pomeni, da lahko Kafka sprejema sporočila s hitrostjo, s katero jih lahko zapisuje v pomnilnik. In obratno, čim dlje se lahko izognemo sproščanju (flushing) pomnilnika na disk, tem bolje. Iz tega razloga ni redkost, da brokerjem Kafke dodelijo 64 GB pomnilnika ali več. Takšna uporaba pomnilnika pomeni, da lahko ena instanca Kafke zlahka deluje s hitrostmi, ki so tisočkrat hitrejše od tradicionalnega posrednika sporočil.
Kafko je mogoče tudi konfigurirati za uporabo operacije sync () na paketih sporočil. Ker je vse v Kafki zasnovano za delo s paketi, to dejansko dobro deluje za mnoge scenarije uporabe in je uporabno orodje za uporabnike, ki zahtevajo zelo močne garancije. Večino čiste zmogljivosti Kafke je povezane s sporočili, ki se pošiljajo brokerju v obliki paketov, in s tem, da se ta sporočila berejo iz brokerja po zaporednih blokih z uporabo operacij (operacij, pri katerih ni zakasnitev pri kopiranju podatkov iz enega področja pomnilnika v drugega). Zadnja točka prinaša velik dobiček z vidika zmogljivosti in virov in je mogoča le s pomočjo osnovne strukture podatkov dnevnika, ki določa shemo particije.
V klastru Kafke je mogoča precej višja zmogljivost, kot pri uporabi enega brokera Kafke, saj se particije teme lahko horizontalno skalirajo na številnih ločenih strojih.
Zaključki
V tem poglavju smo preučili, kako arhitektura Kafka preoblikuje odnose med odjemalci in posredniki, da zagotovi izjemno odporen sistem za izmenjavo sporočil z zmogljivostjo, ki večkrat presega običajnega posrednika sporočil. Razpravljali smo o funkcionalnosti, ki jo uporablja za dosego tega cilja, in na kratko preučili arhitekturo aplikacij, ki zagotavljajo to funkcionalnost. V naslednjem poglavju bomo preučili splošne izzive, ki jih morajo reševati aplikacije na osnovi izmenjave sporočil, ter razpravljali o strategijah za reševanje teh izzivov. Poglavje bomo zaključili s slikovitim prikazom, kako razmišljati o tehnologijah izmenjave sporočil na splošno, da boste lahko ocenili njihovo primernost za vaše scenarije uporabe.
Prejšnji prevedeni del:
Prevod izvršen:
Nastaviće se…
Samo registrovani korisnici mogu učestvovati u anketi. , molim vas.
Ali vaša organizacija uporablja Kafka?
Da
Ne
Prej smo jo uporabljali, zdaj ne več
Načrtujemo uporabo
38 uporabnikov je glasovalo. 8 uporabnikov se je vzdržalo.
Izvor: habr.com
