

Učinek razmaševanja tabel in indeksov (bloat) je široko znan in se pojavlja ne le v Postgresu. Obstajajo načini za boj proti temu "iz škatle", kot sta VACUUM FULL ali CLUSTER, vendar ti blokirajo tabele med delovanjem in zato niso vedno uporabni.
V članku bo nekoliko teorije o tem, kako nastane bloat, kako se z njim lahko borimo, o deferred constraints ter o težavah, ki jih prinašajo pri uporabi razširitve pg_repack.
Ta članek je napisan na podlagi na PgConf.Russia 2020.
Zakaj nastane bloat
Osnova Postgresa je večverzijska zasnova (). Njena bistvo je, da lahko vsaka vrstica v tabeli ima več verzij, pri čemer transakcije vidijo največ eno od teh verzij, vendar ne nujno isto. To omogoča več transakcijam, da delujejo hkrati in skorajda ne vplivajo ena na drugo.
Očitno je, da je treba vse te verzije shraniti. Postgres deluje s pomnilnikom po straneh in stran je najmanjši obseg podatkov, ki ga lahko preberemo s diska ali zapišemo. Oglejmo si majhen primer, da razumemo, kako to poteka.
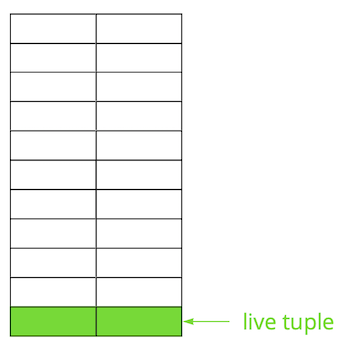
Recimo, da imamo tabelo, v katero smo dodali nekaj zapisov. Na prvi strani datoteke, kjer je shranjena tabela, so se pojavili novi podatki. To so žive verzije vrstic, ki so dostopne drugim transakcijam po potrditvi (za poenostavitev predpostavimo, da je raven izolacije Read Committed).
Nato smo posodobili enega od zapisov in tako označili staro verzijo kot zastarelo.
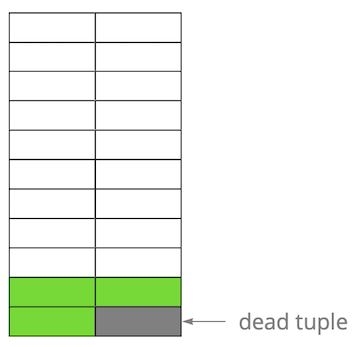
Korak za korakom, ko posodabljamo in brišemo verzije vrstic, smo dobili stran, v kateri je približno polovica podatkov "odpadniških". Ti podatki niso vidni nobeni transakciji.
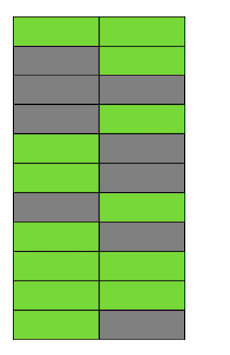
V Postgresu obstaja mehanizem , ki čisti zastarele verzije in sprosti prostor za nove podatke. A če ni nastavljena dovolj agresivno ali je zaposlena pri delu z drugimi tabelami, ostanejo "odpadniški podatki", in moramo uporabiti dodatne strani za nove podatke.
Tako bo v našem primeru ob nekem trenutku tabela sestavljena iz štirih strani, vendar bo v njej le polovica živih podatkov. Posledica tega je, da bomo pri dostopu do tabele prebrali veliko več podatkov, kot je potrebno.
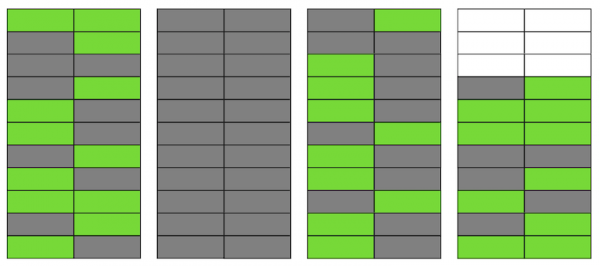
Tudi če VACUUM trenutno odstrani vse zastarele različice vrstic, se situacija ne bo drastično izboljšala. Imeli bomo prostore na straneh ali celo cele strani za nove vrstice, vendar bomo še vedno prebirali več podatkov, kot je potrebno.
Mimogrede, če bi bila popolnoma prazna stran (druga v našem primeru) na koncu datoteke, bi VACUUM lahko to stran odrezal. Toda trenutno je sredi, zato z njo ne moremo nič narediti.
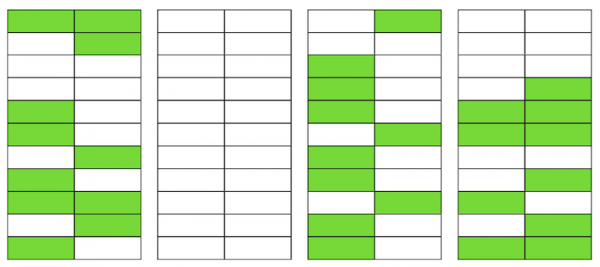
Ko se število takšnih praznih ali močno razredčenih strani poveča, kar imenujemo bloat, začne to vplivati na zmogljivost.
Vse zgoraj opisano je mehanika nastajanja bloat v tabelah. V indeksih se to dogaja približno na enak način.
Ali imam bloat?
Obstaja več načinov, da določite, ali imate bloat. Osnovna ideja prvega je uporaba notranje statistike Postgresa, ki vsebuje okvirne informacije o številu vrstic v tabelah, številu 'živih' vrstic itd. Na spletu lahko najdete številne različice že pripravljenih skriptov. Za osnovo smo vzeli od PostgreSQL Experts, ki lahko oceni bloat tabel skupaj s toastom in bloat btree indeksov. Po naših izkušnjah ima njegova napaka 10-20%.
Drugi način je uporaba razširitve , ki omogoča vpogled v strani in pridobitev tako ocenjevanja kot natančne vrednosti bloat. Vendar pa bo v drugem primeru potrebno preskaniti celo tabelo.
Majhna vrednost bloat, do 20%, velja za sprejemljivo. To lahko šteje kot analog fillfactora za in . Pri 50% in več se lahko začnejo težave z zmogljivostjo.
Metode za boj proti bloat
V Postgresu je več načinov za boj proti bloat 'iz škatle', vendar ti niso vedno primerni za vse.
Nastavite AUTOVACUUM, da bloat ne nastane. In other words, to keep it at a level that is acceptable for you. It may sound like a “captain's” advice, but in reality, it is not always easy to achieve. For instance, if you are actively developing with regular changes to the data schema or undergoing some data migration. As a result, your load profile can often change and, as a rule, is different for different tables. This means you need to constantly work a bit ahead and adjust AUTOVACUUM to the changing profile of each table. But obviously, this is not an easy task.
Another common reason why AUTOVACUUM fails to process tables is the presence of long transactions that prevent it from cleaning up data because it is still accessible to those transactions. The recommendation here is also obvious – get rid of 'hanging' transactions and minimize the duration of active transactions. However, if the load on your application is a hybrid of OLAP and OLTP, you may have numerous frequent updates and short queries, as well as lengthy operations – for example, generating a report. In this situation, it’s worth considering distributing the load across different databases, which will allow for finer tuning of each one.
Another example – even if the profile is homogeneous, if the database is under very high load, even the most aggressive AUTOVACUUM may struggle, and bloat will occur. Scaling (vertically or horizontally) is the only solution.
What to do if you have configured AUTOVACUUM, but bloat continues to increase.
Komanda VACUUM FULL rebuilds the contents of tables and indexes and keeps only current data in them. It works perfectly for eliminating bloat, but during its execution, an exclusive lock (AccessExclusiveLock) is taken on the table, which prevents any queries to that table, including selects. If you can afford to stop your service or part of it for a while (from several minutes to several hours, depending on the size of the database and your hardware), then this option is the best. Unfortunately, we cannot complete VACUUM FULL in the scheduled maintenance time, so this method does not suit us.
Komanda CLUSTER prav tako preureja vsebino tabel, kot VACUUM FULL, omogoča pa tudi določitev indeksa, po katerem bodo podatki fizično razporejeni na disku (vendar v prihodnje za nove vrstice vrstni red ni zagotovljen). V določenih situacijah je to lahko dobra optimizacija za nekatere poizvedbe – pri branju več zapisov po indeksu. Pomanjkljivost te ukaze je enaka kot pri VACUUM FULL – med delovanjem zaklene tabelo.
Komanda REINDEX je podobna dvema prejšnjima, vendar preuredi določen indeks ali vse indekse tabele. Zaklepi so nekoliko šibkejši: ShareLock na tabeli (ovira spremembe, a omogoča izvajanje select) in AccessExclusiveLock na preurejenem indeksu (zaklene poizvedbe, ki uporabljajo ta indeks). V različici 12 Postgres pa se je pojavil parameter , ki omogoča preurejanje indeksa, ne da bi se blokiralo sočasno dodajanje, spreminjanje ali brisanje zapisov.
V prejšnjih različicah Postgres lahko dosežete rezultat, podoben REINDEX CONCURRENTLY, z uporabo . Ta ukaz omogoča ustvarjanje indeksa brez stroge blokade (ShareUpdateExclusiveLock, ki ne ovira sočasnih poizvedb), nato zamenja star indeks z novim in izbriše star indeks. To omogoča odpravo bloat indeksov, ne da bi oviralo delovanje vaše aplikacije. Pomembno je upoštevati, da bo pri preurejanju indeksov dodatno obremenitev na diskovnem sistemu.
Tako, če obstajajo načini za odpravo bloat indeksov "na vroče", pa za tabele teh ni. Tukaj vstopijo različne zunanje razširitve: (prej pg_reorg), , in druge. V okviru tega članka jih ne bom primerjal in bom govoril le o pg_repack, ki ga po nekaj prilagoditvah uporabljamo pri nas.
Kako deluje pg_repack
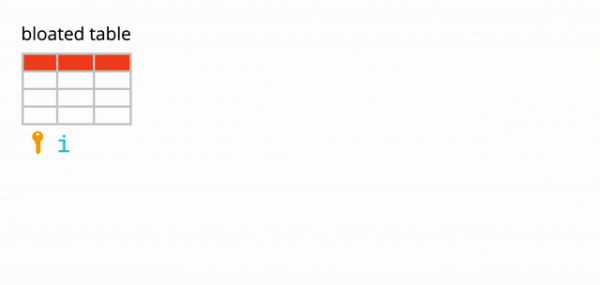
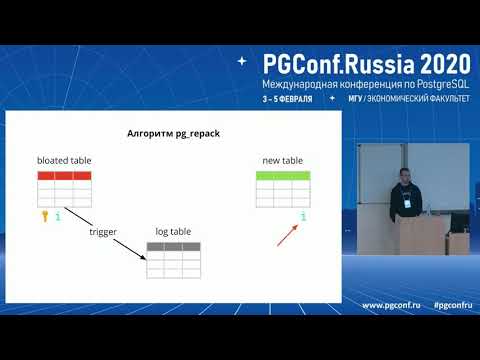
Recimo, da imamo povsem običajno tabelo – z indeksi, omejitvami in, žal, z bloatom. Prvi korak pg_repack ustvari log-tabelo, da shrani podatke o vseh spremembah med delovanjem. Sprožilec bo repliciral te spremembe pri vsakem vstavitvi, posodobitvi in brisanju. Nato se ustvari tabela, ki je po strukturi podobna izvorni, brez indeksov in omejitev, da se ne upočasni postopek vstavljanja podatkov.
Nato pg_repack prenese podatke iz stare tabele v novo, pri čemer samodejno filtrira vse zastarele vrstice, nato pa ustvari indekse za novo tabelo. Med izvajanjem vseh teh operacij se v log tabeli nalagajo spremembe.
Naslednji korak je prenos sprememb v novo tabelo. Prenos poteka v več iteracijah, in ko v log tabeli ostane manj kot 20 zapisov, pg_repack prevzame strog zaklep, prenese zadnje podatke in zamenja staro tabelo z novo v sistemskih tabelah Postgresa. To je edini in zelo kratek trenutek, ko ne boste mogli delati s tabelo. Po tem se stara tabela in tabela z logi izbrišeta ter se v datotečnem sistemu sprosti prostor. Proces je zaključen.
V teoriji vse izgleda odlično, kako pa v praksi? Testirali smo pg_repack brez obremenitve in pod obremenitvijo, preverili njegovo delovanje v primeru prezgodnje ustavitve (enostavno povedano, s Ctrl+C). Vsi testi so bili pozitivni.
Odpravili smo se na produkcijo — in tukaj je šlo vse narobe, kot smo pričakovali.
Prvi poskus na produkciji
Na prvem zbornem klastru smo dobili napako o kršitvi unikatne omejitve:
$ ./pg_repack -t tablename -o id
INFO: repacking table "tablename"
ERROR: query failed:
    ERROR: duplicate key value violates unique constraint "index_16508"
DETAIL:  Key (id, index)=(100500, 42) already exists.
Ta omejitev je imela samodejno generirano ime index_16508 – ustvaril ga je pg_repack. Po atributih, ki so vključeni vanjo, smo ugotovili "našo" omejitev, ki ji ustreza. Težava je bila v tem, da to ni povsem običajna omejitev, ampak odložena (), tj. njeno preverjanje se izvede kasneje kot sql ukaz, kar vodi do nepričakovanih posledic.
Odložene omejitve: zakaj so potrebne in kako delujejo
Malo teorije o odloženih omejitvah.
Poglejmo preprost primer: imamo referenčno tabelo avtomobilov z dvema atributoma – imenom in vrstnim redom avtomobila v referenčni tabeli.
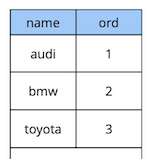
create table cars
(
  name text constraint pk_cars primary key,
  ord integer not null constraint uk_cars unique
);
Predpostavimo, da smo potrebovali zamenjati prvi in drugi avtomobil. Rešitev "na trdo" – posodobiti prvo vrednost na drugo in drugo na prvo:
begin;
  update cars set ord = 2 where name = 'audi';
  update cars set ord = 1 where name = 'bmw';
commit;
Toda pri izvajanju te kode pričakujemo, da bomo dobili kršitev omejitve, ker je vrstni red vrednosti v tabeli unikaten:
[23305] ERROR: dvojen ključ vrijedi naručiti jedinstveno ograničenje “uk_cars”
Detalji: Ključ (ord)=(2) već postoji.
Kako to učiniti na drugi način? Prva opcija: dodati dodatnu zamjenu vrijednosti za redoslijed koji sigurno ne postoji u tablici, na primjer “-1”. U programiranju se ovo naziva “izmjenom vrijednosti dviju varijabli putem treće”. Jedini nedostatak ove metode je dodatni update.
Druga opcija: redizajnirati tablicu kako bi se koristio tip podataka s pomičnom točkom za vrijednost redoslijeda umjesto cijelih brojeva. Tada bi prva stavka automatski „stajala“ između druge i treće kada se vrijednost ažurira s 1, na primjer, na 2.5. Ovo je funkcionalno rješenje, ali postoje dva ograničenja. Prvo, neće vam odgovarati ako se vrijednost koristi negdje u sučelju. Drugo, ovisno o točnosti tipa podataka, imat ćete ograničen broj mogućih umetanja prije nego što se izvrši ponovni izračun vrijednosti svih stavki.
Treća opcija: učiniti ograničenje odgođenim, tako da se provjerava samo u trenutku potvrde:
create table cars
(
  name text constraint pk_cars primary key,
  ord integer not null constraint uk_cars unique deferrable initially deferred
);
Budući da logika našeg prvobitnog upita osigurava da su svi vrijednosti jedinstvene u trenutku potvrde, on će se uspješno izvršiti.
Razmatrani primjer je naravno vrlo sintetičan, ali otkriva ideju. U našoj aplikaciji koristimo odgođena ograničenja za implementaciju logike koja upravlja rješavanjem konflikata kada korisnici istovremeno rade s zajedničkim objektima – widgetima na ploči. Korištenje takvih ograničenja omogućava nam da aplikacijski kod učinimo malo jednostavnijim.
Općenito, ovisno o tipu ograničenja u Postgresu, postoje tri razine granularnosti njihove provjere: razina reda, transakcije i izraza.
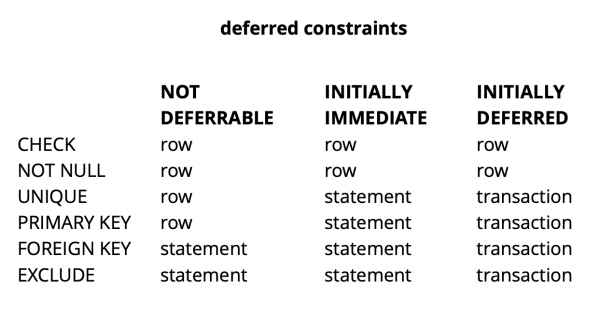
Izvor:
CHECK i NOT NULL uvijek se provjeravaju na razini reda, za ostala ograničenja, kao što se vidi u tablici, postoje različite opcije. Više informacija možete pročitati. .
Na kratko povedano, odložene omejitve v nekaterih situacijah pomenijo bolj razumljivo kodo in manj ukazov. Vendar pa se za to plača z zapletenostjo procesa odpravljanja napak, saj sta trenutek nastanka napake in trenutek, ko o njej izveste, časovno ločena. Še ena možna težava je povezana s tem, da načrtovalnik ne more vedno zgraditi optimalnega načrta, če na zahtevo vpliva odložena omejitev.
Izpopolnitev pg_repack
Ugotovili smo, kaj so odložene omejitve, a kako so povezane z našim problemom? Spomnimo se napake, ki smo jo prej dobili:
$ ./pg_repack -t tablename -o id
INFO: repacking table "tablename"
ERROR: query failed:
    ERROR: duplicate key value violates unique constraint "index_16508"
DETAIL:  Key (id, index)=(100500, 42) already exists.
Pojavi se pri kopiranju podatkov iz dnevniške tabele v novo tabelo. Zdi se čudno, saj se podatki v dnevniški tabeli potrjujejo skupaj s podatki iz izvorne tabele. Če zadostujejo omejitvam izvorne tabele, kako lahko kršijo iste omejitve v novi?
Izkazalo se je, da je koren problema v prejšnjem koraku delovanja pg_repack, kjer se ustvarjajo samo indeksi, ne pa omejitve: v stari tabeli je bila edinstvena omejitev, v novi pa se je namesto nje ustvaril edinstven indeks.
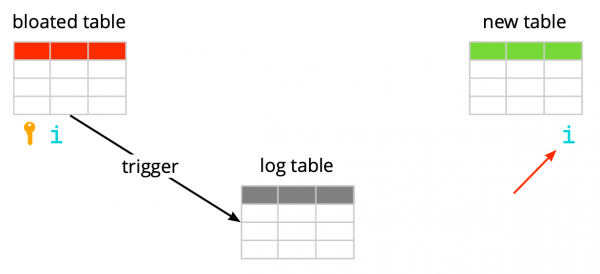
Tu je pomembno omeniti, da če je omejitev navadna, ne pa odložena, potem je edinstven indeks, ustvarjen namesto nje, enakovreden tej omejitvi, saj se edinstvene omejitve v Postgres uresničujejo z ustvarjanjem edinstvenega indeksa. V primeru odložene omejitve pa obnašanje ni enako, saj indeks ne more biti odložen in se vedno preverja ob izvajanju sql ukaza.
Tako je bistvo problema v 'odloženosti' preverjanja: v izvorni tabeli se zgodi ob potrjevanju, v novi pa ob izvajanju sql ukaza. Torej moramo poskrbeti, da se preverjanja izvajajo enako v obeh primerih: bodisi vedno odloženo, bodisi vedno takoj.
Torej, katere ideje smo imeli.
Ustvariti indeks, podoben deferred
Prva ideja je izvajanje obeh preverjanj v takojšnje. To lahko povzroči nekaj napačnih pozitivnih rezultatov omejitev, vendar če jih bo malo, to ne bi smelo vplivati na delo uporabnikov, saj so za njih taki konflikti normalna situacija. Do njih običajno pride, ko dva uporabnika hkrati začnejo urejati isti vtičnik, in odjemalec drugega uporabnika ne uspe pridobiti informacije, da je vtičnik že zaklenjen za urejanje s strani prvega uporabnika. V takšnem primeru strežnik drugemu uporabniku odgovori z zavrnitvijo, njegov odjemalec pa vrne spremembe in zaklene vtičnik. Kmalu zatem, ko prvi uporabnik zaključi z urejanjem, drugi prejme informacijo, da vtičnik ni več zaklenjen in lahko ponovno izvede svojo nalogo.
Da bi bila preverjanja vedno v nujnem načinu, smo ustvarili nov indeks, podoben izvirnemu odloženemu omejitev:
CREATE UNIQUE INDEX CONCURRENTLY uk_tablename__immediate ON tablename (id, index);
-- run pg_repack
DROP INDEX CONCURRENTLY uk_tablename__immediate;
Na testnem okolju smo dobili le nekaj pričakovanih napak. Uspeh! Spet smo zagnali pg_repack na produkciji in dobili 5 napak v prvem klastru v eni uri delovanja. To je sprejemljiv rezultat. Vendar pa se je v drugem klastru število napak znatno povečalo in morali smo ustaviti pg_repack.
Zakaj se je to zgodilo? Verjetnost pojava napake je odvisna od tega, koliko uporabnikov hkrati dela z istimi vtičniki. Sodeč po vsem, je v tistem trenutku s podatki, shranjenimi v prvem klastru, bilo veliko manj konkurenčnih sprememb kot pri drugih, torej smo imeli preprosto »srečo«.
Ideja ni delovala. V tistem trenutku smo videli dve drugi možnosti rešitve: predelati našo aplikacijsko kodo, da se odpovemo odloženim omejitvam, ali »naučiti« pg_repack, da dela z njimi. Izbrali smo drugo.
Zamenjati indekse v novi tabeli z odloženimi omejitvami iz izvirne tabele.
Namen izboljšave je bil očiten – če ima izvirna tabela odloženo omejitev, je treba za novo ustvariti takšno omejitev in ne indeks.
Da bi preverili naše spremembe, smo napisali preprost test:
- tabela z odloženo omejitvijo in enim zapisom;
- vstavljamo v ciklu podatke, ki so v nasprotju z obstoječim zapisom;
- проводим обновление – данные больше не конфликтуют;
- фиксаем изменения.
создать таблицу test_table
(
  id serial,
  val int,
  ограничение uk_test_table__val уникально (val) откладываемо, изначально отложенное
);
ВСТАВИТЬ В test_table (val) ЗНАЧЕНИЯ (0);
ДЛЯ i В 1..10000 ЦИКЛ
  НАЧАЛО
    ВСТАВИТЬ В test_table ЗНАЧЕНИЯ (0) ВОЗВРАЩАЯ id В v_id;
    ОБНОВИТЬ test_table установить val = i где id = v_id;
    ФИКСАЦИЯ;
  КОНЕЦ;
КОНЕЦ ЦИКЛА;
Исходная версия pg_repack всегда падала на первом вставке, доработанная версия работала без ошибок. Отлично.
Выходим в продакшн и снова получаем ошибку на той же фазе копирования данных из лог-таблицы в новую:
$ ./pg_repack -t tablename -o id
INFO: repacking table "tablename"
ERROR: query failed:
    ERROR: duplicate key value violates unique constraint "index_16508"
DETAIL:  Key (id, index)=(100500, 42) already exists.
Классическая ситуация: на тестовых окружениях всё работает, а на продакшне — нет?!
APPLY_COUNT и стык двух батчей
Мы начали анализировать код буквально построчно и обнаружили важный момент: переливка данных из лог-таблицы в новую происходит батчами, константа APPLY_COUNT указывала на размер батча:
for (;;)
{
num = apply_log(connection, table, APPLY_COUNT);

if (num > MIN_TUPLES_BEFORE_SWITCH)
     continue;
/* возможно, все еще есть несколько кортежей, повторить. */
...
}
Проблема в том, что данные исходной транзакции, в которой несколько операций могут потенциально нарушить ограничение, при переносе могут попасть на стык двух батчей – половина команд будет закоммичена в первом батче, а другая половина — во втором. И здесь как повезёт: если команды в первом батче ничего не нарушают, то всё хорошо, а если нарушают — происходит ошибка.
APPLY_COUNT равен 1000 записей, что объясняет, почему наши тесты проходили успешно – они не покрывали случая “стыка батчей”. Мы использовали две команды – вставку и обновление, поэтому ровно 500 транзакций по две команды всегда помещались в батч и мы не испытывали проблем. После добавления второго обновления наша правка перестала работать:
ДЛЯ i В 1..10000 ЦИКЛ
  НАЧАЛО
    ВСТАВИТЬ В test_table ЗНАЧЕНИЯ (1) ВОЗВРАЩАЯ id В v_id;
    ОБНОВИТЬ test_table установить val = i где id = v_id;
    ОБНОВИТЬ test_table установить val = i где id = v_id; -- еще одно обновление
    ФИКСАЦИЯ;
  КОНЕЦ;
КОНЕЦ ЦИКЛА;
Итак, следующая задача – сделать так, чтобы данные из исходной таблицы, которые изменялись в одной транзакции, попадали в новую таблицу также внутри одной транзакции.
Отказ от батчинга
In unserer Situation gab es erneut zwei Lösungsmöglichkeiten. Die erste: Lassen Sie uns ganz auf die Batch-Verarbeitung verzichten und den Datentransfer mit einer einzigen Transaktion durchführen. Für diese Lösung sprach ihre Einfachheit – die erforderlichen Codeänderungen sind minimal (übrigens funktionierte in früheren Versionen pg_reorg genau so). Aber es gibt ein Problem – wir schaffen eine langwierige Transaktion, und das ist, wie bereits erwähnt, eine Bedrohung für die Entstehung neuer Bloat.
Die zweite Lösung ist komplizierter, aber wahrscheinlich auch richtiger: Wir könnten in der Log-Tabelle eine Spalte mit der Kennung der Transaktion erstellen, die die Daten in die Tabelle eingefügt hat. Dann können wir die kopierten Daten nach diesem Attribut gruppieren und sicherstellen, dass zusammenhängende Änderungen gemeinsam übertragen werden. Die Batchgröße würde aus mehreren Transaktionen (oder einer großen) bestehen und variieren, je nachdem, wie viele Daten in diesen Transaktionen geändert wurden. Es ist wichtig zu beachten, dass die Daten verschiedener Transaktionen in die Log-Tabelle in zufälliger Reihenfolge gelangen, sodass sie nicht mehr sequenziell gelesen werden können wie zuvor. Ein seqscan bei jeder Abfrage mit Filterung nach tx_id ist zu teuer, wir brauchen einen Index, aber dieser würde auch die Methode aufgrund der Kosten für dessen Aktualisierung verlangsamen. Im Allgemeinen muss man, wie immer, etwas opfern.
Also beschlossen wir, mit der ersten Variante zu beginnen, da sie einfacher ist. Zunächst mussten wir herausfinden, ob eine langwierige Transaktion ein echtes Problem darstellen würde. Da der Hauptdatentransfer von der alten Tabelle in die neue ebenfalls in einer langen Transaktion erfolgt, transformierte sich die Frage in „wie sehr wir diese Transaktion verlängern können?“ Die Dauer der ersten Transaktion hängt hauptsächlich von der Größe der Tabelle ab. Die Dauer der neuen hängt davon ab, wie viele Änderungen sich in der Tabelle während des Datentransfers ansammeln, d.h. von der Intensität der Last. Der pg_repack-Lauf fand während minimaler Last auf dem Dienst statt, und das Volumen der Änderungen war im Vergleich zur ursprünglichen Größe der Tabelle vernachlässigbar gering. Wir entschieden, dass wir die Dauer der neuen Transaktion vernachlässigen können (im Durchschnitt dauert sie 1 Stunde und 2-3 Minuten).
Die Experimente waren positiv. Auch der Einsatz in der Produktion war erfolgreich. Zur Veranschaulichung – hier ist ein Bild mit der Größe einer der Datenbanken nach dem Lauf:
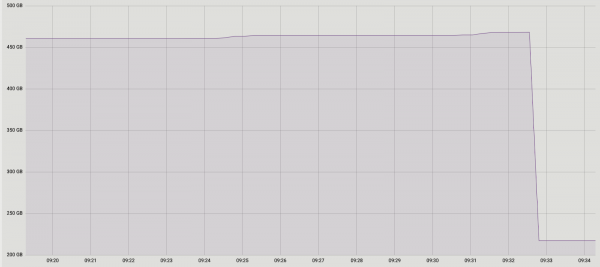
Ker sredstvo ustreza vsem našim zahtevam, nismo poskusili uvesti druge rešitve, vendar pa razmišljamo o možnostih za razpravo z razvijalci razširitev. Naša trenutna prilagoditev ni še pripravljena za objavo, saj smo rešili težavo le z edinstvenimi odloženimi omejitvami, prav tako pa moramo zagotoviti podporo tudi za druge tipe. Upamo, da nam bo to uspelo v prihodnosti.
Morda se spraujete, zakaj smo se v resnici lotili te zgodbe o prilagoditvi pg_repack in ne namesto tega uporabili njegove alternative? Tudi mi smo o tem v nekem trenutku razmišljali, toda pozitivna izkušnja njegove uporabe prej, na tabelah brez odloženih omejitev, nas je motivirala, da poskusimo razumeti bistvo težave in jo odpraviti. Poleg tega pa za uporabo drugih rešitev potrebujemo tudi čas za testiranje, zato smo se odločili, da najprej poskusimo odpraviti težavo v njem, in če ugotovimo, da tega ne moremo storiti v razumnem času, bomo začeli razmišljati o alternativah.
Zaključki
Kaj lahko priporočimo na podlagi lastnih izkušenj:
- Spremljajte svoj bloat. Na podlagi podatkov spremljanja boste lahko razumeli, kako dobro je nastavljen autovacuum.
- Nastavite AUTOVACUUM, da ohranite bloat na sprejemljivi ravni.
- Če bloat kljub vsemu narašča in ga ne morete obvladati s standardnimi orodji, se ne bojte uporabiti zunanjih razširitev. Najpomembnejše je, da vse dobro testirate.
- Ne bojte se prilagoditi zunanjih rešitev svojim potrebam – včasih je to lahko učinkoviteje in celo lažje kot spreminjanje lastne kode.
Izvor: habr.com
