

Želim vam lep petak! Sve manje vremena ostaje do pokretanja kursa , zato danas delimo prevod još jednog korisnog materijala na temu.
Tokom razvoja obavljena je impresivna količina posla na poboljšanju sekcioniranja tabela. Sekcioniranje tabela je funkcija koja postoji u PostgreSQL već dugo vremena, ali, ako se može tako reći, suštinski je nije bilo do verzije 10, kada je postala veoma korisna funkcija. Ranije smo tvrdili da je nasleđivanje tabela naša implementacija sekcioniranja, i to je tačno. Samo, ovaj način vas je prisilio da mnogo posla uradite ručno. Na primer, ako ste želeli da se tuple-ovi umetnu u sekcije tokom INSERT-ova, morali ste da postavite okidače da to urade umesto vas. Sekcioniranje pomoću nasleđivanja bilo je vrlo sporo i komplikovano za razvoj dodatnih funkcija iznad njega.
U PostgreSQL 10 videli smo rođenje "deklarativnog sekcioniranja" — funkcionalnosti dizajnirane da reši mnoge probleme koji su bili nerazrešeni korišćenjem starog metoda s nasleđivanjem. To je dovelo do stvaranja mnogo moćnijeg alata koji nam omogućava horizontalno deljenje podataka!
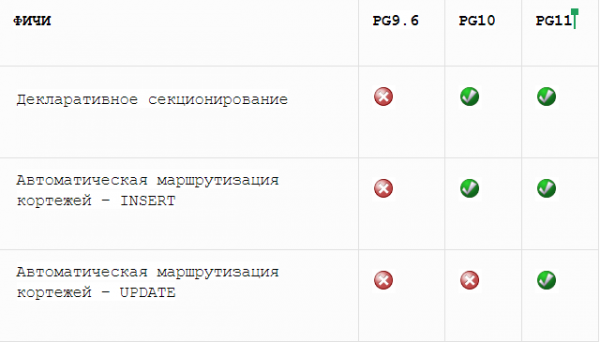
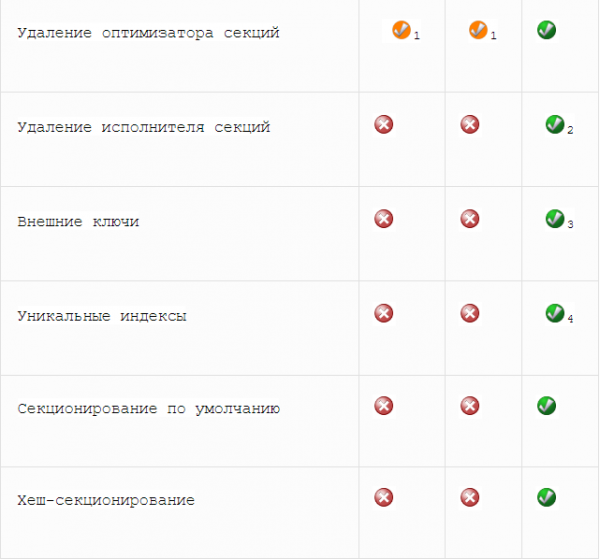
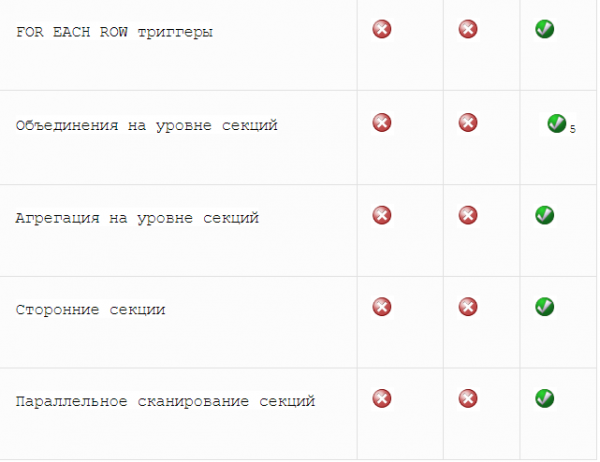
Upoređivanje funkcionalnosti
U PostgreSQL 11 pojavio se impresivan skup novih funkcija koje pomažu u poboljšanju performansi i čine sekcionirane tabele transparentnijim za aplikacije.
1. Korišćenje ograničavajućih izuzetaka
2. Dodavanje samo čvorova
3. Samo za sekcioniranu tabelu koja se poziva na nesekcioniranu
4. Indeksi moraju sadržati sve ključne kolone sekcije
5. Ograničenje na sekciju sa obe strane mora se poklapati
Performansa
Ovde imamo još dobre vesti! Dodata je nova metoda . Ovaj novi algoritam može da utvrdi odgovarajuće sekcije pregledajući uslove upita WHERE. Prethodni algoritam, s druge strane, proveravao je svaku sekciju da bi utvrdio da li može da ispunjava uslov WHERE. Ovo je dovelo do dodatnog povećanja vremena planiranja kako je broj sekcija rastao.
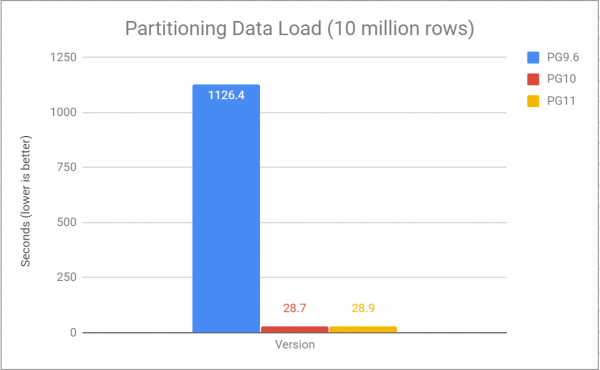
V različici 9.6 je bila usmeritev tuple v sekciji običajno izvedena z napisom sprožilne funkcije, ki je vsebovala vrsto IF operatorjev za vstavljanje tuple v pravilno sekcijo. Te funkcije so lahko bile zelo počasne pri izvajanju. S deklarativnim sekcioniranjem, dodanim v različici 10, je to začelo delovati bistveno hitreje.
Z uporabo sekcionirane tabele s 100 sekcijami lahko ocenimo uspešnost nalaganja 10 milijonov vrstic v tabelo, ki ima 1 stolpec BIGINT in 5 stolpcev INT.
Uspešnost poizvedbe v to tabelo za iskanje ene indeksirane številke in izvajanje DML za manipulacijo enega vnosa (z uporabo samo 1 procesorja):
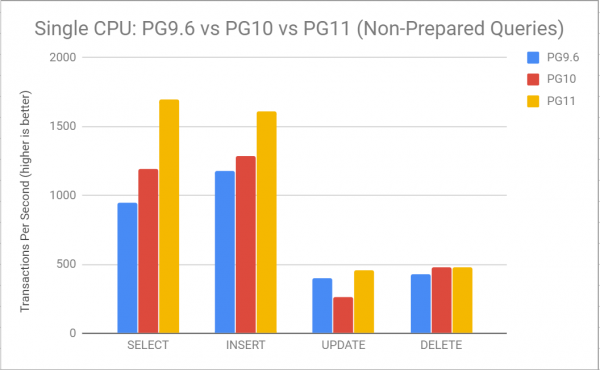
Tukaj vidimo, da se je uspešnost vsake operacije po PG 9.6 občutno povečala. Poizvedbe SELECT so videti precej bolje, zlasti tiste, ki lahko izključijo več sekcij med načrtovanjem poizvedb. To pomeni, da lahko načrtovalec preskoči velik del dela, ki ga je moral opraviti prej. Na primer, poti za nepotrebne sekcije se več ne gradijo.
Zaključek
Sekcioniranje tabel postaja zelo zmogljiva funkcija v PostgreSQL. Omogoča hitro prikazovanje podatkov v online načinu in njihovo preklapljanje v offline, ne da bi bilo potrebno čakati na končanje počasnih masovnih DML operacij.To tudi pomeni, da se lahko povezani podatki shranijo skupaj, kar omogoča dostop do zahtevanih podatkov veliko učinkoviteje. Izboljšave, dosežene v tej različici, ne bi bile mogoče brez razvijalcev, recenzentov in komitente, ki so neomajno delali na vseh teh funkcijah.
Hvala vsem njim! PostgreSQL 11 je videti preprosto fantastično!
Tukaj je kratek, a zelo zanimiv članek. Delite svoje komentarje in ne pozabite se prijaviti na , kjer bo podrobno predstavljena programa tečaja.
Izvor: habr.com
