

V svoji dejavnosti se srečujemo s situacijami, ko razvijalec napiše poizvedbo in pomisli: "baza je pametna, sama se bo spopadla z vsemi težavami!"«
V nekaterih primerih (delno zaradi pomanjkanja poznavanja možnosti baze podatkov, delno zaradi prezgodnjih optimizacij) takšen pristop privede do nastanka 'frankensteinov'.
Najprej bom navedel primer takšne poizvedbe:
-- za vsak ključni par najdemo povezane vrednosti polj
WITH RECURSIVE cte_bind AS (
  SELECT DISTINCT ON (key_a, key_b)
    key_a a
  , key_b b
  , fld1 bind_fld1
  , fld2 bind_fld2
  FROM
    tbl
)
-- najdemo min/max vrednosti za vsak prvi ključ
, cte_max AS (
  SELECT
    a
  , max(bind_fld1) bind_fld1
  , min(bind_fld2) bind_fld2
  FROM
    cte_bind
  GROUP BY
    a
)
-- povežemo po prvem ključu ključne pare in min/max vrednosti
, cte_a_bind AS (
  SELECT
    cte_bind.a
  , cte_bind.b
  , cte_max.bind_fld1
  , cte_max.bind_fld2
  FROM
    cte_bind
  INNER JOIN
    cte_max
      ON cte_max.a = cte_bind.a
)
SELECT * FROM cte_a_bind;
Da bi konkretno ocenili kakovost poizvedbe, ustvarimo nekakšen poljuben nabor podatkov:
CREATE TABLE tbl AS
SELECT
  (random() * 1000)::integer key_a
, (random() * 1000)::integer key_b
, (random() * 10000)::integer fld1
, (random() * 10000)::integer fld2
FROM
  generate_series(1, 10000);
CREATE INDEX ON tbl(key_a, key_b);
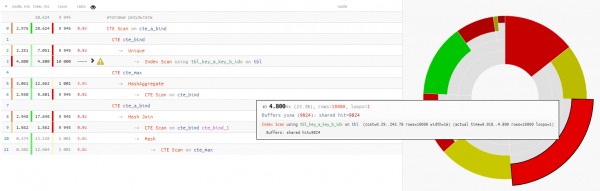
Izkazalo se je, da samo branje podatkov je vzelo manj kot četrtino celotnega časa izvajanja poizvedbe:
Razdelimo na dele
Natančno si ogledamo poizvedbo in se sprašujemo:
- Zakaj je tukaj WITH RECURSIVE, če ni nobenih rekurzivnih CTE-jev?
- Zakaj grupirati min/max vrednosti v ločenem CTE, če se potem vseeno povezujejo z izvirnim izborom?
+25% časa - Zakaj na koncu uporabiti ponoven povzetek iz prejšnjega CTE preko brezpogojnega ‘SELECT * FROM’?
+14% časa
V tem primeru smo imeli srečo, da je bila za povezovanje izbrana Hash Join, ne Nested Loop, saj bi sicer dobili ne en sam prehod CTE Scan, temveč 10K!
malo o CTE ScanTu se je treba spomniti, da CTE Scan je enakovreden Seq Scan - to pomeni brez indeksacije, temveč samo popolno branje, ki bi zahtevalo 10K x 0.3ms = 3000ms pri krogih po cte_max ili 1K x 1.5ms = 1500ms pri krogih po cte_bind!
Sicer, kaj smo torej želeli doseči v rezultatu? Aha, običajno se takšno vprašanje pojavi nekje pet minut po začetku analize 'trojnestopenjskih' poizvedb.
Želeli smo za vsak edinstven ključni par prikazati min/max iz skupine po key_a.
Torej, uporabimo :
SELECT DISTINCT ON(key_a, key_b)
	key_a a
,	key_b b
,	max(fld1) OVER(w) bind_fld1
,	min(fld2) OVER(w) bind_fld2
FROM
	tbl
WINDOW
w AS (PARTITION BY key_a); 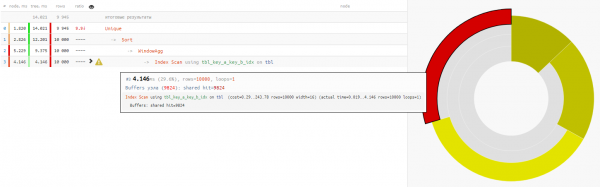
Ker se branje podatkov v obeh primerih traja približno 4-5 ms, je celoten naš prihranek časa -32% — to čista resnica obremenitev, odstranjena s CPU baze, če se takšen poizvedba izvaja dovolj pogosto.
Na splošno ni pametno prisiliti baze, da 'krožno nosi, kvadratno valja'.
Izvor: habr.com
