

V SQL-u opisujete "kaj" želite pridobiti, ne pa "kako" naj se to izvede. Zato problem razvoja SQL poizvedb v slogu "kako se sliši, tako se piše" zaseda svoje častno mesto, ob .
Danes si na izjemno preprostih primerih poglejmo, do česa to lahko pripelje v kontekstu uporabe GROUP/DISTINCT in LIMIT skupaj z njimi.
Če ste v poizvedbi zapisali "najprej združi ti tabele, nato izbriši vse podvojitve, mora ostati samo en primer po ključu" — tako bo delovalo, tudi če združitev sploh ni bila potrebna.
In včasih se zgodi, da to "preprosto deluje", včasih pa neprijetno vpliva na zmogljivost, včasih pa daje povsem nepredvidljive učinke z vidika razvijalca.
No, morda ne tako spektakularni, ampak…
"Sladka dvojica": JOIN + DISTINCT
SELECT DISTINCT
  X.*
FROM
  X
JOIN
  Y
    ON Y.fk = X.pk
WHERE
  Y.bool_condition;
Zdi se jasno, da so želeli izbrati tiste zapise X, za katere v Y obstajajo povezani zapisi, ki ustrezajo izvedenemu pogoj.Zapisali so poizvedbo preko JOIN — in dobili so nekaj vrednosti pk večkrat (točno tolikokrat, kolikor ustreznih zapisov v Y se je izkazalo). Kako to odstraniti? Seveda DISTINCT!
Še posebej "veseli", ko za vsak zapis X najdemo nekaj sto povezanih zapisov Y, nato pa herojsko odstranimo podvojitve...
Kako popraviti? Najprej se je treba zavedati, da je mogoče nalogo spremeniti v "izbrati takšne zapise X, za katere v Y obstaja BAREM EN povezan zapis, ki ustreza izvedenemu pogojem" — saj nam izsame Y-zapisa nič ne korist.
Vložen EXISTS
SELECT
  *
FROM
  X
WHERE
  EXISTS(
    SELECT
      NULL
    FROM
      Y
    WHERE
      fk = X.pk AND
      bool_condition
    LIMIT 1
  );
Nekatere različice PostgreSQL razumejo, da je v EXISTS dovolj najti prvo ustrezno izbiro, starejše ne. Zato raje vedno navedem LIMIT 1 inside EXISTS.
LATERAL JOIN
SELECT
  X.*
FROM
  X
, LATERAL (
    SELECT
      Y.*
    FROM
      Y
    WHERE
      fk = X.pk AND
      bool_condition
    LIMIT 1
  ) Y
WHERE
  Y IS DISTINCT FROM NULL;
Ta možnost omogoča, da hkrati takoj vrnemo tudi kakšne podatke iz najdene povezane Y-zapis. Podobna možnost je obravnavana v članku .
«Zakaj plačati več»: DISTINCT [ON] + LIMIT 1
Dodatna prednost ovakvih transformacija upita je mogućnost lako ograničiti pretragu zapisa, ako je potrebna samo jedna/više njih, kao u sledećem slučaju:
SELECT DISTINCT ON(X.pk)
  *
FROM
  X
JOIN
  Y
    ON Y.fk = X.pk
LIMIT 1;
Sada čitamo upit i pokušavamo da razumemo šta se predlaže da uradi SDB:
- spajamo tabele
- uničavamo prema X.pk
- iz preostalih zapisa biramo neku jednu
Dakle, šta smo dobili? „Neku jednu stavku“ iz unikatnih — a ako uzmem tu jednu iz neunikatnih, hoće li se rezultat promeniti?.. „A ako nema razlike, zašto plaćati više?“
SELECT
  *
FROM
  (
    SELECT
      *
    FROM
      X
    -- ovde se mogu dodati odgovarajući uslovi
    LIMIT 1 -- +1 Limit
  ) X
JOIN
  Y
    ON Y.fk = X.pk
LIMIT 1;
I potpuno ista tema sa GROUP BY + LIMIT 1.
„Samo me pitajte“: nevidljivi GROUP + LIMIT
Slične stvari se javljaju kod raznih provera nije prazno tabele ili CTE tokom izvršavanja upita:
...
CASE
  WHEN (
    SELECT
      count(*)
    FROM
      X
    LIMIT 1
  ) = 0 THEN ...
Agregatne funkcije (count/min/max/sum/...) uspešno se izvršavaju na celom skupu, čak i bez jasnog navođenja GROUP BY. Samo što s LIMIT ne idu baš najbolje.
Programer može misliti „ako postoje zapisi, ne trebam više od LIMIT“.. Ali ne treba tako! Jer za bazu to znači:
- izračunaj šta žele vrati onoliko redova koliko traže
- U zavisnosti od ciljanih uslova, ovde je prikladno izvršiti jednu od zamena:
(count + LIMIT 1) = 0
NOT EXISTS(LIMIT 1)na(count + LIMIT 1) > 0EXISTS(LIMIT 1)nacount >= N(SELECT count(*) FROM (... LIMIT N))na„Koliko stavljati u gramima“: DISTINCT + LIMIT
SELECT DISTINCT pk FROM X LIMIT $1
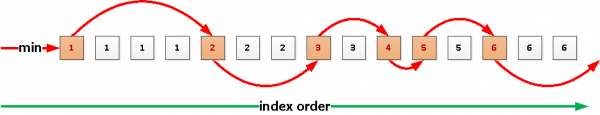
Naivan programer može iskreno verovati da će izvršenje upita stati,čim nađemo $1 prvih naišao različitih vrednosti U nekoj budućnosti to bi moglo tako raditi zahvaljujući novom čvoru.
Index Skip Scan , čija se implementacija trenutno razmatra, ali za sada — nije.Za sada će prvo
svi zapisi biti izvučeni, unikatizovani, i tek iz njih će se vratiti koliko je traženo. Posebno tužno bude ako smo želeli nešto kao, a zapisa u tabeli — stotine hiljada… $1 = 4Da ne tugujemo bez potrebe, iskoristićemo rekursivni upit
„DISTINCT za siromašne“ iz PostgreSQL Wiki :
Izvor: habr.com
