

Danes ne bo zelo zapletenih primerov ali skrivnostnih algoritmov na SQL. Vse bo zelo preprosto, na ravni Kapitana Očitnega — delamo pregled dnevnika dogodkov s sortiranjem po času.
To pomeni, da je v bazi tabela events, na kateri je polje ts — ravno tisti čas, po katerem želimo te vnose urejati in prikazovati:
CREATE TABLE events(
  id
    serial
      PRIMARY KEY
, ts
    timestamp
, data
    json
);

CREATE INDEX ON events(ts DESC);
Seveda, da ne bomo imeli le nekaj vnosev, zato bomo potrebovali v nekem smislu stranicno navigacijo.
#0. «Я у мамы погроммист»
cur.execute("SELECT * FROM events;")
rows = cur.fetchall();
rows.sort(key=lambda row: row.ts, reverse=True);
limit = 26
print(rows[offset:offset+limit]);
Tudi skoraj ne šala — redko, pa se zgodi v divjini. Včasih, ko delamo z ORM, je težko preiti nazaj na "direktno" delo s SQL.
Ampak preidimo na bolj pogoste in manj očitne težave.
#1. OFFSET
SELECT
  ...
FROM
  events
ORDER BY
  ts DESC
LIMIT 26 OFFSET $1; -- 26 - vnosi na strani, $1 - začetek strani
Odkod je prišla številka 26? To je približno število zapisov, ki zapolnijo en zaslon. Natančneje, 25 prikazanih zapisov, plus 1, ki signalizira, da v izbiri še vedno obstaja kaj in ima smisel iti naprej.
Seveda, to vrednost ni nujno "zakodirati" v telo poizvedbe, ampak jo posredovati preko parametra. A v tem primeru načrtovalnik PostgreSQL ne bo mogel opreti na vednost, da bi moralo biti relativno malo zapisov — in bi lahko enostavno izbral neučinkovit načrt.
In dokler je v vmesniku aplikacije pregled dnevnika realiziran kot preklapljanje med vizualnimi "stranicami", nihče dolgo ne opazi ničesar sumljivega. Ravno do trenutka, ko se v boju za udobje UI/UX odločijo za prenovo vmesnika na "neskončno pomikanje" — torej se vsi zapisi dnevnika prikažejo v enem seznamu, ki ga lahko uporabnik vrti zgoraj-dolje.
In tako vas, pri naslednjem testiranju, ujamejo pri podvajanju zapisov v dnevniku. Zakaj, saj ima tabela normalen indeks (ts), na katerega se opira vaša poizvedba?
Ravno zato, ker niste upoštevali, da ts ni edinstven ključ v tej tabeli. Pravzaprav, in vrednosti niso edinstvene., kot vsako "čas" v realnih pogojih — zato se ista vrstica v dveh sosednjih poizvedbah zlahka "preskoči" iz strani na stran zaradi drugega končnega reda v okviru razvrščanja iste vrednosti ključa.
V resnici pa se tu skriva še druga težava, ki jo je veliko težje opaziti — nekatere vrstice ne bodo prikazane sploh! Saj so "podvojene" vrstice zasedle neko mesto. Podrobno razlago s privlačnimi slikami lahko .
Razširimo indeks
Prevarantski razvijalec razume — treba je narediti ključ indeksa edinstven, najbolj preprost način pa je razširiti ga z vnaprej edinstvenim poljem, kot je PK:
USTVARITE EDINSTVENI INDeks na dogodkih(ts DESC, id DESC);Poizvedba se mutira:
IZBERITE
  ...
UREDI PO
  ts DESC, id DESC
OMEJI 26 OFFSET $1;
#2. Переход на «курсоры»
Nekaj časa pozneje k vam pride DBA in "razveseli", da vaše poizvedbe , in sploh, čas je, da preidemo na navigacijo od zadnje prikazane vrednosti. Vaša poizvedba se spet mutira:
IZBERITE
  ...
KJER
  (ts, id) < ($1, $2) -- zadnje pridobljene vrednosti v prejšnjem koraku
UREDI PO
  ts DESC, id DESC
OMEJI 26;
Olajšano ste zadihali, dokler ni prišlo do …
#3. Чистка индексов
Ker je nekega dne vaš DBA prebral in spoznal, da "ne-zadnji" timestamp — to ni dobro. In spet je prišel k vam — zdaj z mislijo, da bi moral tisti indeks vseeno spet postati (ts DESC).
Toda kaj storiti z začetno težavo "skakanja" vnosov med stranmi?.. Vse je preprosto — treba je izbirati bloke z nefiksiranim številom vnosov!
Splošno, kdo nam prepoveduje brati ne "natanko 26", ampak "vsaj 26"? Na primer, tako, da se v naslednjem bloku znajdejo vnosov s povsem drugimi vrednostmi ts — takrat ne bo težav z "preskakanjem" vnosov med bloki!
Tako se tega doseže:
IZBERITE
  ...
KJER
  ts = coalesce((
    IZBERITE
      ts
    IZ
      dogodki
    KJER
      ts < $1
    UREDI PO
      ts DESC
    OMEJI 1 OFFSET 25
  ), '-infinity')
UREDI PO
  ts DESC;
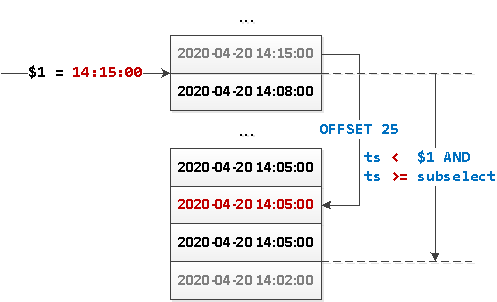
Kaj se tu sploh dogaja?
- Korakamo 25 vnosov "navzdol" in dobimo "mejno" vrednost
ts. - Če tam že ni nič, potem NULL-vrednost nadomestimo z
-infinity. - Odstavimo celoten segment vrednosti med pridobljeno vrednostjo
tsin posredovanim parametrom $1 (prejšnjo "zadnjo" upodobljeno vrednost). - Če blok vrne manj kot 26 zapisov, je to zadnji.
Ali enako s slikami:
Ker imamo zdaj vzorec nima nekega določnega 'začetka', nam torej nič ne preprečuje, da 'razvijemo' to zahtevo v obratno smer in realiziramo dinamično nalaganje podatkovnih blokov od 'referenčne točke' v obe smeri — tako navzdol kot navzgor.
Napomena
- Da, v tem primeru se obračamo na indeks dvakrat, a vse 'čisto po indeksu'. Zato bo vložena zahteva privedla le do enega dodatnega Index Only Scan.
- Očitno je, da se te metode lahko uporabljajo le, kadar vaši vrednosti
tslahko naključno prekrivajo, in jih je malo. Če pa je vaš tipični primer 'milijon zapisov v 00:00:00.000', tega ni pametno početi. V smislu, ne bi smeli dopustiti takega primera. A če je tako izpadlo, uporabite različico z razširjenim indeksom.
Izvor: habr.com
