

Občas má vývojář potřebu předat do požadavku sadu parametrů nebo dokonce celou výběrovou sadu «na vstupu». Někdy se objevují velmi podivná řešení tohoto úkolu.
Pojďme „od konce“ a podívejme se, jak by se to dělat nemělo, proč a jak to lze udělat lépe.
Přímá „vložení“ hodnot do těla požadavku
Vypadá to obvykle zhruba takto:
query = "SELECT * FROM tbl WHERE id = " + value… nebo takto:
query = "SELECT * FROM tbl WHERE id = :param".format(param=value)O tomto způsobu bylo řečeno, napsáno a víc než dost:
Téměř vždy je to — přímá cesta k SQL injekcím a přetížení firemní logiky, která je nucena „lepít“ řetězec vašeho dotazu.
Částečně je tento přístup ospravedlnitelný pouze v případě potřeby použití sekcí ve verzích PostgreSQL 10 a nižších pro získání efektivnějšího plánu. V těchto verzích je seznam skenovaných sekcí určen ještě bez ohledu na předávané parametry, pouze na základě těla dotazu.
$n-argumenty
Uporaba parametry — to je dobré, umožňuje to použít , snižující zátěž jak na firemní logiku (řetězec požadavku se vytváří a předává pouze jednou), tak na server DB (není potřeba opakované rozebírání a plánování pro každý případ požadavku).
Proměnlivé množství argumentů
Problémy nás čekají, když budeme chtít předat předem neznámé množství argumentů:
... id IN ($1, $2, $3, ...) -- $1 : 2, $2 : 3, $3 : 5, ...Pokud necháme dotaz v tomto stavu, tak i když nás to uchrání před potenciálními injekcemi, stále to povede k nutnosti skládat/zpracovávat dotaz pro každou variantu počtu argumentů. Už je to lepší, než to dělat pokaždé, ale lze se s tím obejít i bez toho.
Stačí předat pouze jeden parametr, obsahující serializované zobrazení pole:
... id = ANY($1::integer[]) -- $1 : '{2,3,5,8,13}'Jediný rozdíl — nutnost jasně převést argument na požadovaný typ pole. Ale to nezpůsobuje problémy, protože už předem víme, kam směřujeme.
Předání výběru (matice)
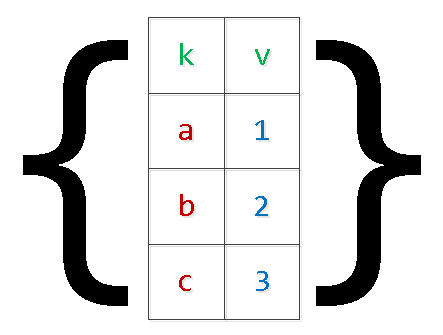
Obvykle jde o různé způsoby předávání souborů dat pro vložení do databáze „za jeden požadavek“:
INSERT INTO tbl(k, v) VALUES($1,$2),($3,$4),...Kromě výše popsaných problémů s „slepením“ požadavku nás to může také vést k out of memory in padcu servera. Razlog je preprost — pod argumenti PG rezervira dodatno pomnilnika, medtem ko je število zapisov v naboru omejeno le z aplikacijskimi zahtevami poslovne logike. V posebej kliničnih primerih smo lahko videli »številčne« argumente več kot $9000 — ne delaj tako.
Ponovno napišimo poizvedbo, pri čemer uporabimo že »dvojnоslojno« serializacijo:
INSERT INTO tbl
SELECT
  unnest[1]::text k
, unnest[2]::integer v
FROM (
  SELECT
    unnest($1::text[])::text[] -- $1 : '{"{a,1}","{b,2}","{c,3}","{d,4}"}'
) T;
Da, v primeru »zapletenih« vrednosti znotraj tabele je potrebno obdaniti z narekovaji.
Jasno je, da je na ta način mogoče »razviti« izbor s poljubnim številom polj.
unnest, unnest, …
Periodično se srečujejo različice, kjer se namesto »niza nizov« posreduje več »nizov stolpcev«, o katerih sem omenil :
SELECT
  unnest($1::text[]) k
, unnest($2::integer[]) v;
Z to metodo, če se zmotite pri generiranju seznamov vrednosti za različne stolpce, je zelo enostavno dobiti povsem nepričakovane rezultate, ki so odvisni tudi od različice strežnika:
-- $1 : '{a,b,c}', $2 : '{1,2}'
-- PostgreSQL 9.4
k | v
-----
a | 1
b | 2
c | 1
a | 2
b | 1
c | 2
-- PostgreSQL 11
k | v
-----
a | 1
b | 2
c |
JSON
Že od različice 9.3 dalje so v PostgreSQL na voljo popolne funkcije za delo z json tipom. Tako da, če se določitev vhodnih parametrov izvaja v brskalniku, lahko tam neposredno oblikujete json-objekt za SQL poizvedbo:
SELECT
  key k
, value v
FROM
  json_each($1::json); -- '{"a":1,"b":2,"c":3,"d":4}'
Za prejšnje različice je mogoče uporabiti enak način za each(hstore), vendar lahko pravilno »zvijanje« z obravnavo zapletenih objektov v hstore povzroči težave.
json_populate_recordset
Če vnaprej veste, da bodo podatki iz »vhodnega« json-niza šli za izpolnitev kakšne tabele, lahko precej prihranite pri »razčiščevanju« polj in pretvorbi v potrebne tipe, tako da uporabite funkcijo json_populate_recordset:
SELECT
  *
FROM
  json_populate_recordset(
    NULL::pg_class
  , $1::json -- $1 : '[{"relname":"pg_class","oid":1262},{"relname":"pg_namespace","oid":2615}]'
  );
json_to_recordset
Ta funkcija preprosto »razvije« posredovani niz objektov v izbor, ne da bi se opirala na format tabele:
SELECT
  *
FROM
  json_to_recordset($1::json) T(k text, v integer);
-- $1 : '[{"k":"a","v":1},{"k":"b","v":2}]'
k | v
-----
a | 1
b | 2
TEMPORARY TABLE
Ampak, če je obseg podatkov v predani izbiri zelo velik, je težko in včasih celo nemogoče, ker zahteva enkratno dodelitev velike količine pomnilnikaNa primer, potrebujete dolgo zbirati velik paket podatkov o dogodkih iz zunanjega sistema, nato pa ga želite enkrat obdelati na strani DB.
V tem primeru bo najboljša rešitev uporaba :
CREATE TEMPORARY TABLE tbl(k text, v integer);
...
INSERT INTO tbl(k, v) VALUES($1, $2); -- ponovite večkrat
...
-- tukaj naredite nekaj koristnega s to celotno tabelo
Metoda je dobra predvsem za redko prenašanje velikih količin podatkov.
Z vidika opisa strukture svojih podatkov se začasna tabela razlikuje od "obične" zgolj po enem kriteriju v sistemski tabeli pg_class, već u pg_type, pg_depend, pg_attribute, pg_attrdef, … — tako ne razlikuje od ničesar.
Zato v spletnih sistemih z velikim številom kratkotrajnimi povezavami ta tabela za vsako od njih ustvarja nove sistemske zapise, ki se odstranijo ob zaprtju povezave z DB. Na koncu, nekontrolirana uporaba TEMP TABLE pripelje do „napihnjenosti“ tabel v pg_catalog in upočasnitev mnogih operacij, ki jih uporabljajo.
Seveda pa se temu lahko upremo z periodičnim prehodom VACUUM FULL po tabelah sistemskega kataloga.
Sejne spremenljivke
Recimo, da je obdelava podatkov iz prejšnjega primera dovolj zapletena za en SQL poizvedbo, a jo želimo izvajati dokaj pogosto. Tako želimo uporabiti proceduralno obdelavo v , vendar bo uporaba prenosa podatkov preko začasnih tabel predraga.
Uporabiti $n-parametre za prenos v anonimni blok prav tako ne moremo. Izhod iz te situacije nam lahko olajšajo sejne spremenljivke in funkcija current_setting.
Pred različico 9.2 je bilo potrebno vnaprej nastaviti custom_variable_classes za „svoje“ sejne spremenljivke. V aktualnih različicah pa lahko pišete nekako tako:
SET my.val = '{1,2,3}';
DO $$
DECLARE
  id integer;
BEGIN
  FOR id IN (SELECT unnest(current_setting('my.val')::integer[])) LOOP
    RAISE NOTICE 'id : %', id;
  END LOOP;
END;
$$ LANGUAGE plpgsql;
-- NOTICE:  id : 1
-- NOTICE:  id : 2
-- NOTICE:  id : 3
V drugih podprtih proceduralnih jezikih lahko najdete še druge rešitve.
Poznate še druge načine? Delite jih v komentarjih!
Izvor: habr.com
