

Bojte se operacij, buffers koje donose…
Na primeru malog upita razmotrićemo neke univerzalne pristupe optimizaciji upita u PostgreSQL-u. Koristiti ih ili ne — izbor je vaš, ali vredi ih znati.
U nekim budućim verzijama PG situacija bi se mogla promeniti sa 'pamćenjem' planera, ali za 9.4/9.6 izgleda otprilike isto kao primeri ovde.
Uzećemo sasvim realan upit:
SELECT
  TRUE
FROM
  "Dokument" d
INNER JOIN
  "DokumentProširenje" doc_ex
    USING("@Dokument")
INNER JOIN
  "TipDokumenta" t_doc ON
    t_doc."@TipDokumenta" = d."TipDokument"
WHERE
  (d."Lice3" = 19091 or d."Zaposlenik" = 19091) AND
  d."$Člank" IS NULL AND
  d."Obrisan" IS NOT TRUE AND
  doc_ex."Stanje"[1] IS TRUE AND
  t_doc."TipDokumenta" = 'PlanPoslova'
LIMIT 1;
o imenima tabela i poljaNa 'ruska' imena polja i tabela može se gledati na različite načine, ali to je stvar ukusa. Pošto nema stranih programera, a PostgreSQL nam omogućava da imenujemo i hijeroglifima, ako su oni stavljeni u navodnike, preferiramo da objekte imenujemo jednoznačno i jasno, kako ne bi došlo do nesporazuma.
Pogledajmo na dobijeni plan:
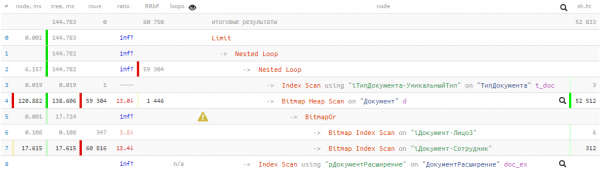
144ms i skoro 53K buffers — to jest više od 400MB podataka! I srećni smo ako se svi oni nađu u kešu u trenutku našeg upita, inače će on trajati znatno duže prilikom čitanja sa diska.
Algoritam je najvažniji!
Da bismo nekako optimizovali bilo koji upit, prvo moramo da razumemo šta on zapravo treba da radi.
Za sada ćemo ostaviti van okvira ovog članka razvoj same strukture Baze podataka, i dogovoriti se da možemo relativno 'jeftino' prepisati upit i/ili na Bazu implementirati neke potrebne indekse.
Dakle, upit:
— proverava postojanje bilo kojeg dokumenta
— u potrebnom nam stanju i određenog tipa
— gde je autor ili izvršilac potreban nam zaposlenik
JOIN + LIMIT 1
Često je programeru lakše napisati upit gde se prvo povezuje veliki broj tabela, a zatim iz te gomile ostane jedinstveni zapis. Ali lakše za programera — ne znači efikasnije za Bazu podataka.
U našem slučaju tabela je bila samo 3 — a kakav je efekat…
Hajde da se prvo oslobodimo povezivanja sa tabelom 'TipDokumenta', a usput da kažemo bazi da kod nas ima jedinstven zapis tipa. (mi to vemo, ali planifikator za sada ne shvata):
WITH T AS (
  SELECT
    "@TipDokumenta"
  FROM
    "TipDokumenta"
  WHERE
    "TipDokumenta" = 'PlanPoslova'
  LIMIT 1
)
...
WHERE
  d."TipDokumenta" = (TABLE T)
...
Da, ako tabela/CTE sadrži samo jedno polje jedne jedine vrednosti, onda se u PG može pisati čak i ovako, umesto
d."TipDokumenta" = (SELECT "@TipDokumenta" FROM T LIMIT 1)Lenjivo računanje u upitima PostgreSQL-a
BitmapOr vs UNION
U nekim slučajevima Bitmap Heap Scan će nas koštati mnogo — na primer, u našoj situaciji, kada mnogo zapisa odgovara zahtevu. Došli smo do toga zbog OR-uslova koji se pretvorio u BitmapOr-operaciju u planu.
Vratimo se na prvobitni zadatak — treba pronaći zapis koji odgovara bilo kojem od uslova — dakle, ne treba tražiti svih 59K zapisa po oba uslova. Postoji način da se izvrši jedan uslov, a na drugi pređemo samo kada po prvom ništa ne pronađemo. Pomoći će nam ova konstrukcija:
(
  SELECT
    ...
  LIMIT 1
)
UNION ALL
(
  SELECT
    ...
  LIMIT 1
)
LIMIT 1
Spoljni LIMIT 1 garantuje da će pretraga završiti kada se pronađe prva vrednost. I ako se ona pronađe već u prvom bloku, drugo se neće izvršiti (nikad ne izvršeno u planu).
Skrivamo složene uslove pod CASE
U prvobitnom upitu postoji izuzetno neprijatan trenutak — provera stanja na povezanoj tabeli "DokumentEkstenzija". Bez obzira na tačnost ostalih uslova u izrazu (na primer, d."Obrisan" IS NOT TRUE), ovo povezivanje se uvek izvršava i "troši resurse". Više ili manje će ih biti potrošeno — zavisi od obima ove tabele.
Ali možemo modifikovati upit tako da se pretraga za povezanim zapisom vrši samo kada je to zaista potrebno:
SELECT
  ...
FROM
  "Dokument" d
WHERE
  ...
/*index cond*/ AND
  CASE
    WHEN "$Nacrt" IS NULL AND "Obrisan" IS NOT TRUE THEN (
      SELECT
        "Stanje"[1] IS TRUE
      FROM
        "DokumentEkstenzija"
      WHERE
        "@Dokument" = d."@Dokument"
    )
  END
Pošto nam iz povezane tabele ni jedno polje nije potrebno za rezultat, imamo mogućnost da pretvorimo JOIN u uslov sa podupitom.
Ostaćemo indeksirani polja „van zagrade“ CASE, jednostavne uslove unosimo u WHEN-blok — i sada se „težak“ upit izvršava samo kada pređemo u THEN.
Moje prezime je „Ukupno“
Sastavljamo rezultate upita sa svim mehanizmima opisanim iznad:
S T AS (
  SELECT
    "@DocumentType"
  FROM
    "DocumentType"
  WHERE
    "DocumentType" = 'WorkPlan'
)
  (
    SELECT
      TRUE
    FROM
      "Document" d
    WHERE
      ("Person3", "DocumentType") = (19091, (TABLE T)) AND
      CASE
        WHEN "$Draft" IS NULL AND "Deleted" IS NOT TRUE THEN (
          SELECT
            "State"[1] IS TRUE
          FROM
            "DocumentExtension"
          WHERE
            "@Document" = d."@Document"
        )
      END
    LIMIT 1
  )
UNION ALL
  (
    SELECT
      TRUE
    FROM
      "Document" d
    WHERE
      ("DocumentType", "Employee") = ((TABLE T), 19091) AND
      CASE
        WHEN "$Draft" IS NULL AND "Deleted" IS NOT TRUE THEN (
          SELECT
            "State"[1] IS TRUE
          FROM
            "DocumentExtension"
          WHERE
            "@Document" = d."@Document"
        )
      END
    LIMIT 1
  )
LIMIT 1;
Adjusting [to] indexes
The trained eye noticed that the indexed conditions in the UNION sub-blocks differ slightly — this is because there are already suitable indexes on the table. If there weren't any — it would be worth creating them: Document(Person3, DocumentType) in Document(DocumentType, Employee).
about the order of fields in ROW conditionsFrom the scheduler's point of view, of course, it can also be written as (A, B) = (constA, constB), i (B, A) = (constB, constA). But when writing in the order of fields in the index, such a query is simply more convenient to debug later.
What's in the plan?
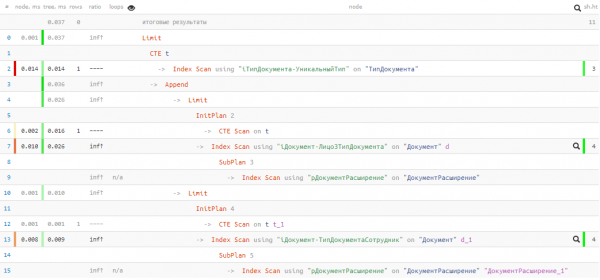
Unfortunately, we were unlucky, and in the first UNION block, nothing was found, so the second one still went for execution. But even then — only 0.037ms and 11 buffers!
We accelerated the query and reduced the data 'pumping' in memory by several thousand times, using quite simple techniques — not a bad result for a little copy-pasting. 🙂
Izvor: habr.com
