

Predlagam, da se spoznate z razlago poročila iz začetka leta 2016 Vladimira Sitnikova "PostgreSQL in JDBC - iztisnemo vse sokove"
Dober dan! Moje ime je Vladimir Sitnikov. Delam 10 let v podjetju NetCracker. In predvsem se ukvarjam z zmogljivostjo. Vse, kar je povezano z Javom, vse, kar je povezano s SQL – to je tisto, kar imam rad.
Danes bom govoril o tem, s čimer smo se srečali v podjetju, ko smo začeli uporabljati PostgreSQL kot strežnik podatkov. In večinoma delamo z Javo. Toda to, kar bom danes predstavil, ni povezano samo z Javo. Kot je praksa pokazala, se to pojavi tudi v drugih jezikih.
Govorili bomo o:
- izvleku podatkov.
- Shranjevanju podatkov.
- Pa tudi o zmogljivosti.
- In o podvodnih skalah, ki so tam skrite.
Začnimo z enostavnim vprašanjem. Izbiramo eno vrstico iz tabele po primarnem ključu.
Baza se nahaja na istem gostiteljskem strežniku. In vse to traja 20 milisekund.
Teh 20 milisekund – to je zelo veliko. Če imate 100 takih poizvedb, porabite čas v sekundi za obdelavo teh poizvedb, torej vržemo čas stran.
S tega ne maramo delati in gledamo, kaj nam baza ponuja. Baza nam ponuja dve možnosti za izvajanje poizvedb.
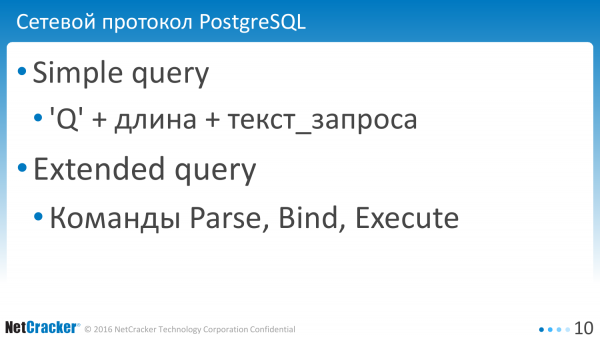
Prva možnost je preprosta poizvedba. Po čem je dobra? Po tem, da jo vzamemo in pošljemo, in to je to.
Baza ima tudi razširjeno poizvedbo, ki je bolj zapletena, vendar bolj funkcionalna. Lahko pošljete ločeno poizvedbo za parsanje, izvajanje, povezovanje spremenljivk itd.
Super razširjena poizvedba – to ni tema trenutnega poročila. Morda smo si od baze zaželeli nekaj in obstaja seznam želja, ki je v nekem smislu oblikovan, torej to je tisto, kar želimo, vendar ni mogoče zdaj in v bližnji prihodnosti. Zato smo preprosto zapisali in bomo prosili glavne ljudi.
Tisto, kar lahko storimo, je preprosta poizvedba in razširjena poizvedba.
Kaj je značilno za vsak pristop?
Preprosto poizvedbo je dobro uporabiti za enkratno izvedbo. Enkrat izvedete in pozabite. In težava je v tem, da ne podpira binarnega formata podatkov, torej za nekatere visoko zmogljive sisteme ni primerno.
Razširjena poizvedba omogoča prihranek časa pri parsiranju. To smo storili in začeli uporabljati. Zelo nam je pomagalo. Poleg prihranka pri parsiranju je tu tudi prihranek pri prenosu podatkov. Prenos podatkov v binarni obliki je bistveno bolj učinkovit.
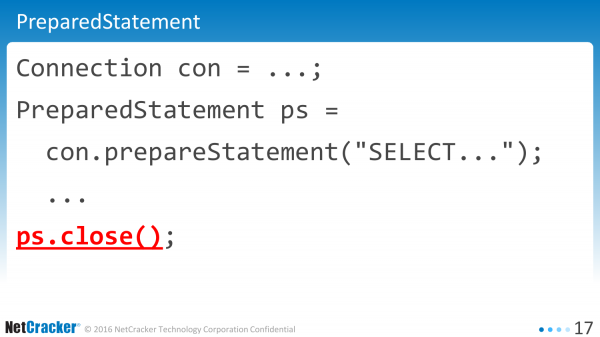
Poglejmo prakso. Tako izgleda tipična aplikacija. To je lahko Java, itd.
Ustvarili smo statement. Izvedli smo ukaz. Ustvarili smo close. Kje je tukaj napaka? Kje je problem? Ni težav. Tako piše v vseh knjigah. Tako je treba pisati. Če želite največjo zmogljivost, pišite tako.
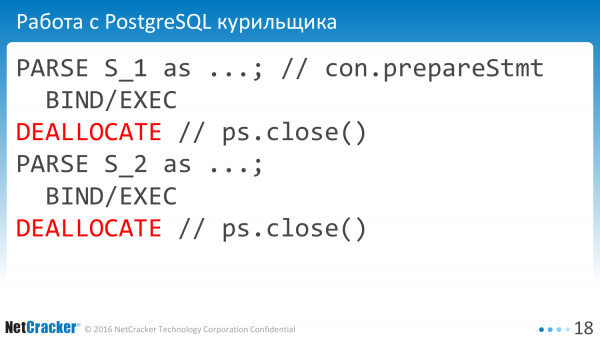
Toda praksa je pokazala, da to ne deluje. Zakaj? Zaradi tega, ker imamo metodo 'close'. In ko to naredimo, z vidika baze podatkov to deluje kot delo kadilca z bazo podatkov. Rekli smo 'PARSE EXECUTE DEALLOCATE'.
Zakaj te nepotrebne ustvaritve in nalaganje statements? Nihče jih ne potrebuje. Običajno pri PreparedStatement tako pride, ko jih zapremo, zaprejo vse v bazi podatkov. To ni to, kar želimo.
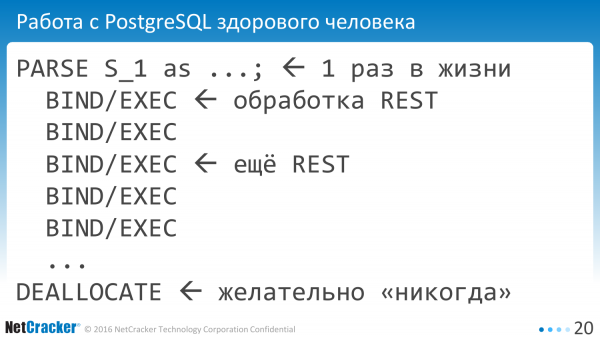
Želimo, da delamo z bazo kot zdravi ljudje. Enkrat vzamemo in pripravimo naš statement, nato ga izvajamo večkrat. V resnici večkrat – to pomeni enkrat za vse življenje aplikacije zaparseriti. In na različnih REST-ih uporabljamo isti ID statement. To je naš cilj.
Kako to doseči?
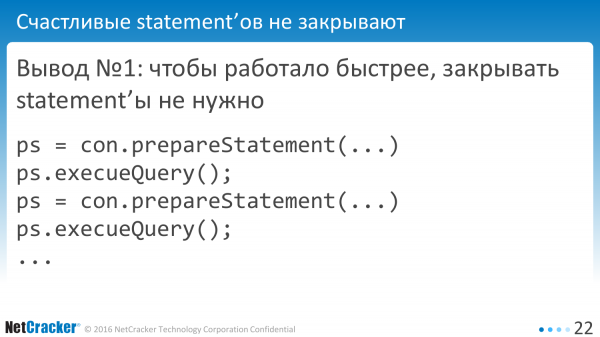
Zelo preprosto – ne smemo zapirati statements. Pišemo tako: 'prepare' 'execute'.
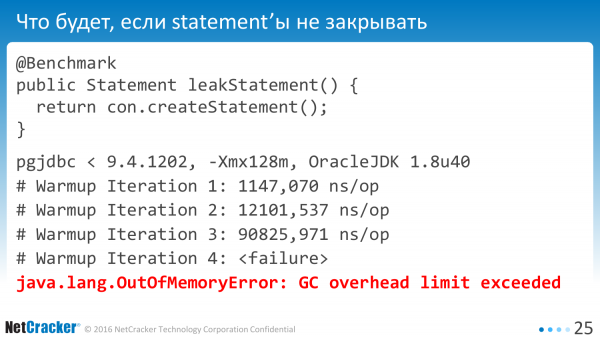
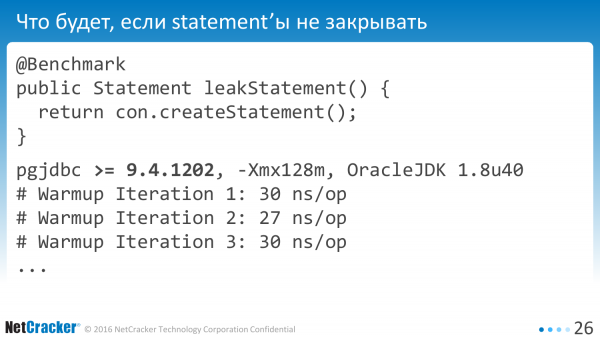
Če to zaženemo, je jasno, da se lahko kje kaj preplavi. Če ni jasno, lahko to tudi izmerimo. Vzamemo in napišemo benchmark, v katerem bo tak preprost način. Ustvarimo statement. Zaženemo na neki različici gonilnika in ugotovimo, da se dokaj hitro sesuje z izgubo celotne pomnilniške kapacitete, ki smo jo imeli.
Jasno je, da so takšne napake enostavno popravljive. O tem ne bom govoril. Toda povedal bom, da v novi različici deluje veliko hitreje. Metoda je neumna, a kljub temu.
Kako pravilno delovati? Kaj moramo storiti?
V resnici aplikacije vedno zaprejo statements. V vseh knjigah pišejo, naj jih zaprejo, sicer bo prišlo do uhajanja pomnilnika.
In PostgreSQL ne more keširati poizvedb. Vsaka seja mora sama ustvariti ta keš.
In tudi ne želimo izgubljati časa za parsanje.
In kot ponavadi imamo dve možnosti.
Prva opcija – uzimamo i kažemo da sve obavijamo u PgSQL. Tamo postoji keš. On sve kešira. Biće odlično. Pogledali smo to. Imamo 100500 zahteva. Ne radi. Ne slažemo se da se zahtevi prebacuju u procedure ručno. Ne-ne.
Imamo drugu opciju – uzeti i sami napraviti. Otvaramo izvorne kodove, počinjemo da radimo. Radimo, radimo. Ispostavilo se da to nije tako teško uraditi.
To se pojavilo u avgustu 2015. Sada već postoji modernija verzija. I sve je odlično. Radi toliko dobro da ne menjamo ništa u aplikaciji. Čak smo prestali da razmišljamo u pravcu PgSQL, tj. to nam je bilo dovoljno da sve troškove skoro svedemo na nulu.
Shodno tome, Server-prepared statements se aktivira pri petom izvršenju kako ne bismo trošili memoriju u bazi podataka za svaku jednokratnu upit.
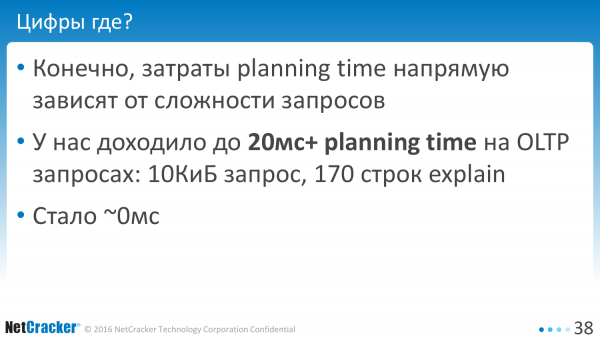
Možete pitati – gde su brojevi? Šta dobijate? I ovde ne mogu da dam brojeve, jer su za svaki upit različiti.
Naši zahtevi su bili takvi da smo na OLTP upitima trošili oko 20 milisekundi na parsiranje. Tamo je bilo 0,5 milisekundi na izvršenje, 20 milisekundi na parsiranje. Upit – 10 KiB teksta, 170 redova plana. To je OLTP upit. Pita 1, 5, 10 redova, ponekad više.
Ali nismo želeli da trošimo 20 milisekundi. Sve smo sveli na nulu. Sve je odlično.
Šta možete izvući iz ovoga? Ako imate Java, uzimate modernu verziju drajvera i radujete se.
Ako imate neki drugi jezik, razmislite – možda vam je to takođe potrebno? Jer sa stanovišta krajnjeg jezika, na primer, ako je PL 8 ili imate LibPQ, nije vam očigledno da trošite vreme ne na izvršenje, već na parsiranje i to treba proveriti. Kako? Sve je besplatno.
Osim toga, postoje greške, neke osobine. I o tome ćemo upravo govoriti. Većina će biti o industrijskoj arheologiji, o onome što smo pronašli, na šta smo naišli.
Ako se upit generiše dinamički. To se dešava. Neko spaja stringove, što rezultira SQL upitom.
Šta je loše u tome? Loše je što svaki put dobijamo drugačiji string.
Tudi ta različna vrstica mora znova izračunati hashCode. To je resnično naloga za CPU – najti dolg besedilni zahtevek v tudi obstoječem hash-u ni tako preprosto. Zato je preprost zaključek – ne ustvarjajte zahtevkov. Shranite jih v eno spremenljivko. In uživajte.
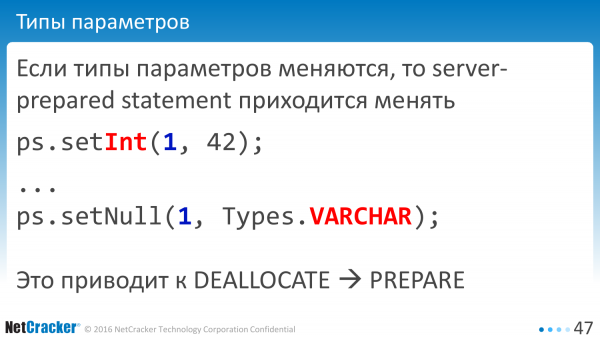
Naslednja težava. Tipi podatkov so pomembni. Obstajajo ORM, ki pravijo, da ni pomembno, kakšen NULL, naj bo kakršen koli. Če je Int, potem rečemo setInt. In če je NULL, naj bo vedno VARCHAR. In kakšna razlika je na koncu kakšen tam NULL? Baza podatkov bo vse razumela sama. In ta slika ne deluje.
V praksi bazi podatkov ni vseeno. Če ste prvič rekli, da imate številko, drugič pa rekli, da je to VARCHAR, potem ni mogoče ponovno uporabiti Server-prepared statements. V takem primeru je treba naš statement znova ustvariti.
Če izvajate isti zahtevek, pazite, da se tipi podatkov v stolpcu ne mešajo. Treba je paziti na NULL. To je pogosta napaka, ki smo jo imeli po tem, ko smo začeli uporabljati PreparedStatements.
Dobro, vključili smo. Morda smo vzeli gonilnik. In zmogljivost je padla. Vse je postalo slabo.
Kako se to zgodi? Je to bug ali funkcija? Na žalost ni bilo mogoče razumeti – ali je to bug ali funkcija. Toda obstaja povsem preprost scenarij za ponavljanje te težave. Presenetljivo nas je napadla. In gre za poizvedbo iz ene same tabele. Takih zahtevkov smo imeli več. Običajno so vključevali dve ali tri tabele, a obstaja takšen scenarij ponovitve. Vzemite na vaši bazi katere koli različice in ga ponovite.
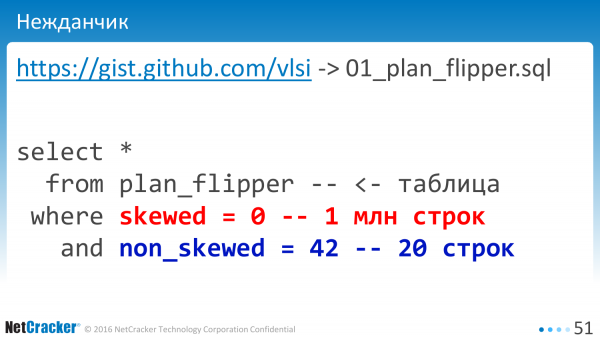
Smisel je v tem, da imamo dva stolpca, od katerih je vsak indeksiran. V enem stolpcu je milijon vrstic z vrednostjo NULL. V drugem stolpcu pa je le 20 vrstic. Ko izvajamo brez povezanih spremenljivk, vse dobro deluje.
Če začnemo izvajati s povezanimi spremenljivkami, tj. izvajamo znak „?“ ali „$1“ za naš zahtevek, kaj na koncu dobimo?
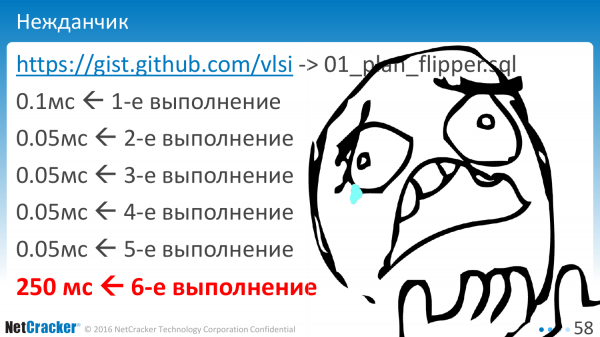
Prvo izvajanje – kot je treba. Drugo – malo hitreje. Nekaj se je shranilo v predpomnilnik. Tretje-četrto-peto. Potem pa bum – in nekako tako. In najhuje je, da se to zgodi pri šestem izvajanju. Kdo je vedel, da je treba izvesti prav šest izvajanj, da bi ugotovili, kakšen je dejansko načrt izvedbe?
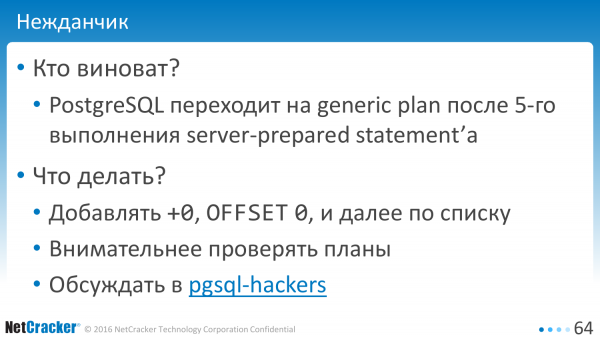
Kdo je kriv? Kaj se je zgodilo? Baza podatkov vsebuje optimizacijo. In je nekako optimizirana za splošni primer. In tako se, od določene točke naprej, preklopi na splošni načrt, ki je, žal, lahko drugačen. Lahko se izkaže, da je enak, lahko pa tudi drugačen. Obstaja neka mejna vrednost, ki vodi do tega vedenja.
Kaj lahko storimo glede tega? Tukaj je seveda težje karkoli predvidevati. Obstaja enostavna rešitev, ki jo uporabljamo. To je +0, OFFSET 0. Verjetno poznate takšne rešitve. Enostavno vzamemo in v poizvedbo dodamo „+0“ in vse je v redu. To pokažem kasneje.
Obstaja še ena možnost - bolj skrbno preverjanje načrtov. Razvijalec mora ne samo napisati poizvedbo, temveč tudi 6-krat reči „explain analyze“. Če 5-krat, potem ne bo ustrezalo.
In še tretja možnost - poslati e-pošto na pgsql-hackers. Napisal sem, vendar še vedno ni jasno - ali je to napaka ali lastnost.
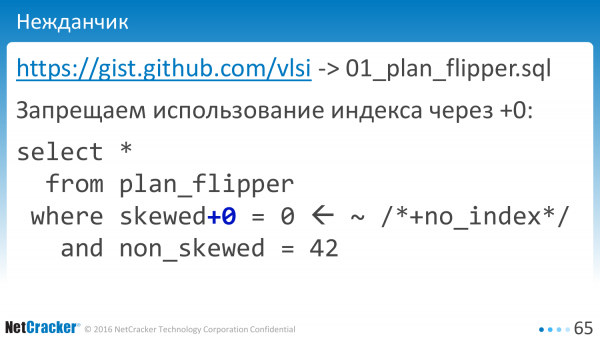
Medtem ko razmišljamo - ali je to napaka ali lastnost, popravimo. Vzamemo našo poizvedbo in dodamo „+0“. Vse je v redu. Dva znaka in sploh ni treba razmišljati, kako in kaj. Zelo preprosto. Preprosto smo bazi podatkov prepovedali uporabo indeksa za to kolono. Nimamo indeksa za kolono „+0“ in vse, baza podatkov ne uporablja indeksa, vse je v redu.
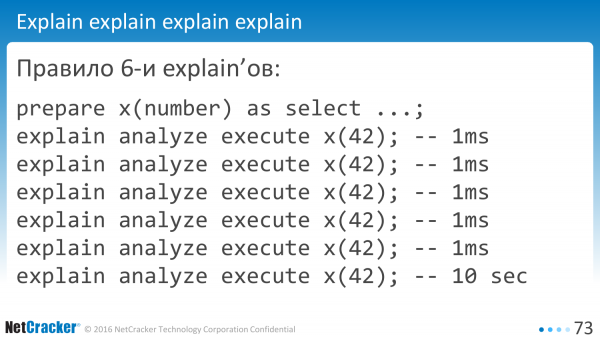
To je pravilo 6-ih pojasnil. Zdaj je v trenutnih različicah potrebno narediti 6-krat, če imate povezane spremenljivke. Če nimate povezanih spremenljivk, potem lahko to storimo tako. In tako na koncu ta poizvedba pade. Zadeva ni zapletena.
Zdi se, da koliko lahko? Tukaj napaka, tam napaka. Realno napaka povsod.
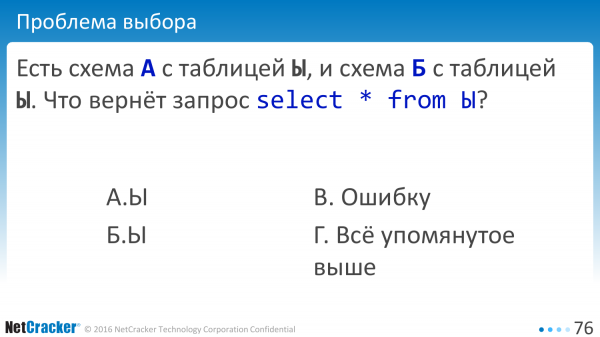
Poglejmo še eno stvar. Na primer, imamo dve shemi. Shema A z tabelo Y in shema B z tabelo Y. Poizvedba - izberite podatke iz tabele. Kaj se nam pri tem zgodi? Imeli bomo napako. Imeli bomo vse zgoraj navedeno. Pravilo je to - napaka povsod, imeli bomo vse zgoraj navedeno.
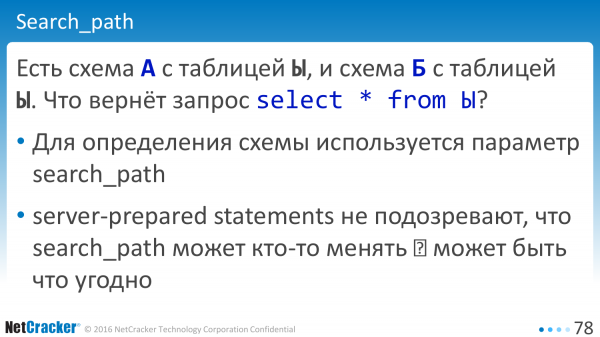
Zdaj vprašanje: „Zakaj?“. Zdi se, da obstaja dokumentacija, da, če imamo shemo, obstaja spremenljivka „search_path“, ki pove, kje iskati tabelo. Zdi se, da spremenljivka obstaja.
Kakšna je težava? Težava je v tem, da server-prepared statements ne domnevajo, da lahko nekdo spremeni search_path. Ta vrednost ostane nekako konstantna za bazo podatkov. In nekateri deli morda ne prevzamejo novih vrednosti.
Seveda, to je odvisno od različice, na kateri preizkušate. Odvisno je tudi od tega, kako resno se vaši podatkovni nizi razlikujejo. Različica 9.1 bo preprosto izvedla stare poizvedbe. Novejše različice lahko opazijo prevaro in povedo, da imate napako.
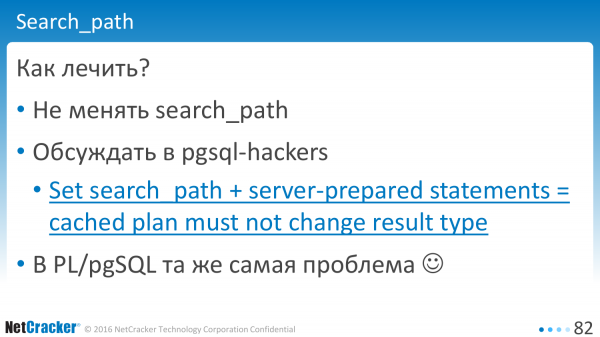
Kako to ozdraviti? Obstaja preprost recept – ne delajte tako. Ne spreminjajte search_path med delom aplikacije. Če ga že spremenite, je bolje ustvariti novo povezavo.
Lahko se pogovarjamo, t.j. odpreti, razpravljati, dodati. Morda bomo prepričali razvijalce podatkovne baze, da v primeru, ko nekdo spremeni vrednost, baza podatkov mora obvestiti uporabnika: 'Oglejte si, vaša vrednost se je posodobila. Morda bi bilo potrebno ponastaviti stavke, re-create?' Zdaj se baza podatkov obnaša skrito in ne obvešča o spremembah v stavkih.
In še enkrat poudarjam – to ni tipično za Javo. Enako bomo videli v PL/pgSQL enakovredno. A tam se bo reproduciralo.
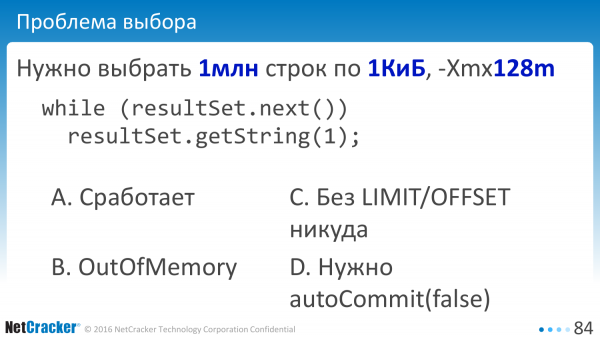
Poskusimo še enkrat izbrati podatke. Izbiramo. Imamo tabelo z milijonom vrstic. Vsaka vrstica ima en kilobajt. Približno gigabajt podatkov. In imamo delovni pomnilnik v Java stroju 128 megabajtov.
Kot običajno, kot priporočajo vse knjige, uporabljamo procesiranje tokov. T.j. odpreti moramo resultSet in brati podatke postopoma. Bo to delovalo? Ali bomo presegli pomnilnik? Bo bral postopoma? Poglejmo v bazo, poglejmo v Postgres. Ne verjamemo. Bomo naleteli na OutOFMemory? Kdo je doživel OutOfMemory? Kdo je uspel popraviti po tem? Nekdo je uspel popraviti.
Če imate milijon vrstic, ne morete kar tako izbirati. Obvezno je treba uporabiti OFFSET/LIMIT. Kdo se strinja s to možnostjo? In kdo se veže na možnost, da je treba igrati z autoCommit?
Tukaj se običajno izkaže, da je najbolj nepričakovana možnost pravilna. In če nenadoma izklopite autoCommit, vam bo to pomagalo. Zakaj? O tem znanost ne ve.
Toda privzeto vsi odjemalci, ki se povezujejo z bazo podatkov Postgres, izberejo podatke v celoti. PgJDBC v tem smislu ni izjema, izbere vse vrstice.
Obstaja variacija na temo FetchSize, t.j. na ravni posameznega stavka lahko poveste, da naj izbere podatke po 10, 50. Toda to ne deluje, dokler ne izklopite autoCommit. Ko izklopite autoCommit – začne delovati.
Toda hoja secciones por el código y establece setFetchSize en todos lados es incómodo. Así que hemos creado una configuración que establece un valor predeterminado para toda la conexión.
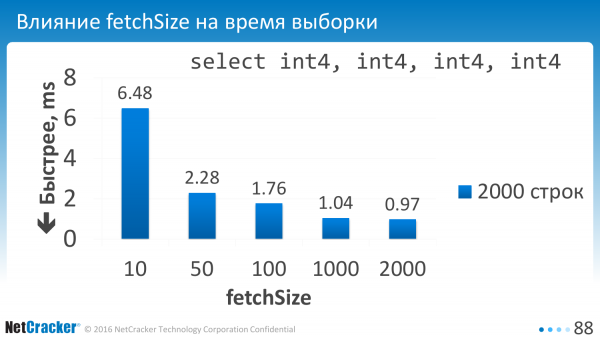
Ya lo hemos dicho. Hemos configurado el parámetro. ¿Y qué hemos logrado? Si seleccionamos un número pequeño, por ejemplo, seleccionando 10 filas, tenemos sobrecargas bastante grandes. Por lo tanto, deberíamos establecer este valor en alrededor de cien.
En ideal, claro, aprender a limitar aún en bytes, pero la receta es la siguiente: establecemos defaultRowFetchSize a más de cien y estamos felices.
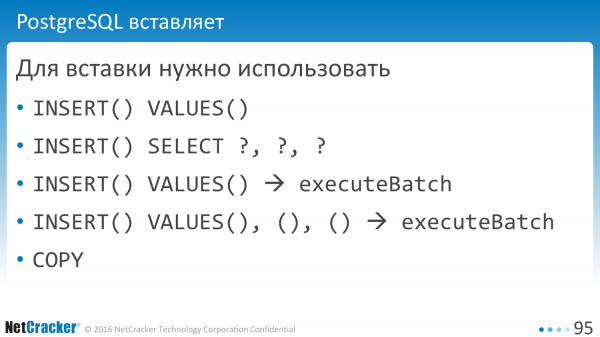
Pasemos a la inserción de datos. La inserción es más simple, hay diferentes opciones. Por ejemplo, INSERT, VALUES. Esta es una buena opción. También se puede decir ‘INSERT SELECT’. En la práctica, es lo mismo. No hay diferencia en el rendimiento.
Los libros dicen que se debe realizar una declaración de BATCH, y los libros dicen que se pueden ejecutar comandos más complejos con varios paréntesis. Y en Postgres hay una función maravillosa: se puede hacer COPY, es decir, hacerlo más rápido.

Si medimos, podemos hacer nuevamente varios descubrimientos interesantes. ¿Cómo queremos que funcione? Queremos no analizar y no ejecutar comandos innecesarios.
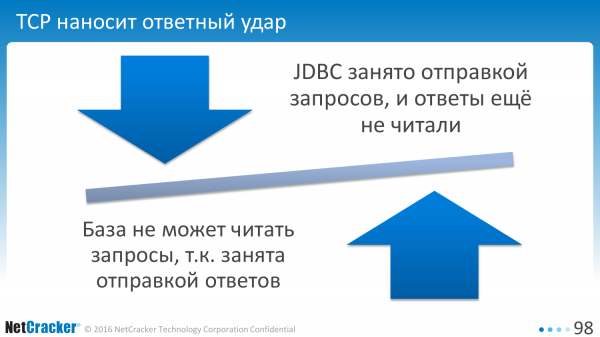
En la práctica, TCP no nos permite hacer eso. Si el cliente está ocupado enviando una solicitud, la base de datos, en sus intentos de enviarnos respuestas, no lee las solicitudes. Como resultado, el cliente espera a que la base de datos lea la solicitud, mientras que la base de datos espera al cliente a que lea la respuesta.
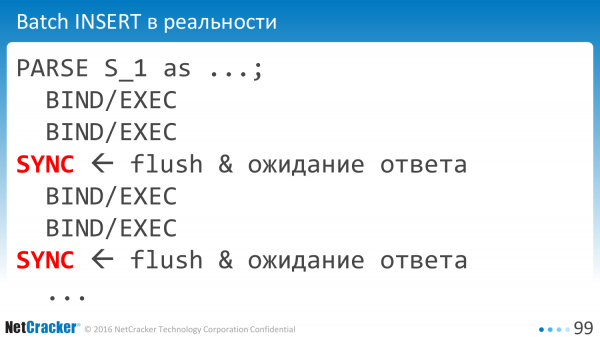
Por lo tanto, el cliente se ve obligado a enviar periódicamente un paquete de sincronización. Interacciones de red innecesarias, pérdida de tiempo adicional.
 Y cuanto más los añadimos, peor se vuelve. El controlador es bastante pesimista y los añade con bastante frecuencia, aproximadamente cada 200 filas, dependiendo del tamaño de las filas, etc.
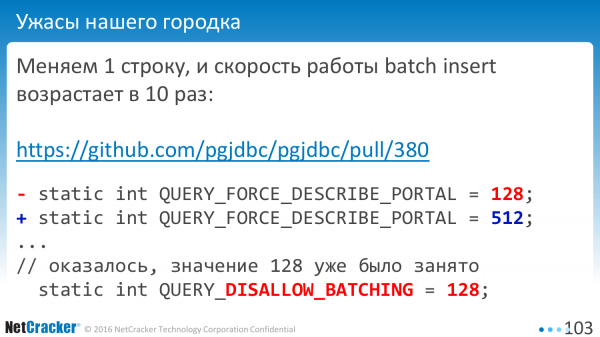
A veces, puedes corregir solo una línea y todo se acelera diez veces. Eso sucede. ¿Por qué? Como siempre, una constante ya fue utilizada en algún lugar. Y el valor ‘128’ significaba no utilizar batching.
Es bueno que esto no haya llegado a la versión oficial. Se detectó antes de comenzar a lanzar la versión. Todos los valores que menciono se basan en versiones modernas.
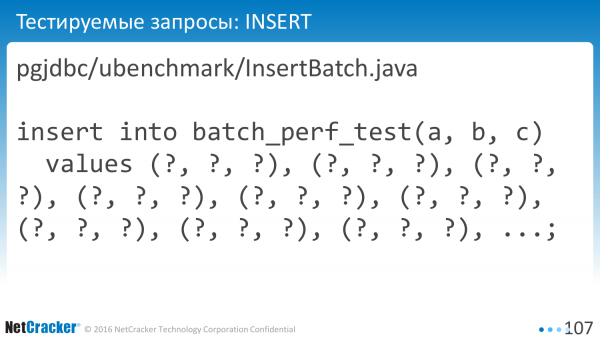
Midamos. Medimos InsertBatch simple. Medimos InsertBatch múltiple, es decir, lo mismo, pero con muchos valores. Un movimiento astuto. No todos pueden hacerlo, pero es un movimiento simple, mucho más fácil que COPY.
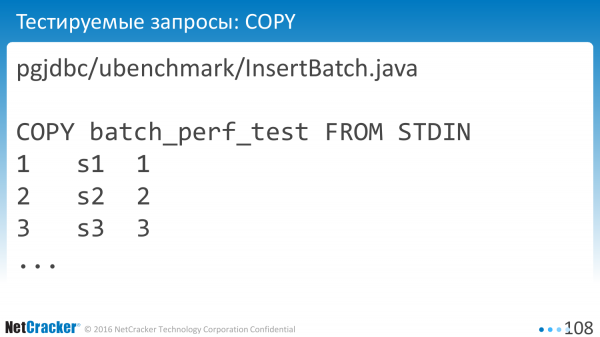
Se puede hacer COPY.
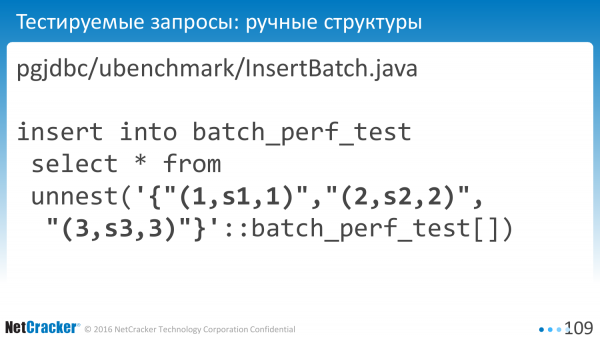
In structures, this can be done. Declare the User default type, pass an array and INSERT directly into the table.
If you open the link: pgjdbc/ubenchmsrk/InsertBatch.java, this code is available on GitHub. You can specifically see what queries are generated there. It's not essential.
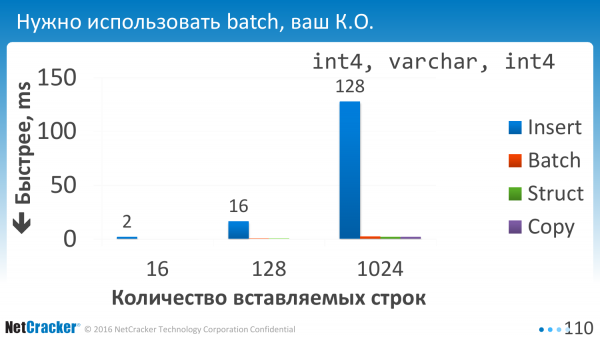
We ran it. And the first thing we realized was that not using batch is simply not an option. All batching alternatives yield nearly zero time, meaning execution time is practically zero compared to a single execution.
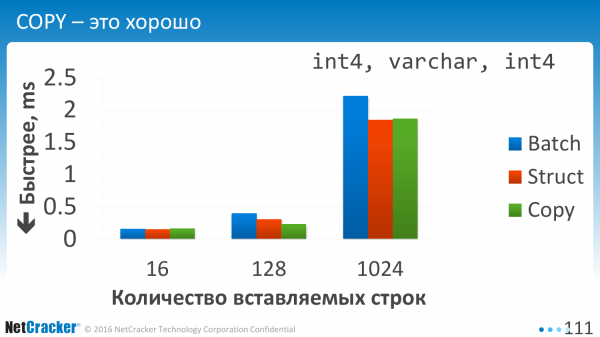
We are inserting data. It's a quite simple table with three columns. And what do we see here? We see that all three options are roughly comparable. And COPY is certainly better.
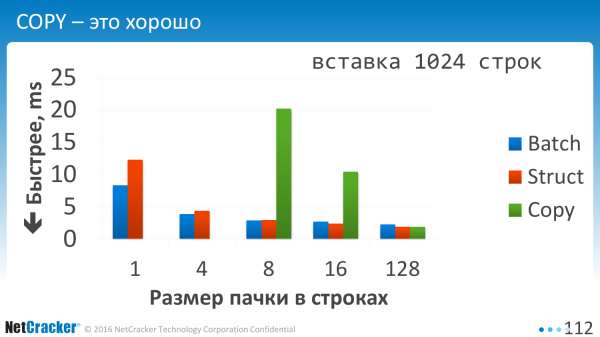
This is when we insert in chunks. When we said one value VALUES, two values VALUES, three values VALUES, or when we indicated 10 separated by commas. This is just horizontally now. 1, 2, 4, 128. It's clear that the Batch Insert, which is shown in blue, benefits significantly from this. So when you insert one at a time or even when you insert four, it gets twice as better, simply because we packed a bit more into VALUES. Fewer EXECUTE operations.
Using COPY for small volumes is extremely unpromising. I didn't even draw the first two. They go to infinity, meaning those green numbers for COPY.
COPY should be used when you have at least more than a hundred rows of data. The overhead of opening this connection is significant. And, to be honest, I haven't dug into this direction. I've optimized the batch, but not COPY.
What do we do next? We measured. We understand that we need to use either structures or a clever batch that combines several values.
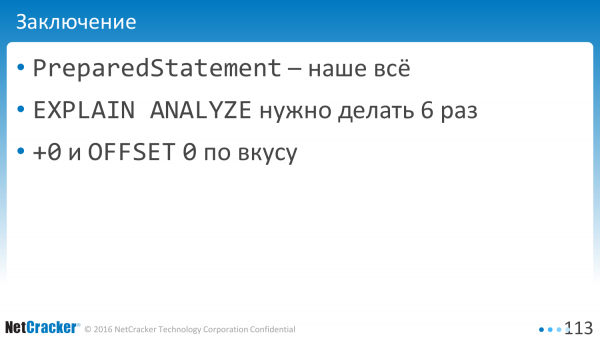
What should be taken away from today's presentation?
- PreparedStatement is everything for us. It gives a lot for performance. However, it gives a large barrel of tar.
- And we need to do EXPLAIN ANALYZE 6 times.
- And we need to dilute OFFSET 0, and tricks like +0 to correct the remaining percentage of our problematic queries.
Izvor: habr.com
