

Spoštovani bralci, dober dan!
Naloga gradnje IT-platform za zbiranje in analizo podatkov se prej ali slej pojavi pri vsakem podjetju, katerega poslovni model temelji na intelektualno zahtevnih storitvah ali razvoju tehnično zahtevnih izdelkov. Gradnja analitičnih platform je zapleten in delovno intenziven postopek. Vendar pa je vsako nalogo mogoče olajšati. V tem članku želim deliti izkušnje o uporabi low-code orodij, ki pomagajo pri ustvarjanju analitičnih rešitev. Te izkušnje so bile pridobljene pri izvajanju številnih projektov področja Big Data Solutions podjetja „Neoflex“. Področje Big Data Solutions podjetja „Neoflex“ se od leta 2005 ukvarja z vprašanji gradnje skladišč in jezer podatkov, rešuje naloge optimizacije hitrosti obdelave informacij ter razvija metodologijo upravljanja kakovosti podatkov.
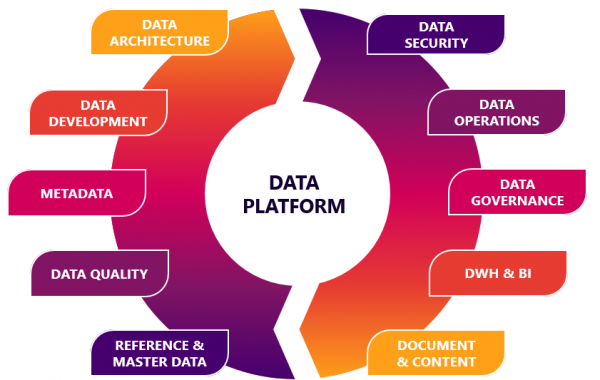
Izogibanje zavednemu kopičenju slabo in/ali dobro strukturiranih podatkov ne bo uspelo nikomur. Verjetno celo, če bo šlo za malo podjetje. Kajti pri širjenju poslovanja se bodo perspektivni podjetniki soočili z vprašanji oblikovanja programa zvestobe, želeli analizirati učinkovitost prodajnih mest, razmišljali o ciljni reklami in se spraševali o povpraševanju po spremljevalnih izdelkih. V prvem približku se lahko naloga reši 'na kolenih'. A pri rasti podjetja je prihod do analitične platforme neizbežen.
Vendar pa v katerem primeru naloge analize podatkov lahko prerastejo v naloge razreda 'Rocket Science'? Morda takrat, ko govorimo o resnično velikih podatkih.
Da bi olajšali nalogo 'Rocket Science', lahko pojejete slona po delih.
Večja kot je diskretnost in avtonomnost vaših aplikacij/servisov/mikroservisov, lažje boste vi, vaši sodelavci in celo vaše podjetje prebavljali slona.
Do tega postulata so prišli praktično vsi naši klienti, ki so preoblikovali pokrajino na podlagi inženirskih praks ekip DevOps.
Toda tudi pri 'ločeni, slonji' dieti imamo zelo dobre možnosti za 'prekomerno nasičenje' IT-pokrajine. V tem trenutku je smiselno zastaviti, zadihati in pogledati v smer low-code inženirska platforma.
Mnogi razvijalci se bojijo, da bo njihova kariera zastala, ko se bodo odmaknili od neposrednega pisanja kode in prešli na "prenašanje" puščic v UI vmesnikih low-code sistemov. Vendar pa pojav strojev ni povzročil izginotja inženirjev, temveč je njihovo delo dvignil na nov nivo!
Poglejmo, zakaj.
Analiza podatkov na področju logistike, telekomunikacijske industrije, medijskih raziskav in finančnega sektorja je vedno povezana z naslednjimi vprašanji:
- Hitrost izvajanja avtomatizirane analize;
- Možnost izvajanja eksperimentov brez vpliva na glavni tok proizvodnje podatkov;
- Pravilen pripravljeni podatki;
- Sledenje spremembam in verzioniranje;
- Izvor podatkov, sledljivost podatkov, CDC;
- Hitrost dostave novih funkcij v produkcijsko okolje;
- In slavni: strošek razvoja in vzdrževanja.
To pomeni, da imajo inženirji ogromno visoko raven nalog, katerih učinkovito izvajanje je mogoče le, če se umaknejo od nizko nivojskih razvojnih nalog.
Pogoji za prehod razvijalcev na nov nivo so bili evolucija in digitalizacija poslovanja. Vrednost razvijalca se prav tako spreminja: razvijalci, ki se lahko poglobijo v bistvo konceptov avtomatiziranega poslovanja, so v veliki oskrbi.
Poglejmo analogijo med nizko nivojskimi in visoko nivojskimi programskimi jeziki. Prehod s nizko nivojskih jezikov k visoko nivojskim jeziku pomeni prehod od pisanja "direktiv v jeziku strojne opreme" k "direktivam v jeziku ljudi". To pomeni dodajanje neke vrste abstraktne plasti. V tem primeru prehod na low-code platforme z visoko nivojskih programskih jezikov pomeni prehod od "direktiv v jeziku ljudi" k "direktivam v jeziku poslovanja". Če se najdejo razvijalci, ki jih bo ta dejstvo prizadelo, potem so verjetno žalostni že od trenutka, ko je svet ugledal JavaScript, v katerem so funkcije za razvrščanje nizov. Te funkcije imajo seveda v ozadju programsko implementacijo z drugimi sredstvi istega visoko nivojskega programiranja.
Tako je low-code le še en nivo abstrakcije.
Praktične izkušnje pri uporabi low-code
Tema low-code je dovolj široka, vendar bi zdaj rad govoril o praktični uporabi "malokodnih konceptov" na primeru enega naših projektov.
Pododdeljenje Big Data Solutions podjetja "Neoflex" se v večji meri specializira za finančni sektor poslovanja, gradi skladišča in jezera podatkov ter avtomatizira različna poročila. V tej niši je uporaba low-code že dolgo standard. Med drugimi orodji low-code lahko omenimo sredstva za organizacijo ETL-procesov: Informatica Power Center, IBM Datastage, Pentaho Data Integration. Ali pa Oracle Apex, ki deluje kot okolje za hitro razvoj vmesnikov za dostop in urejanje podatkov. Vendar uporaba malokodnih razvojnih orodij ni vedno povezana z gradnjo ozkopasovnih aplikacij na komercialni tehnološki sestavi z izrazito odvisnostjo od ponudnika.
S pomočjo platform low-code lahko tudi organiziramo orkestracijo tokov podatkov, ustvarimo podatkovno-znanstvene površine ali, na primer, module za preverjanje kakovosti podatkov.
Eden od praktičnih primerov izkušenj z uporabo malokodnih razvojnih orodij je sodelovanje "Neoflex" s podjetjem Mediascope, enim od vodilnih na ruskem trgu raziskav medijev. En od poslovnih ciljev tega podjetja je proizvodnja podatkov, na podlagi katerih oglaševalci, internetne platforme, televizijski kanali, radijske postaje, oglaševalske agencije in blagovne znamke sprejemajo odločitve o nakupu oglasov in načrtujejo svoje marketinške komunikacije.
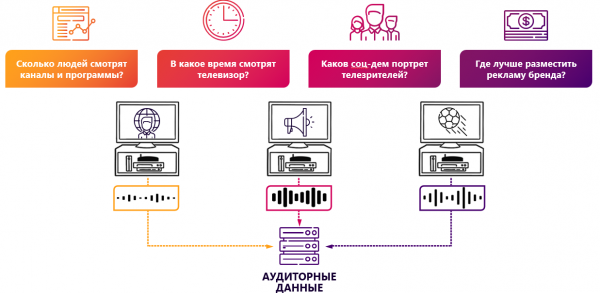
Medijske raziskave so tehnološko obremenjeno področje poslovanja. Prepoznavanje video posnetkov, zbiranje podatkov z naprav, ki analizirajo ogled, merjenje aktivnosti na spletnih virih – vse to zahteva, da ima podjetje veliko IT-vojaštvo in ogromno izkušenj pri gradnji analitičnih rešitev. Vendar pa eksponentna rast količine informacij, števila in raznolikosti njenega izvora nenehno prisili IT-industrijo podatkov k napredku. Najenostavnejša rešitev za razširitev že delujoče analitične platforme Mediascope bi lahko bila povečanje števila zaposlenih v IT. Ampak veliko bolj učinkovita rešitev je pospešitev procesa razvoja. Eden od korakov, ki vodijo v to smer, lahko predstavlja uporaba platform low-code.
При начале проекта у компании уже было действующее продуктовое решение. Однако реализация на MSSQL не могла полностью соответствовать ожиданиям по масштабируемости функционала при сохранении приемлемой стоимости доработки.
Перед нами стояла поистине амбициозная задача – компании «Неофлекс» и Mediascope необходимо было создать промышленное решение менее чем за год, с выходом MVP в течение первого квартала после начала работ.
В качестве основы для создания новой платформы данных, основанной на low-code-вычислениях, был выбран стек технологий Hadoop. Стандартом хранения данных стал HDFS с использованием формата файлов parquet. Для доступа к данным на платформе использовался Hive, где все доступные витрины представлены в виде внешних таблиц. Загрузка данных в хранилище осуществлялась с помощью Kafka и Apache NiFi.
Low-code-инструмент в данной концепции был применен для оптимизации самой трудоемкой задачи при построении аналитической платформы – задачи расчета данных.
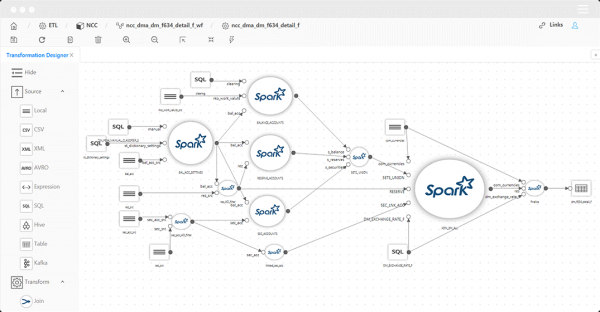
Основным механизмом для маппинга данных был выбран low-code-инструмент Datagram. Neoflex Datagram – это средство для разработки трансформаций и потоков данных.
Используя данный инструмент, можно обойтись без ручного написания кода на Scala. Код на Scala генерируется автоматически с использованием подхода Model Driven Architecture.
Очевидный плюс такого подхода – ускорение процесса разработки. Однако помимо скорости есть и другие достоинства:
- Просмотр содержимого и структуры источников/приемников;
- Отслеживание происхождения объектов потока данных до отдельных полей (lineage);
- Частичное выполнение преобразований с возможностью просмотра промежуточных результатов;
- Просмотр исходного кода и его корректировка перед выполнением;
- Автоматическая валидация трансформаций;
- Автоматическая загрузка данных 1 в 1.
Vstopna točka za low-code rešitve za generiranje transformacij je dovolj nizka: razvijalec mora poznati SQL in imeti izkušnje z ETL orodji. Pri tem je treba omeniti, da code-driven generatorji transformacij niso ETL orodja v širšem pomenu te besede. Low-code orodja morda nimajo lastnega okolja za izvajanje kode. To pomeni, da se generirana koda izvaja v okolju, ki je bilo na voljo v gruči že pred namestitvijo low-code rešitve. In to je verjetno še ena prednost za low-code. Kajti vzporedno z low-code ekipo lahko deluje 'klasična' ekipa, ki implementira funkcionalnost, na primer, v čistem Scala kodu. Začetek vseh izboljšav obeh ekip v produkcijo bo preprost in 'brezšiven'.
Morda je treba omeniti tudi, da poleg low-code obstajajo še no-code rešitve. In po svoji naravi so to različne stvari. Low-code v večji meri omogoča razvijalcu, da poseže v generirano kodo. V primeru Datagram je mogoče pregledovati in urejati generirano Scala kodo, no-code pa morda te možnosti ne ponuja. Ta razlika je precej pomembna ne le z vidika prilagodljivosti rešitve, temveč tudi z vidika udobja in motivacije pri delu podatkovnih inženirjev.
Arhitektura rešitve
Poglejmo, kako točno low-code orodje pomaga rešiti problem optimizacije hitrosti razvoja funkcionalnosti za izračun podatkov. Najprej analizirajmo funkcionalno arhitekturo sistema. V tem primeru je primer model proizvodnje podatkov za medijske raziskave.
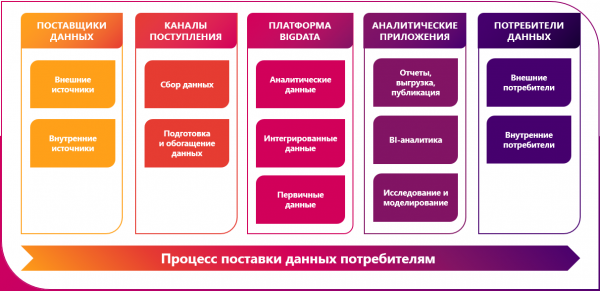
Viri podatkov v našem primeru so precej raznoliki in raznoliki:
- Peoplemeters (TV meters) are software-hardware devices that read user behavior from respondents of the television panel – who, when, and which TV channel was watched in the household participating in the study. The provided information is a stream of viewing intervals linked to the media package and media product. The data during the loading phase into the Data Lake can be enriched with demographic attributes, geographical ties, time zones, and other information necessary for analyzing the television viewing of a particular media product. The measurements taken can be used for analyzing or planning advertising campaigns, assessing activity and audience preferences, and creating broadcast schedules;
- Data can come from streaming television monitoring systems and measurement of content viewing on video resources on the Internet;
- Measuring tools in the web environment, including both site-centric and user-centric counters. The data supplier for the Data Lake can be a browser extension research bar and a mobile application with integrated functionality; VPN.
- Data can also come from platforms consolidating the results of online survey completions and outcomes from telephone interviews in the company's survey research;
- Additional enrichment of the data lake can occur through the uploading of information from the logs of partner companies.
The implementation of as-is loading from source systems into the primary staging of raw data can be organized in various ways. If low-code is used for these purposes, automatic generation of loading scripts can be possible based on metadata. In this case, there is no need to delve into the development of source to target mappings. To implement automatic loading, we need to establish a connection with the source, after which we define in the loading interface the list of entities to be loaded. The creation of directory structures in HDFS will occur automatically and will correspond to the data storage structure in the source system.
However, in the context of this project, we decided not to use this low-code platform capability because Mediascope has already independently started working on creating a similar service using the combination of Nifi + Kafka.
Takoj je treba poudariti, da ti instrumenti niso zamenljivi, temveč se medsebojno dopolnjujejo. Nifi in Kafka lahko delujeta tako v neposredni (Nifi -> Kafka) kot v obratni (Kafka -> Nifi) povezavi. Za platformo medijskih raziskav je bila uporabljena prva možnost povezave.
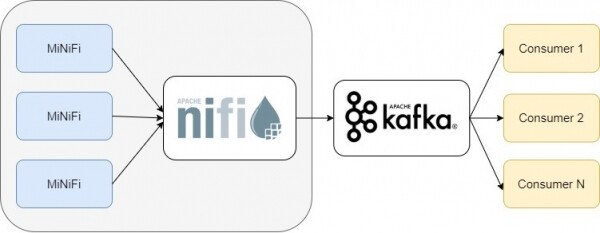
V našem primeru je Nifi potreboval obdelovati različne tipe podatkov iz sistemov virov in jih pošiljati posredniku Kafka. Pri tem je bilo usmerjanje sporočil v določen topic Kafka izvedeno z uporabo Nifi procesorjev PublishKafka. Orkestracija in upravljanje teh pipelines se izvajata v vizualnem vmesniku. Orodje Nifi in uporaba kombinacije Nifi + Kafka sta prav tako označena kot low-code pristop k razvoju, ki ima nizko vstopno oviro za tehnologije Big Data in pospešuje proces razvoja aplikacij.
Naslednji korak pri izvedbi projekta je bil poenotenje formata enotnega semantičnega sloja podrobnih podatkov. V primeru, da entiteta vsebuje zgodovinske atribute, se izračun izvede v kontekstu obravnavane particije. Če entiteta ni zgodovinska, je opcijsko mogoč bodisi ponovni izračun celotne vsebine objekta bodisi opustitev izračuna tega objekta (zaradi odsotnosti sprememb). V tej fazi se generirajo ključi za vse entitete. Ključi se shranijo v ustrezne matične objekte v referenčnih katalogih Hbase, ki vsebujejo ustreznost med ključem v analitični platformi in ključi iz sistemov virov. Konsolidacija atomskih entitet je povezana z obogatitvijo z rezultati predhodnega izračuna analitičnih podatkov. Ogrodje za izračun podatkov je bil Spark. Opisani funkcionalnosti poenotenja podatkov v enotno semantiko je bila prav tako uresničena na podlagi mapiranj low-code orodja Datagram.
V ciljni arhitekturi je bilo potrebno zagotoviti SQL dostop do podatkov za poslovne uporabnike. Za to možnost je bil uporabljen Hive. Registracija objektov v Hive se izvede samodejno, ko je omogočena možnost „Registr Hive Table“ v low-code orodju.
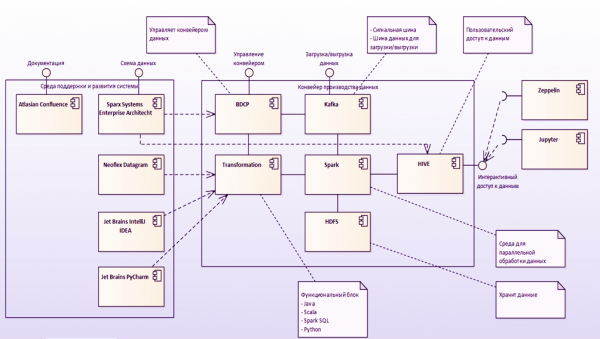
Upravljanje toka izračuna
Datagram ima sučelje za dizajn workflow tokova. Pokretanje mapiranja može se vršiti korišćenjem Oozie planera. U sučelju za razvoj tokova moguće je kreirati sheme paralelnih, sekvencijalnih ili zavisnih izvršavanja na osnovu postavljenih uslova za transformaciju podataka. Podrška je omogućen za shell skripte i java programe. Takođe je moguće korišćenje strežnika Apache Livy. Apache Livy se koristi za pokretanje aplikacija direktno iz developerskog okruženja.
U slučaju da kompanija već ima sopstveni orkestrator procesa, može se koristiti REST API za ugradnju mapiranja u već postojeći tok. Na primer, imali smo prilično uspešno iskustvo ugradnje mapiranja u Scala u orkestratore napisane na PLSQL i Kotlin. REST API low-code alata podrazumeva postojanje operacija kao što su generisanje izvršnog godišnjeg plana na osnovu dizajna mapiranja, pozivanje mapiranja, pozivanje sekvence mapiranja i, naravno, prosleđivanje parametara u URL za pokretanje mapiranja.
Pored Oozie, moguće je organizovati tok izračunavanja koristeći Airflow. Neću se previše zadržavati na poređenju Oozie i Airflow, samo ću reći da je u kontekstu rada na projektu medijskih istraživanja izbor pao na Airflow. Glavni argumenti ovog puta bili su aktivnija zajednica koja razvija proizvod i razvijenije sučelje + API.
Airflow je takođe dobar jer se za opisivanje procesa izračunavanja koristi Python, koji mnogi vole. Uostalom, platformi za upravljanje radnim tokovima otvorenog koda nema mnogo. Pokretanje i praćenje izvršenja procesa (uključujući Gantt dijagrame) dodatno poboljšava ugled Airflow-a.
Format konfiguracione datoteke za pokretanje mapiranja low-code rešenja postao je spark-submit. To se desilo iz dva razloga. Prvo, spark-submit omogućava direktno pokretanje jar datoteke iz konzole. Drugo, on može sadržavati sve potrebne informacije za konfiguraciju radnog toka (što olakšava pisanje skripti koje formiraju Dag).
Najčešće se susreće element radnog toka Airflow u našem slučaju postao je SparkSubmitOperator.
SparkSubmitOperator omogućava pokretanje jar file-ova — pakovanih mapiranja Datagram sa prethodno formiranim ulaznim parametrima.
Treba napomenuti da se svaka zadaća Airflow-a izvršava u odvojenom niti i ne zna ništa o drugim zadaćama. Zbog toga se interakcija između zadaća sprovodi pomoću kontrolnih operatora, kao što su DummyOperator ili BranchPythonOperator.
Kombinacija korišćenja low-code rešenja Datagram sa univerzalizacijom konfiguracionih fajlova (koji formiraju Dag) dovela je do značajnog ubrzanja i pojednostavljenja procesa razvoja tokova za preuzimanje podataka.
Izračun vitrina
Verovatno najinteligentnije opterećenje u proizvodnji analitičkih podataka jeste korak izgradnje vitrina. U kontekstu jednog od tokova izračunavanja podataka istraživačke kompanije, u ovoj fazi se vrši usklađivanje sa etalonnom transmisijom uzimajući u obzir korekcije vremenskih zona u vezi sa mrežom emitovanja. Takođe, moguća je korekcija na lokalnu emitersku mrežu (lokalne vesti i reklama). Pored ostalog, u ovom koraku se vrši razbijanje intervala neprekidnog gledanja medijskih proizvoda na osnovu analize intervala gledanja. Takođe se vrši 'ponderisanje' vrednosti gledanja na osnovu podataka o njihovoj važnosti (izračunavanje korekcijskog koeficijenta).
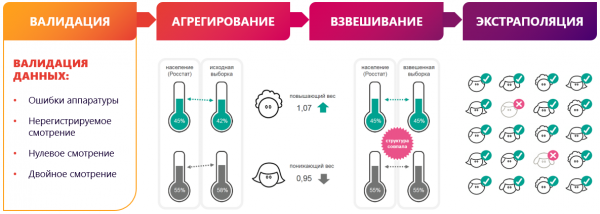
Posebna faza pripreme vitrina je validacija podataka. Algoritam validacije povezan je sa primenom niza matematičkih science-modela. Međutim, korišćenje low-code platforme omogućava razbijanje složenog algoritma u niz zasebnih vizuelno čitljivih mapiranja. Svako od mapiranja izvršava usku zadaću. Kao rezultat toga, moguće je međupredavanje, logovanje i vizualizacija koraka pripreme podataka.
Odlučeno je da se algoritam validacije diskretizuje u sledeće podkorake:
- Izgradnja regresija zavisnosti gledanja televizijske mreže u regionu u odnosu na gledanje svih mreža u regionu tokom poslednjih 60 dana.
- Izračunavanje stjudenitizovanih ostataka (odstupanja stvarnih vrednosti od predviđenih regresijskom modelu) za sve tačke regresije i za obračunski dan.
- Prikupljanje anomalnih parova region-televizijska mreža, gde stjudenitizovani ostatak obračunskog dana premašuje normu (utvrđenu podešavanjem operacije).
- Ponovno izračunavanje prilagođenog studentiziranog ostatka po anomalnim parovima regija-televizija za svakog ispitanika koji gleda mrežu u regiji, s definicijom doprinosa tog ispitanika (promjena studentiziranog ostatka) uz izuzimanje gledanja tog ispitanika iz uzorka.
- Pretraga kandidata čije isključenje dovodi studentizirani ostatak na normu u računski dan.
Gornji primer potvrđuje hipotezu da, kao što je slučaj s data-inžinjerima, postoji previše toga što treba imati na umu... I, ako je to zaista 'inženjer', a ne 'programer', strah od profesionalne degradacije pri korišćenju low-code alata bi definitivno trebao da nestane.
Šta još može low-code?
Područje primene low-code alata za paketnu i strimsku obradu podataka bez potrebe za ručnim pisanjem koda u Scal-i se ne završava.
Primena low-code u razvoju datalake-ova postala je neka vrsta standarda za nas. Možda se može reći da rešenja na Hadoop stack-u prate razvoj klasičnih DWH baziranih na RDBMS. Low-code alati na Hadoop stack-u mogu rešavati i zadatke obrade podataka i zadatke izgradnje krajnjih BI interfejsa. Treba napomenuti da pod BI može da se razume ne samo prikazivanje podataka, nego i njihovo uređivanje od strane poslovnih korisnika. Ova funkcionalnost se često koristi prilikom izrade analitičkih platformi za finansijski sektor.
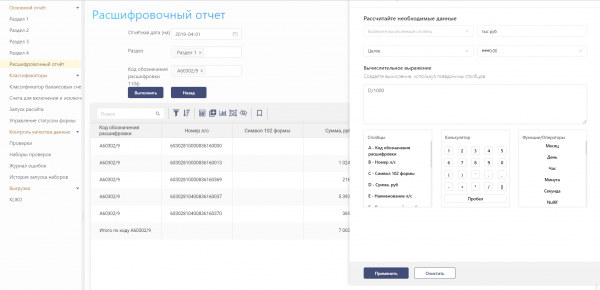
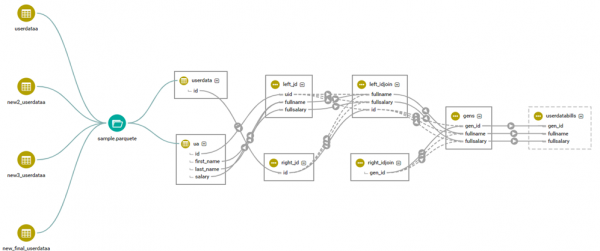
Med drugim, s pomočjo low-code ter zlasti Datagram lahko rešimo nalogo sledenja izvoru objektov podatkovnega toka z atomarnostjo do posameznih polj (lineage). V ta namen je v low-code orodju implementirano povezovanje z Apache Atlas in Cloudera Navigator. V bistvu mora razvijalec registrirati niz objektov v Atlas knjižnicah in se sklicevati na registrirane objekte pri gradnji map. Mehanizem sledenja izvoru podatkov ali analiza odvisnosti objektov prihrani veliko časa, ko je potrebno opraviti popravke v algoritmih izračuna. Na primer, pri sestavljanju finančnih poročil ta funkcionalnost omogoča lažje preživetje obdobij sprememb zakonodaje. Kakovostnejše, kot smo zavedeni medsebojnih odvisnosti z vidika objekta podrobnega sloja, manj verjetno bomo naleteli na 'nenadne' napake in zmanjšali število revorkov.
Kakovost podatkov in low-code
Še ena naloga, ki jo je realiziral low-code instrument v projektu podjetja Mediascope, je postala naloga razreda Kakovost podatkov. Značilnost izvajanja cevi za preverjanje podatkov za raziskovalno podjetje je bila, da ni vplivala na delovanje in hitrost osnovnega toka izračuna podatkov. Za orkestracijo neodvisnih tokov preverjanja podatkov je bil uporabljen že znani Apache Airflow. Ko je bil vsak korak proizvodnje podatkov pripravljen, se je hkrati začela izolirana komponenta DQ cevi.
Dobra praksa je nadziranje kakovosti podatkov od trenutka njihovega nastanka v analitični platformi. Imela informacije o metapodatkih, lahko že od trenutka, ko informacije pristanejo v prvotnem sloju, preverimo spoštovanje osnovnih pogojev — not null, omejitve, tuji ključi. Ta funkcionalnost je implementirana na podlagi samodejno ustvarjenih mapiranj družine kvalitete podatkov v Datagram. Kodegeneracija v tem primeru temelji tudi na metapodatkih modela. V projektu podjetja Mediascope je bila povezava izvedena z metapodatki produkta Enterprise Architect.
Zahvaljujoč povezavi low-code orodja in Enterprise Architect so bile samodejno ustvarjene naslednje preverjanja:
- Preverjanje prisotnosti vrednosti 'null' na poljih z modifierjem 'not null';
- Preverjanje prisotnosti podvajanja primarnega ključa;
- Preverjanje zunanjega ključa entitete;
- Preverjanje edinstvenosti vrstice po naboru polj.
Za bolj zapletene preverbe dostopnosti in zanesljivosti podatkov je bil ustvarjen mapping s Scala Expression, ki sprejme zunanje Spark SQL kode preverjanja, pripravljene s strani analitikov v Zeppelin.
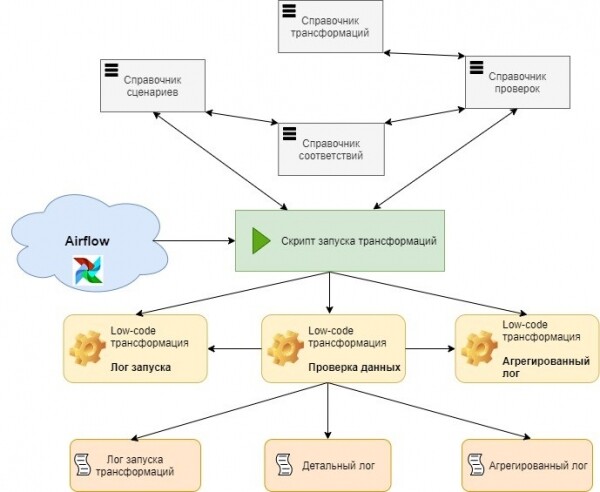
Seveda je treba postopoma pristopiti k avto-generaciji preverjanj. V okviru opisanega projekta so mu predhodili naslednji koraki:
- DQ, implementirani v beležnicah Zeppelin;
- DQ, vgrajeni v mapping;
- DQ v obliki ločenih masivnih mappingov, ki vsebujejo celotni sklop preverjanj za posamezno entiteto;
- Univerzalni parametrize DQ mappingi, ki sprejmejo informacije o metapodatkih in poslovnih preverjanjih.
Verjetno je glavna prednost ustvarjanja storitve parametriziranih preverjanj skrajšanje časa dostave funkcionalnosti v produkcijsko okolje. Nova preverjanja kakovosti lahko obidejo klasični vzorec dostave kode posredno skozi razvojna in testna okolja:
- Vsa preverjanja metapodatkov se avtomatsko generirajo ob spremembi modela v EA;
- Preverjanja dostopnosti podatkov (opredelitev prisotnosti kakršnih koli podatkov v določenem trenutku) se lahko generirajo na podlagi imenika, ki hrani pričakovani časovni okvir za pojav novega sklopa podatkov glede na objekte;
- Poslovne preverjanja zanesljivosti podatkov ustvarjajo analitiki v beležnicah Zeppelin. Kjer se neposredno pošljejo v konfiguracijske tabele modula DQ v produkcijskem okolju.
Tveganja neposredne dostave skriptov na produkcijo praktično ni. Tudi v primeru sintaktične napake je edina nevarnost, da se ne izvede eno samo preverjanje, saj sta tok izračuna podatkov in tok zagon preverjanj kakovosti ločena med seboj.
Dejansko je storitev DQ nenehno zagnana v produkcijskem okolju in pripravljena začeti svoje delo ob pojavu novega sklopa podatkov.
Namesto zaključka
Prednost uporabe low-code je očitna. Razvijalcem ni treba razvijati aplikacije "od začetka". Programer, osvobojen dodatnih nalog, prinaša rezultate hitreje. Hitrost, ki jo omogoča, sprošča dodatni čas za obravnavo vprašanj optimizacije. Zato lahko v tem primeru računamo na bolj kakovostno in hitro rešitev.
Seveda low-code ni zdravilo za vse in čarovnija se ne bo zgodila sama od sebe:
- Industrija low-code prehaja v fazo "okreplenja", in zaenkrat v njej ni enotnih industrijskih standardov;
- Mnoga low-code rešitev niso brezplačna, in njihova pridobitev mora biti premišljena, ki jo je treba sprejeti le ob popolni gotovosti o finančni koristi uporabe;
- Mnoge rešitve z malo kode ne vedno sodelujejo dobro z GIT / SVN. Ali pa so nepraktične pri skrivanju generirane kode;
- Pri širjenju arhitekture je lahko potrebno prilagoditi rešitev z malo kode – kar znova sproži učinek "priklenjenosti in odvisnosti" od ponudnika rešitve z malo kode.
- Pravi nivo zagotavljanja varnosti je mogoč, vendar je zelo delovno intenziven in zapleten za izvajanje motorjev sistemov z malo kode. Platforme z malo kode je treba izbirati ne le na podlagi iskanja koristi njihove uporabe. Pri izbiri se je smiselno vprašati o prisotnosti funkcionalnosti upravljanja dostopa in delegiranja/eskalacije identifikacijskih podatkov na ravni celotne IT pokrajine organizacije.
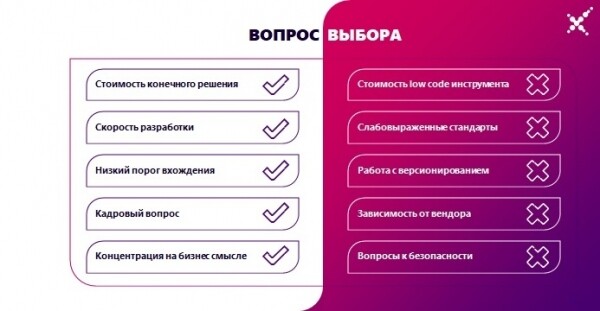
Vendar, če so vam vsi slabosti izbrane sistem znane in so koristi od njene uporabe kljub temu v prevladujočem številu, potem preidite na malo kode brez strahu. Še posebej, ker je prehod nanjo neizbežen – kot je neizbežna katera koli evolucija.
Če en programer na platformi low-code opravi svoje delo hitreje kot dva programerja brez low-code, to podjetju prinaša prednost na vseh področjih. Vstopna ovira za rešitve low-code je nižja kot pri "tradicionalnih" tehnologijah, kar pozitivno vpliva na vprašanje pomanjkanja kadrov. Uporaba orodij z nizko kodo omogoča hitrejšo interakcijo med funkcionalnimi ekipami in hitrejše sprejemanje odločitev o pravilnosti izbrane poti raziskovanja podatkov. Nizko-kodne platforme lahko postanejo vzrok digitalne transformacije organizacije, saj so rešitve, ki jih proizvedejo, dostopne za razumevanje netehničnim strokovnjakom (zo particulary poslovnim uporabnikom).
Če imate tesne roke, obremenjeno poslovno logiko, pomanjkanje tehnološke ekspertize in potrebujete pospešiti čas do trga, je low-code ena izmed možnosti, kako zadovoljiti svoje potrebe.
Ni mogoče zanikati pomena tradicionalnih razvojnih orodij, vendar je v mnogih primerih uporaba rešitev z nizko kodo najboljši način za povečanje učinkovitosti reševanja nalog.
Izvor: habr.com
