

Objavil sem na Githubu .
To je preprosta hramena tabela za GPU, ki lahko obdeluje na stotine milijonov vstavljanj na sekundo. Na mojem prenosniku z NVIDIA GTX 1060 koda vstavi 64 milijonov naključno generiranih parov ključ-vrednost približno v 210 ms in odstrani 32 milijonov parov približno v 64 ms.
Torej, hitrost na prenosniku znaša približno 300 milijonov vstavljanj/sek in 500 milijonov odstranitve/sek.
Tabela je napisana v CUDA, čeprav lahko isto metodologijo uporabimo za HLSL ali GLSL. Ima nekaj omejitev, ki zagotavljajo visoko zmogljivost na grafični kartici:
- Obdelujejo se le 32-bitni ključi in enake vrednosti.
- Hramena tabela ima fiksno velikost.
- In ta velikost mora biti moč dveh.
Za ključe in vrednosti je potrebno rezervirati preprost ločevalni znak (v priloženi kodi je to 0xffffffff).
Hramena tabela brez zaklepanja
V hrameni tabeli se uporablja odprta adresacija z , torej je to preprosto polje parov ključ-vrednost, shranjeno v pomnilniku, ki ima odlično zmogljivost predpomnilnika. To ne velja za veriženo vezavo (chaining), kar pomeni iskanje kazalca v povezani seznam. Hramena tabela je preprosto polje, ki hrani elemente KeyValue:
struct KeyValue
{
    uint32_t key;
    uint32_t value;
};
Velikost tabele je moč dveh, ne prvoštevilo, zato ker za uporabo pow2/AND-maske potrebujemo le eno hitro navodilo, medtem ko delovanje operatorja modulo deluje veliko počasneje. To je pomembno pri linearni iskanju, saj mora biti indeks reže pri linearni iskanju ovit v vsako reže. In posledično se doda strošek delovanja modulo v vsaki reži.
Tabela hrani le ključ in vrednost za vsak element, ne pa hasha ključa. Ker tabela hrani le 32-bitne ključe, se hash izračuna zelo hitro. V priloženi kodi se uporablja hash Murmur3, ki izvaja le nekaj premikov, XOR-ov in množenj.
V hashtable se uporablja zaščitna metodologija, ki ni odvisna od vrstnega reda shranjevanja v pomnilniku. Tudi če nekatere operacije zapisovanja prekinjajo vrstni red drugih tovrstnih operacij, bo hashtable še vedno ohranila pravilno stanje. O tem bomo govorili spodaj. Metodologija odlično deluje z grafičnimi karticami, na katerih hkrati deluje tisoče nitij.
Ključi in vrednosti v hashtable so inicializirani kot prazni.
Kodo je mogoče modificirati, da lahko obravnava tudi 64-bitne ključe in vrednosti. Za ključe so potrebne atomske operacije branja, pisanja in primerjave z izmenjavo (compare-and-swap). Za vrednosti so potrebne atomske operacije branja in pisanja. Na srečo v CUDA operacije branja in pisanja za 32- in 64-bitne vrednosti ostajajo atomske, tako dolgo kot so pravilno poravnane (glej. ), sodobne grafične kartice pa podpirajo 64-bitne atomske operacije primerjave z izmenjavo. Seveda pa se bo pri prehodu na 64 bitov nekoliko zmanjšala zmogljivost.
Stanje hashtable
Vsak par ključ-vrednost v hashtable lahko ima eno od štirih stanj:
- Ključ in vrednost sta prazna. V tem stanju je hashtable inicializirana.
- Ključ je bil zapisan, vrednost pa še ne. Če v tem trenutku drug izvajalni nit bere podatke, se vrne prazna vrednost. To je normalno, enako bi se zgodilo, če bi drugi izvajalni nit deloval malo prej, kar pomeni, da govorimo o konkurenčni strukturi podatkov.
- Zapisan je tako ključ kot vrednost.
- Vrednost je dostopna drugim izvajalnim nitim, ključa pa še ni. To se lahko zgodi, ker model programiranja v CUDA predvideva slabo urejen model pomnilnika. To je normalno, ob kakem dogodku je ključ še vedno prazen, četudi vrednost ni več.
Pomemben vidik je, da ko je ključ enkrat zapisan v mesto, se ne premakne več — tudi če je ključ izbrisan, o čemer bomo govorili spodaj.
Koda hashtable deluje tudi s slabše urejenimi modeli pomnilnika, v katerih vrstni red branj in zapisov v pomnilnik ni znan. Ko bomo obravnavali vstavljanje, iskanje in brisanje v hashtable, ne pozabite, da je vsaka pari ključ-vrednost v enem od štirih zgoraj opisanih stanj.
Vstavljanje v hashtable
CUDA funkcija, ki v hashtablo vstavi pare ključ-vrednost, izgleda takole:
void gpu_hashtable_insert(KeyValue* hashtable, uint32_t key, uint32_t value)
{
    uint32_t slot = hash(key);

    while (true)
    {
        uint32_t prev = atomicCAS(&hashtable[slot].key, kEmpty, key);
        if (prev == kEmpty || prev == key)
        {
            hashtable[slot].value = value;
            break;
        }
        slot = (slot + 1) & (kHashTableCapacity-1);
    }
}
Za vstavljanje ključa koda iterira po nizu hashtabele, začenši z hashom vstavljenega ključa. V vsakem režo niza se izvede atomska operacija primerjave in menjave, pri kateri se ključ v tem režo primerja s praznim. Če se odkrije neujemanje, se ključ v režo posodobi z vstavljanjem ključa in nato vrne izvorni ključ režo. Če je bil ta izvorni ključ prazen ali je ustrezal vstavljanemu ključno, je koda našla ustrezen režo za vstavljanje in vnese v režo vstavljeno vrednost.
Če v enem klicu jedra gpu_hashtable_insert() obstaja več elementov z enakim ključem, lahko je katera koli njihova vrednost zapisana v režo ključa. To velja za normalno: ena od operacij zapisa ključ-vrednost med klicem bo uspešna, toda ker vse to poteka vzporedno v okviru več izvajalnih niti, ne moremo napovedati, katera operacija zapisa v pomnilnik bo zadnja.
Iskanje v hashtabli
Koda za iskanje ključev:
uint32_t gpu_hashtable_lookup(KeyValue* hashtable, uint32_t key)
{
        uint32_t slot = hash(key);

        while (true)
        {
            if (hashtable[slot].key == key)
            {
                return hashtable[slot].value;
            }
            if (hashtable[slot].key == kEmpty)
            {
                return kEmpty;
            }
            slot = (slot + 1) & (kHashTableCapacity - 1);
        }
}
Da bi našli vrednost ključa, shranjene v tabeli, iteriramo po nizu, začenši z hashom iskanega ključa. V vsakem režo preverimo, ali je ključ tisti, ki ga iščemo, in če je, vrnemo njegovo vrednost. Prav tako preverimo, ali je ključ prazen, in če je, prekinemo iskanje.
Če nam ne uspe najti ključa, koda vrne prazno vrednost.
Vse te operacije iskanja se lahko izvajajo hkrati med vstavljanjem in brisanjem. Vsak par v tabeli bo imel za nit eno od štirih zgoraj opisanih stanj.
Brisanje v hashtabli
Koda za brisanje ključev:
void gpu_hashtable_delete(KeyValue* hashtable, uint32_t key, uint32_t value)
{
    uint32_t slot = hash(key);

    while (true)
    {
        if (hashtable[slot].key == key)
        {
            hashtable[slot].value = kEmpty;
            return;
        }
        if (hashtable[slot].key == kEmpty)
        {
            return;
        }
        slot = (slot + 1) & (kHashTableCapacity - 1);
    }
}
Удалjanje ključa vrši se na neobičan način: ostavljamo ključ u tabeli i označavamo njegovu vrednost (a ne sam ključ) kao praznu. Ovaj kod je veoma sličan lookup(), osim što, kada otkrijemo podudaranje po ključu, čini njegovu vrednost praznom.
Kao što je ranije pomenuto, čim je ključ upisan u slot, više se ne pomera. Čak i kada se element ukloni iz tabele, ključ ostaje na mestu, samo postaje njegova vrednost prazna. To znači da ne moramo koristiti atomsku operaciju pisanja vrednosti slota, jer nije važno da li je trenutna vrednost prazna ili ne — svakako postaje prazna.
Promena veličine heš-tabele
Veličinu heš-tabele možemo promeniti kreiranjem veće tabele i ubacivanjem nepraznih elemenata iz stare tabele. Ovu funkcionalnost nisam implementirao, jer sam želeo da zadržim kod jednostavnim. Štaviše, u CUDA programima, alokacija memorije često se vrši u host kodu, a ne u CUDA jezgri.
V članku opisuje kako menjati takvu strukturudata, zaštićenu od blokada.
Konkurentnost
U gorenavedenim fragmentima koda funkcije gpu_hashtable_insert(), _lookup() in _delete() obrađuju po jedan par ključ-vrednost u isto vreme. A ispod gpu_hashtable_insert(), _lookup() in _delete() obrađuju niz parova paralelno, svaki par u zasebnom GPU thread-u izvršenja:
// CPU code to invoke the CUDA kernel on the GPU
uint32_t threadblocksize = 1024;
uint32_t gridsize = (numkvs + threadblocksize - 1) / threadblocksize;
gpu_hashtable_insert_kernel<<<gridsize, threadblocksize>>>(hashtable, kvs, numkvs);

// GPU code to process numkvs key/values in parallel
void gpu_hashtable_insert_kernel(KeyValue* hashtable, const KeyValue* kvs, unsigned int numkvs)
{
    unsigned int threadid = blockIdx.x*blockDim.x + threadIdx.x;
    if (threadid < numkvs)
    {
        gpu_hashtable_insert(hashtable, kvs[threadid].key, kvs[threadid].value);
    }
}
Heš-tabela s zaštitom od blokada podržava konkurentne umetke, pretrage i brisanja. Budući da su parovi ključ-vrednost uvek u jednom od četiri stanja, a ključevi se ne pomeraju, tabela osigurava tačnost čak i kada se istovremeno koriste različite vrste operacija.
Međutim, ako paralelno obrađujemo paket umetanja i brisanja, i ako ulazni niz parova sadrži duplicirane ključeve, nećemo moći predvideti koji parovi "pobeđuju" — biće zapisani u heš-tabelu poslednji. Pretpostavimo da smo pozvali kod umetanja sa ulaznim nizom parova A/0 B/1 A/2 C/3 A/4. Kada se kod završi, parovi B/1 in C/3 garantovano će biti prisutni u tabeli, ali će takođe u njoj biti bilo koji od parova A/0, A/2 ili A/4To je lahko težava, morda pa tudi ne — vse je odvisno od uporabe. Lahko vnaprej veste, da v vhodnem polju ni podvojenih ključev, ali pa vam morda ni pomembno, katera vrednost je bila zabeležena zadnja.
Če je to za vas težava, potem morate razdeliti podvojene pare v različne sistemske CUDA-klice. V CUDA vsaka operacija z izvajanjem jeder vedno konča pred naslednjim klicem jedra (vsaj znotraj enega niza. V različnih nizih se jedra izvajajo hkrati). Če v zgoraj navedenem primeru pokličete eno jedro z A/0 B/1 A/2 C/3, drugo pa z A/4, potem bo ključ A prejel vrednost 4.
Zdaj se pogovorimo, ali bi funkcije lookup() in delete() morale uporabljati preprost (plain) ali spremenljiv (volatile) kazalec na polje parov v hash tabeli. trdi, da:
Kompilator lahko po svoji presoji optimizira operacije branja in pisanja v globalno ali skupno pomnilnik … Te optimizacije je mogoče onemogočiti s pomočjo ključne besede
volatile: … vsaka sklica na to spremenljivko se prevaja v pravo navodilo za branje ali pisanje v pomnilnik.
Pomisleki o pravilnosti ne zahtevajo uporabe volatile. Če tok izvajanja uporablja predpomnjeno vrednost iz prejšnje operacije branja, to pomeni, da bo uporabljal nekoliko zastarele informacije. A vseeno so to informacije iz veljavnega stanja hash tabele v določenem trenutku klica jedra. Če potrebujete najnovejše informacije, lahko uporabite kazalec volatile, vendar bo takrat malce zmanjšana zmogljivost: po mojih testih se je pri brisanju 32 milijonov elementov hitrost zmanjšala z 500 milijonov brisanj/sec na 450 milijonov brisanj/sec.
Performansa
V testu vstavljanja 64 milijonov elementov in brisanja 32 milijonov od njih je konkurenca med std::unordered_map in hash tabelo za GPU dejansko ni prisotna:
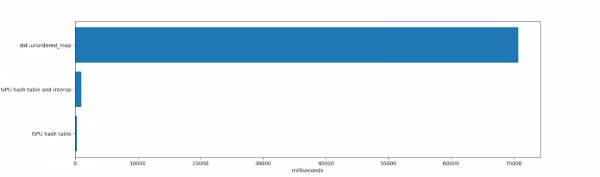
std::unordered_map porabila 70.691 ms za vstavljanje in brisanje elementov z nadaljnjim sproščanjem unordered_map (sproščanje milijonov elementov traja kar nekaj časa, ker potekajo številna dodeljevanja pomnilnika). Iskreno, pri unordered_map std:unordered_map std:unordered_map popolnoma druge omejitve. To je enotni CPU-nit za izvajanje, ki podpira vrednostne pare katerekoli velikosti, dobro deluje pri visokih stopnjah uporabe in prikazuje stabilno zmogljivost po številnih brisanjih.
Čas delovanja razpršene tabele za GPU in medprogramsko komunikacijo je znašal 984 ms. To vključuje čas, potreben za postavitev tabele v spomin in njeno brisanje (enkratno dodeljevanje 1 GB spomina, kar v CUDA traja nekaj časa), vstavljanje in brisanje elementov ter iteriranje preko njih. Upoštevana so tudi vsa kopiranja v spomin in iz spomina grafične kartice.
Delovanje same razpršene tabele je trajalo 271 ms. To vključuje čas, ki ga grafična kartica porabi za vstavljanje in brisanje elementov, in ne upošteva časa za kopiranje v spomin in iteriranje po ustvarjeni tabeli. Če razpršena tabela GPU obstaja dolgo, ali če je razpršena tabela popolnoma v spominu grafične kartice (na primer za ustvarjanje razpršene tabele, ki jo bo uporabljala druga GPU-koda in ne centralni procesor), so rezultati testiranja relevantni.
Razpršena tabela za grafično kartico prikazuje visoko zmogljivost zahvaljujoč veliki prepustnosti in aktivnemu razporejanju nalog.
Slabosti
Arhitektura razpršene tabele ima več težav, ki jih je treba upoštevati:
- Linearno sondiranje ovirajo grozdenja, zaradi katerih se ključi v tabeli ne postavljajo idealno.
- Ključi se ne brišejo s funkcijo
izbrišiin sčasoma blokirajo tabelo.
Zaradi tega se lahko zmogljivost razpršene tabele postopoma zmanjšuje, zlasti če obstaja dlje časa in se v njej izvaja veliko vstavljanj in brisanj. Eden od načinov za omilitev teh pomanjkljivosti je prehashiranje v novo tabelo z dovolj nizko stopnjo uporabe in filtriranje izbrisanih ključev med prehashiranjem.
Da bi ponazoril opisane težave, uporabljam zgoraj navedeno kodo za ustvarjanje tabele z 128 milijoni elementov, ciklično bom vnašal 4 milijone elementov, dokler ne zapolnim 124 milijonov mest (stopnja uporabe približno 0,96). Tukaj so rezultati, vsak vrstica je klic CUDA jedra z vstavljanjem 4 milijonov novih elementov v eno razpršeno tabelo:
Stopnja uporabe
Trajanje umetanja 4 194 304 elemenata
0,00
11,608448 ms (361,314798 miliona ključeva/sek.)
0,03
11,751424 ms (356,918799 miliona ključeva/sek.)
0,06
11,942592 ms (351,205515 miliona ključeva/sek.)
0,09
12,081120 ms (347,178429 miliona ključeva/sek.)
0,12
12,242560 ms (342,600233 miliona ključeva/sek.)
0,16
12,396448 ms (338,347235 miliona ključeva/sek.)
0,19
12,533024 ms (334,660176 miliona ključeva/sek.)
0,22
12,703328 ms (330,173626 miliona ključeva/sek.)
0,25
12,884512 ms (325,530693 miliona ključeva/sek.)
0,28
13,033472 ms (321,810182 miliona ključeva/sek.)
0,31
13,239296 ms (316,807174 miliona ključeva/sek.)
0,34
13,392448 ms (313,184256 miliona ključeva/sek.)
0,37
13,624000 ms (307,861434 miliona ključeva/sek.)
0,41
13,875520 ms (302,280855 miliona ključeva/sek.)
0,44
14,126528 ms (296,909756 miliona ključeva/sek.)
0,47
14,399328 ms (291,284699 miliona ključeva/sek.)
0,50
14,690304 ms (285,515123 miliona ključeva/sek.)
0,53
15,039136 ms (278,892623 miliona ključeva/sek.)
0,56
15,478656 ms (270,973402 miliona ključeva/sek.)
0,59
15,985664 ms (262,379092 miliona ključeva/sek.)
0,62
16,668673 ms (251,627968 miliona ključeva/sek.)
0,66
17,587200 ms (238,486174 miliona ključeva/sek.)
0,69
18,690048 ms (224,413765 miliona ključeva/sek.)
0,72
20,278816 ms (206,831789 miliona ključeva/sek.)
0,75
22,545408 ms (186,038058 miliona ključeva/sek.)
0,78
26,053312 ms (160,989275 miliona ključeva/sek.)
0,81
31,895008 ms (131,503463 miliona ključeva/sek.)
0,84
42,103294 ms (99,619378 miliona ključeva/sek.)
0,87
61,849056 ms (67,815164 miliona ključeva/sek.)
0,90
105,695999 ms (39,682713 miliona ključeva/sek.)
0,94
240,204636 ms (17,461378 miliona ključeva/sek.)
Kako raste koeficijent iskorišćenosti, performanse padaju. To je nepoželjno u većini slučajeva. Ako aplikacija umetne elemente u tabelu, a zatim ih odbacuje (na primer, prilikom prebrojavanja reči u knjizi), to nije problem. Međutim, ako aplikacija koristi dugotrajnu hesh-tabelu (na primer, u grafičkom editoru za skladištenje nepraznih delova slika, kada korisnik često umetne i ukloni informacije), ovo ponašanje može biti neprijatno.
Izmerio sam dubinu sondiranja hesh-tabele nakon 64 miliona umetanja (koeficijent iskorišćenosti 0,5). Prosečna dubina je bila 0,4774, tako da su se većina ključeva nalazila ili u najboljem mogućem mestu, ili u jednom mestu od najboljeg.
Zatim sam izmerio dubinu sondiranja u tabeli sa 124 miliona umetanja (koeficijent iskorišćenosti 0,97). Prosečna dubina bila je već 10,1757, a maksimalna — 6474 (!!). Performanse linearne sondiranja naglo opadaju pri visokim koeficijentima iskorišćenosti.
Najbolje je imati nisku potrošnju ove hash-tablice. No, tada povećavamo performanse na račun potrošnje memorije. Srećom, u slučaju 32-bitnih ključeva i vrednosti, to može biti opravdano. Ako u gornjem primeru održimo potrošnju od 0,25 u tabeli sa 128 miliona elemenata, moći ćemo smestiti najviše 32 miliona elemenata, a preostalih 96 miliona slotova će biti izgubljeno — po 8 bajtova po svakom paru, 768 MB izgubljene memorije.
Imajte na umu da se radi o gubitku memorije grafičke kartice, koja je vredniji resurs od sistemske memorije. Iako većina modernih desktop grafičkih kartica koje podržavaju CUDA ima najmanje 4 GB memorije (u trenutku pisanja, NVIDIA 2080 Ti ima 11 GB), gubiti toliko memorije neće biti najsmislenije rešenje.
Kasnije ću detaljnije pisati o stvaranju hash-tablica za grafičke kartice koje nemaju problema sa dubinom pretraživanja, kao i o metodama ponovnog korišćenja obrisanih slotova.
Merenje dubine pretraživanja
Da bismo odredili dubinu pretraživanja ključa, možemo izvući hash ključa (njegov idealan indeks u tabeli) iz njegovog stvarnog tabličnog indeksa:
// get_key_index() -> index of key in hash table
uint32_t probelength = (get_key_index(key) - hash(key)) & (hashtablecapacity-1);
Zbog magije dva binarna broja u dodatnom kodu i činjenice da je kapacitet hash-tabele jednak dvojci na potpunu snagu, ovaj pristup će raditi čak i kada se indeks ključa prenese na početak tabele. Uzmimo ključ koji se hashira u 1, ali je umetnut u slot 3. Tada za tabelu sa kapacitetom 4 dobijamo (3 — 1) & 3, što je ekvivalentno 2.
Zaključek
Ako imate pitanja ili komentare, javite mi na ili otvorite novu temu u.
Ovaj kod je napisan pod inspiracijom divnih članaka:
U budućnosti ću nastaviti pisati o implementacijama hash-tablica za grafičke kartice i analizirati njihove performanse. Planiram povezivanje u lance, Robin Hood heširanje i kučkino heširanje koristeći atomske operacije u strukturama podataka pogodnim za grafičke kartice.
Izvor: habr.com
