

Predstavljamo vam tretji del prevoda gradiva o poti, ki jo je prešla družba Dropbox pri uvajanju sistema preverjanja tipov Python kode.
→ Prejšnji deli: in
Dosego 4 milijonov vrstic tipizirane kode
Še en pomemben cilj (to je bil drugi najbolj priljubljen problem, ki je skrbelo tiste, ki so sodelovali v notranjih anketah) je bil povečati obseg kode v Dropboxu, pokritega s preverjanjem tipov. Preizkusili smo več pristopov za rešitev tega izziva — od naravnega povečanja obsega tipizirane kode do osredotočanja naporov članov ekipe mypy na statično in dinamično avtomatizirano sklepanje tipov. Na koncu se je zdelo, da ne obstaja enostavna zmagovalna strategija, vendar smo uspeli doseči hitro rast obsega Annotirane kode, ki smo jo kombinirali z več pristopi.
Zaradi tega je v našem največjem Python repozitoriju (z backend kodo) število vrstic annotirane kode doseglo skoraj 4 milijone. Delo na statični tipizaciji kode je trajalo približno tri leta. Mypy zdaj podpira različne vrste poročil o pokritosti kode s tipi, kar poenostavi spremljanje napredka tipizacije. Še posebej lahko sestavimo poročila za kodo s negotovostmi v tipih, kot so, na primer, eksplicitna uporaba tipov Any v oznakah, ki jih ni mogoče preveriti, ali s tistimi, kot so uvozi zunanjih knjižnic, ki nimajo oznak tipov. V okviru projekta za izboljšanje natančnosti preverjanja tipov v Dropboxu smo prispevali k izboljšanju definicij tipov (t. i. stub datotek) za nekatere priljubljene odprtokodne knjižnice v centraliziranem Python repozitoriju .
Implementirali smo (in standardizirali v naslednjih PEP) nove možnosti sistema tipov, ki omogočajo uporabo natančnejših tipov za nekatere specifične Python vzorce. Opazen primer tega je TypeDict, ki nudi tipe za JSON podobne slovarje, ki imajo fiksno skupino nizov ključev, kjer ima vsak ključ svojo vrsto. Nadaljevali bomo z razširjanjem sistema tipov. Verjetno bomo naslednji korak izboljšali podporo Pythonovim zmogljivostim pri delu s številkami.
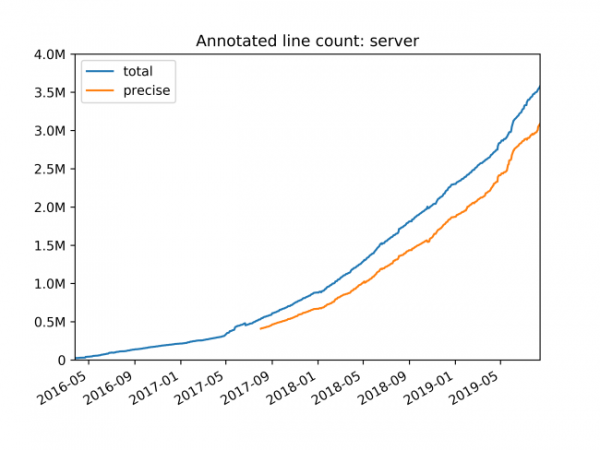
Število vrstic anotiranega kode: strežnik
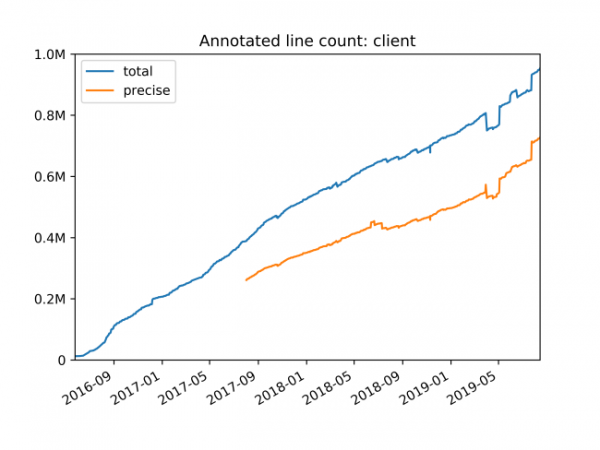
Število vrstic anotiranega kode: odjemalec
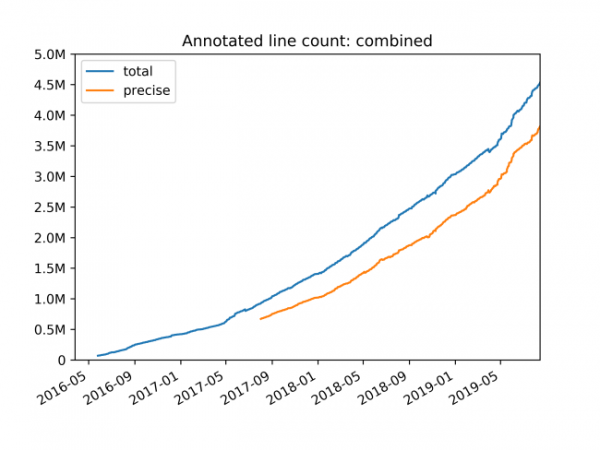
Skupno število vrstic anotiranega kode
Tukaj je pregled glavnih značilnosti ukrepov, ki smo jih sprejeli za povečanje števila anotirane kode v Dropboxu:
Strogost anotiranja. Postopoma smo povečali zahtevnost glede strogosti anotiranja nove kode. Začeli smo s priporočili lintra, ki so predlagala dodajanje anotacij v datoteke, v katerih so že prisotne nekatere anotacije. Zdaj zahtevamo prisotnost tipnih anotacij v novih Python datotekah in v večini obstoječih datotek.
Poročila o tipizaciji. Tedensko pošiljamo ekipam poročila o ravni tipizacije njihove kode in dajemo nasvete, kaj bi bilo smiselno anektirati najprej.
Popularizacija mypy. O mypy-ju govorimo na različnih dogodkih in se pogovarjamo z ekipami, ter jim pomagamo začeti uporabljati tipne anotacije.
Ankete. Redno izvajamo ankete med uporabniki, da bi ugotovili glavne težave. Pripravljeni smo iti dovolj daleč, da rešimo te težave (tudi do ustanovitve novega jezika, da bi pospešili mypy!).
Učinkovitost. Z znatnim izboljšanjem učinkovitosti mypy smo uporabili demone in mypyc. To smo storili, da bi omilili nevšečnosti, ki nastanejo pri anotiranju, in omogočili delo z večjimi količinami kode.
Integracija z uredniki. Ustvarili smo orodja za podporo zagonu mypy v priljubljenih urejevalnikih v Dropboxu. Sem spadajo PyCharm, Vim in VS Code. To je močno poenostavilo postopek opravila anotiranja kode in preverjanja njene delovanja. Takšne akcije so običajne pri anotiranju obstoječe kode.
Statistična analiza. Ustvarili smo orodje za izhod funkcijskih podpisov z uporabo statične analize. To orodje lahko deluje le v razmeroma preprostih situacijah, vendar nam je pomagalo brez večjih težav povečati pokritost kode s tipi.
Podpora zunanjih knjižnic. V mnogih naših projektih uporabljamo nabor orodij SQLAlchemy. V njem se uporabljajo dinamične funkcionalnosti Pythona, ki jih tipi PEP 484 ne morejo neposredno modelirati. V skladu s PEP 561 smo ustvarili ustrezen stub-dokument in napisali vtičnik za mypy (), ki izboljšuje podporo za SQLAlchemy.
Težave, s katerimi smo se srečali
Pot do 4 milijonov vrstic tipizirane kode ni bila vedno enostavna. Na tej poti smo naleteli na številne ovire in naredili nekaj napak. To so nekatere težave, s katerimi smo se srečali. Upamo, da bo pripoved o njih pomagala drugim, da se izognejo podobnim težavam.
Izpuščeni datoteke. Začeli smo z raznovrstnim pregledom le majhnega števila datotek. Vse, kar ni bilo vključeno v to število datotek, ni bilo pregledovano. Datoteke so bile dodane v pregled, ko so se v njih pojavile prve anotacije. Če je bila kaj uvoženo iz modula, ki je bil zunaj območja pregleda, je šlo za delo z vrednostmi tipa Any, ki niso bile sploh preverjene. To je povzročilo znatno izgubo natančnosti tipizacije, zlasti v zgodnjih fazah migracije. Tak pristop je še vedno deloval presenetljivo dobro, čeprav je bila znana situacija, ko je dodajanje datotek v območje pregleda razkrilo težave v drugih delih kode. V najhujšem primeru, ko sta se združili dve izolirani področji kode, pri katerih so bili tipi neodvisno preverjeni, se je izkazalo, da tipi teh področij niso združljivi. To je pomenilo potrebo po spremembah v veliko anotacijah. Zdaj, ko se ozremo nazaj, razumemo, da bi bilo bolje, da bi čim prej dodali osnovne knjižnične module v območje tipizacije mypy. To bi naše delo naredilo veliko bolj predvidljivo.
Annotacija starega kode. Ko smo začeli delo, smo imeli približno 4 milijone vrstic obstoječe kode v Pythonu. Bilo je jasno, da je annotiranje vse te kode zahtevna naloga. Ustvarili smo orodje, imenovano PyAnnotate, ki lahko zbira informacije o tipih med izvajanjem testov in dodaja annotacije tipov v kodo, temelječe na zbranih informacijah. Vendar pa posebnega širšega uvajanja tega orodja nismo opazili. Zbiranje informacij o tipih je bilo počasno, samodejno generirane annotacije so pogosto zahtevale številne ročne popravke. Razmišljali smo o samodejnem zagonu tega orodja pri vsakem pregledu kode ali o zbiranju informacij o tipih na podlagi analize majhnega števila dejanskih omrežnih zahtevkov, vendar smo se odločili, da tega ne storimo, saj je bilo kateri od teh pristopov preveč tvegano.
Na koncu lahko ugotovimo, da je večina kode ročno annotirana s strani njenih lastnikov. Da bi usmerili ta postopek v pravo smer, pripravljamo poročila o zlasti pomembnih modulih in funkcijah, ki jih je treba annotirati. Na primer, pomembno je, da knjižnični modul, ki se uporablja v stotinah mest, opremimo z annotacijami tipov. Stara storitev, ki jo nadomešča nova, pa ni več tako pomembno annotirati. Poleg tega eksperimentiramo z uporabo statične analize za ustvarjanje annotacij tipov za staro kodo.
Ciklični uvozi. Prethodno sam spomenuo ciklične uvoze (o "klupčima zavisnosti"), čije postojanje otežava ubrzanje mypy-a. Takođe, morali smo ozbiljno raditi na tome da mypy podrži sve vrste idioma, čiji uzrok su ovi ciklični uvozi. Nedavno smo završili veliki projekat redizajna sistema, koji je ispravio većinu problema mypy-a vezanih za ciklične uvoze. Ovi problemi su, zapravo, potekli iz vrlo ranih dana projekta, još iz Alorea, nastavnog jezika na koji je projekat mypy prvobitno bio orijentisan. Sintaksa Alorea olakšava rešavanje problema cikličnih import komandi. Savremeni mypy je nasledio neka ograničenja iz svoje rane jednostavne implementacije (koja je bila odlična za Alore). Python otežava rad sa cikličnim uvozima uglavnom zbog nejasnoća izraza. Na primer, tokom operacije dodele vrednosti može se zapravo definisati alias tipa. Mypy ne može uvek da identifikuje slične stvari dok veći deo ciklusa uvoza ne bude obrađen. U Alore nije bilo takvih nejasnoća. Neuspešna rešenja doneta u ranim fazama razvoja sistema mogu doneti programeru neprijatno iznenađenje nakon mnogo godina.
Rezultati: put do 5 miliona linija koda i novim horizontima
Projekat mypy je prošao dug put — od ranih prototipova do sistema koji kontroliše tipove proizvodnog koda obima od 4 miliona linija. Tokom razvoja mypy-a standardizovani su saveti o tipovima u Pythonu. Danas se oko tipizacije Python koda razvila moćna ekosistem. Tu su podrške za biblioteke, alati za IDE i uređivače, i nekoliko sistema za kontrolu tipova, od kojih svaki ima svoje prednosti i mane.
Iako se provera tipova već smatra nečim što je u Dropbox-u opšteprihvaćeno, siguran sam da još uvek živimo u zoru tipizacije Python koda. Mislim da će tehnologije za proveru tipova nastaviti da se razvijaju i usavršavaju.
Če še niste uporabljali preverjanja tipov v svojem velikem Python projektu, vedite, da je zdaj zelo primeren čas, da začnete prehod na statično tipizacijo. Pogovarjal sem se z nekaterimi, ki so izvedli tak prehod. Nihče od njih ni obžaloval. Nadzor tipov pretvori Python v jezik, ki je veliko bolj primeren za razvoj velikih projektov kot "navadni Python".
Spoštovani bralci! Ali uporabljate nadzor tipov v svojih Python projektih?
Izvor: habr.com
