

Package tidyr je del del jedne iz najbolj priljubljenih knjižnic v jeziku R - tidyverse.
Glavna funkcija paketa je ureditev podatkov v pregleden format.
Na Habrju je že posvečena temu paketu, vendar je datirana iz leta 2015. Rad bi povedal o najnovejših spremembah, o katerih je pred nekaj dnevi obvestil njegov avtor Hadley Wickham.
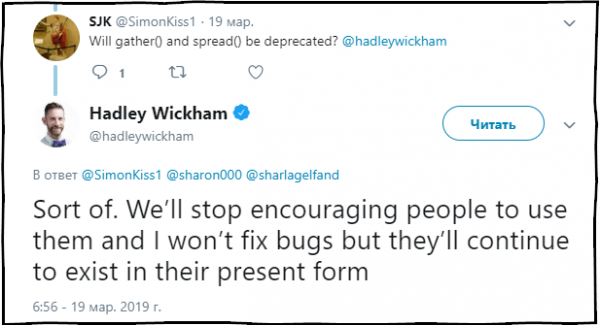
SJK: Bodo funkcije gather() in spread() zastarele?
Hadley Wickham: Do neke mere. Priporočal bomo prenehanje uporabe teh funkcij in odpravljanja napak v njih, vendar bodo še naprej prisotne v paketu v trenutnem stanju.
Vsebina
Če vas zanima analiza podatkov, vas morda zanimajo moji in kanali. Večina vsebine se posveča jeziku R.
Koncept TidyData
Cilj tidyr — vam pomaga urediti podatke v tako imenovani pregleden format. Pregledni podatki so podatki, kjer:
- Vsaka spremenljivka se nahaja v stolpcu.
- Vsako opazovanje je vrstica.
- Vsaka vrednost je celica.
S podatki, ki so urejeni v tidy data, je analiziranje precej enostavnejše in bolj priročno.
Glavne funkcije, vključene v paket tidyr
tidyr vsebuje nabor funkcij, namenjenih transformaciji tabel:
fill()— zapolnitev manjkajočih vrednosti v stolpcu s prejšnjimi vrednostmi;separate()— razdeli eno polje na več prek ločila;unite()— izvaja operacijo združevanja več polj v eno, nasprotnemu funkcijiseparate();pivot_longer()— funkcija, ki pretvarja podatke iz širokega formata v dolg;pivot_wider()— funkcija, ki pretvarja podatke iz dolgega formata v širokega. Operacija je nasprotna tisti, ki jo izvaja funkcijapivot_longer().gather()zastarela — funkcija, ki pretvarja podatke iz širokega formata v dolg;spread()zastarela — funkcija, ki pretvarja podatke iz dolgega formata v širokega. Operacija je nasprotna tisti, ki jo izvaja funkcijagather().
Nova koncept prenosa podatkov iz širokega v dolg format in obratno
V preteklosti so se za takšne transformacije uporabljale funkcije gather() in spread(). Skozi leta uporabe teh funkcij je postalo očitno, da so imena teh funkcij in njihovih argumentov večini uporabnikov, vključno z avtorjem paketa, predstavljala velik izziv, saj so bila precej nejasna in so povzročala težave pri iskanju in razumevanju, katera od teh funkcij pretvarja podatkovni okvir iz široke v dolgo obliko in obratno.
Zato so tidyr dodatne nove, pomembne funkcije, ki so namenjene za transformacijo podatkovnih okvirov.
Nove funkcije pivot_longer() in pivot_wider() so bile ustvarjene pod vplivom nekaterih funkcij iz paketa cdata, ki sta ga ustvarila John Mount in Nina Zumel.
Namestitev najnovejše različice tidyr 0.8.3.9000
Za namestitev nove, najbolj posodobljene različice paketa tidyr 0.8.3.9000, v kateri so na voljo nove funkcije, uporabite naslednjo kodo.
devtools::install_github("tidyverse/tidyr")
Ob pisanju te vsebine so bile te funkcije na voljo samo v dev različici paketa na GitHubu.
Prehod na nove funkcije
Dejansko ni težko pretvoriti stare skripte za delo z novimi funkcijami, za boljše razumevanje pa bom vzel primer iz dokumentacije starih funkcij in pokazal, kako te iste operacije izvajamo s pomočjo novih pivot_*() funkcij.
Pretvorba široke oblike v dolgo.
Primer kode iz dokumentacije funkcije gather
# example
library(dplyr)
stocks <- data.frame(
  time = as.Date('2009-01-01') + 0:9,
  X = rnorm(10, 0, 1),
  Y = rnorm(10, 0, 2),
  Z = rnorm(10, 0, 4)
)

# old
stocks_gather <- stocks %>% gather(key   = stock,
                                   value = price,
                                   -time)

# new
stocks_long   <- stocks %>% pivot_longer(cols      = -time,
                                       names_to  = "stock",
                                       values_to = "price")
Pretvorba dolge oblike v široko.
Primer kode iz dokumentacije funkcije spread
# old
stocks_spread <- stocks_gather %>% spread(key = stock,
                                          value = price)

# new
stock_wide    <- stocks_long %>% pivot_wider(names_from  = "stock",
                                            values_from = "price")
Ker v zgoraj navedenih primerih dela z pivot_longer() in pivot_wider(), v izvirni tabeli stocks ni stolpcev, navedenih v argumentih names_to in values_to je potrebno njihova imena navajati v narekovajih.
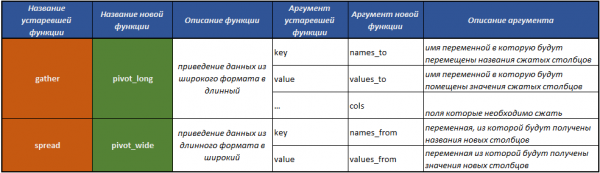
Tabela, s katero vam bo najlaže razumeti, kako preiti na delo z novim konceptom tidyr.
Opomba avtorja
Vse nadaljnje besedilo je prilagodljivo, celo prost prevod s uradne spletne strani knjižnice tidyverse.
Enostaven primer prenosa podatkov iz širokega formata v dolg
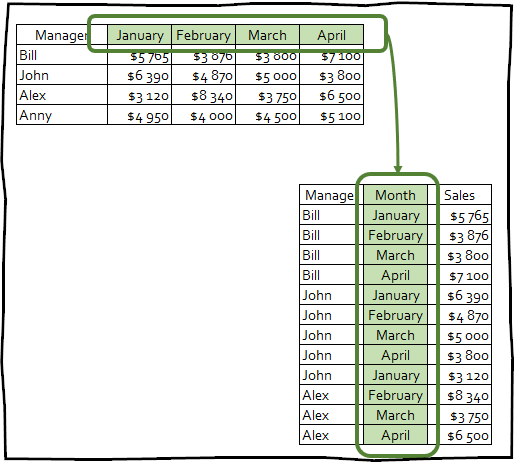
pivot_longer () — podaljšuje nabor podatkov, zmanjšuje število stolpcev in povečuje število vrstic.
Za izvedbo primerov, predstavljenih v članku, je najprej potrebno naložiti potrebne pakete:
library(tidyr)
library(dplyr)
library(readr)
Recimo, da imamo tabelo z rezultati ankete, v kateri (med drugim) sprašujemo ljudi o njihovi religiji in letnem dohodku:
#> # A tibble: 18 x 11
#>    religion `<$10k` `$10-20k` `$20-30k` `$30-40k` `$40-50k` `$50-75k`
#>    <chr>      <dbl>     <dbl>     <dbl>     <dbl>     <dbl>     <dbl>
#>  1 Agnostic      27        34        60        81        76       137
#>  2 Atheist       12        27        37        52        35        70
#>  3 Buddhist      27        21        30        34        33        58
#>  4 Catholic     418       617       732       670       638      1116
#>  5 Don’t k…      15        14        15        11        10        35
#>  6 Evangel…     575       869      1064       982       881      1486
#>  7 Hindu          1         9         7         9        11        34
#>  8 Histori…     228       244       236       238       197       223
#>  9 Jehovah…      20        27        24        24        21        30
#> 10 Jewish        19        19        25        25        30        95
#> # … with 8 more rows, and 4 more variables: `$75-100k` <dbl>,
#> #   `$100-150k` <dbl>, `>150k` <dbl>, `Don't know/refused` <dbl>
Ta tabela vsebuje podatke o religiji respondentov v vrsticah, medtem ko je raven dohodka razporejena po imenih stolpcev. Število respondentov iz vsake kategorije je shranjeno v vrednostih celic na presečišču religije in ravni dohodka. Da bi tabelo prilagodili urejenemu, pravilnemu formatu, je dovolj uporabiti pivot_longer():
pew %>%
  pivot_longer(cols = -religion, names_to = "income", values_to = "count")
pew %>%
pivot_longer(cols = -religion, names_to = "income", values_to = "count")
#> # A tibble: 180 x 3
#> religion income count
#>
#> 1 Agnostic 2 Agnostic $10-20k 34
#> 3 Agnostic $20-30k 60
#> 4 Agnostic $30-40k 81
#> 5 Agnostic $40-50k 76
#> 6 Agnostic $50-75k 137
#> 7 Agnostic $75-100k 122
#> 8 Agnostic $100-150k 109
#> 9 Agnostic >150k 84
#> 10 Agnostic Don't know/refused 96
#> # … with 170 more rowsArgumenti funkcije pivot_longer()
- Prvi argument cols, opisuje, katere stolpce je treba združiti. V tem primeru vse stolpce, razen time.
- Argument names_to daje ime spremenljivki, ki bo ustvarjena iz imen stolpcev, ki smo jih združili.
- values_to daje ime spremenljivki, ki bo ustvarjena iz podatkov, shranjenih v vrednostih celic združenih stolpcev.
Specifikacije
To je nova funkcionalnost paketa tidyr, ki prej pri delu z zastarelimi funkcijami ni bila dostopna.
Specifikacija je podatkovni okvir, kjer vsaka vrstica ustreza enemu stolpcu v novem izhodnem podatkovnem okviru, in dvema posebnima stolpcema, ki se začenjata s:
- .name vsebuje izvorno ime stolpca.
- .value vsebuje ime stolpca, v katerega bodo vključene vrednosti celic.
Preostali stolpci specifikacije odražajo, kako bo v novem stolpcu prikazano ime stisnjenih stolpcev iz .name.
Specifikacija opisuje metapodatke, shranjene v imenu stolpca, z eno vrstico za vsak stolpec in enim stolpcem za vsako spremenljivko, združeno z imenom stolpca. Morda se trenutno zdi, da je ta definicija zapletena, a po pregledu več primerov bo vse precej bolj jasno.
Smisel specifikacije je, da lahko pridobivate, spreminjate in določate nove metapodatke k pretvorjenemu podatkovnemu okviru.
Za delo s specifikacijami pri pretvorbi tabele iz širokega formata v dolg format služi funkcija pivot_longer_spec().
Kako ta funkcija deluje, vzame kateri koli podatkovni okvir in oblikuje njegove metapodatke na zgoraj opisani način.
Za primjer uzmimo skup podataka who, koji dolazi s paketom tidyr. Ovaj skup podataka sadrži informacije koje pruža Svjetska zdravstvena organizacija o oboljenju od tuberkuloze.
who
#> # A tibble: 7,240 x 60
#>    country iso2  iso3   year new_sp_m014 new_sp_m1524 new_sp_m2534
#>        &
#>  1 Afghan… AF    AFG    1980          NA           NA           NA
#>  2 Afghan… AF    AFG    1981          NA           NA           NA
#>  3 Afghan… AF    AFG    1982          NA           NA           NA
#>  4 Afghan… AF    AFG    1983          NA           NA           NA
#>  5 Afghan… AF    AFG    1984          NA           NA           NA
#>  6 Afghan… AF    AFG    1985          NA           NA           NA
#>  7 Afghan… AF    AFG    1986          NA           NA           NA
#>  8 Afghan… AF    AFG    1987          NA           NA           NA
#>  9 Afghan… AF    AFG    1988          NA           NA           NA
#> 10 Afghan… AF    AFG    1989          NA           NA           NA
#> # … with 7,230 more rows, and 53 more variables
Izradimo njegovu specifikaciju.
spec %
  pivot_longer_spec(new_sp_m014:newrel_f65, values_to = "count")
#> # A tibble: 56 x 3
#> .name .value name
#> <chr> <chr> <chr>
#> 1 new_sp_m014 count new_sp_m014
#> 2 new_sp_m1524 count new_sp_m1524
#> 3 new_sp_m2534 count new_sp_m2534
#> 4 new_sp_m3544 count new_sp_m3544
#> 5 new_sp_m4554 count new_sp_m4554
#> 6 new_sp_m5564 count new_sp_m5564
#> 7 new_sp_m65 count new_sp_m65
#> 8 new_sp_f014 count new_sp_f014
#> 9 new_sp_f1524 count new_sp_f1524
#> 10 new_sp_f2534 count new_sp_f2534
#> # … with 46 more rowsPolja country, iso2, iso3 već su varijable. Naš zadatak je preokrenuti kolone s new_sp_m014 o newrel_f65.
U nazivima ovih kolona se čuva sljedeća informacija:
- Prefiks
new_ukazuje da kolona sadrži podatke o novim slučajevima oboljenja od tuberkuloze, trenutni datum okvira sadrži informacije samo o novim oboljenjima, pa taj prefiks u trenutnom kontekstu ne nosi nikakvo značenje. sp/rel/sp/epopisuje način dijagnosticiranja bolesti.m/fspol pacijenta.014/1524/2535/3544/4554/65uzrast pacijenta.
Možemo razdvojiti te kolone pomoću funkcije extract(), koristeći regularni izraz.
spec %
        extract(name, c("diagnosis", "gender", "age"), "new_?(.*)_(.)(.*)")
#> # A tibble: 56 x 5
#> .name .value diagnosis gender age
#> <chr> <chr> <chr> <chr> <chr>
#> 1 new_sp_m014 count sp m 014
#> 2 new_sp_m1524 count sp m 1524
#> 3 new_sp_m2534 count sp m 2534
#> 4 new_sp_m3544 count sp m 3544
#> 5 new_sp_m4554 count sp m 4554
#> 6 new_sp_m5564 count sp m 5564
#> 7 new_sp_m65 count sp m 65
#> 8 new_sp_f014 count sp f 014
#> 9 new_sp_f1524 count sp f 1524
#> 10 new_sp_f2534 count sp f 2534
#> # … with 46 more rowsImajte na umu da kolona .name mora ostati nepromijenjena, jer je to naš indeks u nazivima kolona izvornog skupa podataka.
Spol i dob (kolone gender in age) imaju fiksne i poznate vrijednosti, stoga se preporučuje pretvaranje tih kolona u faktore:
spec %
            mutate(
              gender = factor(gender, levels = c("f", "m")),
              age = factor(age, levels = unique(age), ordered = TRUE)
            )
Na kraju, da bismo primijenili kreiranu specifikaciju na izvorni datum okvir who moramo koristiti argument spec v funkciji pivot_longer().
who %>% pivot_longer(spec = spec)
#> # A tibble: 405,440 x 8
#>    country     iso2  iso3   year diagnosis gender age   count
#>    <chr>       <chr> <chr> <int> <chr>     <fct>  <ord> <int>
#>  1 Afghanistan AF    AFG    1980 sp        m      014      NA
#>  2 Afghanistan AF    AFG    1980 sp        m      1524     NA
#>  3 Afghanistan AF    AFG    1980 sp        m      2534     NA
#>  4 Afghanistan AF    AFG    1980 sp        m      3544     NA
#>  5 Afghanistan AF    AFG    1980 sp        m      4554     NA
#>  6 Afghanistan AF    AFG    1980 sp        m      5564     NA
#>  7 Afghanistan AF    AFG    1980 sp        m      65       NA
#>  8 Afghanistan AF    AFG    1980 sp        f      014      NA
#>  9 Afghanistan AF    AFG    1980 sp        f      1524     NA
#> 10 Afghanistan AF    AFG    1980 sp        f      2534     NA
#> # … with 405,430 more rows
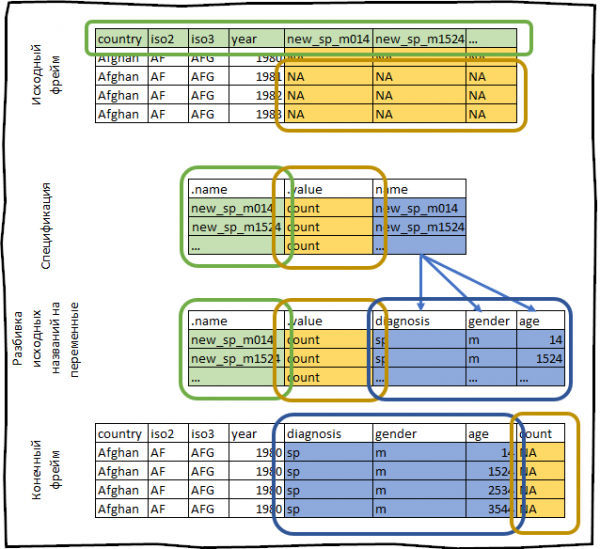
Sve što smo upravo učinili može se sažeti na sljedeći način:
Specifikacija z uporabo več vrednosti (.value)
U gornjem primjeru kolona specifikacije .value je vseboval samo eno vrednost, kar je v večini primerov tudi res.
Toda občasno se lahko pojavi situacija, ko morate zbrati vrednosti iz stolpcev z različnimi tipi podatkov. S pomočjo zastarele funkcije spread() bi bilo to precej zapleteno.
Spodnji primer je prevzet iz paketa data.table.
Ustvarimo trening okvir podatkov.
family <- tibble::tribble(
  ~family,  ~dob_child1,  ~dob_child2, ~gender_child1, ~gender_child2,
       1L, "1998-11-26", "2000-01-29",             1L,             2L,
       2L, "1996-06-22",           NA,             2L,             NA,
       3L, "2002-07-11", "2004-04-05",             2L,             2L,
       4L, "2004-10-10", "2009-08-27",             1L,             1L,
       5L, "2000-12-05", "2005-02-28",             2L,             1L,
)
family % mutate_at(vars(starts_with("dob")), parse_date)
#> # A tibble: 5 x 5
#> family dob_child1 dob_child2 gender_child1 gender_child2
#> <int> <date> <date> <int> <int>
#> 1 1 1998-11-26 2000-01-29 1 2
#> 2 2 1996-06-22 NA 2 NA
#> 3 3 2002-07-11 2004-04-05 2 2
#> 4 4 2004-10-10 2009-08-27 1 1
#> 5 5 2000-12-05 2005-02-28 2 1Ustvarjen okvir podatkov v vsaki vrstici vsebuje podatke o otrocih ene družine. V družinah je lahko en ali dva otroka. Za vsakega otroka so na voljo podatki o datumu rojstva in spolu, pri čemer so podatki za vsakega otroka v ločenih stolpcih, naš cilj je te podatke prilagoditi pravilnemu formatu za analizo.
Opazite, da imamo dve spremenljivki z informacijami o vsakem otroku: njegov spol in datum rojstva (stolpci s predpono dop vsebujejo datum rojstva, stolpci s predpono gender vsebujejo spol otroka). V pričakovanem rezultatu bi morali biti ti podatki v ločenih stolpcih. To lahko dosežemo z generiranjem specifikacije, v kateri bo stolpec .value imel dve različni vrednosti.
spec %
  pivot_longer_spec(-family) %>%
  separate(col = name, into = c(".value", "child")) %>%
  mutate(child = parse_number(child))
#> # A tibble: 4 x 3
#>   .name         .value child
#>   <chr>         <chr>  <dbl>
#> 1 dob_child1    dob        1
#> 2 dob_child2    dob        2
#> 3 gender_child1 gender     1
#> 4 gender_child2 gender     2
Torej, poglejmo korak za korakom, katere akcije izvaja zgoraj navedena koda.
pivot_longer_spec(-family)— ustvarimo specifikacijo, ki stisne vse obstoječe stolpce, razen stolpca family.separate(col = name, into = c(".value", "child"))— ločimo stolpec .name, ki vsebuje imena izvornih polj, po podčrtaju in pridobljene vrednosti prenesemo v stolpce .value in child.mutate(child = parse_number(child))— pretvorimo vrednosti polja child iz besedilne v številčno vrsto podatkov.
Zdaj lahko uporabimo pridobljeno specifikacijo na izvirni okvir podatkov in prilagodimo tabelo v želeno obliko.
family %>%
    pivot_longer(spec = spec, na.rm = T)
#> # A tibble: 9 x 4
#> family child dob gender
#> <int> <dbl> <date> <int>
#> 1 1 1 1998-11-26 1
#> 2 1 2 2000-01-29 2
#> 3 2 1 1996-06-22 2
#> 4 3 1 2002-07-11 2
#> 5 3 2 2004-04-05 2
#> 6 4 1 2004-10-10 1
#> 7 4 2 2009-08-27 1
#> 8 5 1 2000-12-05 2
#> 9 5 2 2005-02-28 1Uporabljamo argument na.rm = TRUE, ker trenutna oblika podatkov prisili ustvarjanje odvečnih vrstic za neobstoječe opazovanja. Ker ima družina 2 le enega otroka, na.rm = TRUE zagotovlja, da bo družina 2 imela en vrstico v izhodu.
Pretvorba data frame-ov iz dolgega formata v širokega
pivot_wider() je obratna transformacija, ki povečuje število stolpcev podatkovnega okvira z zmanjšanjem števila vrstic.
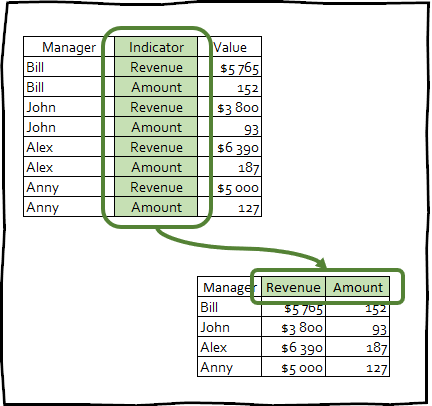
Takšna transformacija se redko uporablja za preurejanje podatkov v urejen videz, vendar je ta tehnika lahko koristna za ustvarjanje povzetkov, ki se uporabljajo v predstavitvah, ali za integracijo z drugimi orodji.
V resnici sta funkciji pivot_longer() in pivot_wider() simetrični in izvajata obratne dejavnosti, tj: df %>% pivot_longer(spec = spec) %>% pivot_wider(spec = spec) in df %>% pivot_wider(spec = spec) %>% pivot_longer(spec = spec) bosta vrnila izvorni df.
Najosnovnejši primer ureditev tabele v širok format
Za demonstracijo delovanja funkcije pivot_wider() bomo uporabili zbirko podatkov fish_encounters, ki hrani informacije o tem, kako različne postaje beležijo gibanje rib po reki.
#> # A tibble: 114 x 3
#>    fish  station  seen
#>    <fct> <fct>   <int>
#>  1 4842  Release     1
#>  2 4842  I80_1       1
#>  3 4842  Lisbon      1
#>  4 4842  Rstr        1
#>  5 4842  Base_TD     1
#>  6 4842  BCE         1
#>  7 4842  BCW         1
#>  8 4842  BCE2        1
#>  9 4842  BCW2        1
#> 10 4842  MAE         1
#> # … with 104 more rows
V večini primerov bo ta tabela bolj informativna in uporabna, če informacije o vsaki postaji predstavimo v ločenem stolpcu.
fish_encounters %>% pivot_wider(names_from = station, values_from = seen)
fish_encounters %>% pivot_wider(names_from = station, values_from = seen)
#> # Tibble: 19 x 12
#>    fish  Release I80_1 Lisbon  Rstr Base_TD   BCE   BCW  BCE2  BCW2   MAE
#>        &;
#>  1 4842        1     1      1     1       1     1     1     1     1     1
#>  2 4843        1     1      1     1       1     1     1     1     1     1
#>  3 4844        1     1      1     1       1     1     1     1     1     1
#>  4 4845        1     1      1     1       1    NA    NA    NA    NA    NA
#>  5 4847        1     1      1    NA      NA    NA    NA    NA    NA    NA
#>  6 4848        1     1      1     1      NA    NA    NA    NA    NA    NA
#>  7 4849        1     1     NA    NA      NA    NA    NA    NA    NA    NA
#>  8 4850        1     1     NA     1       1     1     1    NA    NA    NA
#>  9 4851        1     1     NA    NA      NA    NA    NA    NA    NA    NA
#> 10 4854        1     1     NA    NA      NA    NA    NA    NA    NA    NA
#> # … s 9 več vrsticami in 1 več spremenljivko: MAW
Ta zbirka podatkov beleži informacije samo takrat, ko je bila riba odkrila postaja, tj. če katera riba ni bila zabeležena s strani katere koli postaje, podatkov ne bo v tabeli. To pomeni, da bodo izhodni podatki zapolnjeni z NA.
Vendar v tem primeru vemo, da odsotnost zapisa pomeni, da riba ni bila opažena, zato lahko uporabimo argument values_fill v funkciji pivot_wider() in zapolnimo te manjkajoče vrednosti z ničelami:
fish_encounters %>% pivot_wider(
  names_from = station,
  values_from = seen,
  values_fill = list(seen = 0)
)
#> # A tibble: 19 x 12
#> fish Release I80_1 Lisbon Rstr Base_TD BCE BCW BCE2 BCW2 MAE
#> <fct> <int> <int> <int> <int> <int> <int> <int> <int> <int> <int>
#> 1 4842 1 1 1 1 1 1 1 1 1 1
#> 2 4843 1 1 1 1 1 1 1 1 1 1
#> 3 4844 1 1 1 1 1 1 1 1 1 1
#> 4 4845 1 1 1 1 1 0 0 0 0 0
#> 5 4847 1 1 1 0 0 0 0 0 0 0
#> 6 4848 1 1 1 1 0 0 0 0 0 0
#> 7 4849 1 1 0 0 0 0 0 0 0 0
#> 8 4850 1 1 0 1 1 1 1 0 0 0
#> 9 4851 1 1 0 0 0 0 0 0 0 0
#> 10 4854 1 1 0 0 0 0 0 0 0 0
#> # … with 9 more rows, and 1 more variable: MAW <int>Generiranje imena stolpca iz več izvornih spremenljivk
Predstavljajte si, da imamo tabelo, ki vsebuje kombinacijo izdelka, države in leta. Za generiranje testnega podatkovnega okvira lahko izvedete naslednjo kodo:
df %
  filter((product == "A" & country == "AI") | product == "B") %>%
  mutate(value = rnorm(nrow(.)))
#> # A tibble: 45 x 4
#> product country year value
#> <chr> <chr> <int> <dbl>
#> 1 A AI 2000 -2.05
#> 2 A AI 2001 -0.676
#> 3 A AI 2002 1.60
#> 4 A AI 2003 -0.353
#> 5 A AI 2004 -0.00530
#> 6 A AI 2005 0.442
#> 7 A AI 2006 -0.610
#> 8 A AI 2007 -2.77
#> 9 A AI 2008 0.899
#> 10 A AI 2009 -0.106
#> # … with 35 more rowsNaša naloga je razširiti podatkovni okvir tako, da bo en stolpec vseboval podatke za vsako kombinacijo izdelka in države. To lahko dosežemo tako, da posredujemo v argument names_from vektor, ki vsebuje imena združenih polj.
df %>% pivot_wider(names_from = c(product, country),
                 values_from = "value")
#> # A tibble: 15 x 4
#> year A_AI B_AI B_EI
#> <int> <dbl> <dbl> <dbl>
#> 1 2000 -2.05 0.607 1.20
#> 2 2001 -0.676 1.65 -0.114
#> 3 2002 1.60 -0.0245 0.501
#> 4 2003 -0.353 1.30 -0.459
#> 5 2004 -0.00530 0.921 -0.0589
#> 6 2005 0.442 -1.55 0.594
#> 7 2006 -0.610 0.380 -1.28
#> 8 2007 -2.77 0.830 0.637
#> 9 2008 0.899 0.0175 -1.30
#> 10 2009 -0.106 -0.195 1.03
#> # … with 5 more rowsLahko tudi uporabite specifikacije funkcije pivot_wider(). Toda ob predložitvi v pivot_wider() specifikacija izvede transformacijo, nasprotno pivot_longer(): ustvarjajo se stolpci, navedeni v .name, z uporabo vrednosti iz .value in drugih stolpcev.
Za ta nabor podatkov lahko ustvarite prilagojeno specifikacijo, če želite, da ima vsaka možna kombinacija države in izdelka svoj stolpec, ne le tiste, ki so prisotne v podatkih:
spec %
  expand(product, country, .value = "value") %>%
  unite(".name", product, country, remove = FALSE)
#> # A tibble: 4 x 4
#> .name product country .value
#> <chr> <chr> <chr> <chr>
#> 1 A_AI A AI value
#> 2 A_EI A EI value
#> 3 B_AI B AI value
#> 4 B_EI B EI valuedf %>% pivot_wider(spec = spec) %>% head()#> # A tibble: 6 x 5
#> year A_AI A_EI B_AI B_EI
#> <int> <dbl> <dbl> <dbl> <dbl>
#> 1 2000 -2.05 NA 0.607 1.20
#> 2 2001 -0.676 NA 1.65 -0.114
#> 3 2002 1.60 NA -0.0245 0.501
#> 4 2003 -0.353 NA 1.30 -0.459
#> 5 2004 -0.00530 NA 0.921 -0.0589
#> 6 2005 0.442 NA -1.55 0.594Nekateri napredni primeri dela z novim konceptom tidyr
Ureditev podatkov v pregleden format na primeru nabora podatkov o dohodku in najemnini v ZDA
Nabor podatkov us_rent_income vsebuje informacije o povprečnem dohodku in najemnini za vsak zvezno državo v ZDA za leto 2017 (nabor podatkov je na voljo v paketu tidycensus).
us_rent_income
#> # A tibble: 104 x 5
#>    GEOID NAME       variable estimate   moe
#>
#>  1 01    Alabama    income      24476   136
#>  2 01    Alabama    rent          747     3
#>  3 02    Alaska     income      32940   508
#>  4 02    Alaska     rent         1200    13
#>  5 04    Arizona    income      27517   148
#>  6 04    Arizona    rent          972     4
#>  7 05    Arkansas   income      23789   165
#>  8 05    Arkansas   rent          709     5
#>  9 06    California income      29454   109
#> 10 06    California rent         1358     3
#> # … s še 94 vrsticami
V obliki, v kateri so podatki shranjeni v naboru podatkov, us_rent_income je z njimi izjemno neprijetno delati, zato bi radi ustvarili nabor podatkov s stolpci: rent, rent_moe, come, income_moe. Obstaja več načinov za ustvarjanje te specifikacije, toda glavno je, da moramo ustvariti vsako kombinacijo vrednosti spremenljivke in estimate/moe, nato pa generirati ime stolpca.
  spec %
    expand(variable, .value = c("estimate", "moe")) %>%
    mutate(
      .name = paste0(variable, ifelse(.value == "moe", "_moe", ""))
    )
#> # A tibble: 4 x 3
#> variable .value .name
#> <chr> <chr> <chr>
#> 1 income estimate income
#> 2 income moe income_moe
#> 3 rent estimate rent
#> 4 rent moe rent_moeNavedba te specifikacije pivot_wider() nam daje rezultat, ki ga iščemo:
us_rent_income %>% pivot_wider(spec = spec)
#> # A tibble: 52 x 6
#>    GEOID NAME                 income income_moe  rent rent_moe
#>    <chr> <chr>                 <dbl>      <dbl> <dbl>    <dbl>
#>  1 01    Alabama               24476        136   747        3
#>  2 02    Alaska                32940        508  1200       13
#>  3 04    Arizona               27517        148   972        4
#>  4 05    Arkansas              23789        165   709        5
#>  5 06    California            29454        109  1358        3
#>  6 08    Colorado              32401        109  1125        5
#>  7 09    Connecticut           35326        195  1123        5
#>  8 10    Delaware              31560        247  1076       10
#>  9 11    District of Columbia  43198        681  1424       17
#> 10 12    Florida               25952         70  1077        3
#> # … with 42 more rows
Svetovna banka
Včasih je potrebno za oblikovanje nabora podatkov v želeno obliko izvesti več korakov.
Nabor podatkov world_bank_pop vsebuje podatke Svetovne banke o prebivalstvu vsake države za obdobje od leta 2000 do 2018.
#> # A tibble: 1,056 x 20
#>    country indicator `2000` `2001` `2002` `2003`  `2004`  `2005`   `2006`
#>    <chr>   <chr>      <dbl>  <dbl>  <dbl>  <dbl>   <dbl>   <dbl>    <dbl>
#>  1 ABW     SP.URB.T… 4.24e4 4.30e4 4.37e4 4.42e4 4.47e+4 4.49e+4  4.49e+4
#>  2 ABW     SP.URB.G… 1.18e0 1.41e0 1.43e0 1.31e0 9.51e-1 4.91e-1 -1.78e-2
#>  3 ABW     SP.POP.T… 9.09e4 9.29e4 9.50e4 9.70e4 9.87e+4 1.00e+5  1.01e+5
#>  4 ABW     SP.POP.G… 2.06e0 2.23e0 2.23e0 2.11e0 1.76e+0 1.30e+0  7.98e-1
#>  5 AFG     SP.URB.T… 4.44e6 4.65e6 4.89e6 5.16e6 5.43e+6 5.69e+6  5.93e+6
#>  6 AFG     SP.URB.G… 3.91e0 4.66e0 5.13e0 5.23e0 5.12e+0 4.77e+0  4.12e+0
#>  7 AFG     SP.POP.T… 2.01e7 2.10e7 2.20e7 2.31e7 2.41e+7 2.51e+7  2.59e+7
#>  8 AFG     SP.POP.G… 3.49e0 4.25e0 4.72e0 4.82e0 4.47e+0 3.87e+0  3.23e+0
#>  9 AGO     SP.URB.T… 8.23e6 8.71e6 9.22e6 9.77e6 1.03e+7 1.09e+7  1.15e+7
#> 10 AGO     SP.URB.G… 5.44e0 5.59e0 5.70e0 5.76e0 5.75e+0 5.69e+0  4.92e+0
#> # … with 1,046 more rows, and 11 more variables: `2007` <dbl>,
#> #   `2008` <dbl>, `2009` <dbl>, `2010` <dbl>, `2011` <dbl>, `2012` <dbl>,
#> #   `2013` <dbl>, `2014` <dbl>, `2015` <dbl>, `2016` <dbl>, `2017` <dbl>
Naš cilj je ustvariti urejen nabor podatkov, kjer je vsaka spremenljivka v stolpcu. Še vedno ni jasno, kateri koraki so potrebni, vendar bomo začeli s najbolj očitnim problemom: leto je razdeljeno v več stolpcev.
Za rešitev tega problema je treba uporabiti funkcijo pivot_longer().
pop2 %
  pivot_longer(`2000`:`2017`, names_to = "year")
#> # A tibble: 19,008 x 4
#> country indicator year value
#> <chr> <chr> <chr> <dbl>
#> 1 ABW SP.URB.TOTL 2000 42444
#> 2 ABW SP.URB.TOTL 2001 43048
#> 3 ABW SP.URB.TOTL 2002 43670
#> 4 ABW SP.URB.TOTL 2003 44246
#> 5 ABW SP.URB.TOTL 2004 44669
#> 6 ABW SP.URB.TOTL 2005 44889
#> 7 ABW SP.URB.TOTL 2006 44881
#> 8 ABW SP.URB.TOTL 2007 44686
#> 9 ABW SP.URB.TOTL 2008 44375
#> 10 ABW SP.URB.TOTL 2009 44052
#> # … with 18,998 more rowsNaslednji korak je preučiti spremenljivko indicator.
pop2 %>% count(indicator)
#> # A tibble: 4 x 2
#>   indicator       n
#>   <chr>       <int>
#> 1 SP.POP.GROW  4752
#> 2 SP.POP.TOTL  4752
#> 3 SP.URB.GROW  4752
#> 4 SP.URB.TOTL  4752
Kjer je SP.POP.GROW – rast prebivalstva, SP.POP.TOTL – skupno število prebivalcev, SP.URB. * pa isto, vendar le za urbano območje. Razdelimo te vrednosti na dve spremenljivki: area – območje (total ali urban) in spremenljivko, ki vsebuje dejanske podatke (population ali growth):
pop3 %
  separate(indicator, c(NA, "area", "variable"))
#> # A tibble: 19,008 x 5
#> country area variable year value
#> <chr> <chr> <chr> <chr> <dbl>
#> 1 ABW URB TOTL 2000 42444
#> 2 ABW URB TOTL 2001 43048
#> 3 ABW URB TOTL 2002 43670
#> 4 ABW URB TOTL 2003 44246
#> 5 ABW URB TOTL 2004 44669
#> 6 ABW URB TOTL 2005 44889
#> 7 ABW URB TOTL 2006 44881
#> 8 ABW URB TOTL 2007 44686
#> 9 ABW URB TOTL 2008 44375
#> 10 ABW URB TOTL 2009 44052
#> # … with 18,998 more rowsZdaj nam ostane le še razdeliti spremenljivko variable na dva stolpca:
pop3 %>%
  pivot_wider(names_from = variable, values_from = value)
#> # A tibble: 9,504 x 5
#> country area year TOTL GROW
#> <chr> <chr> <chr> <dbl> <dbl>
#> 1 ABW URB 2000 42444 1.18
#> 2 ABW URB 2001 43048 1.41
#> 3 ABW URB 2002 43670 1.43
#> 4 ABW URB 2003 44246 1.31
#> 5 ABW URB 2004 44669 0.951
#> 6 ABW URB 2005 44889 0.491
#> 7 ABW URB 2006 44881 -0.0178
#> 8 ABW URB 2007 44686 -0.435
#> 9 ABW URB 2008 44375 -0.698
#> 10 ABW URB 2009 44052 -0.731
#> # … with 9,494 more rowsSeznam stikov
Zadnji primer, predstavljajte si, da imate seznam kontaktov, ki ste jih kopirali in prilepili s spletne strani:
contacts <- tribble(
  ~field, ~value,
  "name", "Jiena McLellan",
  "company", "Toyota",
  "name", "John Smith",
  "company", "google",
  "email", "john@google.com",
  "name", "Huxley Ratcliffe"
)
Oblikovati seznam v tabelarično obliko je precej težko, ker ni spremenljivke, ki bi identificirala, kateri podatki pripadajo kateremu stiku. To lahko odpravimo tako, da opazimo, da podatki o vsakem novem kontaktu začnejo z imenom ("name"), zato lahko ustvarimo edinstven identifikator in ga povečujemo za enoto vsakič, ko v stolpcu field naletimo na vrednost “name”:
contacts %
  mutate(
    person_id = cumsum(field == "name")
  )
contacts
#> # A tibble: 6 x 3
#> field value person_id
#> <chr> <chr> <int>
#> 1 name Jiena McLellan 1
#> 2 company Toyota 1
#> 3 name John Smith 2
#> 4 company google 2
#> 5 email john@google.com 2
#> 6 name Huxley Ratcliffe 3Zdaj, ko imamo edinstven identifikator za vsak kontakt, lahko preusmerimo field in value v stolpce:
contacts %>%
  pivot_wider(names_from = field, values_from = value)
#> # A tibble: 3 x 4
#> person_id name company email
#> <int> <chr> <chr> <chr>
#> 1 1 Jiena McLellan Toyota <NA>
#> 2 2 John Smith google john@google.com
#> 3 3 Huxley Ratcliffe <NA> <NA>Zaključek
Po mojem mnenju je nova konceptualizacija tidyr resnično intuitivno bolj razumljiva in močno presega stare funkcije spread() in gather(). Upam, da vam je ta članek pomagal razjasniti pivot_longer() in pivot_wider().
Izvor: habr.com
