

Op. prev.: Avtor tega gradiva je Cindy Sridharan, inženirka iz podjetja imgix, ki se ukvarja z razvojem API-jev in zlasti s testiranjem mikroservisov. V tem gradivu deli svoje poglobljeno mnenje o aktualnih težavah na področju porazdeljenega sledenja, kjer po njenem mnenju primanjkuje resnično učinkovitih orodij za reševanje nujnih težav.
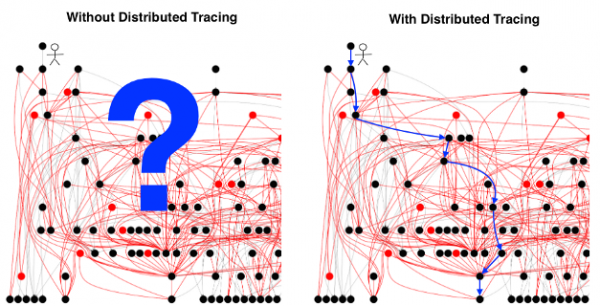
[Ilustracija prevzeta iz o porazdeljenem sledenju.]
Menijo, da je težko implementirati, pa tudi donosi od njega Težavnost sledenja pojasnjujejo z mnogimi razlogi, pri čemer se pogosto sklicujejo na delovno intenzivnost nastavitve vsakega sestavnega dela sistema za prenašanje ustreznih glavic skupaj z vsakim zahtevkom. Čeprav ta težava resnično obstaja, je ne moremo imenovati nepreprosto rešljivo. Mimogrede, ne pojasnjuje, zakaj razvijalci ne marajo sledenja (tudi že delujočega).
Glavna težava pri porazdeljenem sledenju niso zbiranju podatkov, ne standardizacija formatov distribucije in predstavitve rezultatov, ne določitev, kdaj, kje in kako izvesti vzorčenje. Niti ne poskušam predstaviti trivialnih teh 'težav s sprejemanjem' — v resnici obstajajo precej pomembni tehnični in (če razmišljamo o resnično Open Source ) politični izzivi, ki jih je treba premagati, da bi lahko te težave štele za rešljive.
Vendar pa, če predpostavimo, da so vse te težave rešene, je velika verjetnost, da se prav nič bistveno ne bo spremenilo z vidika izkušnje končnega uporabnika.Sledenje lahko še vedno ne prinaša praktične koristi v najpogostejših scenarijih odpravljanja napak — celo potem, ko je bilo vzpostavljeno.
Tako neobičajno sledenje
Porazdeljeno sledenje vključuje več razdrobljenih komponent:
- opremljanje aplikacij in middleware z orodji za nadzor;
- prenosi porazdeljenega konteksta;
- zbiranje sledi;
- shranjevanje sledi;
- njihovo pridobivanje in vizualizacija.
Množstvo pogovorov o distribuiranem sledenju se zmanjša na to, da ga obravnavamo kot neko unary operacijo, katere edini cilj je pomoč pri celotni diagnostiki sistema. V veliki meri to izhaja iz zgodovinskih predstav o distribuiranem sledenju. V , ki je bila narejena, ko so bili odprti viri Zipkina, je bilo omenjeno, da on [Zipkin] pospešuje Twitter. Prve komercialne ponudbe za sledenje so tudi napredovale kot .
Op. prev.: Da bi bil nadaljnji tekst bolje razumljiv, opredelimo dva osnovna termina v skladu z :
- Span — osnovni element distribuiranega sledenja. Predstavlja opis nekega delovnega procesa (na primer, poizvedbe v bazo podatkov) z imenom, časom začetka in konca, oznakami, dnevniki in kontekstom.
- Span-i običajno vsebujejo povezave na druge span-e, kar omogoča združevanje številnih span-ov v Trace — vizualizacijo življenja poizvedbe med njenim premikanjem skozi distribuirani sistem.
Trace-i vsebujejo neverjetno dragocene podatke, ki lahko pomagajo pri nalogah, kot so: testiranje v produkciji, izvajanje testov za obnovitev po napaki, testiranje z vnosom napak itd. Dejansko nekatere podjetja že uporabljajo sledenje za take namene. Začnimo s tem, da ima tudi druge uporabe poleg preproste prenosa span-ov v sistem za shranjevanje:
- Na primer, Uber rezultati sledenja za ločevanje testnega prometa in produkcijskega prometa.
- Facebook podati podatke trace-ov za analizo kritične poti in preusmerjanje prometa med rednimi testi obnove po napaki.
- Tudi socialno omrežje zvezki Jupyter, ki omogočajo razvijalcem, da izvajajo poljubne poizvedbe na rezultatih sledenja.
- Pristaši (Vnos napak temelječ na izvoru) distribuirane trace-e za testiranje z vnosom napak.
Noben od zgoraj naštetih scenarijev se ne nanaša popolnoma na odpravljanje napak, v katerem inženir poskuša rešiti težavo, ko pogleda trace.
Ko gre vseeno do scenarija odpravljanja napak, ostaja primarni vmesnik diagram traceview (čeprav nekateri to imenujejo tudi „Gantov diagram“ ili „kaskadni diagram“). Pod traceview jaz vse span’y i soputstvuyushchie metadannye, kotorye vmeste sostavlyayut trace. Kazhdaya sistema trassirovki s otkrytym istochnikom, a takzhe kazhdoe kommertsionnoe reshenie dlya trassirovki predlagaet osnovannyy na traceview polzovatelskiy interfeys dlya vizualizatsii, detalizatsii i filtratsii trace’ov.
Problema so vsemi sistemami trassirovki, s kotorymi mne dovelolos’ ozнакомitsya na dannyy moment, sostoit v tom, chto itogovaya vizualizatsiya (traceview) prakticheski polnost’yu otrazhaet osobennosti protsessa generatsii trace’a. Daazhe kogda predlagayutsya alternativnye vizualizatsii: karty intensivnosti (heatmap), topologii servisyv, histogrammy zaderzhki (latency), — v konechnom itoge oni vse ravno svoditsya k traceview.
V proshlom ya na to, chto bol’shinstvo «innovatsiy» v oblasti trassirovki v otnoshenii UI/UX, kak pokazivaetsya, ogranichivayutsya dopolnitel’nykh metadannykh v trace, vklucheniem v nikh informatsii s vysokoy kardinal’nost’yu (high-cardinality) ili predostavleniem vozmozhnosti detalizirovat’ konkretnye span’y ili vypolnyat’ zaprosy mezhu- i vnutri-trace. Pri tem traceview ostayetsya osnovnym sredstvom vizualizatsii. Poka budet sokhranyat’sya podobnoye polozhenie veshchestv, raspredelennaya trassirovka budet (v luchshem sluchaye) zaniyat’ 4-e mesto v kachestve otladkogo instrumenta, v sleduyushchikh metrikakh, logakh i stack trace’akh, a v khudshikh — okazhetsya pustoy poteryu deneg i vremeni.
Problema s traceview
Namen traceview — predostavlyat’ polnuyu kartinu peredvizheniya otdelnogo zaprosa po vsekomponentam raspredelennoy sistemy, k kotorym on imeet otnoshenie. Nekotorye boleye prodvinutye sistemy trassirovki pozvolyayut detalizirovat’ otdelnye span’y i prosmatrivat’ razbivku po vremeni inside odnogo protsessa (kogda span’y imayut funktsional’nye granitsy).
Osnovna predpostavka arhitekture mikroservisa je ideja da se organizacijska struktura razvija zajedno s potrebama kompanije. Zagovornici mikroservisa tvrde da raspodjela različitih poslovnih zadataka u posebne servise omogućava malim, autonomnim timovima programera da kontroliraju cijeli životni ciklus tih servisa, dajući im mogućnost da ih neovisno kreiraju, testiraju i implementiraju. Međutim, nedostatak takve raspodjele je gubitak informacija o tome kako svaki servis komunicira s drugima. U takvim uvjetima distribuirano praćenje pretendira na ulogu nezamjenjivog alata za odpravljanje napak kompleksne interakcije između servisa.
Ako imate zaista , onda nijedna osoba ne može zadržati u glavi njegovu potpunu sliku. U stvarnosti, razvoj alata uz pretpostavku da je to uopće moguće je nešto poput antipatterna (neefikasnog i neproduktivnog pristupa). U idealnom slučaju, za otklanjanje grešaka potreban je alat koji pomaže sužiti područje pretraživanja, tako da se inženjeri mogu usredotočiti na podskup mjera (servisa/korisnika/hostova itd.) koji su relevantni za razmatrani scenarij problema. Prilikom utvrđivanja uzroka greške, inženjeri ne bi trebali razmatrati što se događalo u svim servisima odjednom, budući da bi takav zahtjev bio u suprotnosti sa samom idejom arhitekture mikroservisa.
Međutim, traceview predstavlja upravo to. Da, neki sustavi praćenja nude sažete traceview prikaze kada je broj span-ova u traceu toliko velik da ih nije moguće prikazati unutar jedne vizualizacije. Međutim, zbog velikog volumena informacija, čak i u takvoj skraćenoj vizualizaciji, inženjeri i dalje moraju ''pročeprkati'' te podatke, ručno sužavajući uzorak na skup servisa koji su izvor problema. Nažalost, u tom području mašine su značajno brže od čovjeka, manje sklone greškama, a njihovi rezultati su ponovljivi.
Još jedan razlog zbog kojeg smatram da je metoda traceview pogrešna je taj što se loše uklapa u kontekst otklanjanja grešaka na temelju hipoteza. U svojoj suštini, otklanjanje greške je iterativni postopek, ki se začne s hipotezo, sledijo preverjanje različnih opazovanj in dejstev, pridobljenih iz sistema po različnih smereh, sklepi/splošne navedbe in nadaljnja ocena resničnosti hipoteze.
Možnost hitro in poceni testirati hipoteze in ustrezno izboljšati mentalni model je temelj odpravljanja napak. Vsako orodje za odpravljanje napak mora biti interaktivno in ožiti iskalni prostor ali, v primeru napačnega namiga, omogočiti uporabniku, da se vrne nazaj in osredotoči na drugo področje sistema. Idealno orodje bo to počelo proaktivno, takoj pritegne pozornost uporabnika na morebitne problematične dele.
Žal, traceview ga ni mogoče imenovati orodje z interaktivnim vmesnikom. Najboljše, kar lahko upamo pri njegovi uporabi, je, da odkrijemo določen vir povečane latence in pregledamo vse vrste oznak in dnevnikov, povezanih z njim. To ne pomaga inženirju prepoznati zakonitosti v prometu, kot so posebnosti porazdelitve latence, ali odkriti korelacije med različnimi merjenji. lahko pomaga obiti nekatere od teh težav. Resnično, uspešne analize z uporabo strojnega učenja za prepoznavanje abnormalnih sekvenc in identifikacijo podmnožice oznak, ki so lahko povezane z anomalnim vedenjem. Kljub temu pa do zdaj še nisem zasledil prepričljivih vizualizacij ugotovitev, ki so jih pridobili s strojno učenje ali analizo podatkov, uporabljenih na sekvencah, ki bi se bistveno razlikovale od traceview ali DAG (usmerjenega acikličnega grafika).
Sekvence so preveč nizkonivojske
Temeljna težava s traceview je, da sekvence so preveč nizkonivojski primitivi za analizo latence (latency) in analizo osnovnih vzrokov. To je tako, kot da bi analizirali posamezne ukaze procesorja v poskusu odpravljanja izjeme, pri čemer vemo, da obstajajo veliko bolj visokonivojska orodja, kot je backtrace, s katerimi je delo bistveno lažje.
Zatorej bom drznil trditi naslednje: v idealnem primeru ne potrebujemo celotne slike ki se dogaja med življenjskim ciklom zahtevka, kar predstavljajo sodobna orodja za sledenje. Namesto tega potrebujemo neko obliko višje ravni abstrakcije, ki vsebuje informacije o tem, kar ni šlo v redu (podobno kot backtrace), skupaj z nekim kontekstom. Namesto da bi opazoval celoten trace, raje vidim del, kjer se dogaja kaj zanimivega ali nenavadnega. Trenutno se iskanje izvaja ročno: inženir pridobi trace in sam analizira spane v iskanju česa zanimivega. Pristop, pri katerem ljudje opazujejo spane v posameznih trace'ih in upajo, da bodo odkrili sumljivo aktivnost, se absolutno ne da razširiti (še posebej, ko morajo razmišljati o vseh metapodatkih, vključenih v različne spane, kot so ID spana, ime RPC metode, trajanje spana, dnevniki, oznake itd.).
Alternatives traceview
Rezultati sledenja so najbolj uporabni, ko jih je mogoče vizualizirati na način, ki zagotavlja nedvoumno predstavo o tem, kar se dogaja v medsebojno povezanih delih sistema. Dokler tega ni, proces odpravljanja napak na splošno ostaja inerten in odvisen od sposobnosti uporabnika, da opazi pravilne korelacije, preveri ustrezne dele sistema ali združi koščke mozaika – v nasprotju s alata, kar uporabniku pomaga oblikovati te hipoteze.
Nisem vizualni oblikovalec in ne strokovnjak za UX, vendar bom v naslednjem razdelku delil nekaj idej o tem, kako bi takšne vizualizacije lahko izgledale.
Osredotočanje na posamezne storitve
V razmerah, ko se industrija konsolidira okoli idej , se zdi smiselno, da morajo posamezne ekipe najprej spremljati usklajenost svojih storitev s temi cilji. Iz tega sledi, da vizualizacija usmerjena na storitev najbolje ustreza takšnim ekipam.
Trace'i, še posebej brez vzorca, so zakladnica informacij o vsakem komponentu razporejene sisteme. Te informacije lahko obdelamo s pametnim obdelovalnikom, ki bo uporabnikom dobavljal usmerjene na storitev najdbe. Te lahko zaznamo vnaprej – še preden uporabnik pogleda trace'e:
- Diagrami porazdelitve zakasnitev samo za močne izstopajoče poizvedbe (izstopajoče poizvedbe);
- Diagrami porazdelitve zakasnitev v primerih, ko cilji SLO storitve niso doseženi;
- Najbolj 'splošni', 'zanimivi' in 'čudni' oznake v poizvedbah, ki se najpogosteje ponavljajo;
- Razčlenitev zakasnitev za primere, ko odvisnosti storitev ne doseže zastavljenih ciljev SLO;
- Razčlenitev zakasnitev po različnih spodnjih (downstream) storitvah.
Na nekatere od teh vprašanj vgrajene metrike preprosto ne morejo odgovoriti, kar uporabnike prisili, da natančno preučijo span’e. Na koncu imamo izjemno sovražen mehanizem do uporabnikov.
V povezavi s tem se postavlja vprašanje: kako je s kompleksnimi interakcijami med različnimi storitvami, ki jih nadzorujejo različne ekipe? Ali ni traceview najbolj primerno orodje za osvetlitev takšne situacije?
Mobilni razvijalci, lastniki stateless storitev, lastniki upravljanih stateful storitev (kot so baze podatkov) in lastniki platform so lahko zainteresirani za drugo predstavitev distribuiranega sistema; traceview — to je preveč univerzalna rešitev za te temeljno različne potrebe. Tudi v zelo kompleksni mikroservisni arhitekturi lastnikom storitev ni potrebno globoko znanje o več kot dveh ali treh upstream in downstream storitvah. V bistvu, v večini scenarijev uporabnikom zadostuje, da odgovarjajo na vprašanja, ki se nanašajo na omejen sklop storitev.
To je podobno opazovanju majhnega podmnožstva storitev skozi povečavo zaradi natančnega preučevanja. To uporabniku omogoča postavljanje bolj nujnih vprašanj glede kompleksne interakcije med temi storitvami in njihovimi neposrednimi odvisnostmi. To je podobno backtrace’u v svetu storitev, kjer inženir ve, To vam omogoča, da rekonstruirate ne le ne tako, kot tudi ima nek vpogled v dogajanje v okoliških storitvah, da bi razumel, je merjeni predmet prav te dolžine, kot jo je pokazal. Ravnil bo samo pokazal njegovo velikost in nič več. Ni filozofski kamen, temveč zgolj lesena deska, s katero merimo..
Moj pristop je popolnoma nasprotje pristopu "od zgoraj navzdol", ki temelji na traceview, kjer analiza začne z vsemi trace-i in nato postopoma prehaja na posamezne span-e. Nasprotno, pristop "od spodaj navzgor" se začne z analizo majhnega dela, blizu potencialnega vzroka incidenta, nato pa se prostor iskanja širi po potrebi (z morebitnim vključevanjem drugih ekip za analizo širšega spektra storitev). Drugi pristop je bolje prilagojen za hitro preverjanje začetnih hipotez. Ko so pridobljeni konkretni rezultati, lahko preidemo na bolj usmerjeno in podrobno analizo.
Gradnja topologije
Povezani s specifikacijo storitve lahko biti izjemno koristni, če uporabnik ve, kateri servis ali skupina storitev povzroča povečanje zamud ali je vir napak. Vendar pa je v kompleksnem sistemu določitev storitve-kršitelja lahko naloga, ki ni trivialna med napako, še posebej, če poročila o napakah s storitev niso bila prejeta.
Gradnja topologije storitev lahko močno pomaga pri ugotavljanju, katera storitev prikazuje porast pogostosti napak ali povečanje zamude, kar vodi do opaznega poslabšanja delovanja storitve. Ko govorim o gradnji topologije, ne mislim na zemljevide storitev, ki prikazuje vse storitve v sistemu in so znane po svojih . Takšna predstava ni nič boljša od traceview, ki temelji na usmerjenem acikličnem grafu. Namesto tega bi želel videti dinamično generirano topologijo storitev, ki temelji na določenih atributih, kot so pogostost napak, čas odziva ali katerem koli parametrju, ki ga določijo uporabniki in pomaga razjasniti situacijo s specifičnimi sumljivimi storitvami.
Oglejmo si primer. Predstavljajmo si hipotetično novičarsko spletno stran. Glavna stran storitve (front page) izmenjuje podatke z Redisom, s priporočilno storitvijo, z oglasno storitvijo in video storitvijo. Video storitev pridobiva videoposnetke iz S3, medtem ko metapodatke pridobiva iz DynamoDB. Priporočilna storitev pridobiva metapodatke iz DynamoDB, nalaga podatke iz Redis in MySQL ter piše sporočila v Kafka. Oglasna storitev pridobiva podatke iz MySQL in piše sporočila v Kafka.
Spodaj je shematska slika te topologije (topologijo izdeluje mnoge komercialne programe za sledenje). To lahko pride prav, če se želite seznaniti z odvisnostmi storitev. Vendar pa med odpravljanje napak, ko določen servis (recimo, video storitev) pokaže povečano časovno odzivnost, taka topologija ni preveč uporabna.
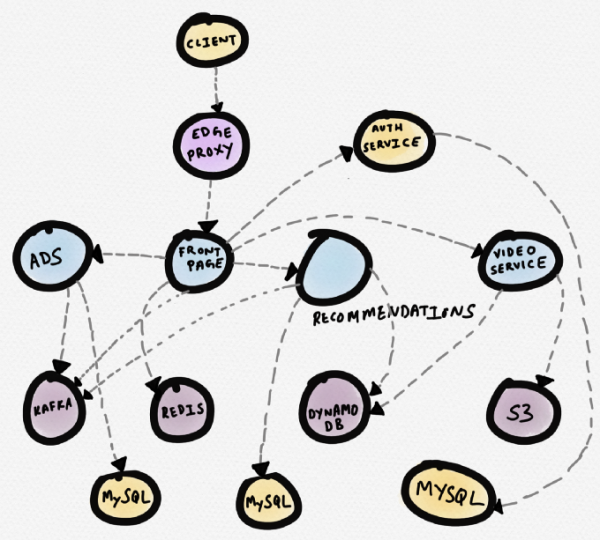
Shema storitev hipotetične novičarske strani
Bolje bi bila diagram, prikazan spodaj. Na njem je problematična storitev (video) prikazana prav v središču. Uporabnik jo takoj opazi. Iz te vizualizacije postane jasno, da video storitev deluje nenormalno zaradi povečanja časovne odzivnosti S3, kar vpliva na hitrost nalaganja dela glavne strani.
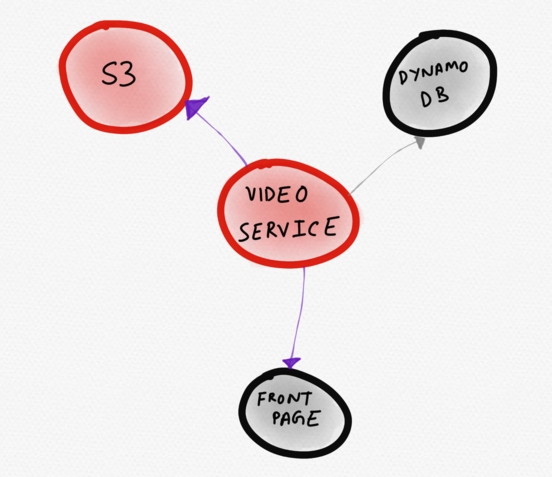
Dinamična topologija, ki prikazuje le "zanimive" storitve
Dinamično generirane topološke sheme so lahko bolj učinkovite od statičnih zemljevidov storitev, še posebej v elastičnih, avtomatsko skalirnih infrastruktura. Možnost primerjave in ujemanja topologij storitev omogoča uporabniku, da postavlja relevantnejša vprašanja. Natančnejša vprašanja o sistemu verjetneje privedejo do boljšega razumevanja delovanja sistema.
Primerjalna vizualizacija
Še ena uporabna vizualizacija bi bila primerjalna vizualizacija. Trenutno trace-i niso najbolj primerni za primerjavo drug ob drugem, zato se običajno primerjajo sekvence. Glavna ideja tega članka pa je, da so span-i preveč nizke ravni, da bi iz rezultatov sledenja izluščili najbolj dragocene informacije.
Primerjava dveh trace-ov ne zahteva načelno novih vizualizacij. V resnici zadostuje nekaj podobnega histogramu, ki predstavlja iste informacije kot traceview. Neverjetno, vendar tudi ta preprost način lahko prinese veliko več koristi kot preprosto raziskovanje dveh trace-ov posebej. Še bolj močna bi bila možnost vizualizirati usporedba trace'ova zajedno. Bilo bi izuzetno korisno vidjeti kako nedavno implementirana promjena konfiguracije baze podataka s uključenim GC (sakupljačem smeća) utječe na vrijeme odziva downstream usluge tijekom nekoliko sati. Ako ono što ovdje opisujem izgleda kao A/B analiza utjecaja infrastrukturnih promjena u mnogim uslugama uz pomoć rezultata praćenja, tada niste daleko od istine.
Zaključek
Ne dovodim u pitanje korisnost samog praćenja. Iskreno vjerujem da nema druge metode za prikupljanje toliko bogatih, slučajnih i kontekstualnih podataka kao što su oni sadržani u trace-u. Međutim, također smatram da svi alati za praćenje koriste ove podatke iznimno neučinkovito. Dokle god će alati za praćenje biti fokusirani na prikaz traceview-a, bit će ograničeni u mogućnosti maksimalnog iskorištavanja vrijednih informacija koje se mogu izvući iz podataka sadržanih u trace-ima. Osim toga, postoji rizik od daljnjeg razvoja izuzetno neprijateljskog i neintuitivnog vizualnog sučelja koje će ozbiljno ograničiti sposobnost korisnika za otklanjanje grešaka u aplikaciji.
Debagiranje složenih sustava, čak i uz korištenje najnovijih alata, nevjerojatno je teško. Alati moraju pomoći programerima da formiraju i testiraju hipoteze, aktivno pružajući relevantne informacije, identificirajući iznimke i primjećujući osobitosti u raspodjeli latencija. Kako bi praćenje postalo preferirani alat programera za otklanjanje grešaka u produkciji ili rješavanje problema koji obuhvaćaju različite usluge, potrebna su originalna korisnička sučelja i vizualizacije, koje u većoj mjeri odgovaraju mentalnom modelu programera koji stvaraju i koriste te usluge.
Bit će potrebno ozbiljno mentalno naprezanje kako bi se projektirao sustav koji će predstavljati različite signale dostupne u rezultatima praćenja na način optimiziran za olakšavanje analize i zaključivanja. Potrebno je osmisliti kako apstrahirati topologiju sustava tijekom debagiranja na način koji će pomoći korisniku da premosti slijepa mjesta, ne gledajući u pojedinačne trace-e ili span-e.
Potrebujemo dobre možnosti abstrakcije in delitve na ravni (zlasti v UI). Takšne, ki se dobro vključijo v proces odpravljanja napak na podlagi hipotez, kjer lahko iterativno postavljamo vprašanja in preverjamo hipoteze. Ne bodo same odpravile vseh težav z opazovanjem, vendar bodo pomagale uporabnikom izpopolniti intuicijo in oblikovati bolj premišljena vprašanja. Pozivam k bolj premišljenemu in inovativnemu pristopu na področju vizualizacije. Tu je resnična priložnost za širitev obzorij.
P.S. od prevajalca
Preberite tudi na našem blogu:
- «»;
- «»;
- «».
Izvor: habr.com
