

CAP teorema je temelj teorije distribuiranih sustava. Naravno, rasprave oko nje ne jenjavaju: definicije nisu kanoničke, a niti strogi dokazi ne postoje… Ipak, čvrsto držeći se svakodnevnog zdravog razuma™, intuitivno razumijemo da je teorem ispravan.
Jedina stvar koja nije očita je značenje slova "P". Kada se klaster podijeli, odlučuje – hoće li čekati da se postigne kvorum ili će poslati podatke koji su dostupni. Ovisno o rezultatima ovog izbora, sustav se klasificira kao CP ili AP. Na primjer, Cassandra se može ponašati na oba načina, ovisno ne samo o postavkama klastera, već i o parametrima svakog pojedinog upita. No ako sustav nije "P", i podijelio se, tada – što?
Odgovor na ovo pitanje je pomalo iznenađujući: CA klaster se ne može podijeliti.
Što je to klaster koji se ne može podijeliti?
Nepohodna oznaka takvog klastera je zajednički sustav za pohranu podataka. U većini slučajeva to podrazumijeva povezivanje putem SAN-a, što ograničava primjenu CA rješenja na velika poduzeća sposobna održavati SAN infrastrukturu. Da bi više strežnikov moglo raditi s istim podacima, potrebna je klasterska datotečna sustava. Takvi sustavi postoje u portfeljima HPE (CFS), Veritas (VxCFS) i IBM (GPFS).
Oracle RAC
Opcija Real Application Cluster prvi put se pojavila 2001. godine u izdanju Oracle 9i. U takvom klasteru, nekoliko instanci strežnika radi s istom bazom podataka.
Oracle može raditi i s klasterskim datotečnim sustavom, kao i s vlastitim rješenjem – ASM, Automatic Storage Management.
Svaka instanca vodi svoj dnevnik. Transakcija se izvršava i bilježi od strane jedne instance. U slučaju kvara instance, jedan od preživjelih čvorova klastera (instanci) čita njen dnevnik i obnavlja izgubljene podatke – zahvaljujući tome osigurava se dostupnost.
Sve instance podržavaju vlastiti cache, a iste stranice (blokovi) mogu istovremeno biti u cacheu više instanci. Štoviše, ako neka stranica treba jednoj instanci, a ona je dostupna u cacheu druge instance, može je dobiti od "susjeda" putem mehanizma cache fusion umjesto da je čita s diska.
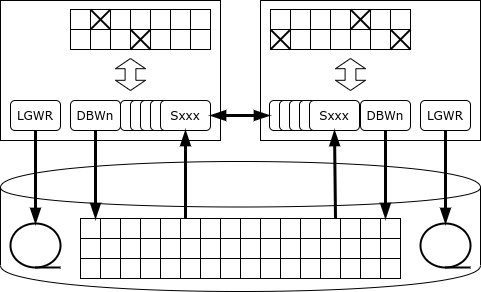
Kaj se zgodi, če enega od primerkov potrebuje za spremembo podatkov?
Posebnost Oracle-a je, da nima posebne storitve za zaklepanja: če strežnik želi zakleniti vrstico, se zapis o zaklepanju postavi neposredno na tisti strani pomnilnika, kjer je zaklenjena vrstica. Zaradi tega pristopa je Oracle prvak glede zmogljivosti med monolitnimi bazami: storitev zaklepanja nikoli ne postane ozka grla. V pačni konfiguraciji pa lahko taka arhitektura privede do intenzivne omrežne izmenjave in medsebojnih zaklepov.
Ko je zapis zaklenjen, instanca obvesti vse druge instance, da je stran, na kateri je shranjen ta zapis, zajeta v monopolnem načinu. Če drugi instanci potrebujejo spremeniti zapis na isti strani, mora počakati, dokler spremembe na strani niso potrjene, to jest, informacije o spremembi niso zabeležene v dnevniku na disku (medtem ko transakcija lahko poteka naprej). Lahko se tudi zgodi, da bo stran zaporedno spremenjena s strani več instanc, in nato ob zapisovanju strani na disk bo potrebno ugotoviti, kdo hrani aktualno različico te strani.
Naključna posodobitev istih strani preko različnih vozlišč RAC povzroča dramatičen padec zmogljivosti baze podatkov - do te mere, da je zmogljivost klasterja lahko nižja od zmogljivosti posamezne instance.
Pravilna uporaba Oracle RAC je fizična delitev podatkov (na primer, s pomočjo mehanizma sekcioniranih tabel) in dostop do vsakega sklopa sekcij preko posebnega vozlišča. Glavni namen RAC ni horizontalno skaliranje, temveč zagotavljanje odpornosti na okvare.
Če vozlišče preneha odgovarjati na heartbeat, tisto vozlišče, ki je to prvi zaznalo, začne postopek glasovanja na disku. Če tudi tukaj izgubljeno vozlišče ne pošlje znaka, prevzame eno od vozlišč naloge za obnovo podatkov:
- «zamrzne» vse strani, ki so bile v predpomnilniku izgubljenega vozlišča;
- prebere dnevnike (redo) izgubljenega vozlišča in ponovno uporabi spremembe, zapisane v teh dnevnikih, medtem ko preverja, ali imajo druga vozlišča svežje različice spreminjanih strani;
- odvuelve transacciones incompletas.
Para facilitar la conmutación entre nodos, Oracle cuenta con el concepto de servicio: una instancia virtual. Una instancia puede atender múltiples servicios, y un servicio puede trasladarse entre nodos. Una instancia de aplicación que atiende una parte específica de la base de datos (por ejemplo, un grupo de clientes) trabaja con un solo servicio, y el servicio responsable de esta parte de la base de datos se traslada a otro nodo en caso de que el nodo original falle.
IBM Pure Data Systems for Transactions
La solución de clúster para bases de datos apareció en el portafolio del Gigante Azul en 2009. Ideológicamente, es heredera del clúster Parallel Sysplex, construido sobre hardware 'común'. En 2009, se lanzó el producto DB2 pureScale, que es un paquete de software, y en 2012 IBM ofrece un conjunto software-hardware (appliance) llamado Pure Data Systems for Transactions. No debe confundirse con Pure Data Systems for Analytics, que no es más que un renombramiento de Netezza.
La arquitectura pureScale, a primera vista, se parece a Oracle RAC: de manera similar, varios nodos están conectados a un sistema de almacenamiento de datos común, y en cada nodo opera su propia instancia de base de datos con sus áreas de memoria y registros de transacciones. Sin embargo, a diferencia de Oracle, DB2 tiene un servicio de bloqueo dedicado, representado por un conjunto de procesos db2LLM*. En una configuración de clúster, este servicio se traslada a un nodo separado, que en Parallel Sysplex se llama facility de acoplamiento (CF), y en Pure Data – PowerHA.
PowerHA proporciona los siguientes servicios:
- gestor de bloqueos;
- caché de buffer global;
- área de comunicación entre procesos.
Para la transferencia de datos desde PowerHA a los nodos de base de datos y viceversa, se utiliza acceso remoto a la memoria, por lo que el interconector del clúster debe soportar el protocolo RDMA. PureScale puede usar tanto Infiniband como RDMA sobre Ethernet.
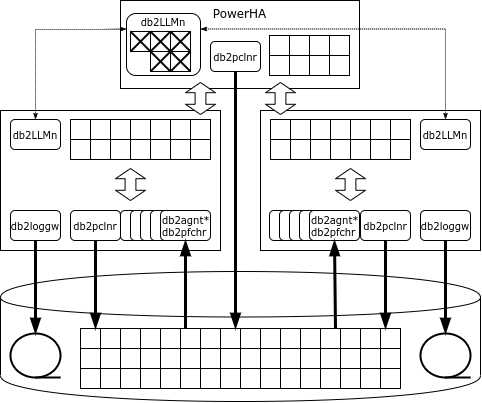
Si un nodo necesita una página y esta no está en el caché, el nodo solicita la página en el caché global, y solo en caso de que tampoco esté allí, la lee desde el disco. A diferencia de Oracle, la solicitud solo va a PowerHA, y no a nodos vecinos.
Če primerek namerava spremeniti vrstico, jo zaklene v ekskluzivnem načinu, stran, na kateri se nahaja vrstica, pa v deljenem načinu. Vse zaklepe se registrirajo v globalnem upravitelju zaklepov. Ko se transakcija zaključi, vozlišče pošlje sporočilo upravitelju zaklepov, ki kopira spremenjeno stran v globalni predpomnilnik, odstrani zaklepe in invalidira spremenjeno stran v predpomnilnikih drugih vozlišč.
Če je stran, v kateri se nahaja spremenjena vrstica, že zaklenjena, bo upravitelj zaklepov prebral spremenjeno stran iz pomnilnika vozlišča, ki je naredilo spremembe, odstranil zaklep, invalidiral spremenjeno stran v predpomnilnikih drugih vozlišč in dal zaklep strani vozlišču, ki ga je zahtevalo.
»Umazane«, torej spremenjene, strani se lahko zapišejo na disk tako z navadnega vozlišča kot tudi z PowerHA (castout).
Pri odpovedi enega izmed vozlišč pureScale je obnova omejena le na tiste transakcije, ki ob trenutni napaki še niso bile zaključene: strani, spremenjene s tem vozliščem v že zaključenih transakcijah, so na voljo v globalnem predpomnilniku na PowerHA. Vozlišče se ponovno zažene v omejeni konfiguraciji na enem izmed strežnikov v klastru, prekliče nedokončane transakcije in odstrani zaklepe.
PowerHA deluje na dveh strežnikih, pri čemer osnovno vozlišče sinhronizirano replikira svoje stanje. Ob odpovedi osnovnega vozlišča PowerHA klaster nadaljuje s delovanjem z rezervnim vozliščem.
Seveda, če dostopate do niza podatkov prek enega vozlišča, bo skupna zmogljivost klustra višja. PureScale lahko celo zazna, da nek del podatkov obdeluje eno vozlišče, in takrat bodo vsi zaklepi, ki se nanašajo na ta del, obdelani lokalno brez komunikacije s PowerHA. Vendar, ko se poskuša aplikacija obrniti na te podatke prek drugega vozlišča, se bo centralizirano obvladovanje zaklepov nadaljevalo.
Notranji testi IBM-a pri obremenitvi, ki obsega 90% branja in 10% pisanja, kar se zelo približno ujema z resnično industrijsko obremenitvijo, kažejo skoraj linearno skaliranje do 128 vozlišč. Pogoji testiranja, žal, niso razkriti.
HPE NonStop SQL
Svojo visoko razpoložljivo platformo ima tudi Hewlett-Packard Enterprise. To je platforma NonStop, ki jo je podjetje Tandem Computers lansiralo na trg leta 1976. Leta 1997 je podjetje prevzela Compaq, ki se je leta 2002 združila s Hewlett-Packardom.
NonStop se uporablja za gradnjo kritičnih aplikacij – na primer, HLR ali obdelavo bančnih kartic. Platforma se dobavlja kot programsko-hardware rešitev (appliance), ki vključuje računalniške vozlišča, shranjevanje podatkov in komunikacijsko opremo. Mreža ServerNet (v sodobnih sistemih – Infiniband) služi tako za izmenjavo med vozlišči kot za dostop do sistema shranjevanja podatkov.
V zgodnjih različicah sistema so se uporabljali lastniški procesorji, ki so bili sinhronizirani drug z drugim: vse operacije so se izvajale sinhrono z več procesorji, in ko je eden od procesorjev napak, je bil izključen, drugi pa je nadaljeval z delom. Kasneje je sistem prešel na običajne procesorje (sprva MIPS, nato Itanium in nazadnje x86), sinhronizacija pa se je začela izvajati z drugimi mehanizmi:
- sporočila: vsak sistemski proces ima dvojnik-‘senco’, ki mu aktivni proces redno pošilja sporočila o svojem stanju; ob napaki glavnega procesa senca začne delovati od trenutka, ki ga je določilo zadnje sporočilo;
- glasovanje: sistem za shranjevanje podatkov ima poseben strojni komponent, ki sprejema več enakih zahtevkov in jih izvede le, če se zahtevki ujemajo; namesto fizične sinhronizacije procesorji delujejo asinhrono, rezultati njihovega dela pa se primerjajo le v trenutkih vnosa/izvlečka.
Od leta 1987 na platformi NonStop deluje relacijska SGBD – najprej SQL/MP, nato pa SQL/MX.
Vsa baza podatkov je razdeljena na dele, za vsak del pa odgovarja svoj proces Data Access Manager (DAM). Ta omogoča zapisovanje podatkov, predpomnjenje in mehanizem zaklepanja. Z obdelavo podatkov se ukvarjajo izvršni procesi (Executor Server Process), ki delujejo na istih vozlih kot ustrezni upravljavci podatkov. Načrtovalnik SQL/MX deli naloge med izvajalce in združuje rezultate. Pri potrebnih usklajenih spremembah se uporablja protokol dvofaznega potrjevanja, ki ga zagotavlja knjižnica TMF (Transaction Management Facility).
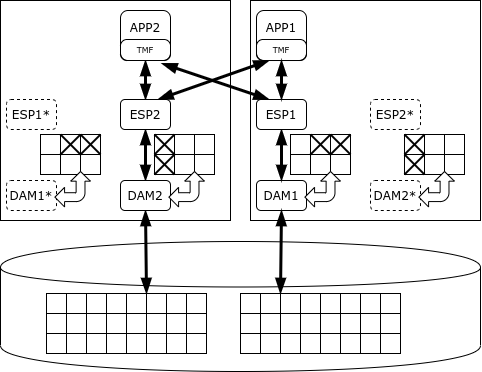
NonStop SQL zna prednostno obravnavati procese, tako da dolgi analitični poizvedbi ne ovira izvajanja transakcij. Vendar pa je njegovo osnovno poslanstvo obdelava kratkih transakcij, ne analitika. Razvijalec zagotavlja dostopnost klasterja NonStop na ravni petih devetk, kar pomeni, da traja izpad le 5 minut letno.
SAP HANA
Prva stabilna različica DBMS HANA (1.0) je izšla novembra 2010, paket SAP ERP pa je prešel na HANA maja 2013. Platforma temelji na pridobljenih tehnologijah: TREX Search Engine (iskanje v stolpčnem skladišču), DBMS P*TIME in MAX DB.
Beseda 'HANA' je akronim za High performance ANalytical Appliance. Ta DBMS se dobavlja v obliki kode, ki lahko deluje na katerem koli strežniku x86, vendar so industrijske namestitve dovoljene le na opremi, ki je opravila certifikacijo. Na voljo so rešitve HP, Lenovo, Cisco, Dell, Fujitsu, Hitachi, NEC. Nekatere konfiguracije Lenovo celo dopuščajo delovanje brez SAN - vlogo skupnega skladišča podatkov igra klaster GPFS na lokalnih diskih.
Za razliko od zgoraj navedenih platform je HANA DBMS v spominu, tj. primarni prikaz podatkov se shranjuje v pomnilniku, na disk pa se zapisujejo le dnevniki in občasni posnetki - za obnovitev v primeru okvare.
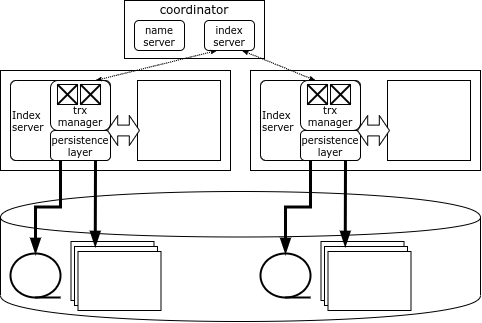
Vsak vozel klasterja HANA odgovarja za svoj del podatkov, karta podatkov pa se shranjuje v posebni komponenti - Name Server, ki se nahaja na koordinatnem vozlu. Podatki med vozli se ne podvajajo. Informacije o zaklepanju se prav tako shranjujejo na vsakem vozlu, vendar v sistemu obstaja globalni detektor medsebojnih zaklepov.
HANA klient při připojení ke clustri načítá jeho topologii a může se dále obracet přímo na kteroukoli uzel v závislosti na tom, jaká data potřebuje. Pokud transakce zasahuje do dat jednoho uzlu, může být provedena lokálně tímto uzlem, ale pokud se mění data několika uzlů, iniciátor uzlu se obrací na koordinátor uzlu, který otevírá a koordinuje rozloženou transakci a potvrzuje ji pomocí optimalizovaného protokolu dvoufázového potvrzení.
Koordinátor uzlu je duplikován, takže v případě, že koordinátor selže, se okamžitě aktivuje záložní uzel. Pokud však selže uzel s daty, je jediným způsobem, jak získat přístup k jeho datům, restartování uzlu. Obvykle se v clustrech HANA udržuje záložní (spare) server, aby bylo možné co nejrychleji restartovat ztracený uzel.
Izvor: habr.com
