

Danes bom povedal zgodbo. Zgodbo o evoluciji računalniške tehnologije in nastanku oddaljenih delovnih mest od davnih časov do danes.
Razvoj IKT
Glavna stvar, ki jo lahko potegnemo iz zgodovine IKT, je...
Seveda, da se IKT razvija spiralno. Iste rešitve in koncepti, ki so bili opuščeni pred desetletji, pridobijo nov pomen in uspešno začnejo delovati v novih pogojih, pri novih nalogah in z novimi zmogljivostmi. V tem pogledu se IKT ne razlikuje od katerekoli druge discipline človeškega znanja in zgodovine Zemlje nasploh.
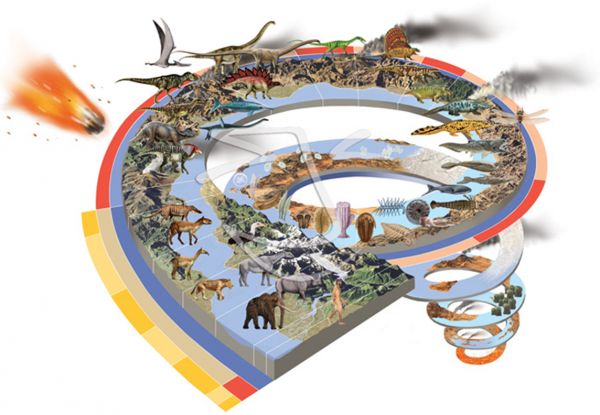
Nekoč, ko so bili računalniki veliki
"Mislim, da na svetu obstaja trg za približno pet računalnikov,” je dejal Thomas Watson, predsednik IBM-a, leta 1943.
Zgodnja računalniška oprema je bila ogromna. Ne, napačno, zgodnja oprema je bila ogromen, ciklopičen stroj. Popolnoma računalniška naprava je zavzela površino, primerljivo s športno dvorano, in stala povsem nerealne zneske. Kot primer komponent lahko navedemo modul pomnilnika na feritnih obročih (1964).
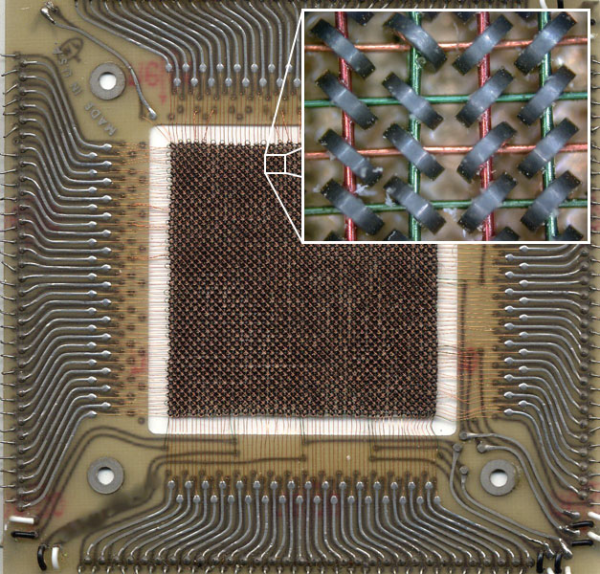
Ta modul je velik 11 cm * 11 cm in ima kapaciteto 512 bajtov (4096 bitov). Omara, popolnoma napolnjena s temi moduli, bi imela zares komaj toliko kapacitete kot že dolgo preteklost 3,5” disketa (1,44 MB = 2950 modulov), pri čemer je porabljala precejšnjo količino električne energije in se ogrevala kot parni stroj.
Prav z ogromnimi dimenzijami je povezano tudi angleško ime za odpravljanje napak v programskem kodi – “debugging”. Ena prvih programerk v zgodovini, Grace Hopper (da, ženska), oficirka mornarice, je leta 1945 zapisala v dnevnik dejanj po preiskavi napake v programu.
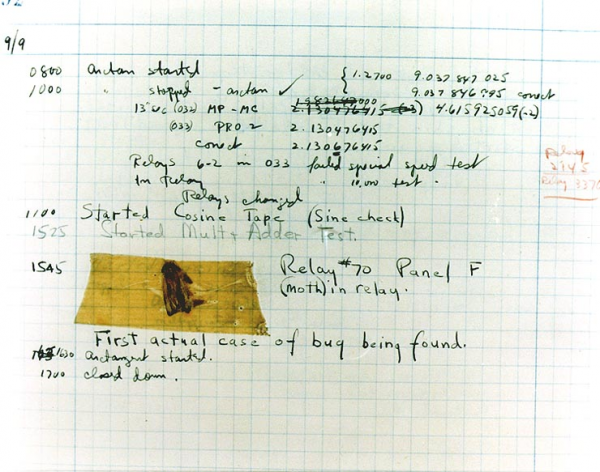
Ker je moth (moth) na splošno insekt, je bilo vse nadaljnje težave in ukrepe za rešitev osebje poročalo šefu kot “debugging” (do besede: razžužiti), tako da je za napako v programu in napako v kodi trdno ostalo ime bug, medtem ko je odpravljanje napak postalo debugging.
S postopnim razvojem elektronike in zlasti polprevodniške elektronike so se fizične dimenzije naprav začele zmanjševati, nasprotno pa se je računalniška moč povečevala. Vendar tudi v tem primeru ni bilo mogoče vsakemu zagotoviti osebnega računalnika.
"Ni nobenega razloga, da bi kdorkoli hotel imeti računalnik doma" — Ken Olsen, ustanovitelj DEC, 1977.
V 70. letih se pojavi izraz mini računalnik. Spomnim se, da sem, ko sem prvič prebral ta izraz pred mnogimi leti, pomislil na nekaj podobnega netbooku, skoraj na ročni računalnik. Nisem mogel biti dlje od resnice.
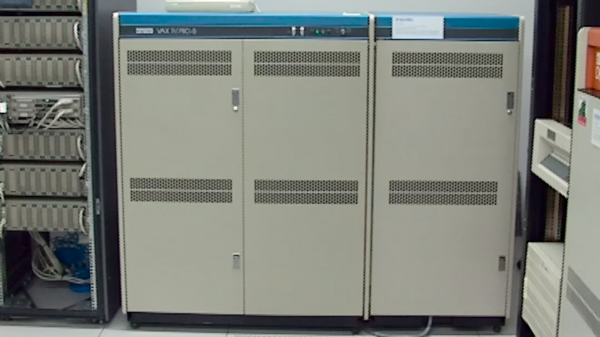
Mini — je le v primerjavi z ogromnimi računalniškimi dvoranami, a to je še vedno več omar z opremo, ki stane stotine tisoč evrov in milijone dolarjev. Vendar pa je računalniška moč že tako narasla, da ni bila vedno obremenjena na 100%, pri čemer so računalniki postali dostopni študentom in profesorjem univerz.
In tukaj je prišel ON!
Redko kdo se sprašuje o Latinah koreninah v angleščini, a ravno ta je prinesla oddaljen dostop, kot ga poznamo danes. Terminus (lat) — konec, meja, cilj. Cilj Terminatorja T800 je bil končati življenje Johna Conorja. Prav tako vemo, da so transportne postaje, na katerih se izvajajo vkrcanja in izkrcanja potnikov ali nalaganje in razkladanje tovora, imenovane terminali — končne točke poti.
Tako se je pojavila koncepta terminalskega dostopa, in lahko vidite najbolj znan terminal na svetu, ki še vedno živi v naših srcih.
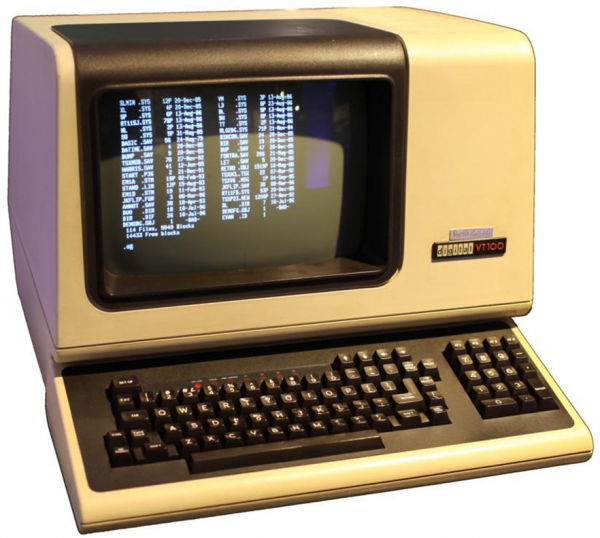
DEC VT100 se imenuje terminal, ker končuje informacijsko linijo. Ima dejansko ničelno računalniško moč, njegova edina naloga je prikazati prejeto informacijo iz velikega računalnika in posredovati vhod iz tipkovnice. In čeprav so VT100 fizično že dolgo mrtvi, jih še vedno v celoti uporabljamo.
Naši dnevi
“Naši dnevi” bi začel šteti od začetka 80. let, ko so se pojavili prvi dostopni procesorji z vsaj malo pomembno računalniško močjo. Tradicionalno se šteje, da je glavni procesor te dobe postal Intel 8088 (družina x86) kot predhodnik zmagovite arhitekture. Kakšna je torej načelna razlika v primerjavi s konceptom 70. let?
Pojavlja se tendenca prenašanja obdelave informacij iz središča na obrobje. Daleč od tega, da bi vse naloge potrebovale nore (v primerjavi z šibkim x86) zmogljivosti mainframe ali celo mini računalnika. Intel ne miruje, v 90. letih uvaja družino Pentium, ki postane pravzaprav prvi množično prisoten domači procesor v Rusiji. Ti procesorji so že sposobni veliko, ne le pisanja pisem — temveč tudi multimedije in delo z manjšimi podatkovnimi bazami. Dejansko za mala podjetja popolnoma odpade potreba po strežnikih — vse je mogoče izvajati na obrobju, na odjemalskih napravah. S vsakim letom so procesorji vse bolj zmogljivi, razlika med strežniki in osebnimi računalniki pa je vse manjša z vidika računalniške moči, pogosto ostane le v rezervi napajanja, podpori za vročo zamenjavo in posebnih ohišjih za montažo v racks.
Če primerjamo sodobne odjemalske procesorje „smešne“ za administratorje težkih strežnikov iz 90. let podjetja Intel s superračunalniki iz preteklosti, se lahko počutimo nekoliko nelagodno.
Poglejmo starega mačka, skoraj mojih let. Cray X-MP/24 iz leta 1984.
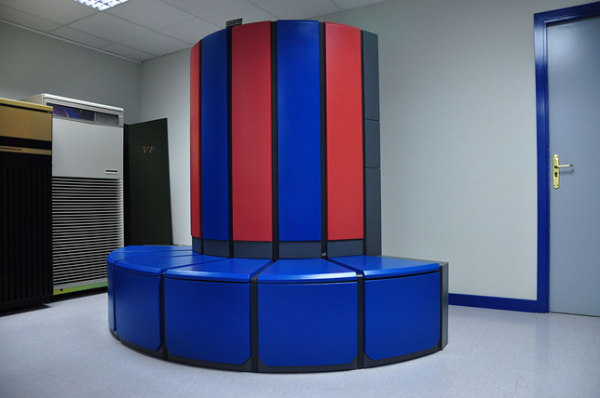
Ta stroj je bil na vrhu superračunalnikov leta 1984, imel je 2 procesorja po 105 MHz s pikovno računalniško močjo 400 MFlops (milijonov operacij s plavajočo vejico). Konkretno tisti stroj, ki je prikazan na fotografiji, je stal v laboratoriju za kriptografijo NSA ZDA in se ukvarjal z dekodiranjem šifer. Če pretvorimo 15 milijonov dolarjev iz leta 1984 v dolarje 2020, bi znašala cena 37,4 milijona, ali 93.500 dolarjev/MFlops.
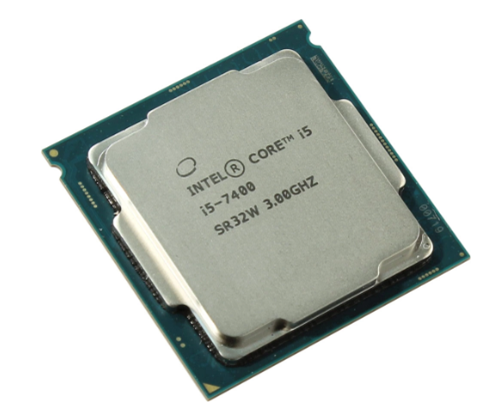
V stroju, s katerim pišem te vrstice, je procesor Core i5-7400 iz leta 2017, ki ni več vse nov, in je bil ob letu izida najmlajši 4-jedrni med vsemi namiznimi procesorji srednjega razreda. 4 jedra pri osnovni frekvenci 3.0 GHz (3.5 s Turbo Boost) in podvojeni tokovi HyperThreading dajejo od 19 do 47 GFlops moči pri različnih testih pri ceni 16 tisoč rubljev za procesor. Če zberem celotno mašino, bi njeno vrednost lahko ocenjevali na 750 dolarjev (po cenah in tečaju na 1. marec 2020).
Na koncu dobimo prednost povsem povprečnega namiznega procesorja naših dni od 50-120 krat nad superračunalnikom iz top 10 povsem bližnje preteklosti, padec specifičnih stroškov MFlops pa postane povsem grozljivih 93500/25 = 3700 krat.
Zakaj so nam še vedno potrebni strežniki in centralizacija računalništva ob takšnih zmogljivostih na periferiji — to je povsem nerazumljivo!
Povratni skok — spirala je zavila
Brezdiskovne delovne postaje
Prvi signal, da prenos obdelave na periferijo ne bo končen, je bila pojavitev tehnologije brezdiskovnih delovnih postaj. Pri pomembnem razporejanju delovnih postaj po podjetju, še posebej v onesnaženih prostorih, se postavlja zelo ostra vprašanja upravljanja in podpore teh postaj.
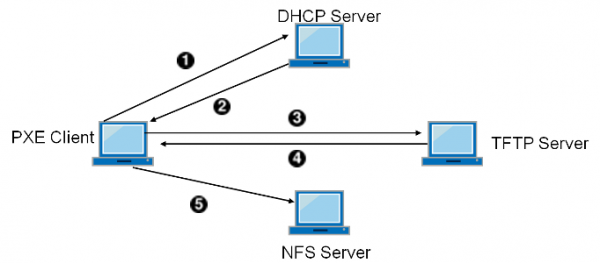
Pojavi se pojem 'hodniško čas' — tisti odstotek časa, ko je zaposlenec tehnične podpore na hodniku, na poti do zaposlenega s težavo. Ta čas je plačan, vendar povsem neroden. Pomembno vlogo, še posebej v onesnaženih prostorih, predstavljajo okvare trdih diskov. Odstranimo disk iz delovne postaje, vse ostalo pa izvedemo preko omrežja, vključno z nalaganjem. Omrežni adapter poleg naslova, ki ga pridobi od DHCP strežnika, dobi tudi dodatne informacije — naslov TFTP strežnika (poenostavljen datotečni servis) in ime zagonske slike, jo naloži v pomnilnik in zažene napravo.
Poleg manjše števila okvar in zmanjšanja hodniškega časa, zdaj naprave ni treba odpravljati na licu mesta, temveč jo preprosto prinesemo novo, staro pa odnesejo na diagnostiko na opremljeno delovno mesto. Ampak to še ni vse!
Brezdiskovna postaja postane bistveno varnejša — če kdo vdre v prostor in odnese vse računalnike, so to le izgube opreme. Na brezdiskovnih postajah se ne shranjujejo podatki.
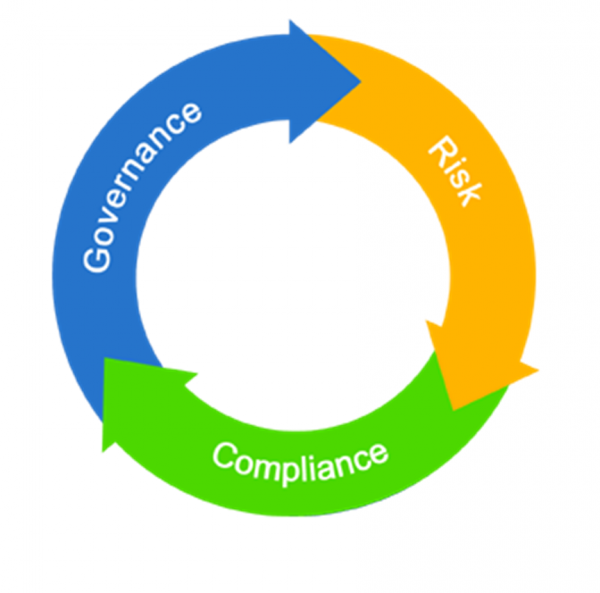
Zapomnimo si ta trenutek, kibernetska varnost igra vse pomembnejšo vlogo po 'brezdolžnem otroštvu' informacijskih tehnologij. In v IT vstopajo vse bolj strašne in pomembne tri črke — GRC (Upravljanje, Tveganje, Usklajenost), ali po rusko »Upravljivost, Tveganje, Usklajenost«.
Terminalski strežniki
Pojavitev vedno močnejših osebnih računalnikov na obrobju je znatno prehitela razvoj javnih omrežij. Klasične strankarsko-strežniške aplikacije iz 90-ih in začetka 00-ih niso dobro delovale po ozkem pasu, če je bila izmenjava podatkov kakorkoli pomembna. Še posebej težko je bilo oddaljenim pisarnam, ki so bile povezane prek modema in telefonske linije, ki se je občasno ustavila ali prekinila. In…
Zavrnitev je naredila krog in se spet znašla v terminalnem načinu s konceptom terminalskih strežnikov.
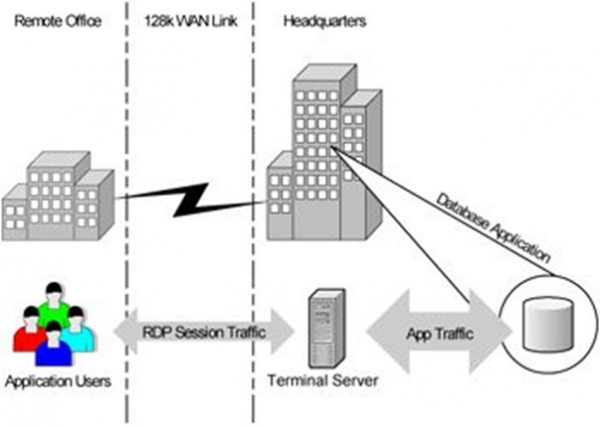
Dejansko smo se vrnili v 70. leta z njihovimi ničelnimi odjemalci in centralizacijo računske moči. Zelo hitro je postalo jasno, da poleg čiste ekonomske podlage s kanali terminalni dostop ponuja ogromne možnosti za organizacijo varnega dostopa od zunaj, vključujoč delo od doma za zaposlene ali zelo omejen in pod nadzorom dostop pogodbenikom iz nezaupljivih omrežij in nezaupljivih/nadzorovanih naprav.
Vendar pa so imel terminalski strežniki, kljub vsem svojim prednostim in progresivnosti, tudi vrsto slabosti — nizko prilagodljivost, težave s hrupnimi sosedi, strogo strežniški Windows itd.
Rojstvo protop VDI
Res je, da je v začetku in sredini 00-ih že množično izstopala industrijska virtualizacija x86 platforme. In nekdo je preprosto izpostavil idejo, ki je visela v zraku: zakaj ne bi namesto centralizacije vseh odjemalcev na strežniških terminalskih farmah vsakemu podarili njegovo osebno VM z odjemalskimi Windows in celo administratorskim dostopom?
Odmik od debelih odjemalcev
Vzporedno z virtualizacijo sej in OS se je razvijal pristop, povezan z poenostavitvijo funkcije odjemalca na ravni aplikacije.
Logika za tem je bila precej preprosta, saj osebni prenosni računalniki niso bili dostopni vsem, internet zagotovo ni bil dostopen vsem, in mnogi so se lahko povezali le iz internetnih kavarn z zelo omejenimi, milo rečeno, pravicami. Dejansko je bilo vse, kar so lahko zagnali, brskalnik. Brskalnik je postal nujen atribut OS, internet pa je trdno vstopil v naše življenje.
Drugače povedano, vzporedno se je odvijal trend prenosa logike z odjemalca v središče v obliki spletnih aplikacij, za dostop do katerih je potreben le najpreprostejši odjemalec, internet in brskalnik.
In the end, we found ourselves not just where we started — with zero clients and central servers. We arrived there through several independent paths.
Virtual Desktop Infrastructure
Broker
In 2007, the market leader in industrial virtualization, VMware, released the first version of its product VDM (Virtual Desktop Manager), which effectively became the first in the nascent virtual desktop market. Unsurprisingly, we didn’t have to wait long for a response from the leader in terminal servers, Citrix, which introduced XenDesktop in 2008 after acquiring XenSource. Of course, there were other vendors with their offerings, but let’s not delve too deeply into history, straying from the concept.
And the concept still persists. The key component of VDI is the connection broker.
This is the heart of the virtual desktop infrastructure.
The broker is responsible for the most important processes of VDI operation:
- Identifies available resources (machines/sessions) for the connected client;
- Balances clients among the pools of machines/sessions as needed;
- Redirects the client to the selected resource.
Today, the client (terminal) for VDI can be virtually anything with a screen — a laptop, smartphone, tablet, kiosk, thin or zero client. The responding part, which performs the productive load, is the terminal server session, a physical machine, or a virtual machine. Modern mature VDI products are closely integrated with the virtual infrastructure and manage it automatically, deploying or conversely, removing unnecessary virtual machines.
While somewhat separate, hardware acceleration support for 3D graphics is extremely important for certain clients, such as designers and architects, in the context of VDI.
Protokol
Another extremely important part of a mature VDI solution is the access protocol to virtual resources. When it comes to operating within a corporate local network with a reliable 1 Gbps connection to the workplace and a latency of 1 ms, virtually any protocol can be used without much thought.
Pomembno je razmisliti, ko povezava poteka prek neobvladovane omrežne povezave, kjer je kakovost te mreže lahko povsem nepredvidljiva, z hitrostmi v desetih kilobitih in nepredvidljivimi zakasnitvami. To je pravzaprav ključno za organizacijo pravega oddaljenega dela, bodisi iz vikendov, iz doma, iz letališč in restavracij.
Terminalski strežniki proti odjemalskim VM
Ko se je pojavil VDI, se je zdelo, da je čas, da se poslovimo od terminalskih strežnikov. Zakaj so potrebni, če ima vsak svojo osebno VM?
Vendar pa se je iz čiste ekonomske perspektive izkazalo, da za običajne množične delovne postaje, ki so enake do nezadostne mere, ni nič bolj učinkovitega od terminalskih strežnikov v razmerju cena / sešnja. Kljub številnim prednostim pristop "1 uporabnik = 1 VM" porabi precej več virov za virtualno opremo in popoln operacijski sistem, kar poslabša ekonomiko pri običajnih delovnih mestih.
V primeru delovnih mest za vrhnje menedžerje, nestandardnih in obremenjenih delovnih mest, kjer je potrebna visoka raven dostopa (do administratorja), ima prednost dodeljena VM za uporabnika. V okviru te VM je mogoče individualno dodeliti vire, podeliti pravice katerekoli ravni ter uravnotežiti VM med virtualizacijskimi gostitelji pri visoki obremenitvi.
VDI in ekonomija
Letos slišim isto vprašanje — ali ni VDI cenejši od preprosto podeljevanja prenosnikov vsem? In že vrsto let odgovarjam na enak način: v primeru običajnih pisarniških zaposlenih VDI ni cenejši, če upoštevamo čiste stroške zagotavljanja opreme. Ne glede na vse, prenosniki postajajo cenejši, strežniki, SHR in sistemska programska oprema pa stanejo precej denarja. Če je prišel čas, da posodobite park in razmišljate o prihrankih z VDI — ne, ne boste prihranili.
Prej sem omenjal strašne tri črke GRC — in tako je, VDI je o GRC. Gre za upravljanje tveganj, gre za varnost in udobje nadzorovanega dostopa do podatkov. In vse to običajno stane precej velike zneske za uvedbo na vseh možnih heterogenih napravah. Z VDI se nadzor poenostavi, varnost se povečuje, lasje pa postanejo mehki in svilnati.
HPE rešitve za oddaljeno delo
Oddaljeno in oblačno upravljanje
iLO
Podjetje HPE ni novinec na področju oddaljenega upravljanja strežniške infrastrukture. Marca je minilo 18 let legendarnega iLO (Integrated Lights Out). Spominjam se svojih administrativnih dni v 00-ih, ko sem bil navdušen. Prvič montaža v omare in povezovanje kablov — to je bilo vse, kar je bilo potrebno storiti v hrupnem in hladnem podatkovnem centru. Vse ostalo konfiguriranje, vključno z namestitvijo operacijskega sistema, je bilo mogoče opraviti že z delovnega mesta, z dvema monitorjema in skodelico vroče kave. In to je bilo pred 13 leti!
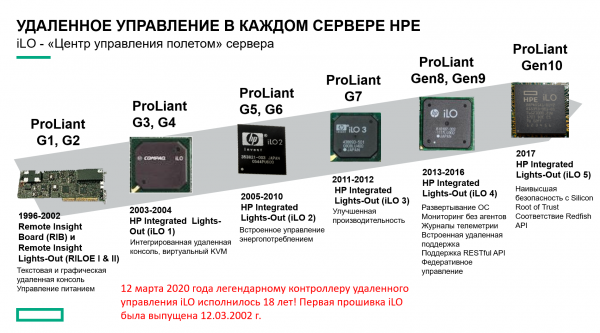
Trenutno so strežniki HPE upravičeno večletni standard kakovosti — v tem pa pomembno vlogo igra zlati standard sistema oddaljenega upravljanja — iLO.
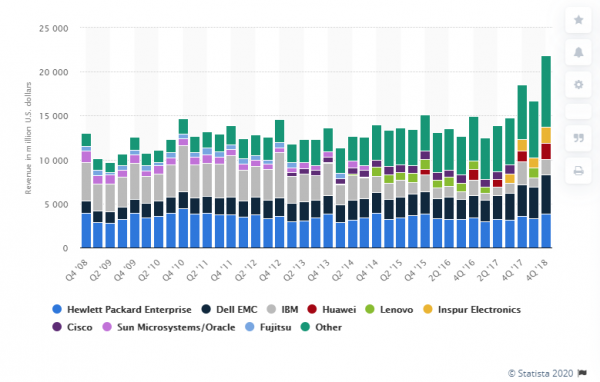
Posebej bi rad izpostavil dejanja HPE pri ohranjanju nadzora človeštva nad koronavirusom. , da bo do konca leta 2020 (vsaj) licenca iLO Advanced na voljo vsem brezplačno.
Infosight
Če imate več kot 10 strežnikov v infrastrukturi in skrbnik ne umira od dolgočasja, bo seveda odlična dopolnitev k standardnim sredstvom za spremljanje oblačni sistem HPE Infosight, ki temelji na umetni inteligenci. Sistem ne le spremlja stanje in gradi grafikon, temveč samostojno priporoča nadaljnje ukrepe na podlagi trenutne situacije in trendov.
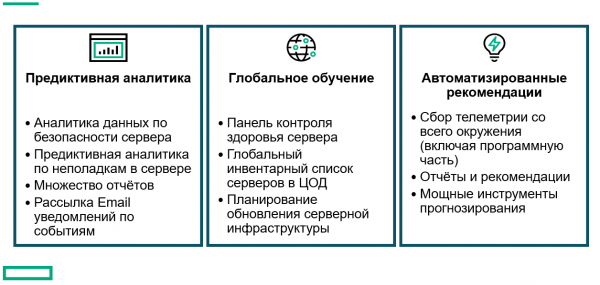
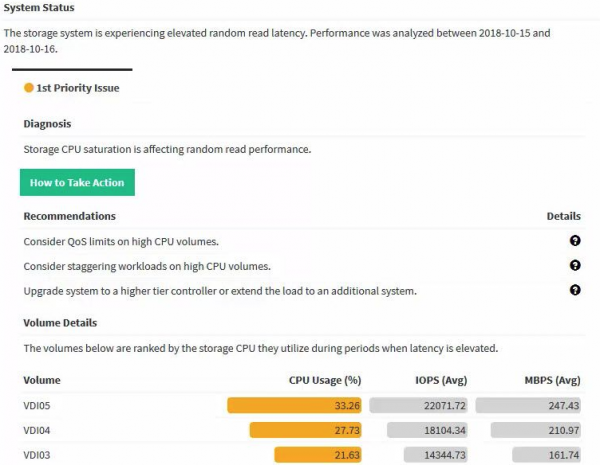
Bodi pameten, , poskusi Infosight!
OneView
Nazadnje, a ne manj pomembno, želim izpostaviti HPE OneView — celoten produktni portfelj z ogromnimi možnostmi za spremljanje in upravljanje celotne infrastrukture. In vse to brez vstajanja od delovne mize, ki je v trenutni situaciji lahko tudi na vikendu.
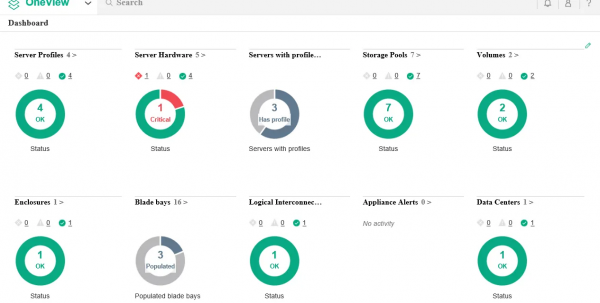
RAID sistemi tudi niso iz lesa!
Seveda, vsi RAID sistemi se upravljajo in spremljajo na daljavo — tako je bilo že pred mnogimi leti. Zato želim danes govoriti o nečem drugem, in sicer o metro-klasterjih.
Metro-klasterji niso novost na trgu, a prav zaradi tega ostajajo še vedno precej nepogodni — odraža se inertnost razmišljanja in prvi vtisi. Seveda so že pred 10 leti obstajali, vendar so stali kot železni most. Leta, ki so minila od prvih metro-klasterjev, so spremenila industrijo in dostopnost tehnologije široki javnosti.
Spominjam se projektov, kjer so namerno razdelili dele shranjevanja podatkov — posebej za izjemno kritične storitve v metroklastru, posebej za sinhrono replikacijo (veliko ceneje).
Dejansko, v letu 2020 metroklastr za vas ne stane nič, če ste sposobni organizirati dve lokaciji in povezave. Povezave za sinhrono replikacijo so namreč povsem enake tistim, ki jih potrebujete za metroklastre. Licenciranje programske opreme že dolgo poteka v paketih — tako sinhrona replikacija kot metroklastri se prodajajo skupaj, edina stvar, ki trenutno ohranja enosmerno replikacijo, je potreba po organizaciji raztegnjene L2 mreže. In tudi to, L2 over L3 že močno napreduje po Sloveniji.
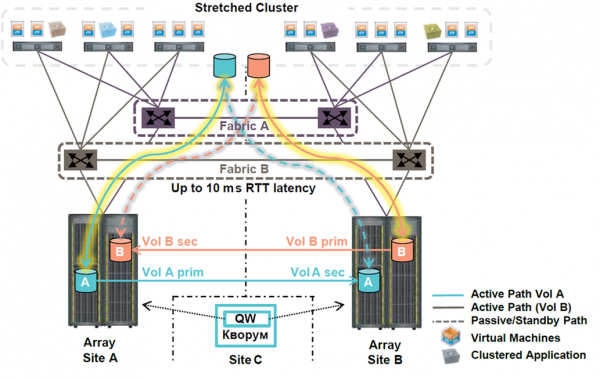
Kakšna je torej načelna razlika med sinhrono replikacijo in metroklastrom z vidika oddaljenega dela?
Vse je zelo preprosto. Metroklastr deluje samodejno, vedno, praktično takoj.
Kako izgleda postopek preklopa obremenitve na sinhroni replikaciji v infrastrukturi z vsaj nekaj sto VM?
- Prejeto je obvestilo o okvari.
- Dežurna ekipa analizira situacijo — lahko mirno načrtujete od 10 do 30 minut samo za prejem obvestila in sprejemanje odločitve.
- V primeru, da dežurni inženirji nimajo pooblastil za samostojen zagon preklopa — še 30 minut za komunikacijo z osebo, ki ima pooblastila, in formalno potrditev začetka preklopa.
- Pritisnite Veliki Rdeči Gumb.
- 10-15 minut za časovne zamude in ponovno montažo volumenov, ponovno registracijo VM.
- 30 minut za spremembo IP naslova — optimistična ocena.
- In nazadnje zagon VM in zagon produktivnih storitev.
Na koncu RTO (čas do obnove poslovnih procesov) lahko mirno ocenimo na 4 ure.
Primerjajmo s situacijo na metroklastru.
- Shranjevanje podatkov razume, da je povezava z ramo metroklastra izgubljena — 15-30 sekund.
- Gostitelji virtualizacije razumejo, da je prvi podatkovni center izgubljen — 15-30 sekund (hkrati s točko 1).
- Samodejni ponovni zagon od polovice do tretjine VM v drugem podatkovnem centru — 10-15 minut do nalaganja storitev.
- Približno v tem času dežurna ekipa razume, kaj se je zgodilo.
Skupaj: RTO = 0 za posamezne storitve, 10-15 minut v splošnem primeru.
Zakaj pa ponovni zagon le od polovice do tretjine VM? Poglejte, v čem je težava:
- Vi vse delate pametno in aktivirate samodejno uravnoteženje VM. Na koncu se v povprečju le polovica VM izvaja v enem od podatkovnih centrov. Saj je celoten smisel metroklastra v minimiziranju zastojev, zato je v vašem interesu minimizirati tudi število VM pod udarcem.
- Del storitev lahko klasteriziramo na ravni aplikacij, razporedimo jih po različnih VM. Ustrezno so ti parni VM pritrjeni z žeblji ali povezani z trakom z različnimi podatkovnimi centri, tako da storitev sploh ne čaka na ponovni zagon VM v primeru okvare.
Pri pravilno zgrajeni infrastrukturi z raztegnjenimi metroklastri poslovni uporabniki delajo z minimalnimi zamudami s katere koli točke, tudi v primeru okvare na ravni podatkovnega centra. V najslabšem primeru bo zamuda trajala toliko časa, kot da si zapolnite kozarec kave.
In seveda, metroklastri odlično delujejo tako na HPE 3Par, ki se umikajo proti Valinoru, kot tudi na novih Primera!
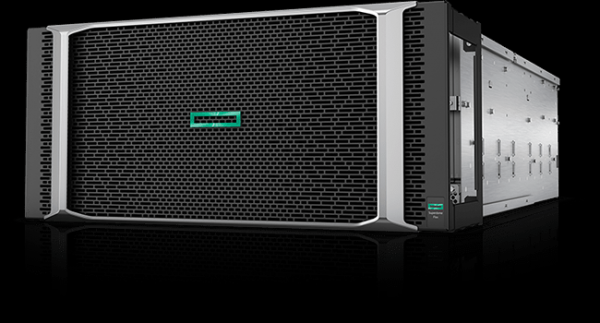
Infrastruktura oddaljenih delovnih mest
Terminalski strežniki
Za terminalske strežnike ni treba izumljati nič novega, HPE že vrsto let dobavlja ene najboljših strežnikov na svetu zanje. Večna klasika — DL360 (1U) ali DL380 (2U) ali za ljubitelje AMD — DL385. Seveda so tu tudi blade strežniki, tako klasični C7000, kot tudi nova modularna platforma Synergy.
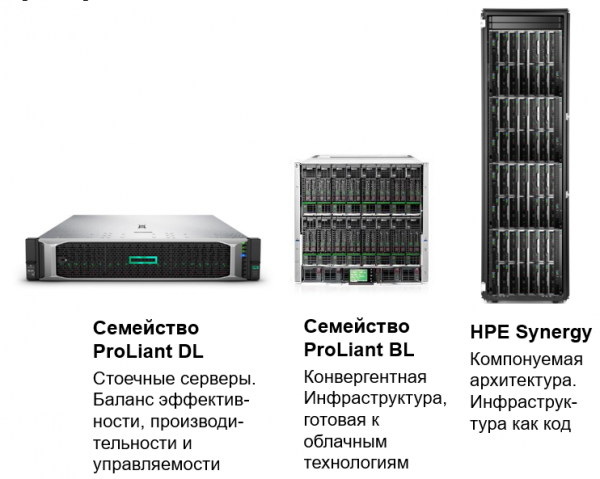
Za vsak okus, za vsako barvo, največ sej na strežnik!
“Klasičen” VDI + HPE Simplivity
V tem primeru, ko govorim o “klasičnem VDI”, imam v mislih koncept 1 uporabnik = 1 VM s klientskimi Windows. Seveda ni nič bližjega in poznejšega VDI obremenitvam za hiperkonvergentne sisteme, še posebej z deduplikacijo in stiskanjem.
Tukaj HPE lahko ponudi tako svojo hiperkonvergentno platformo Simplivity, kot tudi strežnike / certificirane vozlišča pod rešitve partnerjev, na primer VSAN Ready Nodes za gradnjo VDI na infrastrukturi VMware VSAN.
Pogovorimo se malo več o lastni rešitvi Simplivity. Na vrhu, kot nam nežno nakazuje ime, je postavljena preprostost (angleško simple — preprosto). Enostavnost uvajanja, enostavnost upravljanja, enostavnost razširjanja.
Hiper-konvergenčne sisteme su danas jedna od najtoplijih tema u IT-u, a broj različitih dobavljača iznosi oko 40. Prema Gartnerovom magičnom kvadratu, kompanija HPE se nalazi među pet najboljih na globalnom nivou i spada u kvadrat lidera — oni razumeju u kom pravcu se industrija kreće i sposobni su da tu viziju implementiraju u hardver.
Arhitektura Simplivity je klasičan hiper-konvergenčni sistem sa kontroler virtuelnim mašinama, što znači da može podržavati različite hipervizore, za razliku od sistema integrisanih u hipervizor. U aprilu 2020. godine podržavaju se VMware vSphere i Microsoft Hyper-V, a takođe su najavljeni planovi za podršku KVM-u. Ključna karakteristika Simplivity od njenog pojavljivanja na tržištu je hardversko ubrzanje kompresije i deduplikacije putem specijalizovane akceleratorske kartice.
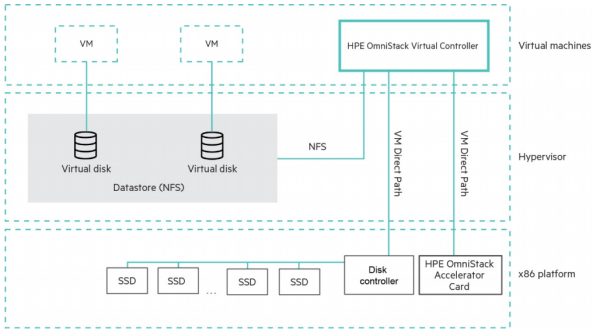
Treba napomenuti da kompresija i deduplikacija predstavljaju globalne i stalno uključene funkcionalnosti, što znači da to nije opcionalna funkcija, već arhitektura rešenja.
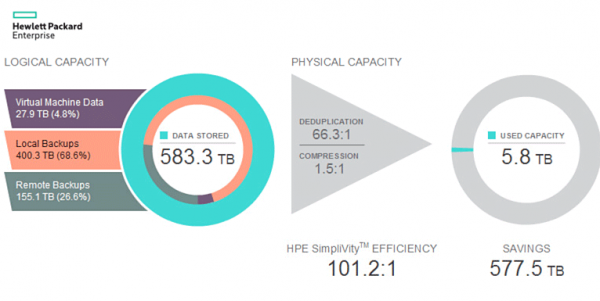
HPE naravno donekle preuveličava kada tvrdi efikasnost 100:1, računajući na poseban način, ali efikasnost korišćenja prostora zaista je veoma visoka. Prosta brojka 100:1 je previše zanosna. Pogledajmo kako je Simplivity tehnički realizovana da bi pokazivala takve brojke.
Snapshot. Snaphotovi (trenutni snimci) su 100% pravilno realizovani kao RoW (Redirect-on-Write), i stoga se dešavaju trenutna bez uticaja na performanse. Razlikuju se, recimo, od nekih drugih sistema. Zašto su nam potrebni lokalni snapshotovi bez kazni? Vrlo jednostavno, da bismo smanjili RPO sa 24 sata (prosečan RPO za backup) na desetine ili čak jedinice minuta.
Backup. Snapshot se od backup-a razlikuje samo po tome kako ga sistem upravljanja virtuelnim mašinama percipira. Ako se brisanjem mašine obriše i sve ostalo — to znači da je to bio snapshot. Ako nešto ostane — to znači da je backup (rezervna kopija). Tako svaki snapshot može biti smatran i punim backup-om, ako ga sistem označi i ne obriše.
Seveda, mnogi bodo ugovarjali — kaj je to za ena varnostna kopija, če je shranjena na istem sistemu? Tu je zelo preprost odgovor v obliki povratnega vprašanja: povejte, ali imate formalni model groženj, ki določa pravila shranjevanja varnostne kopije? To je popolna varnostna kopija pred izbrisanjem datoteke znotraj VM, to je varnostna kopija pred izbrisanjem same VM. V primeru, da je nujno shraniti varnostno kopijo izključno na ločenem sistemu, obstaja možnost: replikacija tega posnetka na drugo vozlišče Simplivity ali na HPE StoreOnce.
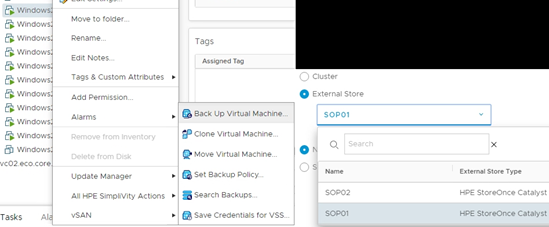
In prav tu se izkaže, da taka arhitektura idealno ustreza vsem vrstam VDI. Saj so VDI — to stotine ali celo tisoče zelo podobnih naprav z istim operacijskim sistemom in istimi aplikacijami. Globalna deduplikacija vse to prebavi in stisne ne le 100:1, ampak še boljše. Namestiti 1000 VM iz enega predloge? Sploh ni težava, te naprave se bodo dlje registrirale v vCenterju, kot pa se bodo klonirale.
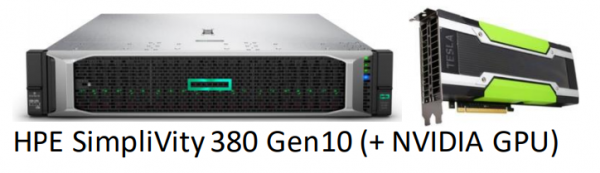
Posebej za uporabnike s posebnimi zahtevami glede zmogljivosti in za tiste, ki potrebujejo 3D pospeševalnike, je bila ustvarjena serija Simplivity G.
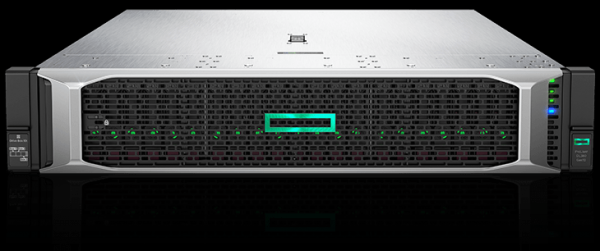
V tej seriji se ne uporablja strojni pospeševalnik deduplikacije, zato je zmanjšano število diskov na vozlišče, da se kontroler lahko spopade s programskim obvladovanjem. To omogoča sprostitev PCIe rež za druge pospeševalnike. Prav tako je podvojen obseg razpoložljive pomnilnika na vozlišče na 3TB za najbolj zahtevne obremenitve.
Simplivity je idealna za organizacijo geografsko razpršenih VDI infrastruktur z replikacijo podatkov v centralni podatkovni center.
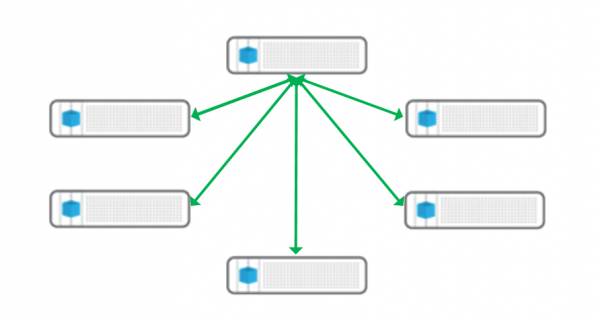
Takšna arhitektura VDI (in, mimogrede, ne samo VDI) je še posebej zanimiva v razmerah v Rusiji — ogromne razdalje (in posledično zamude) ter daleč od popolnih kanalov. Postavljajo se regionalni centri (ali pa celo 1-2 vozlišča Simplivity v čisto oddaljenem uradu), kamor se lokalni uporabniki povezujejo preko hitrih kanalov, ohranja se popoln nadzor in upravljanje iz središča, v središče pa se replikira le majhna količina že pravih, dragocenih, ne pa odpadnih podatkov.
Seveda se Simplivity popolnoma povezuje z OneView in InfoSight.
Tanki in ničelni odjemalci
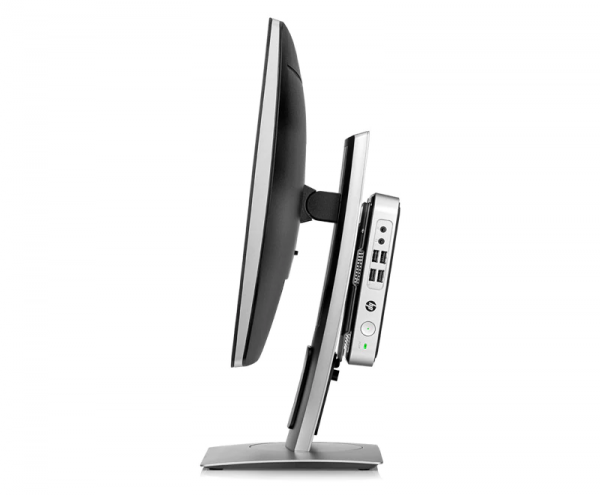
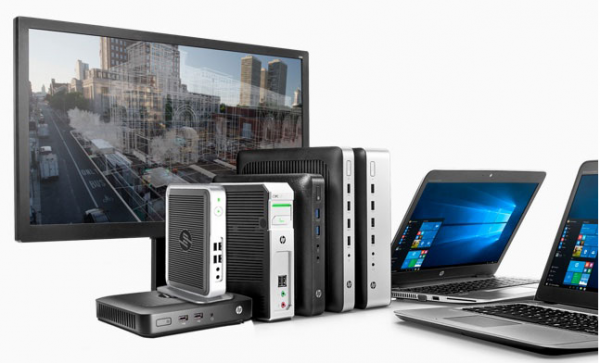
Tanki klijenti su specijalizovana rešenja koja se koriste isključivo kao terminali. Budući da na klijentu zapravo nema opterećenja osim održavanja kanala i dekodiranja videa, obično je tu procesor sa pasivnim hlađenjem, sitna boot jedinica samo za pokretanje specijalizovanog ugrađenog operativnog sistema, i to je otprilike sve. Teško da može da se pokvari, a krađa je besmislena. Cena je mala i nikakvi podaci se u njemu ne čuvaju.
Postoji posebna kategorija tankih klijenata, takozvani nulti klijenti. Njihova osnovna razlika u odnosu na tanke klijente je u tome što nemaju ni ugrađeni operativni sistem opšte namene, već rade isključivo sa mikročipom sa firmverom. Često se u njih ugrađuju specijalni hardverski akceleratori za dekodiranje video potoka u terminalnim protokolima kao što su PCoIP ili HDX.
Iako je velika kompanija Hewlett Packard podeljena na odvojene HPE i HP, ne možemo a da ne pomenemo tanke klijente koje proizvodi HP.
Izbor je širok, za svaki ukus i potrebe — čak i do radnih mesta sa više monitora sa hardverskim akceleracijom video potoka.
HPE usluge za vaš rad na daljinu
I na kraju, ali ne manje važno, želim da pomenem HPE uslugu. Bilo bi predugo nabrajati sve nivoe HPE usluge i njene mogućnosti, ali postoji jedno izuzetno važno ponudno rešenje u uslovima rada na daljinu. Naime, servisni inženjer iz HPE/autorizovanog servisnog centra. Vi nastavite da radite daljinski, s vaše omiljene vikendice, slušajući pčele, dok pčelica iz HPE, dolazeći u data centar, menja hard diskove ili pokvarene napajanja u vašim serverima.
HPE CallHome
U današnjim uslovima, pri ograničenju kretanja, funkcija Call Home postaje važnija nego ikada. Svaki HPE sistem sa ovom funkcijom može samostalno obavestiti HPE podršku o hardverskom ili softverskom kvaru. I vrlo verovatno, deo za zamenu i/ili servisni inženjer dolazi kod vas još pre nego što primetite kvarove i probleme sa produktivnim uslugama.
Lično, toplo preporučujem da uključite ovu funkciju.
Izvor: habr.com
