

Moje ime je Sergey, iz tvrtke ITSumma, i želim vam ispričati kako pristupamo rezerviranju u Kubernetesu. U posljednje vrijeme puno sam se bavio savjetovanjem o implementaciji raznih devops rješenja za različite timove, a posebno radim na projektima koji koriste K8s. Na konferenciji Uptime day 4, koja je bila posvećena rezerviranju u složenim arhitekturama, održao sam izlaganje o rezerviranju 'kubika', i evo njegovog slobodnog sažetka. Samo unaprijed želim upozoriti da to nije neposredni vodič za akciju, već više zbirka razmišljanja o navedenoj temi.
U osnovi, praćenje i rezerviranje su dva osnovna alata za povećanje otpornosti bilo kojeg projekta. No, kako vi kažete, u K8s se sve samo balansira, sve se samo skalira, i ako se nešto dogodi - samo će se pokrenuti... Dakle, na prvo površno istraživanje teme, internet mi je odgovorio na pitanje kako tko pristupa rezerviranju K8s sa 'zašto?'. Mnogi misle da K8s predstavlja neku čarobnu stvar koja oslobađa od svih infrastrukturnih problema i čini da projekt nikada ne propadne. Ali... svijet nije ono što se čini.
Kako smo ranije pristupali procesu rezerviranja? Imali smo identične platforme za hosting - bile su to ili virtualne mašine ili fizički serveri servere, na koje smo primjenjivali tri osnovne prakse:
- synchronizacija koda i statike
- synchronizacija konfiguracija
- replikacija baza podataka
I voila: u svakom trenutku prebacujemo se na rezervnu platformu, svi su sretni, ustajem-i-odlazimo.
Kaj nam ponujajo za povečanje stalne dostopnosti naše aplikacije Kubernetes? Prvo, o čemer govori neformalna dokumentacija, je postaviti veliko naprav, ustvariti veliko master naprav — njihovo število mora zadovoljiti pogoje za dosego quoruma znotraj klasterja, in da ima vsak od masterjev zagnan etcd, api, MC, scheduler… In, tako se zdi, je vse čudovito: ko več delovnih vozlišč ali master naprav ne deluje, se naš klaster preuredi in aplikacija še naprej deluje. Spet zgleda kot čarovnija! Ampak pogosto se naš klaster nahaja v okviru enega podatkovnega centra, kar lahko povzroči določene težave. Kaj pa, če pride buldožer in izkoplje kabel, udari strela, pride do potopa? Vse je propadlo, našega klasterja ni več. Kako pristopiti k rezervaciji ob upoštevanju te plati problema?
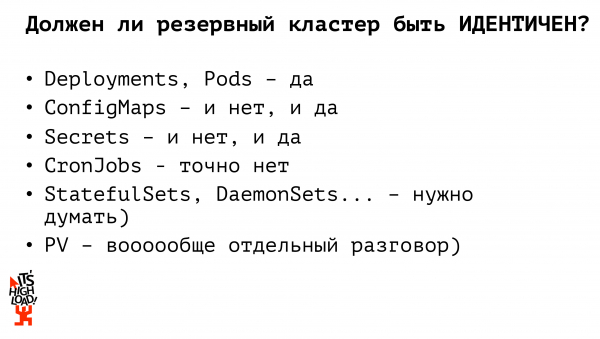
Najprej morate imeti še en klaster v vroči rezervi, torej klaster, na katerega se lahko kadarkoli preklopite. Pri tem morata biti z vidika Kubera infrastruktura popolnoma enaka. Torej, če obstajajo kakšni nestandardni vtičniki za delo z datotečnim sistemom, prilagojene rešitve za ingress, morajo biti popolnoma enake na vaših dveh (ali treh, ali desetih, koliko denarja in truda upraviteljev zadošča) klasterjih. Potrebno je jasno opredeliti dva sklopa aplikacij (deploymentov, statefulsetov, daemonsetov, cronjobov itd.): katere od njih lahko neprekinjeno delujejo na rezervi, in katere je bolje ne zagnati do neposrednega preklopa.
Ali mora biti naš rezervni klaster popolnoma identičen našemu produkcijskemu klasterju? Ne. Če smo prej v okviru dela z monolitnimi projekti, z železno infrastrukturo, ohranjali skoraj popolnoma identično okolje, pa v okviru Kubera menim, da to ne bi smelo biti. Poglejmo, zakaj.
Začnimo z osnovnimi entitetami Kubernetes – deployments – ki morajo biti enaki. Aplikacije morajo biti zagnane, da lahko kadarkoli prevzamejo upravljanje s prometom in omogočijo našemu projektu, da še naprej deluje. Ko govorimo o konfiguracijskih datotekah, moramo preveriti, ali morajo biti enake ali ne. Torej, če smo smiselni ljudje, ki ne uživamo prepovedanih substanc in ne hranimo baze v K8s, potem morajo imeti naše configmaps nastavitve dostopa do produkcijske baze (proces rezervacije, ki je zgrajen ločeno). Tako moramo za omogočanje dostopa do rezervnega primera baze podatkov imeti ločeno konfiguracijsko datoteko (configmap). Enako delamo tudi s secrets: gesli za dostop do baze, api-ključi; kadarkoli lahko deluje bodisi produkcijski secret bodisi rezervni. Tako imamo že dve entiteti Kubernetes, katerih rezervne različice ne smejo biti enake produkcijskim. Naslednja entiteta, na kateri se je treba ustaviti, je cronjob. Cronjobi na rezervnem sistemu nikakor ne smejo biti enaki naboru cronjobov produkcijskega klasterja! Če dvignemo rezervni klaster in ga popolnoma zagnamo z vsemi vključenimi cronjobi – potem, na primer, ljudje prejmejo od vas dve e-pošti naenkrat namesto ene. Ali pa se bo kakšna sinhronizacija podatkov z zunanjimi viri izvajala dvakrat, posledično začnemo zboleti, jokati, kričati in se jeziti.
Kako pa nam predlagajo, da organiziramo rezervni klaster ljudje s spleta? Drugi najbolj priljubljen odgovor po "zakaj?" – uporaba Kubernetes Federation.
Kaj je to? To je, recimo, velika meta-klaster. Če si zamislimo arhitekturo Kuber, kjer imamo master in več nod, imamo z vidika federacije tudi master in več nod, le da je vsaka nod ločen klaster. To pomeni, da delamo z istimi entitetami, z istimi primitivi kot pri enotnem Kuberju, le da ne delamo s fizičnimi stroji, ampak s celotnimi klasterji. V okviru federacije poteka popolna sinhronizacija federativnih virov od staršev do potomcev. Na primer, če smo zagnali kakšen deployment preko federacije — ta se bo namestil na vsak naš podklaster. Če vzamemo kakšen configmap, skrivnost in ga razširimo po federaciji — se bo razširil na vse naše podklastre; pri tem pa federacija omogoča prilagajanje naših virov na otrocih. Torej smo vzeli kakšen configmap, ga namestili preko federacije in nato, če moramo kaj popraviti na določenih klasterjih, gremo popraviti na posameznem klasterju, in ta sprememba se ne bo sinhronizirala nikamor.
Kubernetes Federation — je relativno nov alat, in ne podpira celotnega nabora virov, ki jih nudi sam K8s: ob izdaji ene od prvih različic dokumentacije se je govorilo le o podpori za config-mape, deployment v replica-set, ingress. Skrivnosti se niso podpirale, prav tako delo z volume ni bilo podprto. Zelo omejen nabor. Še posebej, če obožujemo eksperimentirati, — na primer, preko custom resource definition posredovati svoje vire kubernetesu, — v federacijo jih že ne moremo spraviti. Torej, nekako… zelo podobno resnici rešitev, vendar nas občasno prisili, da si streljamo v nogo. Po drugi strani pa federacija omogoča fleksibilno upravljanje z našim replicasetom. Na primer, če želimo, da je zagnanih 10 replik naše aplikacije, bo federacija to številko po privzetku razdelila sorazmerno med število grozdov. In to celo lahko konfiguriramo! Torej lahko določimo, da na produkcijskem grozdu potrebujemo 6 replik naše aplikacije, na rezervnem grozdu, za varčevanje s viri ali za lastno zabavo — le 4 replike naše aplikacije. Kar je prav tako zelo priročno. Toda pri federaciji se moramo zanašati na neka nova rešitev, nekaj dodajati med tekom, prisiliti se, da malce več razmišljamo...
Ali lahko do procesa rezerviranja kubernetes pristopimo na kakšen enostavnejši način? Kateri načini so nam na voljo?
Najprej imamo vedno neko ci/cd sistem, torej ne hodimo ročno, ne pišemo na strežnikih create/apply. Sistem generira yaml datoteke za naše kontejnere.
Drugič, obstaja več grozdov, imamo ali enega ali več (če smo pametni) registry, ki smo ga prav tako rezervirali. In obstaja čudovita utilita kubectl, ki lahko deluje z več grozdi hkrati.
Tako da, po mom mišljenju, najjednostavnije i ispravno rešenje za izgradnju rezervnog klastera je jednostavan paralelni deploy. Postoji neki pipeline u ci/cd sistemu; prvo gradimo naše kontejnere, testiramo i postavljamo aplikacije preko kubectl na nekoliko nezavisnih klastera. Možemo praviti istovremena izdanja na više klastera. Samim tim, isporuku konfiguracija takođe rešavamo u ovoj fazi. Možemo unapred definisati set konfiguracija za naš borbeni klaster, set konfiguracija za rezervni klaster i na nivou ci/cd sistema postavljati produkciono okruženje u produkcijski klaster, a rezervno okruženje u rezervni klaster. U poređenju s federacijom, ne moramo ići nakon definisanja federiranog resursa na svaki podklaster i nešto predefinisati. To smo uradili unapred. Kakvi smo majstori.
Ali... ima... nekad sam pisao, ima "korena svih zala", ali ih zapravo ima dva. Prvo, fajl sistem. Postoji neki PV, ili koristimo spoljašnje skladište. Ako čuvamo fajlove unutar klastera, onda treba delovati po starim praksama, preostalim još iz vremena fizičkih infrastruktura: na primer, sinhronizovati sa lsync-om. Pa ili bilo kojim drugim vašim omiljenim rešenjem. Postavljamo sve na druge mašine i živimo.
Drugo, i zapravo, čak i važnija tačka sporenja — baza podataka. Ako smo pametni ljudi i ne držimo bazu u kuberu, onda je proces rezervisanja podataka po istoj staroj šemi — master-slave replikacija, pa prebacivanje, replikaciju ćemo uhvatiti i živeti dobro. Ali ako ćemo držati našu DB unutar klastera, onda zapravo ima mnogo spremnih rešenja za organizovanje iste master-slave replikacije, mnogo rešenja za pokretanje DB unutar kubera.
O rezervisanju baza podataka je već pročitano milijardu izlaganja, napisano milijardu članaka, ništa novo ovde, u stvari, nije potrebno. U suštini, sledite svoje snove, živite kako želite, izmišljajte sebi takođe neke složene rešitse, ali obavezno razmislite kako ćete sve to rezervisati.
In this section, we will discuss how the process of switching to a backup site will take place in the event of a fire. First of all, we deploy stateless applications in parallel. They do not affect the business logic of our applications and our project, allowing us to maintain two sets of running applications that can start receiving traffic. It is crucial to check during the switching process to the backup site whether configuration needs to be overridden. For example, we have a production Kubernetes cluster, a backup Kubernetes cluster, an external master database, and a backup master database. There are four options for how these applications in production can start interacting with each other. The database may switch, and traffic may need to be redirected to the new database in the production cluster, or the cluster could fail, causing us to switch to backup but continue operating with the production database. The third scenario involves both the application and the cluster failing, requiring us to switch both applications and redefine our configuration so that the new applications work with the new database.
So, what conclusions can we draw from all of this?
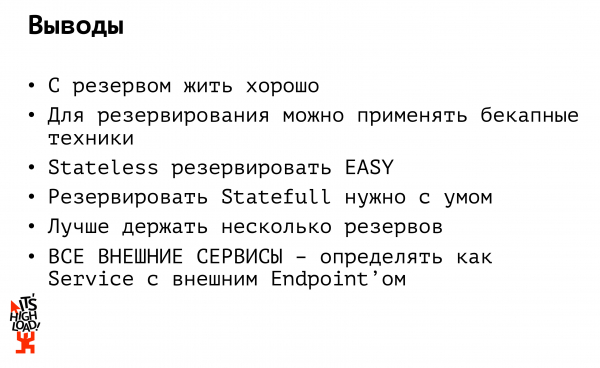
First conclusion: having a backup is good, but it’s expensive. Ideally, one shouldn’t rely on a single backup. It’s best to have multiple backups. First, the backup should not be located in just one data center, and second, it should ideally be with a different host. I have encountered situations like this in my experience. Unfortunately, I can't name the projects, but there was a fire in a data center... and I was like: we are switching to the backup! Only to find out that the backup servers were in the same rack.
Or imagine if Amazon was banned in Russia (and that has happened). What’s the point of having our backup stored in another Amazon if it’s also inaccessible? So once again: we should have a backup, at least in a different data center, and preferably with another host.
Drugi izvod: ako vaše aplikacije u Kubernetesu komuniciraju s nekim vanjskim izvorima (to može biti baza podataka ili neko vanjsko API), obavezno ga definirajte kao uslugu s vanjskim endpointom, kako ne biste morali ponovo implementirati 15 vaših aplikacija koje se povezuju na istu bazu kada dođe do promjene. Definirajte bazu kao zasebnu uslugu, povezujte se s njom kao da je unutar klastera: ako vaša baza zakaže, samo promijenite IP na jednom mjestu i nastavite s radom.
I na kraju: volim 'kocku', kao i eksperimentiranje s njom. Također volim dijeliti rezultate tih eksperimenta i svoja osobna iskustva. Stoga sam snimio seriju webinara o K8s, dobrodošli na za više informacija.
Izvor: habr.com
