

Po , data inženir je v tem trenutku poklic, za katerega povpraševanje raste hitreje kot za vse ostale. Data inženir igra kritično pomembno vlogo v organizacijah – ustvarja in vzdržuje delovanje potokov in baz podatkov, ki se uporabljajo za obdelavo, transformacijo in shranjevanje podatkov. Katere veščine so najprej potrebne predstavnikom tega poklica? Se seznam razlikuje od tistega, ki je potreben za data znanstvenike? O vsem tem boste izvedeli iz mojega članka.
Analiziral sem oglase za delovna mesta data inženirjev v januarju 2020, da bi razumel, katere tehnološke spretnosti so najbolj priljubljene. Nato sem rezultate primerjal s statistiko oglasov za delovna mesta data znanstvenikov – pri tem so se pojavile nekatere zanimive razlike.
Brez dolgih uvodov – tukaj je deset tehnologij, ki se najpogosteje omenjajo v besedilih oglasov za delo:
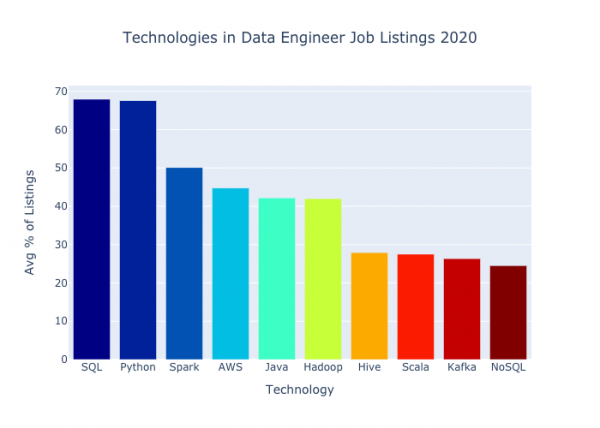
Omembe tehnologij v oglasih za delovno mesto data inženir v letu 2020
Poglejmo podrobneje.
Naloge data inženirja
Danes je delo, ki ga opravljajo data inženirji, izjemno pomembno za organizacije – ravno ti ljudje so odgovorni za shranjevanje informacij in njihovo pripravo v takšni obliki, da jo lahko druge zaposlene obdelujejo. Data inženirji gradijo potoke, da vzpostavijo pridobivanje podatkov, bodisi v tekočem bodisi v paketnih oblikah, iz različnih virov. Nato potoki izvajajo operacije pridobivanja, transformacije in nalaganja (drugimi besedami, ETL procesi), kar podatke naredi bolj primerne za nadaljnjo uporabo. Po tem se podatki predajo analitikom in data znanstvenikom za globlja obdelavo. Na koncu podatki zaključijo svojo pot na informacijskih nadzornih ploščah, v poročilih in modelih za strojno učenje.
Iskal sem informacije, ki bi omogočile ugotovitev, katere tehnologije so trenutno najbolj iskane v delu data inženirja.
Metode
Zbral sem informacije s treh spletnih mest za iskanje zaposlitve – , in in preverjal, katera ključna beseda se najpogosteje pojavi v povezavi z "data inženir" v besedilih oglasov, namenjenih prebivalcem ZDA. Za to nalogo sem uporabil dve Python knjižnici – in . Med ključnimi besedami sem vključil tako tiste, ki so bile v prejšnjem seznamu za analizo delovnih mest za data scientist, kot tudi tiste, ki sem jih ročno izbral, ko sem prebiral oglase za delo za data engineers. LinkedIn ni bil vključen, ker sem tam blokiran po prejšnjem poskusu zbiranja podatkov.
Za vsako ključno besedo sem preštel odstotek povezav v primerjavi z vsemi besedili na posameznih spletnih straneh, nato pa izračunal povprečje za tri vire.
Rezultati
Spodaj je predstavljenih trideset tehničnih izrazov s področja data engineering, ki imajo najvišje vrednosti na vseh treh spletnih mestih za zaposlitev.
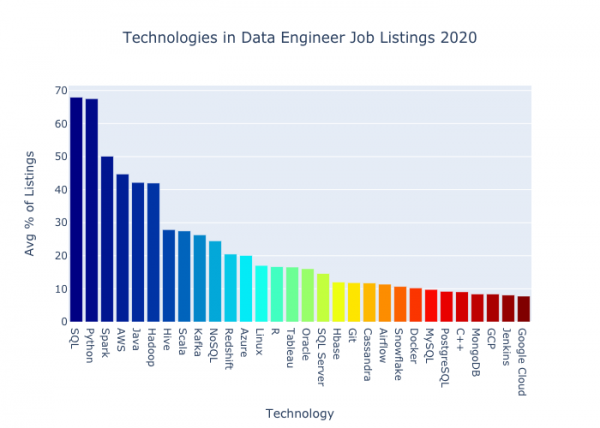
Tukaj so iste številke, toda v obliki tabele:
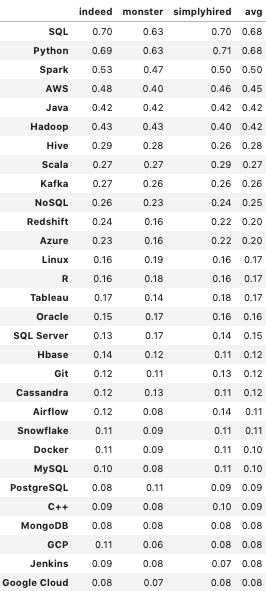
Pojdimo po vrsti.
Pregled rezultatov
Tako SQL kot Python se pojavita v več kot dveh tretjinah obravnavanih delovnih mest. Tehnologiji, ki se ju splača najprej študirati, sta prav ti dve. – zelo priljubljen programski jezik, ki se uporablja za delo z podatki, ustvarjanje spletnih strani in pisanje skript. se krati kot Structured Query Language (jezik strukturiranih poizvedb); predstavlja standard, ki ga uresničuje skupina jezikov, in se uporablja za pridobivanje podatkov iz relacijskih baz. Pojavil se je že dolgo nazaj in se izkazal za zelo zanesljivega.
O Sparku se govori v približno polovici oglasov za zaposlitev. – to je 'integrirani analitični motor za obdelavo velikih podatkov z zgrajenimi moduli za pretok podatkov, SQL, strojno učenje in obdelavo grafov'. Zelo je priljubljen med tistimi, ki delajo z velikimi bazami podatkov.
AWS se pojavi v približno 45% besedil oglasov za zaposlitev. To je oblačna računalniška platforma podjetja Amazon; ima največji tržni delež med vsemi oblačnimi platformami.
Naslednja sta Java in Hadoop - nekoliko več kot 40% za vsakega. – široko razširjen, preizkušen jezik, ki je zasedel deseto mesto med jeziki, ki vzbujajo strah pri programerjih. Nasprotno pa je Python zasedel drugo mesto med jeziki, ki uživajo največ ljubezni. Jezik Java vodi Oracle, vse, kar potrebujete vedeti o njem, pa lahko razumete iz tega posnetka zaslona uradne strani z januarja 2020.
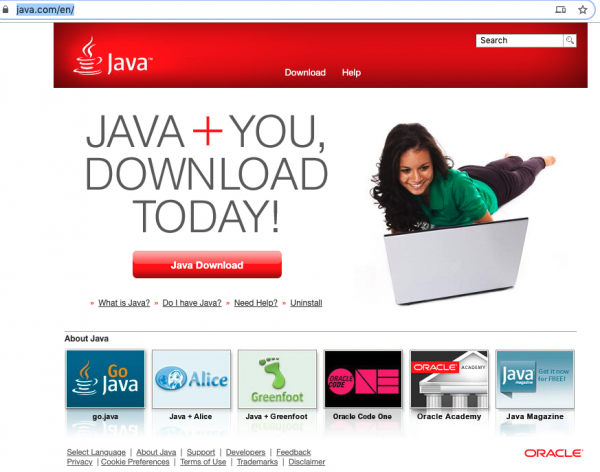
Kot da bi se peljali s časovno mašino
uporablja programski model MapReduce s klasterji strežnikov za velike podatke. Ta model se vse pogosteje zapušča.
Nato vidimo Hive, Scala, Kafka in NoSQL – vsaka od teh tehnologij se omenjajo v četrtini predstavljenih delovnih mest. Apache Hive je program za shranjevanje podatkov, ki 'poenostavi branje, pisanje in upravljanje velikih nizov podatkov, ki se nahajajo v razporejenih skladiščih, s pomočjo SQL'. je programski jezik, ki se aktivno uporablja pri delu z velikimi podatki. Zlasti je bil Spark razvit v Scala. V že omenjenem okviru jezikov, ki vzbujajo strah, zavzema Scala enajsto mesto. je razporejena platforma za obdelavo pretokov sporočil. Je zelo priljubljena kot sredstvo za pretok podatkov.
se postavljajo nasproti SQL-u. Osvetljujejo, da niso relacijske, niso strukturirane in omogočajo horizontalno skalabilnost. NoSQL je pridobil nekaj priljubljenosti, vendar je videti, da je divji navdušenje nad tem pristopom, do prerokb, da bo nadomestil SQL kot prevladujočo paradigmo shranjevanja, že mimo.
Primerjava s termini v zaposlitvah data scientist
Tukaj je trideset tehnoloških izrazov, ki so pri delodajalcih v področju podatkovne znanosti najbolj pogosti. Ta seznam sem pridobil na enak način, kot sem ga opisal zgoraj za podatkovno inženirstvo.
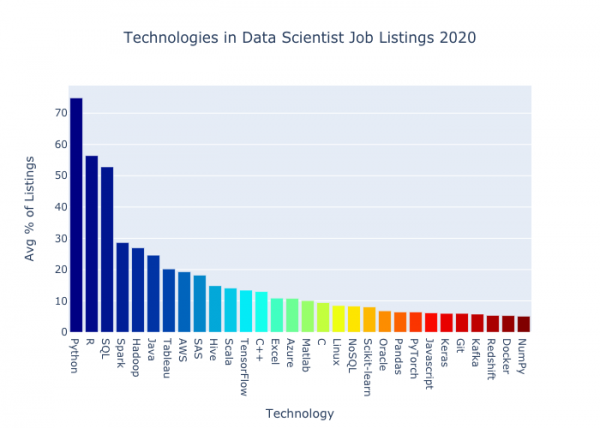
Omenjanje tehnologij v zaposlitvah za položaj data scientist v letu 2020
Kar se tiče skupnega števila, je bilo več zaposlitvenih mest za 28% več (12.013 proti 9.396) v primerjavi s prejšnjim naborom. Poglejmo, katere tehnologije se redkeje pojavljajo v zaposlitvah za data scientists kot za data engineers.
Bolj priljubljene v podatkovnem inženirstvu
Na spodnjem grafu so prikazane ključne besede s povprečno razliko v vrednostih, ki je večja od 10% ali manjša od -10%.
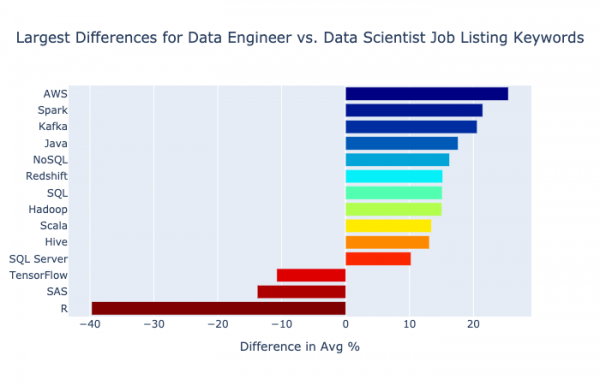
Največje razlike v pogostosti ključnih besed med data engineer in data scientist
Največjo rast zaznava AWS: v podatkovnem inženirstvu se pojavi 25% pogosteje kot v podatkovni znanosti (približno 45% in 20% od skupnega števila zaposlitvenih mest ustrezno). Razlika je opazna!
Tukaj so isti podatki v nekoliko drugačnem prikazu – na grafu so rezultati za isto ključne besedo v zaposlitvah za položaj data engineer in data scientist postavljeni drug ob drugem.
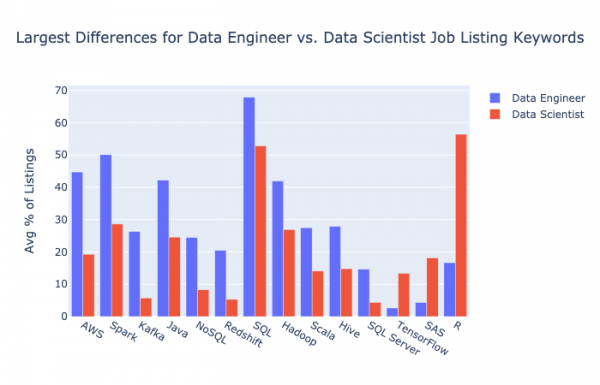
Največje razlike v pogostosti ključnih besed med data engineer in data scientist
Naslednji največji skok sem opazil pri Sparku – podatkovni inženirji pogosto delajo z obsežnimi podatki. je prav tako narasla za 20%, kar pomeni skoraj štirikrat v primerjavi z rezultati za delovna mesta podatkovnih znanstvenikov. Prenos podatkov je ena glavnih nalog podatkovnega inženirja. Končno se je število omemb izkazalo za 15% višje v področju podatkovnega inženiringa pri Java, NoSQL, Redshift, SQL in Hadoop.
Manj priljubljene v podatkovnem inženiringu
Zdaj poglejmo, katere tehnologije so manj priljubljene na delovnih mestih za podatkovne inženirje.
Najostrejši padec v primerjavi s področjem podatkovne znanosti se je zgodil pri : tam je bil prisoten približno v 56% delovnih mest, tu pa le v 17%. Impresivno. R je programski jezik, ki je priljubljen med znanstveniki in statistiki ter zaseda osmo mesto na lestvici jezkov, ki povzročajo strah.
se prav tako precej redkeje pojavlja v delovnih mestih za podatkovne inženirje – razlika znaša 14%. SAS je patentiran jezik, namenjen delu s statistiko in podatki. Zanimivo je, da soditi po rezultatih , je v zadnjem času precej izgubil na pozicijah – bolj kot katera koli druga tehnologija.
Iščemo v podatkovnem inženiringu in podatkovni znanosti
Treba je omeniti, da se osem izmed desetih prvih mest v obeh naborih ujema. SQL, Python, Spark, AWS, Java, Hadoop, Hive in Scala so se uvrstile v desetko tako za področje podatkovnega inženiringa kot tudi za podatkovno znanost. Na grafu spodaj lahko vidite petnajst najbolj priljubljenih tehnologij pri delodajalcih podatkovnih inženirjev, zraven pa njihov kazalnik za delovna mesta podatkovnih znanstvenikov.
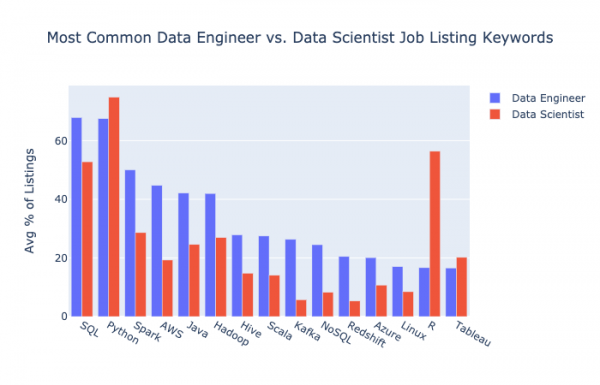
Priporočila
Če želite delati na področju podatkovnega inženiringa, bi vam priporočil, da obvladate naslednje tehnologije – navajam jih v približnem vrstnem redu prednostnosti.
Razvijajte SQL. Priporočam vam PostgreSQL, ker ima odprto kodo, veliko priljubljenost v skupnosti in je v fazi rasti. Kako uporabljati jezik, lahko izveste iz knjige My Memorable SQL – njena pilotna različica je dostopna .
Obvladajte Python, tudi ne na najtežji ravni. Knjiga My Memorable Python je zasnovana prav za novince. Kupite jo lahko na , elektronsko kopijo ali fizično, po vaši izbiri, ali pa jo prenesete v formatu pdf ali epub .
Ko se enkrat spoznate s Python-om, preidite na pandas – knjižnico Python, ki se uporablja pri čiščenju in obdelavi podatkov. Če stremite k delu v podjetju, kjer je znanje Python-a obvezno (kar je v večini primerov), lahko ste prepričani, da bo znanje pandas predpostavka. Zdaj zaključujem uvodni vodnik za delo s pandas – lahko , da ne zamudite trenutka izdaje.
Obvladajte AWS. Če želite postati data engineer, brez oblačne platforme ne boste zmogli, AWS pa je najbolj priljubljena med njimi. Zelo so mi pomagali tečaji , ko sem se učil , mislim, da imajo tudi dobre materiale za AWS.
Če ste že osvojili celoten seznam in želite še naprej rasti v očeh delodajalcev kot data engineer, predlagam, da dodate Apache Spark za delo z velikimi podatki. Čeprav je moje raziskovanje delovnih mest v data science pokazalo upad zanimanja, se pri data engineer-jih še vedno pojavlja skoraj v vsakem drugem oglasu.
Za konec
Upam, da je bil ta pregled najbolj iskanih tehnologij za data engineer koristen. Če vas zanima, kako je s prostimi delovnimi mesti za analitike, preberite . Uspešno inženirstvo!
Izvor: habr.com
