

Ideje i sastanci o tome koje još procese možemo automatizirati, pojavljuju se u poslovanju različitih razmjera svakodnevno. Osim toga, vrijeme koje se troši na izradu modela mora se iskoristiti i za njegovo vrednovanje i provjeru da li je rezultat koji dobijamo slučajan. Nakon implementacije, svaki model potrebno je staviti pod nadzor i povremeno provjeravati.
I to su sve faze koje je potrebno proći u svakoj kompaniji, bez obzira na njezinu veličinu. Ako govorimo o razmjerima i legacy sustavu Sberbanka, broj finih podešavanja raste nekoliko puta. Do kraja 2019. godine, u Sberu je već bilo korišteno više od 2000 modela. Nije dovoljno samo razviti model, potrebno je integrirati se s industrijskim sustavima, razviti data vitrine za izgradnju modela, osigurati kontrolu njegovog rada na klasteru.
Naš tim razvija platformu Sber.DS. Ona omogućava rješavanje problema strojnog učenja, ubrzava proces provjere hipoteza, u suštini olakšava proces razvoja i validacije modela, kao i kontrolira rezultat rada modela u PROM-u.
Kako ne bih prevario vaša očekivanja, želim unaprijed reći da je ovaj post uvodnog karaktera, i ispod u nastavku se priča o tome što zapravo leži ispod haube platforme Sber.DS. Priču o životnom ciklusu modela od stvaranja do implementacije ispričat ćemo odvojeno.
Sber.DS sastoji se od nekoliko komponenti, među kojima su ključne biblioteka, sustav razvoja i sustav izvršavanja modela.
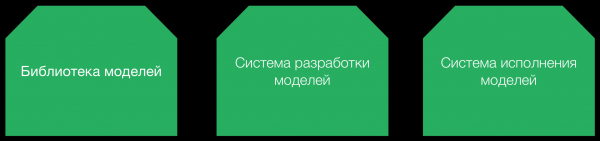
Biblioteka kontrolira životni ciklus modela od trenutka kad se pojavi ideja za njegovu izradu do implementacije u PROM, stavljanja pod nadzor i povlačenja iz upotrebe. Mnoge mogućnosti biblioteke proizašle su iz pravila regulatora, kao što su izvještavanje i čuvanje obrazaca za učenje i validaciju. U suštini, to je registar svih naših modela.
Sustav razvoja namijenjen je vizualnom razvoju modela i validacijskih metoda. Razvijeni modeli prolaze primarnu validaciju i šalju se u sustav izvršavanja za obavljanje svojih poslovnih funkcija. Također, u sustavu izvršavanja model može biti postavljen na monitor s ciljem povremenog pokretanja validacijskih metoda za kontrolu njegova rada.
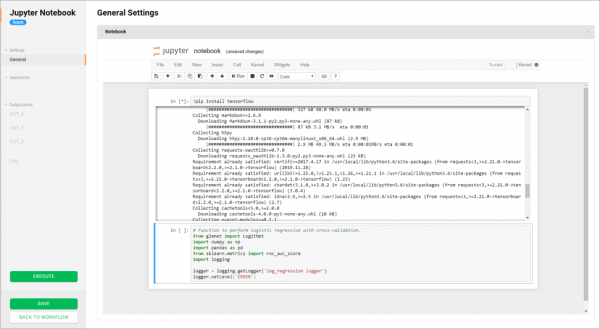
V sistemu je več tipov vozlišč. Nekatera so namenjena povezovanju z različnimi viri podatkov, druga pa za transformacijo izvornih podatkov in njihovo obogatitev (označevanje). Obstaja veliko vozlišč za gradnjo različnih modelov in vozlišč za njihovo validacijo. Razvijalec lahko nalaga podatke iz kakršnih koli virov, jih prenese, filtrira, vizualizira vmesne podatke ter jih razdeli na dele.
Poleg tega platforma vsebuje že pripravljene module, ki jih je mogoče povleči na projektno območje. Vse akcije se izvajajo z uporabo vizualiziranega vmesnika. Dejansko je mogoče rešiti nalogo brez ene same vrstice kode.
Če vgrajenih možnosti ni dovolj, sistem omogoča hitro ustvarjanje lastnih modulov. Uvedli smo način integrirane razvoja na osnovi za tiste, ki ustvarjajo nove module "od začetka".
Arhitektura Sber.DS je zgrajena na mikroservisih. Obstaja veliko mnenj o tem, kaj so mikroservisi. Nekateri menijo, da je dovolj razdeliti monolitno kodo na dele, vendar se kljub temu povezujeta z isto bazo podatkov. Pri nas mora mikroservis komunicirati z drugim mikroservisom le preko REST API. Nobenih obvodnih poti do baze podatkov neposredno.
Trudimo se, da storitve ne postanejo zelo velike in okorne: en primer ne sme porabiti več kot 4-8 gigabajtov operativne pomnilnika in mora zagotavljati možnost horizontalnega skaliranja poizvedb z zagonom novih primerov. Vsaka storitev komunicira z drugimi le preko REST API (). Ekipa, odgovorna za storitev, mora ohranjati združljivost API do zadnjega odjemalca, ki jo uporablja.
Jedro aplikacije je napisano v Javi z uporabo Spring Framework. Rešitev je bila prvotno zasnovana za hitro uvajanje v oblačno infrastrukturo, zato je aplikacija zgrajena z uporabo sistema kontejnerizacije (). Platforma se nenehno razvija, tako na področju povečanja poslovne funkcionalnosti (dodajajo se novi povezovalci, AutoML), kot tudi na področju tehnološke učinkovitosti.
Ena od značilnosti naše platforme je, da lahko izvajamo kodo, razvito v vizualnem vmesniku, na katerem koli sistemu za izvajanje modelov Sberbank. Zdaj so na voljo že dve: ena na Hadoopu, druga pa na OpenShiftu (Docker). Na tem ne bomo ostali in ustvarjamo integracijske module za zagon kode na kateri koli infrastrukturi, vključno z on-premise in v oblaku. Kar se tiče možnosti učinkovitega vgrajevanja v ekosistem Sberbank, načrtujemo tudi podporo za obstoječe okolja za izvajanje. V prihodnosti bi lahko rešitev fleksibilno vgradili »iz škatle« v katero koli okolje katere koli organizacije.
Tisti, ki so kdajkoli poskusili vzdrževati rešitev, ki izvaja Python na Hadoopu v PROM, vedo, da malo pomaga pripraviti in dostaviti uporabniško okolje Pythona na vsak nod podatkov. Ogromno število C/C++ knjižnic za strojno učenje, ki uporabljajo Python module, vam ne bo omogočilo mirnega spanca. Ne pozabite posodabljati paketov ob dodajanju novih knjižnic ali strežnikov, pri čemer ohranjate nazaj združljivost z že implementirano kodo modelov.
Obstaja več pristopov k temu, kako to narediti. Na primer, vnaprej pripraviti nekaj pogosto uporabljenih knjižnic in jih vključiti v PROM. V distribuciji Hadoop od Cloudera se za to običajno uporablja . Prav tako se zdaj v Hadoopu pojavlja možnost zagona -kontejnerjev. V nekaterih preprostih primerih je mogoče dostaviti kodo skupaj s paketom .
Banka zelo resno obravnava varnost izvajanja zunanje kode, zato kar se da izkoriščamo nove možnosti jedra Linux, kjer je mogoče procesu, ki se izvaja v izoliranem okolju , omejiti, na primer, dostop do omrežja in lokalnega diska, kar znatno zmanjšuje možnosti zlonamerne kode. Področja podatkov vsakega oddelka so zaščitena in dostopna le lastnikom teh podatkov. Platforma zagotavlja, da podatki iz enega področja lahko preidejo v drugo področje le preko postopka objave podatkov s kontrolo na vseh stopnjah, od dostopa do virov do prenosa podatkov v ciljno vitrino.
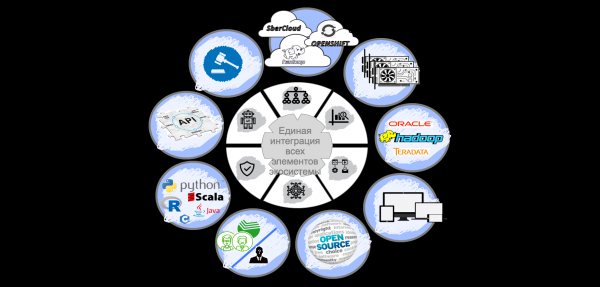
V tem letu nameravamo dokončati MVP zagon modelov, napisanih v Pythonu/R/Javi na Hadoopu. Postavili smo si ambiciozen cilj, da se naučimo zagnati katero koli uporabniško okolje na Hadoopu, da ne omejujemo uporabnikov naše platforme.
Poleg tega se je izkazalo, da mnogi DS-specialisti odlično poznajo matematiko in statistiko, ustvarjajo izvrstne modele, vendar se ne spoznajo najbolje na transformacije velikih podatkov, zato potrebujejo pomoč naših podatkovnih inženirjev pri pripravi učnih vzorcev. Odločili smo se, da bomo kolegom pomagali in ustvarili priročne module za standardno transformacijo in pripravo funkcij za modele na Spark motorju. To bo omogočilo, da bomo več časa posvetili razvoju modelov in ne čakali, da podatkovni inženirji pripravijo nov nabor podatkov.
Pri nas delajo ljudje z znanji na različnih področjih: Linux in DevOps, Hadoop in Spark, Java in Spring, Scala in Akka, OpenShift in Kubernetes. V naslednjem delu bomo govorili o knjižnici modelov, o tem, kako model potuje skozi življenjski cikel znotraj podjetja, kako poteka validacija in implementacija.
Izvor: habr.com
