

Ta članek je že drugi v seriji o hitri kompresiji podatkov. V prvem članku smo opisali kompresor, ki deluje s hitrostjo 10 GB/s na eno procesorsko jedro (minimalna kompresija, RTT-Min).
Ta kompresor je že vgrajen v opremo forenznih duplicatorjev za hitro kompresijo dumpov informacijskih nosilcev in za povečanje odpornosti kriptografije; prav tako se lahko uporablja za kompresijo slik virtualnih strojev in swap datotek RAM-a, ko jih shranjujemo na hitre SSD diske.
V prvem članku je bila prav tako napovedana razvojna faza algoritma kompresije za stiskanje varnostnih kopij HDD in SSD diskov (povprečna kompresija, RTT-Mid) z bistveno izboljšanimi parametri kompresije podatkov. Do sedaj je ta kompresor popolnoma pripravljen in ta članek je prav o njem.
Kompresor, ki izvaja algoritem RTT-Mid, zagotavlja stopnjo kompresije, primerljivo s standardnimi arhivatorji, kot sta WinRar in 7-Zip, ki delujejo v hitrem načinu. Pri tem je hitrost njegovega delovanja vsaj za red višja.
Hitrost pakiranja/razpakiranja podatkov je kritični parameter, ki določa področje uporabe tehnologij kompresije. Malo kdo bi si namreč mislil, da bi stiskal terabajt podatkov s hitrostjo 10-15 MB na sekundo (takšna je namreč hitrost arhivatorjev v standardnem načinu kompresije), saj bi to trajalo skoraj dvajset ur pri popolni obremenitvi procesorja …
Po drugi strani pa se lahko isti terabajt kopira s hitrostmi okoli 2-3 GB na sekundo v desetih minutah.
Zato je kompresija velike količine informacij smiselna, če se izvaja s hitrostjo, ki ni nižja od hitrosti realnega vnosa/izvoda. Za sodobne sisteme to pomeni vsaj 100 MB na sekundo.
Takšne hitrosti lahko sodobni kompresorji dosegajo le v načinu „fast“. V tej aktualni načinu bomo primerjali algoritem RTT-Mid s tradicionalnimi kompresorji.
Primerjalno testiranje novega algoritma kompresije
Kompresor RTT-Mid je deloval v sklopu testne programske opreme. V resnični „delovni“ aplikaciji deluje precej hitreje, saj se tam učinkovito uporablja večnitnost in uporabljeni so „normalni“ prevajalniki, ne pa C#.
Ker so se v primerjalnem testu uporabljeni podatkovni kompresorji temelje na različnih načelih in različne vrste podatkov stiskajo na različne načine, je bila za objektivnost testa uporabljena metoda merjenja "povprečne temperature po bolnišnici"…
Ustvarjena je bila datoteka sektorja stiskanja logičnega diska z operacijskim sistemom Windows 10, kar je najbolj naravna mešanica različnih podatkovnih struktur, ki dejansko obstajajo na vsakem računalniku. Stiskanje te datoteke bo omogočilo primerjavo hitrosti in stopnje kompresije novega algoritma s najnaprednejšimi kompresorji, ki se uporabljajo v sodobnih arhivatorjih.
Tukaj je ta datoteka stiskanja:
Datoteka stiskanja je bila stisnjena s kompresorji RTT-Mid, 7-zip, WinRar. Kompresor WinRar in 7-zip sta bila nastavljena na maksimalno hitrost delovanja.
Kompresor deluje 7-zip:
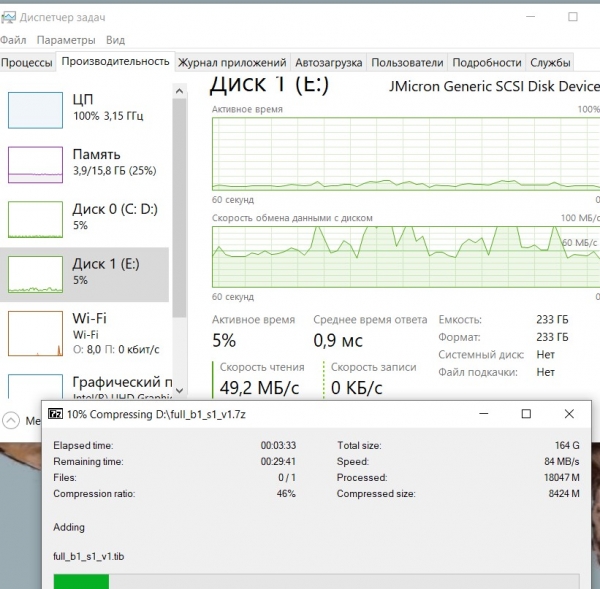
Obremeni procesor na 100 %, pri čemer je povprečna hitrost branja izvorne datoteke okoli 60 Megabajtov/sek.
Kompresor deluje WinRar:
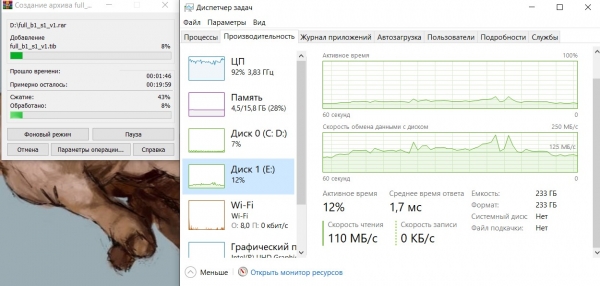
Situacija je podobna, obremenitev procesorja skoraj 100 %, povprečna hitrost branja datoteke okoli 125 Megabajtov/sek.
Kot v prejšnjem primeru je hitrost delovanja arhivatorja omejena z zmogljivostmi procesorja.
Sedaj deluje testna programska oprema kompresorja RTT-Mid:
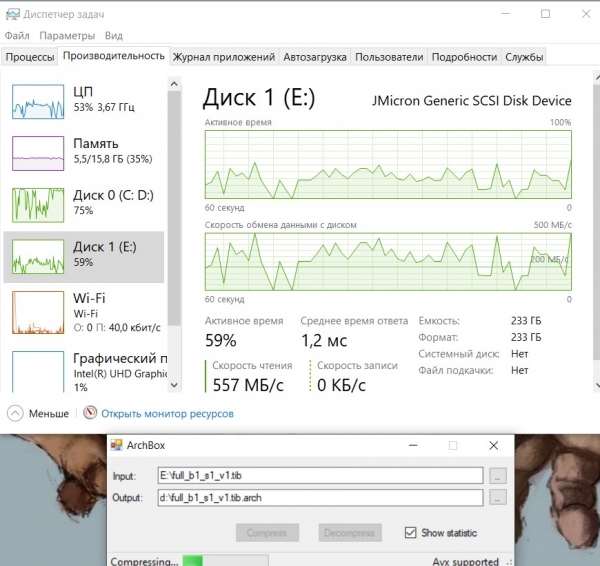
Zaslonski posnetek prikazuje, da je procesor obremenjen 50 % in ostalo čas miruje, ker ni prostora za sproščanje stisnjenih podatkov. Disk za sproščanje podatkov (Disk 0) je skoraj popolnoma obremenjen. Hitrost branja podatkov (Disk 1) močno niha, vendar je v povprečju več kot 200 Megabajtov/sek.
Hitrost delovanja kompresorja je v tem primeru omejena z možnostjo zapisovanja stisnjenih podatkov na Disk 0.
Zdaj stopnja stiskanja nastalih arhivov:
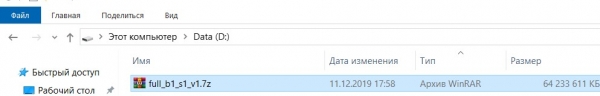
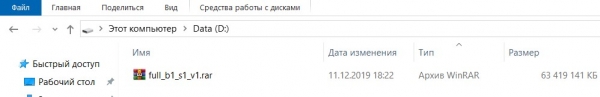
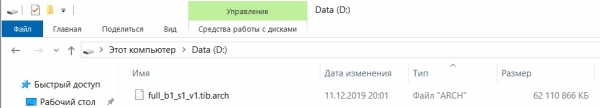
Vidno je, da je kompresor RTT-Mid najbolje opravil nalogo kompresije, arhiv, ki ga je ustvaril, je 1,3 Gigabajta manjši od arhiva WinRar in 2,1 Gigabajta manjši od arhiva 7z.
Čas porabljen za ustvarjanje arhiva:
- 7-zip – 26 minut 10 sekund;
- WinRar – 17 minut 40 sekund;
- RTT-Mid – 7 minut 30 sekund.
Tako je tudi testna, neoptimizirana programska oprema, ki uporablja algoritem RTT-Mid, lahko več kot dvakrat in pol hitreje ustvarila arhiv, pri čemer se je arhiv izkazal za bistveno manjši kot pri konkurenci…
Tisti, ki ne verjamejo zaslonskim posnetkom, lahko preverijo njihovo verodostojnost sami. Testna programska oprema je na voljo na , prenesite in preverite.
Ampak le na procesorjih, ki podpirajo AVX-2; brez podpore teh navodil kompressor ne deluje, prav tako ne preizkušajte algoritma na starejših procesorjih AMD, saj so počasni pri izvajanju AVX ukazov...
Uporabljena metoda stiskanja
Algoritem uporablja metodo indeksiranja ponavljajočih se fragmentov besedila v bajtni granulaciji. Ta metoda stiskanja je znana že dolgo, vendar ni bila uporabljena, ker je bila operacija iskanja ujemanj zelo potratna glede potrebnih virov in je zahtevala veliko več časa kot gradnja slovarja. Tako je algoritem RTT-Mid klasičen primer premikanja 'nazaj v prihodnost'...
Kompressor RTT uporablja edinstven hitri skener za iskanje ujemanj, ta je omogočil pospešitev procesa stiskanja. Skener je lastne izdelave, 'moja dragocenost...', 'cene ni majhna, saj je popolnoma ročno delo' (napisan v assemblerju).
Skener za iskanje ujemanj deluje po dvojnem verjetnostnem režimu, najprej se skenira prisotnost 'znaka' ujemanja, in šele po odkritju 'znaka' na tem mestu se zažene postopek odkrivanja realnega ujemanja.
Okno za iskanje ujemanj ima nepredvidljivo velikost, odvisno od stopnje entropije v obdelovani podatkovni enoti. Za popolnoma naključne (ne stisljive) podatke je velika nekaj megabajtov, za podatke z ponovitvami pa vedno večja od megabajta.
Toda mnogi sodobni formati podatkov so ne stisljivi in 'vrteti' po njih virov požrešen skener je brezsmiselno in razsipno, zato skener uporablja dva načina delovanja. Najprej se iščejo odseki izvornega besedila z morebitnimi ponovitvami, ta operacija se prav tako izvaja s verjetnostno metodo in se izvaja zelo hitro (pri hitrosti 4-6 gigabajtov/s). Nato se odseki z morebitnimi ujemanji obdelajo z glavnim skenerjem.
Indeksno stiskanje ni zelo učinkovito, ker je potrebno ponavljajoče se fragmente zamenjati z indeksi, indeksoni niz pa bistveno znižuje koeficient stiskanja.
Za povečanje stopnje stiskanja se ne indeksirajo samo popolne ujemajoče se nizovne zaporedja, ampak tudi delna, kadar niz vsebuje ujemajoče in neujemajoče se bite. V indeksni format je vključeno polje maske ujemanj, ki označuje ujemajoče bite dveh blokov. Za še večje stiskanje se uporablja indeksiranje z nalaganjem več delno ujemajočih se blokov na trenutni blok.
Vse to je omogočilo, da je kompressor RTT-Mid dosegel stopnjo stiskanja, primerljivo s kompressorji, ki delujejo po besedilni metodi, vendar deluje precej hitreje.
Hitrost delovanja novega algoritma stiskanja
Če kompressor deluje z monopolno uporabo pomnilniškega predpomnilnika (za en tok je potrebnih 4 Megabajti), hitrost dela nihaje med 700-2000 Megabajti/sec na eno procesorsko jedro, odvisno od vrste stiskanih podatkov in malo od delovne frekvence procesorja.
Pri večnitni izvedbi kompressorja učinkovitost skalabilnosti določa količina tretje ravni predpomnilnika. Na primer, s 9 Megabajti predpomnilnika ni smiselno zagnati več kot dveh stiskalnih tokov, saj hitrost ne bo narasla. Toda pri 20 Megabajtih predpomnilnika lahko že zagnate pet stiskalnih tokov.
Prav tako pomemben parameter, ki določa hitrost delovanja kompressorja, postane latenca dostopa do pomnilnika. Algoritem uporablja naključne dostope do glavnega pomnilnika, od katerih del ne pride v predpomnilnik (približno 10%), kar povzroča, da mora čakati na podatke iz glavnega pomnilnika, kar zmanjšuje hitrost delovanja.
Pomembno vpliva na hitrost kompressorja tudi delovanje sistema za vhod/izhod podatkov. Zahteve za dostop do glavnega pomnilnika od naprave za vhod/izhod blokirajo dostop do podatkov s strani procesorja, kar prav tako zmanjšuje hitrost stiskanja. Ta težava je pomembna za prenosne računalnike in namizne računalnike, strežnikov je manj pomembna zaradi bolj naprednega nadzornega bloka za dostop do sistemske vodila in večkanalnega pomnilnika.
V besedilu članka se nenehno omenjata kompresija, dekompresija pa ostaja zunaj te razprave, saj je tam "vse v redu". Dekompresija poteka bistveno hitreje in je omejena s hitrostjo vnosa/izpuščanja. En fizični procesorski jedro v enem toku brez težav doseže hitrosti razpakiranja od 3-4 gigabajtov na sekundo.
To je posledica pomanjkanja operacije iskanja ujemanj med razpakiranjem, ki "požre" glavne vire procesorja in predpomnilnika med kompresijo.
Zanesljivost shranjevanja stisnjenih podatkov
Kot izhaja iz imena celotnega razreda programske opreme, ki uporablja kompresijo podatkov (arhivatorji), so ti namenjeni dolgoročnemu shranjevanju informacij, ne leti, ampak stoletja in tisočletja...
Med shranjevanjem nosilci informacij izgubijo del podatkov, tukaj je primer:
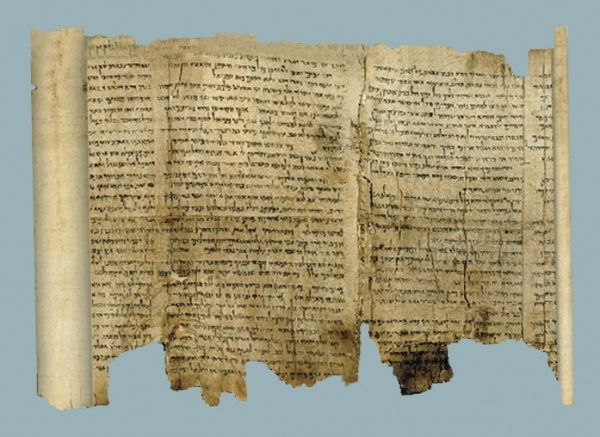
Ta "analogni" nosilec informacij je star tisoč let, nekateri fragmenti so izgubljeni, vendar je v celoti informacija "bralna"...
Nobeden od odgovornih proizvajalcev sodobnih digitalnih sistemov za shranjevanje podatkov in digitalnih nosilcev le-teh ne daje garancij za popolno ohranitev podatkov več kot 75 let.
In to je problem, vendar odložen problem, s katerim se bodo ukvarjali naši potomci...
Sistemi za shranjevanje digitalnih podatkov lahko izgubljajo podatke ne samo po 75 letih, napake v podatkih se lahko pojavijo kadarkoli, celo med zapisovanjem, te izkrivljanja pa poskušajo minimizirati z uporabo odvečnosti in popravljanjem s sistemi za korekcijo napak. Odvečnost in sistemi korekcije morda ne bodo vedno mogli obnoviti izgubljenih informacij, in če jih obnovijo, ni jamstev, da je bila operacija obnovitve pravilno izvedena.
In to je tudi velik problem, a ne odložen, temveč trenutni.
Sodobni kompresorji, uporabljeni za arhiviranje digitalnih podatkov, temeljijo na različnih različicah slovarskih metod in za take arhive bo izguba fragmenta informacij usodna situacija, celo ustaljen izraz za to situacijo obstaja — "pokvaren" arhiv...
Nizka zanesljivost shranjevanja informacij v arhivih s slovarsko stiskalno tehniko je povezana s strukturo stisnjenih podatkov. Informacije v takem arhivu ne vsebujejo izvirnega besedila, temveč shranjujejo številke zapisov v slovarju, sam slovar pa se dinamično prilagaja trenutnemu stiskanju besedila. Ob izgubi ali izkrivljanju fragmenta arhiva niso več možne identifikacije nadaljnjih zapisov arhiva niti po vsebini niti po dolžini zapisa v slovarju, saj ni jasno, čemu ustreza številka slovarnega zapisa.
Obnovitev informacij iz takšnega 'pokvarjenega' arhiva ni mogoča.
Algoritem RTT temelji na zanesljivejši metodi shranjevanja stisnjenih podatkov. Uporablja indeksno metodo za prepoznavanje ponavljajočih se fragmentov. Tak pristop k stiskanju omogoča minimalizacijo posledic izkrivljanja informacij na nosilcu in v mnogih primerih samodejno popravi izkrivljanja, ki so nastala med shranjevanjem informacij.
To je povezano s tem, da arhivska datoteka v primeru indeksnega stiskanja vsebuje dve polji:
- polje izvirnega besedila z odstranjenimi ponavljajočimi se deli;
- polje indeksov.
Kritično pomembno polje indeksov, ki je ključno za obnovitev informacij, ni veliko po velikosti in ga je mogoče podvojiti za večjo zanesljivost shranjevanja podatkov. Zato, tudi če bo izgubljen fragment izvirnega besedila ali indeksnega niza, bo mogoče vse ostale informacije obnoviti brez težav, tako kot na sliki z 'analognim' nosilcem informacij.
Slabosti algoritma
Brez slabosti ni prednosti. Indeksna metoda stiskanja ne stisne ponavljajočih se zaporedij majhne dolžine. To je posledica omejitev indeksne metode. Indeksi imajo velikost vsaj 3 bajte in so lahko veliki do 12 bajtov. Če se sreča ponovitev z manjšimi dimenzijami, kot so tiste, ki jih opisuje njegov indeks, se ne upošteva, ne glede na to, kako pogosto so takšne ponovitve odkrite v stisnjeni datoteki.
Tradicionalna, rječnična metoda kompresije učinkovito smanjuje višestruke ponavljanja male duljine i stoga postiže veći omjer kompresije nego indeksna kompresija. Istina je da se to postiže visokom opterećenju centralnog procesora; da bi rječnična metoda počela učinkovitije komprimirati podatke od indeksne metode, mora smanjiti brzinu obrade podataka na 10-20 megabajta u sekundi na stvarnim računalnim instalacijama pri punom opterećenju CPU-a.
Takve niske brzine su neprihvatljive za moderne sustave pohrane podataka i predstavljaju više «akademski» interes nego praktičan.
Stepen kompresije informacija bit će znatno povećana u sljedećoj modifikaciji algoritma RTT (RTT-Max), koja je već u razvoju.
Dakle, kao i uvijek, nastavak slijedi…
Izvor: habr.com
