

В последние полгода я работал над созданием системы борьбы с мошенничеством (fraudulent activity, fraud, etc.) без какой-либо начальной инфраструктуры для этого. Идеи, которые мы нашли и реализовали в нашей системе, помогают нам обнаруживать множество мошеннических действий и анализировать их. В этой статье я расскажу о принципах, которым мы следовали, и о том, что мы сделали для достижения текущего состояния нашей системы, не углубляясь в технические детали.
Принципы нашей системы
Когда вы слышите термины «automatic» и «fraud», вы, вероятно, начинаете думать о машинном обучении, Apache Spark, Hadoop, Python, Airflow и других технологиях экосистемы Apache Foundation и области Data Science. Я думаю, что есть один аспект использования этих инструментов, который обычно не упоминается: они требуют наличия определенных предварительных условий в вашей корпоративной системе, прежде чем начать их использовать. Проще говоря, вам нужна корпоративная платформа данных, включающая озеро данных и хранилище. Но что делать, если у вас нет такой платформы, и вам все еще нужно развивать эту практику? Следующие принципы, о которых я расскажу ниже, помогли нам достичь момента, когда мы можем сосредоточиться на улучшении наших идей, а не на поиске работающего решения. Тем не менее, это не «плато» проекта. В плане еще много работы как с технологической, так и с продуктовой точки зрения.
Принцип 1: ценность для бизнеса в первую очередь
Во главе всех наших усилий мы поставили «ценность для бизнеса». В общем, любая система автоматического анализа относится к группе сложных систем с высоким уровнем автоматизации и технической сложности. Создание законченного решения займет много времени, если вы будете разрабатывать его с нуля. Мы решили акцентировать внимание на ценности бизнеса, а не на технологической завершенности. В реальной жизни это означает, что мы не принимаем передовые технологии как догму. Мы выбираем технологию, которая лучше всего работает для нас в данный момент. Со временем может возникнуть необходимость заново реализовать некоторые модули. Это компромисс, который мы приняли.
Принцип 2: Расширенный интеллект человека (augmented intelligence)
Stavim se, da večina ljudi, ki niso globoko vključeni v razvoj rešitev strojnega učenja, misli, da je cilj zamenjava ljudi. V resnici so rešitve strojnega učenja daleč od popolnosti in zamenjava je možna le na določenih področjih. Te ideje smo se odrekli že na začetku iz več razlogov: neuravnoteženi podatki o goljufijah in nezmožnost zagotoviti izčrpen seznam funkcij za modele strojnega učenja. Namesto tega smo izbrali možnost razširjenega inteligence. To je alternativna konceptualizacija umetne inteligence, ki se osredotoča na podporno vlogo AI, kar poudarja, da so kognitivne tehnologije namenjene izboljšanju človeške inteligence, ne pa njeni zamenjavi. [1]
Ob upoštevanju tega bi razvoj popolne rešitve strojnega učenja od začetka zahteval ogromne napore, kar bi oviralo ustvarjanje vrednosti za naše podjetje. Odločili smo se zgraditi sistem z iterativno rastočim vidikom strojnega učenja pod vodstvom naših strokovnjakov na tem področju. Zapleten del razvoja takšnega sistema je, da mora našim analitikom predstaviti primere ne le z vidika, ali gre za goljufanje ali ne. Na splošno je vsaka anomalija v obnašanju strank sumljiv primer, ki ga je treba preiskati in na katerega je treba nekako reagirati. Le del teh zabeleženih primerov je dejansko mogoče klasificirati kot goljufivo vedenje.
Načelo 3: platforma obsežnih analitičnih podatkov
Najtežji del našega sistema je neprekinjeno preverjanje delovnega toka sistema. Analitiki in razvijalci morajo z lahkoto dostopati do naborov podatkov iz preteklih obdobij z vsemi metrikami, ki so bile uporabljene za analizo. Poleg tega mora podatkovna platforma nuditi enostaven način za dopolnitev obstoječega nabora kazalnikov z novimi. Procesi, ki jih ustvarjamo, kar niso samo programski procesi, morajo omogočiti enostavno ponovno izračunavanje preteklih obdobij, dodajanje novih metrik in spreminjanje napovedi podatkov. To bi lahko dosegli z zbiranjem vseh podatkov, ki jih generira naš proizvodni sistem. V takem primeru bi podatki postopoma postajali ovira. Morali bi hraniti rastoči obseg podatkov, ki jih ne uporabljamo, in jih zaščititi. V takem scenariju bi podatki sčasoma postajali vse bolj in bolj nerelevantni, a bi vseeno zahtevali naše napore za upravljanje. Za nas ni imelo smisla kopičiti podatkov (data hoarding), zato smo se odločili za drugačen pristop. Odločili smo se organizirati podatkovne skladi v realnem času okoli ciljih entitet, ki jih želimo razvrstiti, in hraniti samo tiste podatke, ki omogočajo preverjanje najnovejših in aktualnih obdobij. Zapletenost teh prizadevanj izhaja iz dejstva, da je naš sistem heterogen z več podatkovnimi skladi in programskimi moduli, ki zahtevajo natančno načrtovanje za usklajeno delovanje.
Konstruktivne koncepcije našega sistema
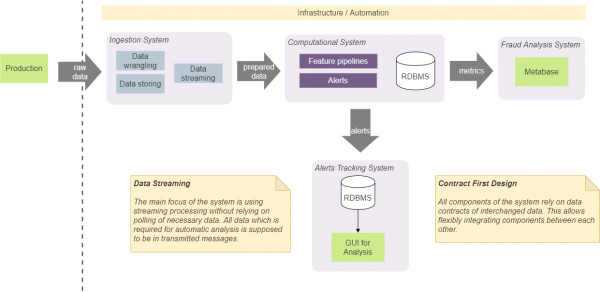
Imamo štiri glavne komponente v našem sistemu: sistem sprejema (ingestion system), izračunavanje (computational), analiza (BI analysis) in sistem sledenja (tracking system). Te služijo specifičnim izoliranim namenom, in jih držimo izolirane, pri čemer sledimo določenim pristopom razvoja.
Oblikovanje, temelječe na pogodbah
Najprej smo se dogovorili, da morajo komponente temeljiti le na določenih podatkovnih strukturah (pogodbah), ki se prenašajo med njimi. To omogoča enostavno integracijo med njimi in ne nalaga konkretne sestave (in vrstnega reda) komponent. Na primer, v nekaterih primerih nam to omogoča neposredno integracijo sistema prejemanja s sistemom sledenja opozorilom. V tem primeru bo to izvedeno v skladu s dogovorjeno pogodbo o opozorilih. To pomeni, da bosta obe komponenti integrirani z uporabo pogodbe, ki jo lahko uporablja katera koli druga komponenta. Ne bomo dodajali dodatne pogodbe za dodajanje opozoril v sistem sledenja iz sistema vnosa. Tak pristop zahteva uporabo vnaprej določenega minimalnega števila pogodb in poenostavi sistem in komunikacijo. V bistvu uporabljamo pristop, ki se imenuje 'Contract First Design', in ga uporabljamo za pogodbe za prenos podatkov. [2]
Streaming povsod
Shranjevanje in upravljanje stanja v sistemu bo neizogibno privedlo do zapletov pri njegovi izvajanju. Na splošno mora biti stanje dostopno iz katerega koli komponenta, mora biti usklajeno in nuditi najbolj ažurno vrednost za vse komponente ter zanesljivo s pravimi vrednostmi. Poleg tega bodo klici na trajno shranjevanje za pridobitev zadnjega stanja povečali število vhodno-izhodnih operacij in zapletenost algoritmov, ki se uporabljajo v naših sistemih v realnem času. Zaradi tega smo se odločili, da bomo shranjevanje stanja, kolikor je mogoče, popolnoma odstranili iz našega sistema. Ta pristop zahteva vključitev vseh potrebnih podatkov v prenosen podatkovni blok (sporočilo). Na primer, če moramo izračunati skupno število nekaterih opazovanj (število operacij ali primerov s posebnimi značilnostmi), ga izračunamo v pomnilniku in generiramo tok takih vrednosti. Odvisni moduli bodo uporabili deljenje (partition) in pakiranje (batch) za razdrobljanje toka po enotah in obdelavo zadnjih vrednosti. Ta pristop je odpravil potrebo po trajnem disku za take podatke. Naš sistem uporablja Kafka kot posrednika sporočil, in to se lahko uporablja kot zbirka podatkov s KSQL. [3] Vendar bi njegova uporaba močno povezala našo rešitev s Kafka in smo se odločili, da ga ne bomo uporabljali. Izbrani pristop omogoča zamenjavo Kafke z drugim posrednikom sporočil brez resnih notranjih sprememb sistema.
Ta koncept ne pomeni, da ne uporabljamo diskovnih shranjevanj in baz podatkov. Za preverjanje in analizo zmogljivosti sistema je potrebno na disku shraniti pomemben del podatkov, ki predstavljajo različne kazalnike in stanja. Pomembno je, da algoritmi v realnem času niso odvisni od takšnih podatkov. V večini primerov uporabljamo shranjene podatke za neodvisno analizo, odpravljanje napak in spremljanje določenih primerov in rezultatov, ki jih izda sistem.
Problemi našega sistema
Obstajajo določene težave, ki smo jih rešili do določene stopnje, vendar zahtevajo bolj premišljene rešitve. Sedaj bi jih rad omenil tukaj, ker vsak posamezni točki pripada samostojen članek.
- Še vedno moramo določiti procese in politike, ki spodbujajo zbiranje pomembnih in relevantnih podatkov za naše avtomatske analize, odkrivanje in raziskovanje podatkov.
- Vključitev rezultatov analize z ročnim posredovanjem v proces avtomatskega prilagajanja sistema za posodabljanje z najnovejšimi podatki. To ni le posodobitev našega modela, temveč tudi posodabljanje procesov in izboljšanje razumevanja naših podatkov.
- Iskanje ravnotežja med determinističnim pristopom IF-ELSE in ML. Nekdo je dejal: „ML je orodje za obupanost“. To pomeni, da boste želeli uporabiti ML, ko ne boste več razumeli, kako optimizirati in izboljšati svoje algoritme. Po drugi strani pa determinističen pristop ne omogoča odkrivanja anomalij, ki niso bile predvidene.
- Potrebujemo preprost način za preverjanje naših hipotez ali korelacij med metričnimi podatki.
- Sistem mora imeti več ravni resnično pozitivnih (true positive) rezultatov. Primeri goljufij so le del vseh primerov, ki jih lahko štejemo za pozitivne za sistem. Na primer, analitiki želijo dobiti vse sumljive primere za preverjanje, in le majhen del med njimi je goljufija. Sistem mora učinkovito zagotoviti analitikom vse primere, ne glede na to, ali gre za dejansko goljufijo ali le sumljivo vedenje.
- Podatkovna platforma mora omogočati pridobivanje podatkovnih nizov za pretekla obdobja z izračuni, ustvarjenimi in izračunanimi v realnem času.
- Enostavno in avtomatizirano uvajanje katerega koli od komponent sistema vsaj v treh različnih okoljih: proizvodnem, eksperimentalnem (beta) in za razvijalce.
- In nenazadnje, pomembno je. Moramo ustvariti obsežno platformo za preverjanje zmogljivosti, na kateri lahko analiziramo naše modele. [4]
Povezave
Izvor: habr.com
