

Predgovor prevajalca
Gradivo me je zaintrigiral, predvsem zaradi spodnje tabele:
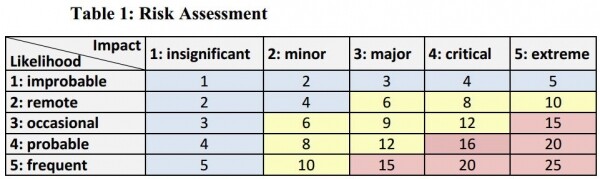
Ob upoštevanju, da statistiki (in Rusi, na genski ravni) na nek način ne marajo vsega, kar se razlikuje od linearne odvisnosti, so ti fantje uspeli potegniti uporabo aktivacijske funkcije v parabolni obliki za določitev stopnje tveganja uporabe BigData v uradni statistiki. Dober pristop. Seveda so statistiki dodali svoje opombe k temu delu - '1 Morebitne napake in opustitve so izključno odgovornost avtorjev. Mnenja, izražena v tem dokumentu, so osebna in nujno ne odražajo uradnega stališča Evropske komisije'. Vendar pa so delo objavili. Menim, da je to danes dovolj, in (avtorji) nikomur niso prepovedali, da najdejo svoje lestvice v teh vidikih.
V delu je dovolj strukturirano mogoče razdeliti, kje in kako se statistične metode razlikujejo od metod raziskovanja za BigData. Po mojem mnenju bo največja korist tega dela pri pogovoru s stranko in pri ovrgli njegovih izjav tipa:
— Mi sami zbiramo statistiko, kaj še želite raziskovati?
— Predstavite nam svoje rezultate tako, da jih uskladimo s svojo statistiko. Na tem področju avtorji pravijo, da bi bilo dobro prebrati to delo (3 )
V tem delu so avtorji predstavili svojo vizijo ravni tveganja. Ta parameter je v oklepaju, ne zamenjati z referencami na vire.
Druga opazka. Avtorji uporabljajo izraz BDS – to je analog pojma BigData. (videti je kot poklon uradni statistiki).
Predgovor avtorjev
Vse več statističnih uradov raziskuje možnost uporabe velikih virov podatkov za pripravo uradne statistike. Trenutno je le nekaj primerov, kjer so bili ti viri popolnoma integrirani v dejansko statistično produkcijo. Zato polna stopnja posledic, ki izhajajo iz njihove integracije, še ni znana. Medtem so bili narejeni prvi poskusi analize pogojev in vpliva velikih podatkov na različne vidike statistične produkcije, kot sta kakovost ali metodologija. Nedavno je ciljno skupino razvila kakovostno osnovo za pripravo statističnih podatkov na podlagi velikih podatkov v okviru projekta velikih podatkov Evropske ekonomske komisije Organizacije narodov (EKK OZN). V skladu z evropskim statističnim kodeksom praks je zagotavljanje visokokakovostnih statističnih informacij osnovna naloga statističnih uradov. Ker se tvegana situacija opredeljuje kot vpliv negotovosti na cilje (npr. Mednarodna organizacija za standardizacijo ISO 31000), smo menili, da je smiselno kategorizirati tveganja glede na dimenzije kakovosti, na katere vplivajo.
Predlagana struktura kakovosti statističnih podatkov, pridobljenih iz velikih virov podatkov, omogoča strukturirano predstavitev kakovosti, povezane z vsemi fazami statističnega poslovnega procesa, ter tako lahko služi kot osnova za celovito oceno in upravljanje tveganj, povezanih s temi novimi viri podatkov. Uvaja nove kakovostne dimenzije, ki so specifične za (ali visoko pomembne) za uporabo velikih podatkov v uradni statistiki, kot so institucionalno/mendlovsko okolje ali kompleksnost. Z uporabo teh novih kakovostnih dimenzij je mogoče sistematičneje odkrivati tveganja, povezana z uporabo velikih virov podatkov v uradni statistiki.
V tejle raziskavi si prizadevamo identificirati tveganja, povezana z uporabo velikih podatkov v kontekstu uradne statistike. Držimo se sistematičnega pristopa k opredelitvi tveganj v okviru predlagane strukture kakovosti. Osredotočamo se na novouvedena merila kakovosti, s katerimi lahko opišemo tveganja, ki trenutno ne obstajajo ali ne vplivajo na pripravo uradne statistike. Hkrati lahko opredelimo obstoječa tveganja, ki bodo ocenjena na povsem drugačen način pri uporabi velikih podatkov za pridobivanje statistike. Nato nadaljujemo v ciklu upravljanja tveganj in nudimo oceno verjetnosti in vpliva teh tveganj. Ker ocenjevanje tveganj predvideva subjektivnost pri njihovi atribuciji, merimo verjetnost in vpliv na različna tveganja ter strinjanje med številnimi različnimi zainteresiranimi stranmi, ki so bile predstavljene neodvisno. Nato predlagamo možnosti za zmanjšanje teh tveganj v skladu s štirimi glavnimi kategorijami: izogibanje, zmanjšanje, skupna raba in zadrževanje. Po ISO bi moral biti en od načel upravljanja tveganj ustvarjanje vrednosti, tj. viri za zmanjšanje tveganj bi morali biti manjši od virov za neukrepanje. V skladu s tem načelom bomo na koncu ocenili možen vpliv nekaterih ukrepov za zmanjšanje tveganj na kakovost končnih rezultatov, da pridemo do bolj celovite ocene uporabe velikih podatkov za uradno statistiko.
1. Uvod
1.1. Ozadje
Razvoj "velikih podatkov" je opredelil Kenneth Neil Cukier in Viktor Mayer-Schönberger v svojem članku "Rast velikih podatkov" (2. ) pojem "datafication". Datafication je opisan kot proces "prevzema vseh vidikov življenja in njihovega pretvarjanja v podatke". Na primer, Facebook omogoča osebne mreže, senzorje za vse vrste okoljskih pogojev, pametne telefone za osebno komunikacijo in premikanje ter nosljive podatke za osebne okoliščine. To vodi v skoraj vseprisoten zbir podatkov in dostopnost podatkov.
Kot v mnogih drugih sektorjih je uradna statistika šele nedavno začela razpravljati o problematiki velikih podatkov na strateški ravni. Še vedno ne obstaja skupno in široko sprejeto razumevanje poti naprej, naj bo to izziv ali priložnost, majhen ali velik in tako naprej. V okviru Skupine visoke ravni za modernizacijo statistične proizvodnje in storitev (3 How big is Big Data? Exploring the role of Big Data in Official Statistics: ), je bila opravljena prva SWOT analiza, ki jo je spremljala groba analiza tveganja/koristi. Opazili smo, da bo "celovita analiza tveganj prav tako vključila vidike, kot so verjetnost in vpliv, in morda bo tudi razširjena, da bi določila strategije za zmanjšanje tveganj in upravljanje z njimi."
Čeprav je ta dokument še daleč od celovite analize tveganj, je usmerjen k izboljšanju situacije z ustvarjanjem prvega strukturiranega pregleda. Radi bi poudarili, da je ta pregled treba obravnavati kot izhodiščno točko za spodbujanje splošne razprave v okviru Odbora za uradno statistiko (OSC).
1.2. Območje
Ta članek se osredotoča izključno na tveganja, izključuje ne samo prednosti, temveč tudi močne in šibke točke, priložnosti in grožnje. To pomeni, da "tveganja opustitve" (na primer tveganje, da bo OSC izgubila konkurenčnost s drugimi udeleženci, če ne bo modernizirana) ne spadajo v obseg; to so pravzaprav grožnje. Namesto tega poskušamo izpostaviti tveganja, ki se lahko pojavijo (a) če OSC izkoristi priložnosti, ki jih prinašajo veliki podatki, in začne razvijati ali izboljšati določen "izdelek uradne statistike na podlagi velikih podatkov" (BOSP); (b) tveganja za nov "normalni posel", torej tveganja za uradno statistiko, ki temelji na "velikih podatkih". (Ker je vse, kar zadeva proizvodnjo uradne statistike, povezano s tveganji, se omejujemo na (b) specifična za "tveganja velikih podatkov", tj. tveganja, ki ne obstajajo ali so nepomembna za "tradicionalni" proces zbiranja uradne statistike.)
1.3. Struktura
V razdelu 2 predstavljamo osnovne principe, povezane s to nalogo, ki se začne s očitno potrebnim temeljem za upravljanje tveganj in obvladovanje tveganj (razdelek 2.1). Predstavljamo tudi predhodno strukturo kakovosti statističnih podatkov, pridobljenih na podlagi velikih podatkov (razdelek 2.2), saj povezava strukture kakovosti s tveganji dosega dva cilja:
- Uvede kontekst za opredelitev tveganj. Določeni kazalniki kakovosti skupaj z obravnavanimi značilnostmi izražajo vrednote objekta, ki se štejejo za pomembne in odločilne za zagotavljanje storitev strankam in uporabnikom.
- Omogoča dodelitev konkretnih tveganj kakovostnim merjenjem, ki so vključena v splošne hiperprostor in povezana s specifičnimi fazami v procesu proizvodnje statističnih izdelkov.
V razdelkih 3, 4, 5 in 6 predstavljamo tveganja, identificirana do sedaj v različnih kontekstih (4 Dokumenti poslovnega primera ESS Big Data projekta, pa tudi v omrežjih ESS Big Data vsebujejo seznam tveganj, delno povezanih s projektom in delno z uporabo virov velikih podatkov za statistične namene. Dokument „Predlagana struktura za kakovost velikih podatkov“ omenjata nekatera tveganja, povezana s dimenzijami kakovosti.). Tukaj uporabljamo klasifikacijo dostopa do podatkov, pravno okolje, zasebnost in varnost podatkov ter spretnosti; reorganizacija v skladu s kakovostno strukturo statistike, pridobljene iz velikih podatkov (razdelek 2.2), bi morala biti obravnavana takoj, ko ta struktura doseže bolj dokončano stanje. Za vsako od identificiranih tveganj (i) zagotavljamo oceno verjetnosti in vpliva (v skladu z razdelkom 2.1.3) ter (ii) predlagamo strategije za zmanjšanje tveganj in obvladovanje le-teh (glej razdelek 2.1.4).
Na koncu bomo razpravljali o naših ugotovitvah in orisali nekatere naslednje korake v razdelku 7.
2. Osnove
2.1. Tveganja in obvladovanje tveganj
V skladu s standardom ISO 31000: 20095 se tveganje opredeljuje kot „vpliv negotovosti na postavljene cilje“. To pomeni, da morajo biti cilji določeni ali znani, preden lahko določimo tveganja. Ti cilji se običajno določajo ob upoštevanju institucionalnega konteksta ustrezne organizacije. Še eno pomembno vprašanje je, da tveganja nosijo značilnost negotovosti, to pomeni, da ni jasno, ali se bo opisani dogodek zgodil. Tako se tveganja merijo z vidika verjetnosti nastopa dogodka in njegovih posledic, tj. vpliv, ki ga ima ta dogodek na dosego postavljenih ciljev. Ocenjevanje tveganj mora zagotavljati bolj objektivne informacije, ki bodo na koncu omogočile iskanje primernega ravnovesja med uresničevanjem priložnosti za dobiček in minimalizacijo negativnih posledic. Upravljanje tveganj je sestavni del prakse upravljanja in pomemben element ustrezne korporativne prakse (6 Statistics Canada: 2014-2015 report on Plans and Priorities, ). To je iterativen proces, ki v idealnem primeru omogoča nenehno izboljševanje procesa odločanja in prispeva k stalnemu izboljšanju uspešnosti.
Tveganja so povezana tudi s kakovostjo. Uporaba sistema kakovosti bi morala omogočiti izkoriščanje priložnosti, ki jih nudijo različni viri in metodologije, za dosego rezultata določenega nivoja kakovosti v tem smislu, da ta rezultat zadostuje potrebam uporabnikov. Tako kot tveganja se lahko nivoji kakovosti pridobijo iz institucionalnega okolja in ciljev določenih institucij. V tem kontekstu institucionalno okolje določa splošno raven tveganja, ki ga organizacija pripravljena prevzeti za dosego svojih ciljev.
Postopek ocenjevanja in upravljanja tveganj je mogoče razdeliti na različne faze, ki vključujejo določitev konteksta, opredelitev tveganj, analizo tveganj z vidika verjetnosti in vpliva, oceno tveganj in končno obravnavo tveganj.
2.1.1. Institucionalni kontekst
Prvi korak je postaviti strateški, organizacijski kontekst i kontekst upravljanja rizicima unutar kojeg će se odvijati ostatak procesa. To uključuje uspostavljanje kriterija prema kojima će se rizici ocjenjivati i definiranje strukture analize.
2.1.2. Identifikacija rizika
U drugoj fazi treba identificirati događaje koji mogu utjecati na postizanje zacrtanih ciljeva. Identifikacija treba uključivati pitanja vezana uz tip rizika, vremenski okvir događaja, mjesto ili način na koji događaji mogu spriječiti, pogoršati, odgoditi ili poboljšati ostvarenje ciljeva.
2.1.3. Procjena rizika
Sljedeći korak uključuje određivanje postojećih sredstava kontrole i analizu rizika s aspekta vjerojatnosti, kao i iz perspektive mogućih posljedica. U kontekstu ovog članka, vjerojatnost ili učestalost nastanka rizika koristi ljestvicu od 1 (malo vjerojatno) do 5 (češće). Utjecaj nastanka događaja mjeri se ljestvicom od 1 (minimalno) do 5 (ekstremno). Kao što je prikazano u Tablici 1, proizvod vjerojatnosti i utjecaja daje 'razinu rizika' u rasponu od 1 do 25.
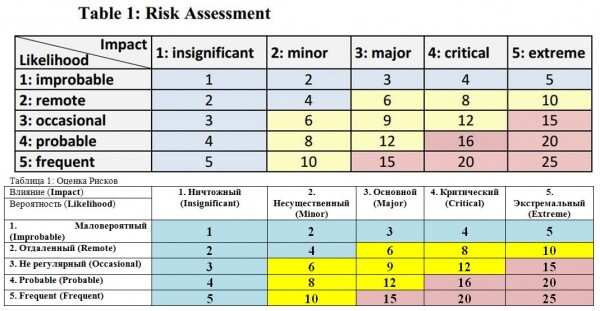
Procijenjene razine rizika mogu se usporediti s prethodno definiranim kriterijima kako bi se uspostavila ravnoteža između potencijalnih koristi i nepovoljnih ishoda. To omogućava donošenje prosudbi o prioritetima upravljanja.
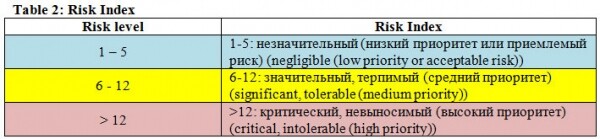
Prioritet za djelovanje treba odrediti za kritične rizike (vidi Tablicu 2), odnosno one koji mogu nastati i imaju ozbiljne ili ekstremne posljedice za ciljeve organizacije.
2.1.4. Reakcija na rizike
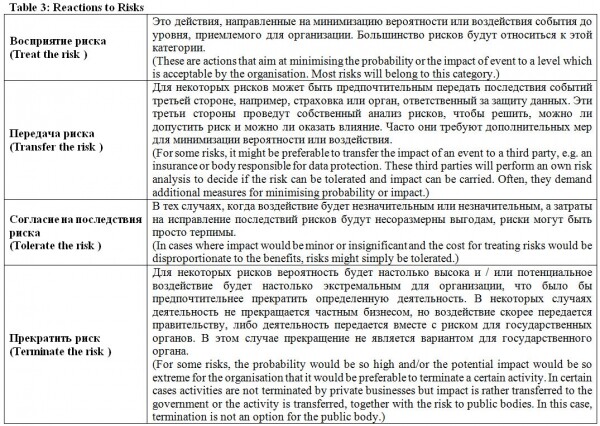
Zadnji korak je odločitev, kako se odzvati na tveganja. Nekatera tveganja, ki so pod vnaprej določenim nivojem tveganja, je mogoče ignorirati ali jih sprejeti. Pri drugih lahko stroški za obvladovanje tveganj presegajo potencialne koristi. V tem primeru se organizacija lahko odloči, da se umakne od ustreznih dejavnosti. Tveganja je mogoče tudi prenesti na tretje strani, kot je zavarovanje, ki kompenzira nastale stroške. Zadnja možnost je, da se tveganja upoštevajo pri določanju strategij in dejanj, ki uravnavajo stroške s potencialnimi koristmi. Tako se organizacija odloči za uvajanje strategij, ki maksimizirajo koristi in minimizirajo potencialne stroške.
2.2. Sistemi kakovosti
Ciljna skupina, sestavljena iz predstavnikov nacionalnih in mednarodnih statističnih organizacij, je leta 2014 razvila preliminarno strukturo kakovosti za statistiko, pridobljeno iz velikih podatkov. Ciljna skupina je delovala pod okriljem projekta UNECE/HLG „Vloga velikih podatkov pri modernizaciji statistične proizvodnje“. Razširila je obstoječe sisteme kakovosti, razvite za oceno statistike, pridobljene iz administrativnih virov podatkov, s kazalniki kakovosti, ki so bili ocenjeni kot pomembni za velike vire podatkov.
V okviru tega sistema se razlikujejo tri faze poslovnega procesa: vnos, produktivnost in izhod. Faza vnosa ustreza fazam „načrtovanja“ in „pridobivanja“ GSBP, produktivnost za faze „procesa“ in „analize“, medtem ko so izhodni podatki ekvivalentni fazi „širjenja“.
V strukturi se uporablja hierarhična struktura, ki je bila prevzeta iz strukture upravnih podatkov, razvite s strani Statističnega urada Nizozemske (7 Daas, P., S. Ossen, R. Vis-Visschers, in J. Arends-Toth, (2009), Checklist for the Quality evaluation of Administrative Data Sources. Statistics Netherlands, The Hague/Heerlen). Merila kakovosti so vključena v hierarhično strukturo, imenovano hipersprostorov. Tri določene hiperdimenzije so „vir“, „metapodatki“ in „podatki“. Merila kakovosti so vključena v te hiperdimenzije in dodeljena vsakemu od stopenj proizvodnje. Za fazo vnosa so bili predlagani dodatni aspekti „zaupnost in zasebnost“, „kompleksnost“ (v skladu s strukturo podatkov), „popolnost“ metapodatkov in „povezanost“ (možnost povezovanja podatkov z drugimi podatki), da se doda k modelu standardne kakovosti. Za vsako od meril kakovosti so predlagani dejavniki, povezani z njihovim opisom, ter morebitni kazalniki.
V okviru tega članka so tveganja lahko izključena iz teh dejavnikov. Na primer, dejavniki, ki jih je treba upoštevati za merjenje kakovosti „institucionalno/biznis okolje“, so trajnost dobavitelja podatkov. S tem povezano tveganje je, da podatki v prihodnosti ne bodo dostopni pri dobavitelju podatkov. Drug primer je povezan z nedavno predlaganim aspektom kakovosti, zasebnosti in varnosti. Eden od pomembnih dejavnikov je „percepcija“, kar pomeni možno negativno dojemanje predvidene uporabe določenih virov podatkov s strani različnih zainteresiranih strani.
3. Tveganja, povezana z dostopom do podatkov
3.1. Pomanjkanje dostopa do podatkov
3.1.1. Opis
To tveganje izhaja iz projekta, povezanega z razvojem BOSP, ki ne pridobi dostopa do potrebnega vira velikih podatkov (BDS).
Do sedaj je OSC doživel težko pot, da je celo izhod iz štartnih blokov in pridobitev tega dostopa včasih nepremostljiva ovira. Včasih je enostavno pridobiti dostop do določenega vira — kot so zapisi podatkov o klicih (CDR) — za namene testiranja/raziskovanja, vendar je mnogo težje (iz pravnih ali komercialnih razlogov) pridobiti dostop do njega za proizvodne namene.
3.1.2. Verjetnost
Verjetnost je v veliki meri odvisna od značilnosti BDS. Če gre za velike administrativne podatke, lahko znaša le 1, zlasti če (kot v primeru podatkov o prometu, ki so jih raziskovali Daas et al. 8 Daas, P., M. Puts, B. Buelens in P. van den Hurk. 2015. „Veliki podatki kot vir uradnih statistik“. Revija uradnih statistik 31 (2). (Pričakovano objavo junija 2015.)) ni težav s varstvom osebnih podatkov. Če gre za BDS, ki pripada zasebni osebi, zlasti če je ta občutljiva (na primer z vidika varstva podatkov) ali dragocena (oziroma gospodarsko gledano), je verjetnost lahko zelo visoka (5).
3.1.3. Vpliv
Vpliv je odvisen od BOSP in načina uporabe BDS. Če je BDS v središču, je vpliv lahko zelo visok (4 = praktično nemogoče ustvariti BOSP), medtem ko je lahko nižji, če je še vedno mogoče ustvariti BOSP (čeprav z nižjo kakovostjo), pri čemer se zanašamo na druge URB, kar povzroči vpliv v razponu 2-3.
3.1.4. Preprečevanje
Da bi zmanjšali tveganje za pomanjkanje dostopa, je priporočljivo vzpostaviti predhodne stike s ponudnikom podatkov in skleniti dolgoročno pogodbo o dostopu do podatkov. Poleg tega je potrebno izvesti celovit pravni pregled, ki se nanaša na specifično kombinacijo BDS in BOSP. Treba je tudi oceniti možnosti dostopa do podatkov v skladu z veljavnim ali prihodnjim zakonom.
3.1.5. Omblažitev
Če obstajajo alternativni BDS, ki bi jih lahko uporabili za BOSP, bi bilo smiselno raziskati te možnosti. Če ni načina za ustvarjanje BOSP brez BDS in če ni mogoče premagati pomanjkanja dostopa, je treba prizadevanja prekiniti in nov BOSP ne bo ugledal svetlobe.
3.2. Izguba dostopa do podatkov
3.2.1. Opis
To tveganje pomeni, da statistični organ izgubi BDS, na katerem temelji BOSP.
3.2.2. Verjetnost
Če BOSP že poteka, običajno obstaja določena stabilnost, v nekaterih primerih pa je tveganje lahko zelo nizko (1). Vendar pa, zlasti v primeru zasebnih subjektov, s katerimi so bila sklenjena nezadostno trdna soglasja, nič ne preprečuje, na primer, novega vodstva, da spremeni politiko zagotavljanja podatkov, kar lahko vodi do zmernega tveganja za prekinitev (3). Poleg tega, če je BDS povezana z nestabilno dejavnostjo, vedno obstaja tveganje, da ponudnik enostavno bankrotira, tveganje pa je lahko celo višje (4).
3.2.3. Vpliv
Ker je obstoječi BOSP morda nemogoč za proizvodnjo, pogosto pride do zelo močnega vpliva (5). V drugih primerih, ko ima BDS pomožno vlogo, je vpliv lahko bolj izguba kakovosti, z vplivom v razponu 2-3.
3.2.4. Preprečevanje
Strategija preprečevanja je podobna strategiji odsotnosti dostopa do podatkov, vendar s povečanjem poudarka na stalni budnosti tudi v proizvodnih razmerah.
Ne dajati vseh jajc v eno košaro (tj. imeti več BDS, ki temeljijo na vsakem BSOP) je prav tako lahko strategija, vendar je to lahko bodisi nepraktično bodisi predrago.
3.2.5. Omilitev
Če je BDS rezultat nestabilne dejavnosti, se morda postopoma pojavi nova BDS, ki odraža isto družbeno pojavnost. Vendar bi bilo prepozno začeti "iskanje trga", ko bi BSOP ali deloval; potrebna bo stalna budnost — kar je lahko težko doseči.
4. Tveganje, povezano s pravnim okoljem
4.1. Neupoštevanje ustrezne zakonodaje
4.1.1. Opis
To tveganje izhaja iz projekta, povezanega z razvojem BOSP, v katerem se ne upošteva ustrezna zakonodaja, kar naredi BOSP nezdružljivo z navedeno zakonodajo. To se lahko nanaša na zakonodajo o varstvu podatkov, predpise, ki se nanašajo na bremenitev odziva itd.
4.1.2. Verjetnost
Glede na nevednost OSC o velikih podatkih ni izključeno, da lahko pride do naključnega (3) neupoštevanja. Verjetnost je običajno povezana z BDS, saj je manj "občutljiv" vir, manjša je verjetnost neustreznosti.
4.1.3. Vpliv
Vpliv je ponavadi kritičen (4) v smislu, da bo za neustrezno proizvodnjo potrebno ustaviti BOSP (ali, če še ni dosegel faze uvedbe, mora biti njegova razvojna faza prenehana). To je lahko celo ekstremno (5), saj lahko reputacijska tveganja, ki izhajajo iz neustrezne ('nezakonite') uradne statistike, povzročijo posledice.
4.1.4. Preprečevanje
Vsak BOSP je treba skrbno pravno analizirati - in to poteka v več fazah (kar je sprejemljivo v fazi razvoja / raziskovanja, morda ne bo tako v fazi uvedbe / proizvodnje). To pa lahko privede do reinžiniranja BOSP, da postane združljiv.
4.1.5. Omilitev
Glede na resnost neskladja je lahko prvi korak prehod BOSP v avtonomni način delovanja.
Reinžiniranje BOSP, da postane združljiv, je lahko možnost, toda to, ali bo BOSP 'rešen' na ta način, močno odvisno od narave neskladja.
4.2. Negativne spremembe v pravnem okolju
4.2.1. Opis
Lahko se uvede nova zakonodaja, ki se nanaša na razvijajoči se BOSP, kar dejansko povzroči, da BOSP postane nezdružljiv.
4.2.2. Verjetnost
Ni izključeno, da podporniki okrepljene zaščite podatkov uspejo uvesti nove zahteve, ki neposredno ali posredno vplivajo na zmožnost ustvarjanja določenih BOSP. Verjetnost v razponu 2-3 se zdi realistična ocena.
4.2.3. Vpliv
Vpliv je ponavadi kritičen (4), v smislu, da bo neustrezno proizvodnjo zahtevalo ustavitev BOSP.
4.2.4. Preprečevanje
Določene poslovne informacije je treba redno spremljati za nadzor razvoja zakonodaje - morda tudi zato, da nanjo vplivamo, tako da zastavljamo argumente za uradno statistiko na ustreznih (npr. svetovalnih) forumih.
4.2.5. Omilitev
Ob predpostavki, da je bil opravljen proaktiven nadzor, je lahko čas za reinžiniranje BOSP, da ga uskladimo z novo zakonodajo od prvega dne njenega začetka.
Če pa spremljanje ni bilo izvedeno, tako da je novo zakonodajo »presenetilo« – ali če je zakonodaja tako radikalna, da ni mogoče narediti BOSP nezdružljivega – je edina možnost lahko izklopiti BOSP.
5. Tveganja, povezana s zasebnostjo in varnostjo podatkov
5.1. Kršitve varnosti podatkov
5.1.1. Opis
To tveganje se nanaša na nepooblaščen dostop do podatkov, shranjenih v statističnih upravah. Tretje osebe lahko pridobijo podatke, ki so pod embargom, na primer zaradi objave časovnice. (9 Za vsak BOSP, ki temelji izključno na eni sami BDS, je neizogibno, da bodo podatki implicitno znani prvotnemu lastniku podatkov, in če je metodologija pregledna, bodo znani tudi pridobljeni statistični podatki. Ta situacija ni obravnavana tukaj, ampak prej v tveganju, povezanem s zlorabo položaja s strani lastnikov.) (10 Poleg tega ti podatki lahko nosijo tveganje kršenja zasebnosti. To tveganje bo obravnavano ločeno.). To so lahko na primer podatki, ki jih vlagatelji pričakujejo na borzi.
5.1.2. Verjetnost
Glede tehničnih vidikov zaščite IT-okolja v statističnem oddelku ima tveganje enako verjetnost za BDS kot za tradicionalne vire. Vendar pa sta dva dodatna vidika, ki ju je treba upoštevati.
Prvič, pri nekaterih BDS se splošno tveganje rahlo poveča zaradi tega, ker varnost podatkov prvotnega lastnika lahko postane ogrožena. To lahko vključuje na primer industrijsko vohunstvo ali hekerske napade.
Drugič, takoj ko se potencialno dragoceni podatki začnejo shranjevati v poslovnih prostorih, se tveganje privabljanja zlonamernih namer poveča. Če so shranjeni podatki zelo dragoceni za podjetje, je treba biti pripravljen na zelo visoko verjetnost napadov na IT-infrastrukturo, zato je lahko verjetnost hekerskega napada potencialno višja (4).
Če shranjeni podatki niso obravnavani kot dragoceni, se splošna verjetnost zdi ne zelo visoka – od (1) do (3), odvisno od vira podatkov.
5.1.3. Vpliv
Potencialna škoda za ugled je lahko velika (5). Pomembno pri BDS je to, da bo vpliv na ugled statističnega upravljanja, kot se pričakuje, nižji, če do kršitve varnosti pride pri prvotnem lastniku, kot bi bil, če bi kršitev nastala z podatki, ki jih hrani.
Po drugi strani pa je možno, da lahko kršitev v statističnem upravljanju negativno vpliva na prvotnega lastnika. V tem primeru je ponovno mogoče močno negativno vplivati zaradi škode z vidika zaupanja med dobaviteljem in statističnim upravljanjem (5).
5.1.4. Preprečevanje
Posebnost primera BDS je, da so postopki varnosti prvotnega lastnika lahko primerni. Malo verjetno je, da bodo statistična upravljanja pridobila pooblastila za revizijo, da bi to nadzirala. Lastniki, katerih podatki se uporabljajo za izdelavo zapisov s podatki o zaupnih razporedih objav, morajo biti obveščeni o posledicah za uradno statistiko v primeru potencialne kršitve varnosti v njihovih prostorih in morajo prejeti uradno zagotovilo, da so sprejeti ustrezni postopki varnosti.
Neposreden način za preprečevanje resnega vpliva kršitve varnosti v prostorih lastnika na statistično upravljanje je zagotovitev uporabe več virov za isti izdelek, da en sam ogrožen vir ne bi bil dovolj za pridobitev končne številke. Prednost tega pristopa je, da je večji nadzor v rokah statističnega upravljanja.
Metoda za preprečevanje negativnih posledic kršitve varnosti v statističnem uradu za prvotnega lastnika podatkov je, da se najde način dela, ki ne predvideva prenosa podatkov, ki so potencialno občutljivi z vidika lastnika, v statistično upravo. V surovem stanju. Možen preventivni pristop je uporaba agregiranih podatkov. Treba je upoštevati, da nekaterih oblik agregacije, na primer tistih, katerih namen je preprečiti identifikacijo posameznih članov populacije, morda v tem primeru ne bo mogoče uporabiti. Eden od razlogov za to je lahko dejstvo, da je tveganje za lastnika povezano s {komercialno vrednostjo} podatkov, ki je lahko pomembna tudi po doseganju anonimnosti.
5.1.5. Omilitve
V primeru kršitve podatkov, ki jih obravnava statistična uprava, bodo ukrepi za omilitev posledic taki kot pri tradicionalnih virih, če ne pride do negativnega vpliva na prvotnega lastnika.
V primeru negativnih posledic za prvotnega lastnika mora statistična uprava ponovno preučiti in okrepiti svoje varnostne postopke ter jasno sporočiti in dokazati svojo zavezanost temu.
Če je prišlo do kršitve v prostorih prvotnega lastnika, mora ustrezna statistična služba jasno obvestiti o situaciji in vztrajati pri izboljšanju varnostnih postopkov lastnika. Po potrebi je mogoče poiskati alternativnega dobavitelja.
5.2. Kršitve zasebnosti podatkov
5.2.1. Opis
To je tveganje, da bo zasebnost enega ali več oseb iz statistične populacije kršena. To se lahko zgodi zaradi napada na IT-infrastrukturo zaradi pritiska drugih državnih institucij ali zaradi neustreznih ukrepov nadzora pri razkrivanju statističnih podatkov.
5.2.2. Verjetnost
Kot pri tveganju kršitve varnosti podatkov se tehnične zahteve za shranjevanje mikro podatkov ne spremenijo bistveno pri dodajanju BDS. Vendar so tudi tukaj nekatera opozorila.
Mikro podatki iz določenih virov podatkov lahko imajo visoko poslovno vrednost, zato bo njihovo shranjevanje povečalo verjetnost napadov.
Poleg tega so lahko nekatere mikropodatke potencialno zelo koristne za druge državne institucije, na primer za organi pregona, davčno upravo ali zdravstvo. V določenih okoliščinah se lahko zaveza načelu statistične zaupnosti znajde pod velikim pritiskom.
Kar zadeva napake pri nadzoru razkrivanja statističnih informacij, že trenutno obstaja dobro uveljavljen sistem. BDS lahko omogoči ustvarjanje statistike za majhne podskupine prebivalstva ali omogoči povezovanje agregiranih podatkov iz različnih BDS, kar lahko poveča verjetnost tveganja. Poleg tega pa bodo novi viri zahtevali nove metodološke pristope, zato je realna nevarnost, da se metodologija nadzora razkrivanja informacij ne posodobi ustrezno.
Na splošno, ob smiselnih preventivnih ukrepih, lahko verjetnost ostane na razumnih ravneh, vendar pa obstaja več različnih in raznolikih dejavnikov, zato je ustrezna ocena tukaj očitno taka, da je verjetnost visoka (4).
5.2.3. Vpliv
Potencialna škoda za ugled je lahko velika (5). Tako kot pri tveganju kršitve varnosti podatkov, lahko tudi kršitev v statističnem upravljanju privede do negativnih posledic za prvotnega lastnika. Vpliv takega dogodka je lahko potencialno še večji, še posebej ob predpostavki, da se trenutni trendi v javnem mnenju ohranjajo. Škoda v odnosih med ponudnikom podatkov in statističnim upravljanjem bo prav tako zelo velika.
5.2.4. Preprečevanje
Brezhibočan način za preprečevanje takšnega tveganja je, da sploh ne hranimo mikropodatkov iz BDS (čeprav hranjenje drugih mikropodatkov še vedno prinaša ustrezno tveganje, čeprav z drugimi verjetnostmi in vplivi). Ta pot bo, tako kot v primeru tveganja zlorabe podatkov, povzročila potrebo po razvoju drugih načinov uporabe podatkov za statistične namene. Poleg tega bo raznolika narava virov pomenila, da bo treba razviti nove metodologije z konkurirajučimi cilji za pridobitev čim več koristnih informacij in zaščito zasebnosti pred nevarnostmi.
V primeru shranjevanja mikropodatkov morajo biti mehanizmi za zagotavljanje varnosti IT in nadzor dostopa na zahtevanem nivoju in redno nadzorovani. Posebno pozornost je treba nameniti zagotavljanju varnosti novih načinov pridobivanja podatkov. Ironično, tak nov način je lahko fizična transporta shranjevalnih naprav (na primer trdih diskov). Če se ta metoda uporablja, mora biti dostava fizično zaščitena, ter mora biti uporabljeno šifriranje.
5.2.5. Omejevanje
Omejevalni ukrepi so v bistvu enaki tistim v primeru zlorabe podatkov. Če je vzrok zlorabe pritisk drugega državnega organa, je treba izkoristiti priložnost za krepitev neodvisnosti upravljanja, da bo takšne kršitve v prihodnosti še težje doseči.
5.3. Manipulacije z virom podatkov
5.3.1. Opis
Dobavitelji podatkov tretjih oseb, na primer podatki družbenih omrežij ali prostovoljno posredovani podatki, so izpostavljeni tveganju manipulacije. To lahko stori bodisi sam dobavitelj podatkov bodisi tretje osebe. Na primer, veliko lažnih sporočil na družbenih omrežjih se lahko generira za vplivanje na statistični indeks, pridobljen na osnovi teh podatkov, na ta ali oni način, če je znano, da se indeks obračuna na podlagi teh podatkov.
Pri prostovoljno posredovanih podatkih se lahko zgodi, da prostovoljci predstavljajo določeno skupino interesov z določeno agendo.
5.3.2. Verjetnost
Pri podatkih, katerih manipulacija lahko prinese velike koristi, je verjetnost višja. To so lahko podatki, za katere so statistike zanimive, na primer borzni trg. Glede na nedavne škandale, povezane z LIBOR-om in Forexom, lahko domnevamo, da bodo, dokler obstajajo spodbude, poskusi manipulacije s podatki verjetni.
Za statistiko, ki temelji na prostovoljno posredovanih podatkih, je dovolj pogledati na nedavno prakso PR-a zaposlovanja ljudi, ki se pretvarjajo, da imajo določeno mnenje, in jim plačujejo za javno izražanje (na primer na internetnih forumih), da bi lahko sklepali, da verjetnost ni majhna. Na splošno se zdi številka od 3 do 4 ustrezna.
5.3.3. Vpliv
Velik problem z manipulacijami je, da lahko trajajo dolgo časa, ne da bi jih odkrili. Če manipulacije trajajo dolgo, lahko postane vpliv na kakovost pomemben. Poleg tega lahko škoda za javno zaupanje v uradne statistike prav tako postane velika, še posebej, če se javno poudarja vloga statističnih uradov kot dobaviteljev kakovostnih podatkov. Po drugi strani pa, če se manipulacije pravočasno odkrijejo in nato objavijo, lahko to dejansko izboljša javno percepcijo. Razen izjemno slabih primerov se lahko predstavi največji vpliv (3).
5.3.4. Preprečevanje
Izvajanje rednih kontrolnih vaj z alternativnimi viri je ena izmed možnih preventivnih pristopov. Ti alternativni viri so lahko tradicionalni ali drugi. Uporaba statistike, ki temelji na kombinaciji virov, lahko prepreči pomembne vplive manipulacij. V primerih, kjer se bojimo manipulacij, ki jih sproži ponudnik, so pravni sporazumi lahko prav tako en način preprečevanja takšnega ravnanja.
5.3.5. Omilitev
Z vidika škode za javne odnose se ukrepi za omilitev, ki jih je treba sprejeti tukaj, malo razlikujejo od ukrepov proti kakršnemu koli krizi.
Z vidika kakovosti podatkov bi bilo koristno, če bi lahko bila prejšnja podatka popravljen na način, da bi tudi z veliko zamudo lahko imeli pravilno vrstico.
В этом контексте регулярный бенчмаркинг может быть полезным. Обратите внимание, что цель сравнительного анализа здесь немного отличается от цели предотвращения. Важно быстро замечать и расследовать подозрительное несоответствие между данными эталонного теста и BDS для смягчения последствий, поэтому старые полезные данные будут всегда актуальны.
Кроме того, стоит позаботиться о том, чтобы такие манипуляции не повтарялись в будущем — в особо деликатных случаях это может означать получение избыточных данных от нескольких поставщиков для проведения сравнительного анализа.
5.4. Негативное общественное восприятие использования больших данных в официальной статистике
5.4.1. Описание
СМИ и широкая общественность очень чувствительны к вопросам конфиденциальности и использованию персональных данных из больших объемов данных, особенно в контексте вторичного использования данных государственными органами, применяющими административные или правовые меры к гражданам. Негативным примером может являться использование данных навигации для контроля скорости. ).
Конкретный случай с TomTom в Нидерландах вызвал значительное снижение спроса на устройства компании и привел к решению ограничить доступ к данным. Хотя данные касались отдельных личностей, они были связаны с уровнями скорости на участках дорог.
Тем не менее, существуют приложения с большими данными, которые положительно воспринимаются обществом. Например, приложения, которые предотвращают преступления, такие как кража со взломом, используя методы больших данных.
Как позитивное, так и негативное общественное мнение могут иметь значительное влияние на использование BDS в производстве официальной статистики.
Последствием негативного общественного восприятия может стать то, что:
- BDS больше не будет доступен для статистических управлений, будь то из-за решений поставщика данных или правительства не использовать данные, либо
- использование данных будет ограничено, что может затруднить производство, если определенные BOSP.
5.4.2. Verjetnost
Dejavniki, ki lahko vplivajo na verjetnost takega dogodka ali njegovega vpliva na proizvodnjo statistike:
- zaupnost podatkov, tj. kako enostavno je identificirati ljudi;
- obseg informacij, ki jih podatki razkrivajo o fizičnih osebah, se povečuje, na primer, s povezovanjem podatkov iz različnih virov;
- tip podatkov, na primer, finančne transakcije se obravnavajo kot bolj zaupne kot drugi podatki;
- tip potencialne dejavnosti, ki bi lahko bila izvedena v zvezi z državljani, na primer, kaznovanje ljudi za prekoračitev hitrosti;
- nejasno pravno okolje, v katerem delujejo ponudniki in uporabniki podatkov, ali ko pravni pogoji nasprotujejo javnim etičnim mnenjem / standardom;
- stopnja odvisnosti od določenega vira podatkov za pridobitev statistike; v fazi raziskovanja je ta dejavnik lahko nepomemben. Vendar pa lahko to zelo močno vpliva na pridobivanje statistike v kasnejši fazi, zato je treba to obravnavati tudi v fazi raziskovanja. Ena od težav je lahko, da končni obseg uporabe podatkov na začetku ni znan, saj lahko viri podatkov potencialno služijo več kot enemu statističnemu področju.
Ocenitev časa nezaželenih pojavov je nemogoča, saj mobilizacija javnosti pogosto izhaja iz poročanja o dogodkih, ki negativno vplivajo na državljane. Kljub temu pa, s povečevanjem uporabe velikih podatkov s strani vlad in zasebnih podjetij, zlasti z aktivnim trženjem podatkov za druge namene, kot je tisto, ki je privedlo do njihovega prvotnega zbiranja, postaja bolj verjetno, da se takšni dogodki zgodijo.
Dogodki, ki močno vplivajo na javno mnenje, niso pogosti, temveč bolj naključni (3) in oddaljeni (2). S povečanjem uporabe velikih virov podatkov se verjetnost tudi povečuje.
5.4.3. Vpliv
Vpliv dogodka je zelo odvisen od dejavnikov, ki so bili obravnavani zgoraj. Na splošno je vpliv bolj resen za že vzpostavljeno proizvodnjo statističnih podatkov, saj je mogoče, da je treba dejanje prekiniti. Vpliv je prav tako odvisen od razpoložljivosti alternativnih virov podatkov, čeprav se lahko zgodi, da javno mnenje ne razlikuje različnih virov podatkov v primeru materializacije dogodka. V trenutnem stanju uporabe velikih podatkov se zdi, da ti viri ne morejo v celoti nadomestiti tradicionalnih virov podatkov, temveč dopolnjujejo obstoječo statistiko. To bo zmanjšalo vpliv dogodkov. Zato se vpliv dogodka ocenjuje v razponu od 2 (marginalen) do 3 (pomemben). V fazi proizvodnje se lahko vpliv poveča na 4 (kritična vrednost).
5.4.4. Preprečevanje
Preventivni ukrepi lahko vključujejo določitev etičnih načel za velike podatke v uradni statistiki. Etična načela bi morala temeljiti na takih načelih, kot je kodeks praks za evropsko statistiko ali temeljna načela uradne statistike (12 ). Naslednji ukrep bo določitev komunikacijske strategije, ki bo objavila rezultate etičnih načel za javnost in se lahko uporablja za obveščanje zainteresiranih strani o etični uporabi BDS za BOSP.
Posebna ocena tveganja za določen BDS se lahko izvede za ugotovitev tveganj in predlaganje preventivnih ali ublažujočih ukrepov na podlagi etičnih načel. Posebna ocena tveganj lahko vključuje tudi zainteresirane strani, kot so agencije za zaščito podatkov, da se zagotovi identifikacija vseh tveganj in utemeljenost ukrepov.
5.4.5. Ublažitev
Komunikacijska strategija mora tudi vključevati ukrepe v primeru naraščajočega negativnega odnosa javnosti. Ločena ocena tveganja mora zbirati pozitivne primerke uporabe podatkov in ukrepe za preprečevanje zlorab podatkov, ki jih je mogoče nujno sprejeti na politični ravni, pri čemer je statistična skupnost morda nezmožna učinkovito vplivati na njih.
5.5. Izguba zaupanja — pridobljena ne na podlagi opazovanja
5.5.1. Opis
Uporabniki uradne statistike običajno zelo zaupajo natančnosti in verodostojnosti statističnih podatkov. To izhaja iz dejstva, da je proizvodnja statističnih podatkov vgrajena v zanesljivo in javno dostopno metodološko osnovo ter dokumentacijo o kakovosti statističnega proizvoda. Poleg tega je večina statističnih podatkov temelji na opazovanjih, tj. pridobljenih iz raziskav ali popisov, kar vzpostavlja lahko razumljivo povezavo med opazovanjem in statističnimi podatki. Uporaba BDS, ki niso zbrani za osnovne statistične namene, prinaša tveganje, da se te povezave izgubijo in uporabniki izgubijo zaupanje v podatke uradne statistike. Primer, ki se nanaša na zadnjo rundo (2010) popisa prebivalstva, je povezan s tem, da so v nekaterih državah statistični podatki pridobljeni z uporabo več virov in statističnih modelov. V nekaterih primerih so deležniki izpodbijali statistične podatke.
5.5.2. Verjetnost
Verjetnost occurrence tveganja je odvisna od takih dejavnikov, kot so zapletenost statističnega / metodološkega modela, verodostojnost odnosov med BSD in BOSP ali skladnost z drugimi statističnimi podatki. Verjetnost mora biti v razponu od 3 (naključni) do 4 (verjetni), kar pomeni, da se lahko zgodi večkrat ali pogosto.
5.5.3. Vpliv
Vpliv nastanka tveganja bo v veliki meri odvisen od sposobnosti NSO, da uspešno dokažejo natančnost in zanesljivost statističnih podatkov. Če to ne bo mogoče, lahko vpliv na izgubo zaupanja in zaupanja prizadene tudi druge statistične področja, torej zanesljivost ne le nekaterih statističnih podatkov, temveč tudi postavi pod vprašaj samo organizacijo. NSO bi izgubili konkurenco pred drugimi zasebnimi organizacijami, ki delujejo na tem področju.
5.5.4. Preprečevanje
Preventivni ukrepi bodo vključevali razvoj in objavo znanstveno utemeljene metodologije, ki jo priznava znanstvena skupnost, obogatenje podatkov z metapodatki o kakovosti, zagotavljanje skladnosti BOSP z ne BOSP ter izvajanje strogega nadzora kakovosti.
Preden se začne statistična proizvodnja, bi bilo možno BOSP objaviti kot eksperimentalno, zainteresiranim stranem pa se priporoča, da izzovejo BOSP, da potrdijo ali izboljšajo BOSP.
5.5.5. Omblažitev
Obstajata dva primera, ki ju je treba ločevati. V primeru, da so statistični podatki izpodbijani, vendar imajo visoko/dovolj kakovost (pravilni/takšni), bi bilo dovolj razložiti in posredovati statistične podatke javnosti, pri čemer bi zagotovili enostavne primere za razumevanje.
6. Tveganja, povezana s spretnostmi
6.1. Pomanjkanje strokovnjakov
6.1.1. Opis
Analiza digitalnih sledi, ki jih ljudje puščajo med izvajanjem svojih dejavnosti, zahteva posebna orodja za analizo podatkov, ki trenutno niso najbolj razširjena v uradni statistiki. Prvič, uporaba posrednih podatkov o dejavnostih ljudi namesto neposrednih anket v raziskavah zahteva uporabo statističnih modelov in posledično spretnosti sklepanja ter strojnega učenja. Drugič, ti digitalni zapisi so sestavljeni iz podatkov, ki pogosto nimajo običajne oblike tabele, značilne za rezultate anket, kjer so vrstice povezane z statistično enoto, stolpci pa z določenimi značilnostmi teh statističnih enot. Digitalne sledi so prav tako predstavljene v obliki besedila, zvoka, slik in videa. Izvlečenje ustreznih statističnih informacij iz teh vrst podatkov zahteva spretnosti obdelave naravnega jezika, obdelave zvočnih signalov in obdelave slik. Tretjič, ti viri podatkov imajo tendenco nuditi obsežne nizke podatkov, katerih obdelava zahteva dobro razumevanje metodologij porazdeljenih računalništva.
Tveganje pomanjkanja strokovnjakov se pojavi pri pridobivanju podatkov iz enega od teh novih velikih virov podatkov, saj statistične ustanove nimajo zmogljivosti za ustrezno obdelavo in analizo zaradi pomanjkanja potrebnih znanj njihovega osebja.
6.1.2. Verjetnost
Verjetnost tega tveganja bo odvisna od treh dejavnikov: 1) specifične vrste znanj, potrebnih za vsak tip vira velikih podatkov, in verjetnost, da bo statistična uprava imela priložnost raziskati tak vir; 2) trenutno razpoložljivost potrebnih znanj v statistični upravi; in 3) organizacijska kultura statistične uprave.
Kar se tiče vrst spretnosti, ki so morda potrebne, je treba opozoriti, da vsi viri ne zahtevajo vseh zgoraj naštetih spretnosti. Nekateri (na primer podatki vrste Google Trends) ne potrebujejo porazdeljenih izračunov, saj so že vnaprej obdelani s strani nosilca podatkov ali imajo spretnosti obdelave signalov, in bodo potrebovali predvsem spretnosti statističnega modeliranja. Kljub temu obstaja široka paleta virov velikih podatkov, za katere so večinoma potrebne spretnosti porazdeljenih izračunov, obdelave signalov in strojnjeg učenja. Hkrati bo pravilna raziskava teh digitalnih sledi zahtevala obdelavo več virov. Zato obstaja velika verjetnost, da bodo veliki viri podatkov, ki postajajo dostopni za statistično upravljanje, zahtevali te nenavadne spretnosti, in verjetnost tega tveganja je zelo visoka (5).
Kar zadeva trenutno razpoložljivost potrebnih spretnosti, bo to odvisno od posameznega statističnega upravljanja. Tudi če je metodologija ankete manj razširjena kot metodologija raziskave, se tudi ta uporablja v uradni statistiki na posameznih področjih. Zato, tudi če lahko izbira zahteva določeno prerazporeditev človeških virov, lahko statistična upravljanja najdejo rešitev sami. Kar se tiče spretnosti porazdeljenih izračunov, ki so predvsem povezane z IT, bodo odvisne od načina upravljanja IT infrastrukture v organizaciji. Glede na to, v kolikšni meri je IT oddelek sposoben, se lahko rešitve najdejo v okviru obstoječih dogovorov. Kljub temu pa spretnosti obdelave signalov in strojnjeg učenja običajno ne obstajajo v večini uradnih statističnih uprav, in uporaba teh spretnosti ni prenosljiva na zunanje izvajalce, saj jih morajo uporabljati strokovnjaki na področju statistike. Tako se z vidika tveganja zdi tudi ta verjetnost zelo visoka (5).
Organizacijska kultura bo prav tako vplivala na verjetnost tega tveganja. Imati osebje, ki je pripravljeno pridobiti potrebne veščine s samoučenjem, lahko organizaciji omogoči, da se odzove na situacijo z novim virom podatkov, ki zahteva veščine, drugačne od običajnih. To bo odvisno od organizacijske kulture statističnega upravljanja, in sicer od tega, ali ta spodbuja zaposlene k usvajanju novih veščin in ali zaposlenim omogoča čas za samostojno učenje.
Tako bo verjetnost, da statistično upravljanje ne bo moglo obdelovati in analizirati novih virov podatkov zaradi pomanjkanja veščin pri svojih zaposlenih, med verjetno (4) in pogost (5), odvisno od kulture samoučenja v organizaciji.
6.1.3. Vpliv
Statistično upravljanje, ki ne more obdelovati in analizirati velikih virov podatkov zaradi pomanjkanja veščin pri svojih zaposlenih, lahko ima dve možni negativni posledici: 1) vir podatkov ne bo ustrezno preučen, vsaj ne v celoti; 2) vir bo nepravilno uporabljen.
Pomanjkanje sposobnosti celovitega preučevanja potenciala dragocenega vira velikih podatkov bo imelo manjši vpliv (2) na kratkoročni ravni, saj statistična upravljanja resnično razpolagajo s statističnimi orodji za zadostitev trenutnim potrebam. Vendar pa bo v dolgoročni (in morda celo srednjeročni) perspektivi posledica izgube te priložnosti odločilna (4), saj se statistični subjekti vse pogosteje soočajo s konkurenco zasebnih ponudnikov, ki nimajo takšne institucionalne strukture, ki bi jim omogočila zagotavljanje neodvisnosti statističnih podatkov družbi.
Vendar pa bo nepravilna uporaba virov imela izjemno negativne posledice za statistične urade, saj uradna statistika v veliki meri temelji na svoji reputaciji pri izvajanju svoje misije. Kljub temu lahko trdimo, da je najpomembnejša veščina, ki lahko, če je spregledana, privede do napačnih rezultatov, statistično sklepanje, zlasti sklepanje, ki temelji na modelu, kar bo tudi manj verjetno manjkalo. Tako bo pričakovani vpliv verjetno kritičen (4), ne pa ekstremalen.
6.1.4. Preprečevanje
Statistični uradi lahko aktivno preprečujejo to tveganje na dva načina: 1) usposabljanje; in 2) zaposlovanje.
Statistični uradi lahko osebju zagotovijo potrebne veščine, tako da natančno določijo veščine, potrebne za uporabo velikih podatkovnih virov v statistični produkciji, sestavijo seznam obstoječih veščin osebja, ugotovijo potrebe po usposabljanju in nato organizirajo tečaje usposabljanja.
Statistični uradi lahko tudi zaposlujejo nove delavce z potrebnimi veščinami. To se zdi imeti resne omejitve, saj statistični uradi ne bodo mogli doseči kritične mase osebja v situaciji, ko bo uporaba velikih podatkovnih virov široko razširjena v oddelku, novi delavci pa bodo vseeno potrebovali več let, da dosežejo raven izkušenj obstoječih zaposlenih. Vendar pa lahko vsaj nekateri novi zaposleni, ki se zaposlujejo v okviru običajnega obnavljanja osebja, obvladajo veščine, povezane z velikimi podatki.
6.1.5. Omblažitev
Ob soočenju s situacijo, ko so novi viri velikih podatkov dostopni brez zaposlenih s potrebnimi veščinami, lahko statistični uradi omilijo negativne posledice na dva načina: 1) podpogodbeno delo; in 2) sodelovanje.
Statistične uprave lahko sklenejo pogodbe o obdelavi podatkov in analizi novih virov velikih podatkov z drugimi organizacijami, ki nudijo te vrste storitev. Zdi se, da je to izvedljiva rešitev, saj se pojavlja nov sektor podjetij, ki se specializirajo za obdelavo takšnih podatkov. Vendar pa je ta rešitev sama po sebi povezana s določenimi tveganji, saj bo imela statistična uprava manjši nadzor nad proizvodnjo potencialno občutljivih statističnih produktov. Ta rešitev ima tudi pomanjkljivost, da ne omogoča zaposlenim v statistični upravi, da se učijo in pridobivajo potrebne veščine.
Sodelovanje z drugimi organizacijami, v katerih so zaposleni z potrebnimi veščinami in ki so prav tako zainteresirani za preučevanje virov velikih podatkov, se zdi bolj obetavna rešitev. To sodelovanje lahko prevzame obliko skupnih projektov z zaposlenimi statistične uprave in zaposlenimi drugih organizacij na enakih pozicijah, ki delijo svoje znanje. To bi omogočilo ne le zmanjšanje tveganja pomanjkanja znanj, temveč tudi omogočilo zaposlenim v statistični upravi, da pridobijo te veščine.
6.2. Odliv strokovnjakov v druge organizacije
6.2.1. Opis
To tveganje pomeni, da statistične uprave izgubljajo svoje osebje drugim organizacijam, potem ko so pridobili veščine, povezane z velikimi podatki.
6.2.2. Verjetnost
Verjetnost tega tveganja bo odvisna od dveh dejavnikov: 1) obstoječe privlačne priložnosti v organizacijah izven uradne statistike; 2) pogoji dela v statističnih upravah.
Kar zadeva zmožnosti v organizacijah izven uradne statistike, se zdi verjetnost tega tveganja precejšnja (4). Obstaja velik povpraševanje po ljudeh s spretnostmi za delo z velikimi podatki v zasebnem sektorju, pa tudi v drugih organizacijah javnega sektorja. Po pridobitvi veščin za delo z velikimi podatki bodo uradne statistike dobile primerjalno prednost, saj bodo izkušeni strokovnjaki na področju statistike. Poleg specifičnih veščin dela z velikimi podatki druge organizacije potrebujejo strokovnjake za podatke, ki imajo bolj tradicionalne spretnosti, kot so ocena potreb uporabnikov in razvoj ključnih kazalnikov uspešnosti (KPI), ki so skupni za uradne statistike. Poleg tega se pričakuje, da bodo zaposleni, ki bodo bolj nagnjeni k pridobivanju novih veščin, tudi tisti, ki bodo bolj odprti za spremembe v karieri in zapustili statistični urad.
Kar zadeva delovne pogoje v statističnih uradih, bo to očitno odvisno predvsem od konkretne pisarne. Kljub temu statistični uradi na splošno še vedno ponujajo privlačne poklicne priložnosti za ljudi s kvantitativno usposobljenostjo. Statistični uradi ponujajo največji spekter možnih področij za delo in največjo izbiro podatkov za delo. To bo na nek način zmanjšalo verjetnost, da bi statistični uradi izgubili svoj kader zaradi nepredvidenih okoliščin (3).
6.2.3. Vpliv
Vpliv tega tveganja bo enak tveganju zaradi pomanjkanja kadra s primerljivimi spretnostmi. Zato bo vpliv kritičen (4), kot je navedeno zgoraj.
6.2.4. Preprečevanje
Zdi se, da je edina možna priložnost za statistične urade, da preprečijo to tveganje, zagotavljanje privlačnih delovnih pogojev za svoje zaposlene. To velja na splošno za vse osebje. Vendar pa je v konkretnem primeru, ko so zaposleni odprti za pridobivanje novih znanj, predvsem znanj o velikih podatkih, mogoče delovne pogoje izboljšati z nudijo priložnosti za usposabljanje, kjer lahko razvijajo svoje poklicne interese. Statistični uradi lahko tudi namenijo posebno pozornost, da so odprti za nove inovativne projekte in ideje, povezane z novimi viri velikih podatkov, ki prihajajo od statistikov, delujočih na številnih področjih statistike. Nazadnje, preprečevanje izgube osebja za druge organizacije v zaporedju njihovih veščin dela z velikimi podatki bo odvisno od dobre identifikacije osebja, ki je usposobljeno in željno delati s tovrstnimi podatki ter od zagotavljanja dobrih priložnosti za njihov poklicni razvoj.
6.2.5. Omilitve
Zmanjšanje tega tveganja bo izvedeno glede na tveganje pomanjkanja osebja z ustreznimi veščinami: 1) podizvajanje; in 2) sodelovanje.
7. Razprava
Iz te prve preučitve je očitno, da ni mogoče vzpostaviti enotne verjetnosti ali vpliva za to 'tveganje velikih podatkov' — na splošno sta oba kazalnika v veliki meri odvisna od vira velikih podatkov, kot tudi od 'uradne statistike, ki temelji na velikih podatkih'.
izdelek.
Tako prihajamo do zaključka, da je logičen naslednji korak v tej smeri sprejeti vrsto možnih pilotskih projektov (vsak od njih vključuje kombinacijo enega ali več BDS-jev in enega ali več BDOS-ov) kot izhodišče in - za vsak tak pilot - prizadevanje za oceno verjetnosti in vpliva vsakega tveganja.
S tem namenom smo na pragu začetka ankete zainteresiranih strani, poskušajo oceniti oceno OSC glede verjetnosti, vpliva (in morebitnih ukrepov za preprečevanje / omilitev posledic) v zvezi s številnimi možnimi pilotskimi projekti - ter zaprositi predloge OSC glede tveganj, ki jih nismo vključili v ta dokument.
8. REFERENCEUNECE (2014), „Predlagani okvir za kakovost velikih podatkov“, dokumenti skupine za kakovost velikih podatkov UNECE,
a%20Quality%20Framework%20-%20final-%20Jan08-2015.pdf?version=1&modificationDate=1420725063663&api=v2
UNECE (2014), „Kako velike so velike podatke? Rola velikih podatkov v uradni statistiki“,
Daas, P., S. Ossen, R. Vis-Visschers in J. Arends-Toth, (2009), Seznam za oceno kakovosti upravnih podatkovnih virov, Statistika Nizozemska, Haga/Heerlen
Dorfman, Mark S. (2007), Uvod v upravljanje tveganj (e izd.), Cambridge, VB, Woodhead-Faulkner, str. 18, ISBN 0-85941-332-22)
Eurostat (2014), „Postopek akreditacije za statistične podatke iz neuradnih virov“ v Analizi metodologij za uporabo interneta za zbiranje informacijskih družbenih in drugih statistik,
Reimsbach-Kounatze, C. (2015), „Rast „velikih podatkov“ in posledice za uradno statistiko in statistične agencije: Predhodna analiza“, OECD Digital Economy Papers, št. 245, OECD Publishing.
Reis, F., Ferreira, P., Perduca, V. (2014) „Uporaba dokazov spletne dejavnosti za povečanje ažurnosti kazalnikov uradne statistike“, prispevek predstavljen na konferenci IAOS 2014,
Tudi če ne omenja izrecno tveganj, ta dokument v resnici obravnava številna tveganja, povezana z uporabo podatkov spletne dejavnosti za uradno statistiko. Eurostat (2007), Priročnik o metodah in orodjih za oceno kakovosti podatkov,
Izvor: habr.com
