

Čeprav so danes podatki na voljo skoraj povsod, so analitične podatkovne baze še vedno precej eksotične. Slabo jih poznamo in še slabše znamo učinkovito uporabljati. Mnogi še naprej "jejo kaktus" z MySQL ali PostgreSQL, ki sta zasnovana za druge scenarije, se mučijo z NoSQL ali preplačujejo za komercialne rešitve. ClickHouse spreminja pravila igre in znatno znižuje vstopno oviro v svet analitičnih DBMS.
Poročilo s konferencije BackEnd Conf 2018 in je objavljeno s soglasjem govornika.
Kdo sem jaz in zakaj govorim o ClickHouse? Sem direktor za razvoj v podjetju LifeStreet, ki uporablja ClickHouse. Poleg tega sem ustanovitelj Altinity. To je partner Yandexa, ki promovira ClickHouse in pomaga Yandexu, da postane ClickHouse uspešnejši. Prav tako sem pripravljen deliti svoja znanja o ClickHouse.
In še nisem brat Pete Zajceva. Pogosto me o tem sprašujejo. Ne, nisva bratje.
"Vsem je znano", da je ClickHouse:
- Zelo hiter,
- Zelo pregleden,
- Uporablja se v Yandexu.
Malce manj znano je, v katerih podjetjih in kako se uporablja.
Povedal vam bom, za kaj, kje in kako se ClickHouse uporablja, poleg Yandexa.
Povedal bom, kako se konkretne naloge rešujejo s pomočjo ClickHouse v različnih podjetjih, katere funkcionalnosti ClickHouse lahko uporabite za svoje naloge in kako so se uporabljale v različnih podjetjih.
Izbral sem tri primere, ki prikazujejo ClickHouse z različnih strani. Mislim, da bo to zanimivo.
Prvo vprašanje: "Zakaj je potreben ClickHouse?". Zdi se, da je vprašanje precej očitno, vendar je odgovorov več kot en.
- Prvi odgovor – zaradi zmogljivosti. ClickHouse je zelo hiter. Analitika na ClickHouse je prav tako zelo hitra. Pogosto ga lahko uporabljate tam, kjer nekaj drugega deluje zelo počasi ali zelo slabo.
- Drugi odgovor – to je cena. In predvsem cena skaliranja. Na primer, Vertica je popolnoma odlična podatkovna baza. Zelo dobro deluje, če imate le malo terabajtov podatkov. Ampak, ko gre za stotine terabajtov ali petabajtov, cena licence in podpore postane precej velika cifra. In to je drago. ClickHouse pa je brezplačen.
- Tretji odgovor je operativni strošek. To je pristop, ki je nekoliko drugačen. RedShift je odlična alternativa. Na RedShiftu lahko hitro razvijete rešitev. Dobro bo delovalo, vendar boste vsak dan in vsak mesec plačevali precej visoke stroške Amazonu, ker je to precej drag storitev. Google BigQuery prav tako. Kdor ga je uporabljal, ve, da lahko sproži več poizvedb in nenadoma dobi račun v višini stotin dolarjev.
V ClickHouse teh težav ni.
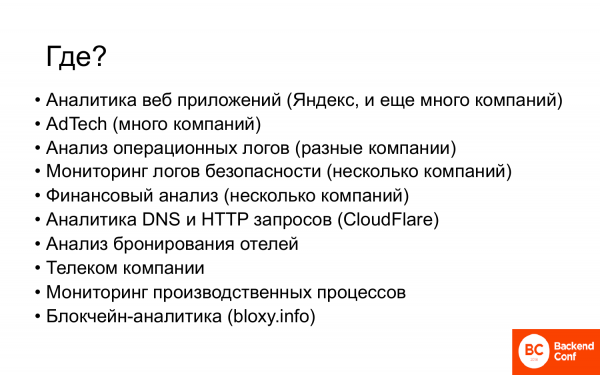
Kje se zdaj uporablja ClickHouse? Poleg Yandexa se ClickHouse uporablja v številnih različnih podjetjih.
- V prvi vrsti je to analitika spletnih aplikacij, tj. to je uporaba, ki izhaja iz Yandexa.
- Veliko AdTech podjetij uporablja ClickHouse.
- Številna podjetja, ki morajo analizirati operativne dnevnike iz različnih virov.
- Nekaj podjetij uporablja ClickHouse za spremljanje varnostnih dnevnikov. Ti jih naložijo v ClickHouse, pripravljajo poročila in dobijo želene rezultate.
- Podjetja začnejo uporabljati ClickHouse tudi v finančni analizi, tj. postopoma se veliki posli tudi približujejo ClickHouseu.
- CloudFlare. Kdor spremlja ClickHouse, je zagotovo slišal za to podjetje. To je en od pomembnih prispevnikov skupnosti. Imajo zelo resno namestitev ClickHouse. Na primer, razvili so Kafka engine za ClickHouse.
- Telekomunikacijska podjetja so začela uporabljati ClickHouse. Nekaj podjetij ga uporablja bodisi kot dokaz koncepta bodisi že v produkciji.
- Ena družba uporablja ClickHouse za spremljanje proizvodnih procesov. Testirajo čipe, beležijo kup parametrov, okoli 2.000 značilnosti. Nato analizirajo – dobra serija ali slaba.
- Analitika verige blokov. Obstaja rusko podjetje, kot je Bloxy.info. To je analiza ethereum omrežja. To so tudi naredili na ClickHouse.
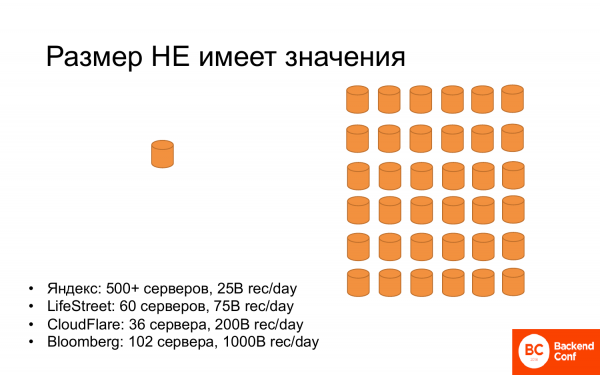
Pri tem velikost ni pomembna. Veliko podjetij uporablja en majhen strežnik. Ta jim omogoča reševanje njihovih težav. In še več podjetij uporablja velike klastre iz mnogih strežnikov ali desetih strežnikov.
In če pogledamo rekorde, to:
- Yandex: 500+ strežnikov, 25 milijard zapisov na dan tam shranijo.
- LifeStreet: 60 strežnikov, približno 75 milijard zapisov na dan. Manj strežnikov, več zapisov kot v Yandexu.
- CloudFlare: 36 strežnikov, 200 miljard zapisov na dan se shranjuje. Imajo še manj strežnikov in še več podatkov, ki jih shranjujejo.
- Bloomberg: 102 strežnika, približno trilijon zapisov na dan. Rekorder po zapisih.
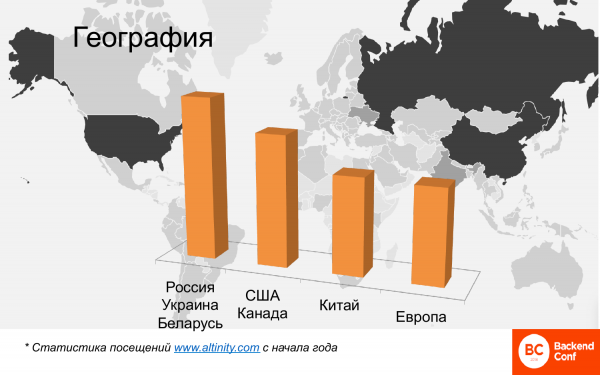
Geografsko – to je tudi veliko. Ta graf pokaže heatmap, kjer se ClickHouse uporablja po svetu. Tukaj izstopata Rusija, Kitajska in Amerika. Evropskih držav je malo. In lahko izpostavimo 4 klastre.
To je primerjalna analiza, tukaj ni potrebno iskati absolutnih številk. To je analiza obiskovalcev, ki berejo angleške vsebine na spletnem mestu Altinity, ker tam ni ruskih govorcev. Rusija, Ukrajina, Belorusija, torej rusko govoreči del skupnosti, so najbolj številčni uporabniki. Nato sledita ZDA in Kanada. Kitajska močno dohiteva. Še pred šestimi meseci skoraj da ni bilo Kitajske, zdaj pa je Kitajska že prehitela Evropo in še naprej raste. Stara Evropa prav tako ne zaostaja, pri čemer je vodilni uporabnik ClickHouse – kar je presenetljivo – Francija.
Zakaj to vse pripovedujem? Da pokažem, da ClickHouse postaja standardna rešitev za analizo velikih podatkov in da se že na mnogih mestih uporablja. Če ga uporabljate, ste na pravi poti. Če ga še niste uporabili, se ni treba bati, da boste ostali sami in da vam nihče ne bo pomagal, ker se že mnogi s tem ukvarjajo.
To so primeri dejanske uporabe ClickHouse v več podjetjih.
- Prvi primer – oglaševalska mreža: migracija z Vertice na ClickHouse. Poznam več podjetij, ki so prešla z Vertice ali so v procesu prehoda.
- Drugi primer – transakcijsko shranjevanje na ClickHouse. To je primer, zgrajen na antipatternih. Vse, kar ne bi smeli početi v ClickHouse po nasvetih razvijalcev, je tukaj narejeno. In to je tako učinkovito, da deluje. In deluje veliko bolje kot tipična transakcijska rešitev.
- Tretji primer – to so distribuirane izračuni na ClickHouse. Bilo je vprašanje o tem, kako lahko ClickHouse integriramo v Hadoop ekosistem. Pokažem primer, kako je podjetje na ClickHouse naredilo nekaj podobnega kontenerju map reduce, pri čemer so upoštevali lokalizacijo podatkov itd., da bi izračunali zelo trivialno nalogo.
- LifeStreet – to je Ad Tech podjetje, ki ima vse tehnologije, povezane z oglaševalsko mrežo.
- Ukvarjajo se z optimizacijo oglasov, programatično ponudbo.
- Veliko podatkov: okoli 10 milijard dogodkov na dan. Pri tem se lahko dogodki delijo na več poddogodkov.
- Veliko strank uporablja te podatke, pri čemer to niso le ljudje, ampak mnogo več – različni algoritmi, ki se ukvarjajo s programatskim biddingom.
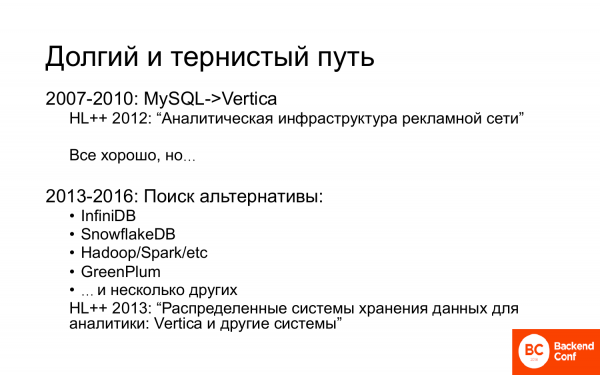
Podjetje je prešlo dolgo in mukotrpno pot. O tem sem govoril na HighLoad. Najprej je LifeStreet prešla z MySQL (s kratkim postankom na Oracle) na Vertico. O tem lahko najdete zgodbo.
Vse je potekalo zelo dobro, a je kmalu postalo jasno, da se podatki povečujejo in da je Vertica draga. Opravili smo iskanje različnih alternativ. Nekatere so tukaj naštevene. Pravzaprav smo naredili dokaz koncepta ali včasih testiranje zmogljivosti skoraj vseh baz podatkov, ki so bile na voljo na trgu od 13. do 16. leta in so približno ustrezale funkcionalnosti. O nekaterih sem tudi govoril na HighLoad.
Naloga je bila – migrirati z Vertice, ker so se podatki povečali. Ti so rasti eksponentno več let. Potem so za trenutek ustavili, a kljub temu. Ob predvidevanju te rasti so poslovne zahteve glede obsega podatkov, po katerih je treba izvajati analitiko, jasno kazale, da se bo hitro začelo pogovarjati o petabajtih. Plačevanje za petabajte je zelo drago, zato so iskali alternativo, kam iti.
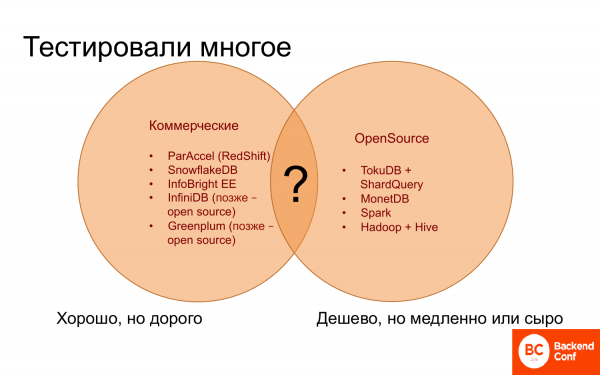
Kam iti? Določeno obdobje je bilo popolnoma nejasno, kam iti, saj so na eni strani komercialne baze podatkov, ki delujejo dokaj dobro. Nekatere delujejo skoraj tako dobro, kot Vertica, nekatere slabše. A vse so drage, nič cenejšega in boljšega ni bilo mogoče najti.
Na drugi strani pa obstajajo rešitve z odprtokodnim sistemom, ki jih ni veliko, kar pomeni, da jih lahko preštejemo na prste. So brezplačne ali poceni, vendar delujejo počasneje. Po navadi jim primanjkuje potrebne in uporabne funkcionalnosti.
Torej, da bi združili to dobro, kar imajo komercialne baze podatkov, in vse tisto brezplačno, kar obstaja v odprtokodu – ni bilo ničesar.
Ničesar ni bilo, dokler Yandex ni nepričakovano predstavil ClickHouse, kot bi čarovnik potegnil zajca iz klobuka. In to je bila nepričakovana rešitev, še vedno se sprašujejo: 'Zakaj?', a kljub temu.
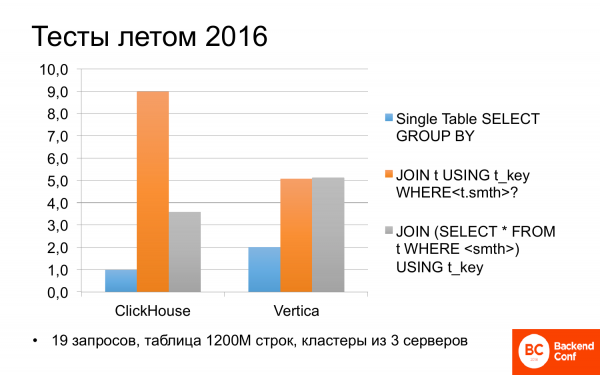
In the summer of 2016, we started investigating what ClickHouse is. It turned out that sometimes it can be faster than Vertica. We tested different scenarios on various queries. And if a query used only one table, i.e., without any joins, ClickHouse was twice as fast as Vertica.
I took the time to look at Yandex's tests a few days ago. They found the same: ClickHouse is twice as fast as Vertica, which is why they often mention it.
However, if the queries involve joins, things become less straightforward. ClickHouse can be twice as slow as Vertica. But with a bit of adjustment and rewriting of the query, the performance becomes roughly equivalent. Not bad, and it's free.
After obtaining the test results and examining them from different perspectives, LifeStreet decided to adopt ClickHouse.
This is 2016, just to remind you. It was like the joke about the mice who cried and pierced themselves but continued to eat the cactus. It was explained in detail, there is a video about it, etc.
Therefore, I will not discuss this in detail; I will only share the results and a few interesting things I did not mention back then.
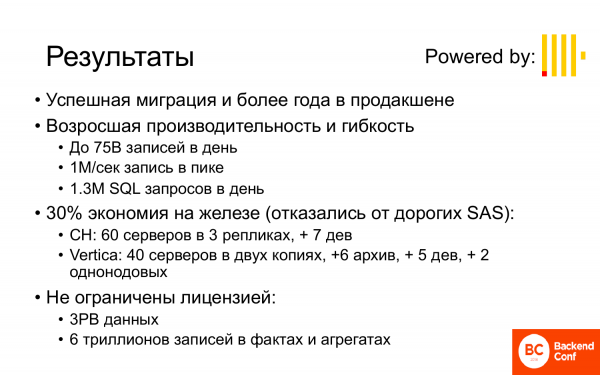
The results are:
- A successful migration, and the system has been operating in production for over a year now.
- Performance and flexibility have increased. Out of the 10 billion records we could afford to store per day, and for a limited time at that, LifeStreet now stores 75 billion records daily and can maintain this for three months or more. At peak times, this amounts to nearly a million events per second being saved. More than a million SQL queries per day are sent to this system, primarily from various bots.
- Despite ClickHouse utilizing more servers than Vertica, cost savings on hardware were achieved because Vertica relied on relatively expensive SAS drives, whereas ClickHouse used SATA. Why? Because in Vertica, inserts are synchronous. Synchronization requires that the drives don't lag too much and that the network doesn't lag too, which is a relatively costly operation. In ClickHouse, inserts are asynchronous. Moreover, you can always write everything locally without any additional costs, allowing data to be inserted into ClickHouse much faster than in Vertica, even on not the fastest drives. Reading speeds are approximately the same. Reading on SATA, especially when configured in RAID, is quite fast.
- Licenca nije ograničena, tj. 3 petabajta podataka na 60 servera (20 servera je jedna replika) i 6 triliona zapisa u činjenicama i agregatima. Ništa slično nije mogla priuštiti Vertica.
Sada prelazim na praktične stvari u ovom primeru.
- Prvo – to je efikasna shema. Od sheme zavisi veoma mnogo.
- Drugo – to je generisanje efikasnog SQL-a.
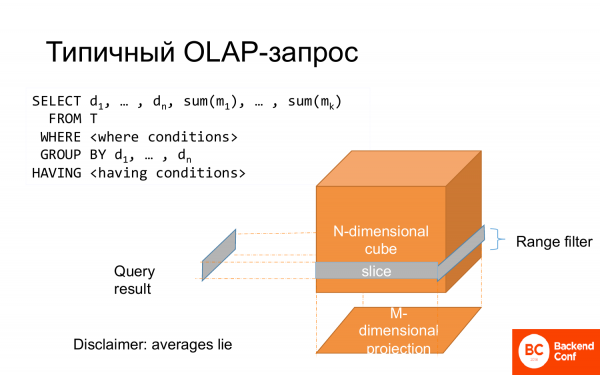
Tipičan OLAP upit je select. Deo kolona ide u group by, deo kolona ide u agregatne funkcije. Tu je i where, što možemo predstaviti kao presečan kocku. Ceo group by možemo predstaviti kao projekciju. I zato se ovo naziva multidimenzionalna analiza podataka.
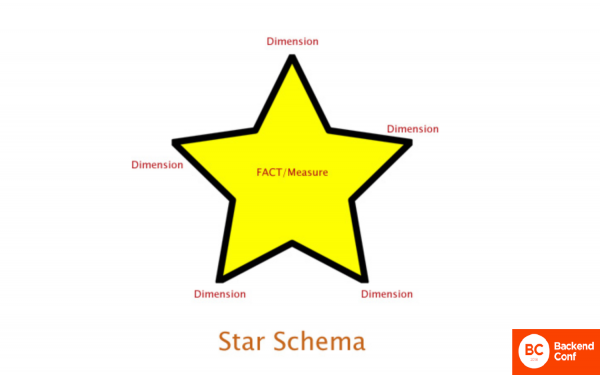
Često se to modeluje u obliku star sheme, kada postoji centralna činjenica i karakteristike te činjenice sa strana, oko zrakova.
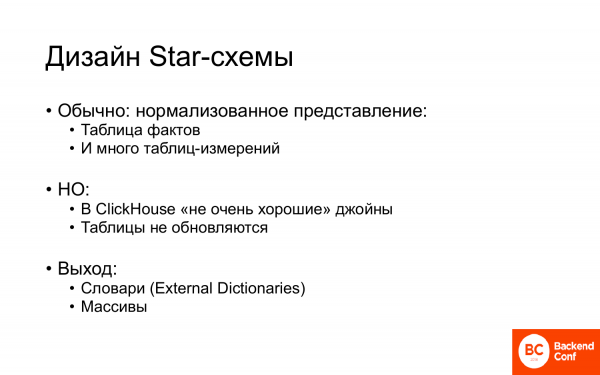
I s fizičkog dizajna, onoga kako se to postavlja u tabelu, obično se pravi normalizovana reprezentacija. Možete denormalizovati, ali to je skupo po disku i nije efikasno po upitima. Zato se obično pravi normalizovana reprezentacija, tj. tabela činjenica i mnogo, mnogo tabeli dimenzija.
Ali u ClickHouse-u to slabo funkcioniše. Ima dva razloga:
- Prvi – to je zato što u ClickHouse-u nemamo dobre join-ove, tj. join-ovi postoje, ali su loši. Za sada loši.
- Drugi – to je što se tabele ne ažuriraju. Obično u ovim tabelama, koje su oko star sheme, treba nešto menjati. Na primer, naziv klijenta, naziv kompanije itd. I to ne funkcioniše.
Postoji rešenje za ovo u ClickHouse-u. Čak dva:
- Prvi – to je korišćenje rečnika. External Dictionaries je ono što pomaže da se 99 % reši problem sa star shemom, sa ažuriranjima i sličnim.
- Drugi – to je korišćenje nizova. Nizovi takođe pomažu da se reše problemi sa join-ovima i normalizacijom.
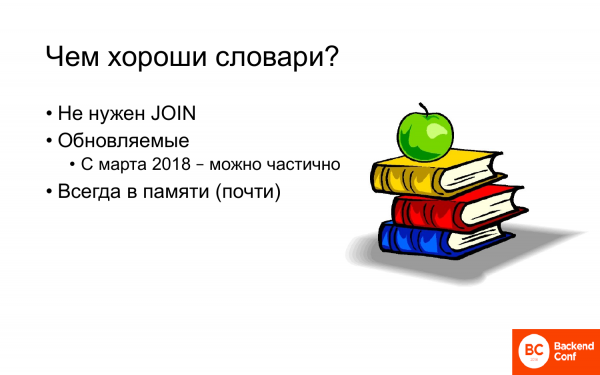
- Join-ovi nisu potrebni.
- Ažuriraju se. Od marta 2018. godine postoji nedokumentovana mogućnost (to nećete naći u dokumentaciji) da se delimično ažuriraju rečnici, tj. oni zapisi koji su se promenili. Praktično – to je kao tabela.
- Uvek u memoriji, tako da join-ovi sa rečnikom rade brže nego ako bi to bila tabela koja leži na disku i još nije sigurno da li je u kešu, verovatno nije.
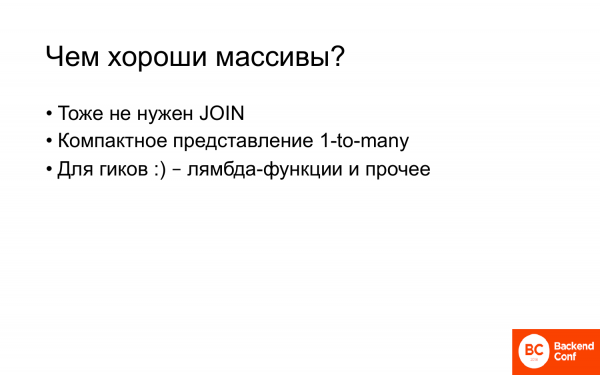
- Takođe nisu potrebni join-ovi.
- To je kompaktno predstavljanje 1 prema mnogima.
- I po mom mišljenju, nizovi su napravljeni za geekove. To su lambda funkcije i slično.
To ni je zgolj marketinška poteza. To je zelo močna funkcionalnost, ki omogoča enostavno in elegantno izvajanje številnih nalog.
Tipični primeri, ki pomagajo reševati nize. Ti primeri so preprosti in dovolj nazorni:
- Iskanje po oznakah. Če imate tam hashtag-e in želite najti določene objave po hashtag-u.
- Iskanje po parih ključ-vrednost. Tudi tu so nekateri atributi z vrednostjo.
- Shranjevanje seznamov ključev, ki jih morate prevesti v nekaj drugega.
Vse te naloge lahko rešite brez nizov. Oznake lahko spravite v en niz in jih izberete s pomočjo rednih izrazov ali v ločeno tabelo, toda v tem primeru boste morali delati združitve (join).
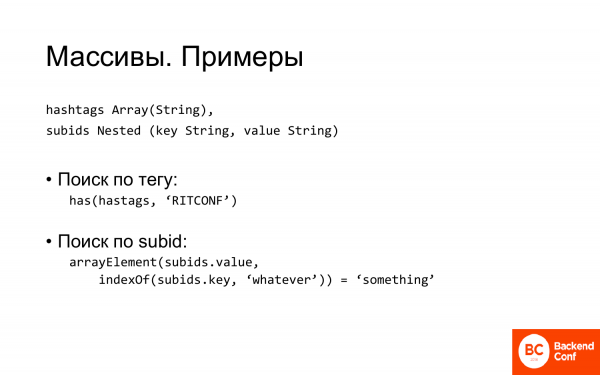
V ClickHouse pa ni potrebno ničesar narediti, dovolj je opisati niz string za hashtag-e ali ustvariti vdelano strukturo za sisteme tipa ključ-vrednost.
Vdelana struktura – morda ni najbolj primeren naziv. To sta dva niza, ki imata skupni del v imenu in nekatere povezane značilnosti.
Iskanje po oznaki je zelo enostavno. Obstaja funkcija has, ki preverja, ali je element prisoten v nizu. To je to, našli smo vse zapise, ki se nanašajo na našo konferenco.
Iskanje po subid je nekoliko bolj zapleteno. Najprej moramo najti indeks ključa, nato pa vzeti element z tem indeksom in preveriti, ali je njegova vrednost tista, ki jo potrebujemo. Vseeno pa je zelo preprosto in kompaktno.
Redni izraz, ki bi ga želeli napisati, če bi vse to shranili v en niz, bi bil, najprej, neroden. In drugič, delal bi veliko dlje kot dva niza.
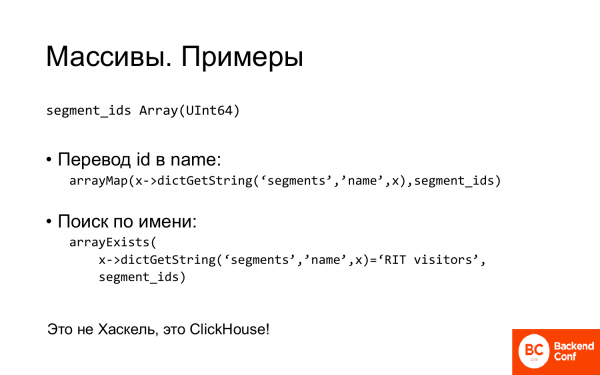
Drug primer. Imate niz, v katerem shranjujete ID-je. In lahko jih prevedete v imena. Funkcija arrayMap. To je tipična lambda funkcija. Tja posredujete lambda izraz. In ta izsleduje vrednost imena vsakemu ID-ju iz slovarja.
Podobno lahko izvedete iskanje. Predaja se funkcija predikata, ki preverja, kateri elementi ustrezajo določenim kriterijem.
Te stvari močno poenostavijo shemo in rešujejo številne težave.
Naslednja težava, s katero smo se soočili in o kateri bi želel spregovoriti, so učinkoviti poizvedbe.
- V ClickHouse ni načrtovalnika poizvedb. Sploh ne.
- Vseeno pa je potrebno kompleksne poizvedbe načrtovati. V katerih primerih?
- Če v poizvedbi obstaja več povezav (join), ki jih zavijate v podpoizvedbe. In vrstni red, v katerem se izvajajo, ima pomen.
- In drugo - če je poizvedba razdeljena. Ker v razdeljeni poizvedbi se le najgloblja podpoizvedba izvaja razdeljeno, vse ostalo pa se prenese na en strežnik, s katerim ste povezani in se tam izvaja. Zato, če imate razdeljene poizvedbe z mnogimi povezavami (join), morate izbrati vrstni red.
In celo v preprostejših primerih je včasih smiselno opraviti delo načrtovalnika in poizvedbe malo prepisati.
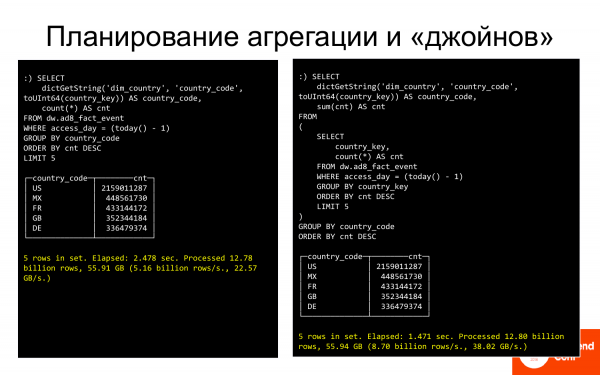
Tukaj je primer. Na levi strani je poizvedba, ki prikazuje top-5 držav. In traja 2,5 sekunde, po mojem mnenju. Na desni strani pa je ista poizvedba, a malo prepisana. Namesto da bi grupirali po vrsti, smo začeli grupirati po ključu (int). In to je hitreje. Potem smo k rezultatu priključili slovar. Namesto 2,5 sekunde poizvedba traja 1,5 sekunde. To je dobro.
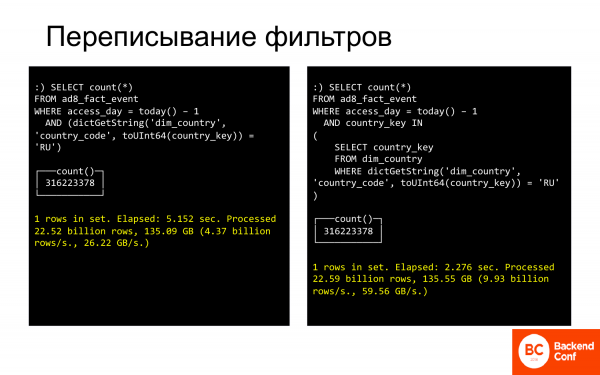
Podoben primer s prepisovanjem filtrov. Tukaj je poizvedba za Rusijo. Traja 5 sekund. Če jo prepišemo tako, da primerjamo ponovno ne vrsto, ampak številke s nekim nizom tistih ključev, ki se nanašajo na Rusijo, bo to veliko hitreje.
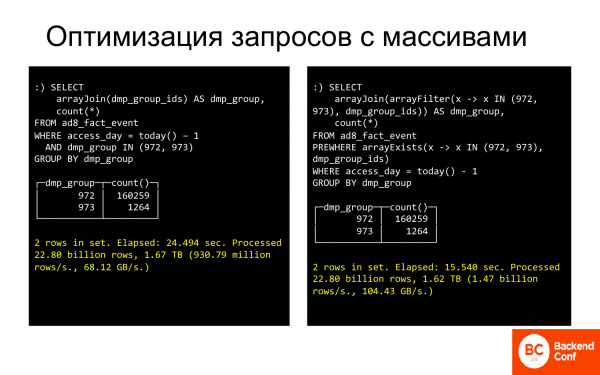
Obstaja veliko takih trikov. In ti omogočajo znatno pospešitev poizvedb, za katere se zdi, da že delujejo hitro, ali nasprotno, delujejo počasi. Lahko jih naredimo še hitreje.
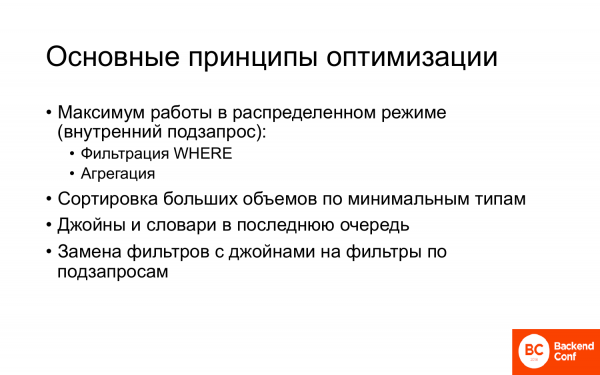
- Največ dela v razdeljenem načinu.
- Sortiranje po minimalnih tipih, kot sem to počel s int-ji.
- Če obstajajo kakšne povezave (join), slovarji, je najbolje, da jih naredite na samem koncu, ko so vaši podatki vsaj delno grupirani, takrat bo operacija povezav (join) ali klic slovarja manjkrat poklicana in to bo hitrejše.
- Zamenjava filtrov.
Obstajajo še druge tehnike, ne le tiste, ki sem jih prikazal. In vse te včasih omogočajo znatno pospešitev izvajanja poizvedb.
Preidimo na naslednji primer. Podjetje X iz ZDA. Kaj počne?
Naloga je bila:
- Offline povezovanje reklamnih transakcij.
- Modeliranje različnih modelov povezovanja.
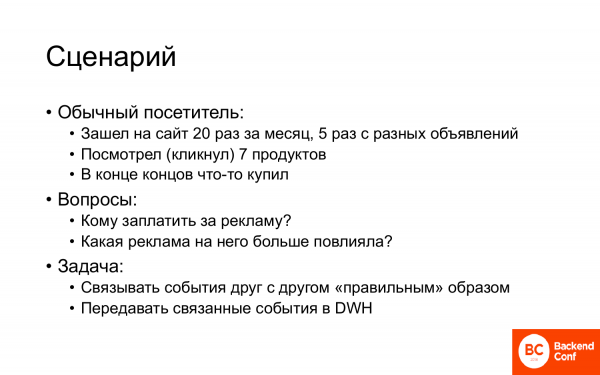
V čem je scenarij?
Običan posjetitelj posjeti stranicu, na primjer, 20 puta mjesečno s različitih oglasa ili jednostavno s vremena na vrijeme dođe bez ikakvih oglasa, jer se sjeća te stranice. Pregleda neke proizvode, stavlja ih u košaricu, vadi ih iz košarice. I, na kraju, nešto kupuje.
Razumna pitanja: "Kome treba platiti za oglas, ako je potrebno?" i "Koji oglas je na njega utjecao, ako je utjecao?". To jest, zašto je kupio i kako učiniti tako da ljudi slični ovoj osobi također kupuju?
Kako bi se ovaj zadatak riješio, potrebno je pravilno povezati događaje koji se događaju na web stranici, to jest izgraditi neku vrstu veze među njima. Zatim ih proslijediti na analizu u DWH. Na temelju te analize, izgraditi modele, kome i koji oglas prikazati.
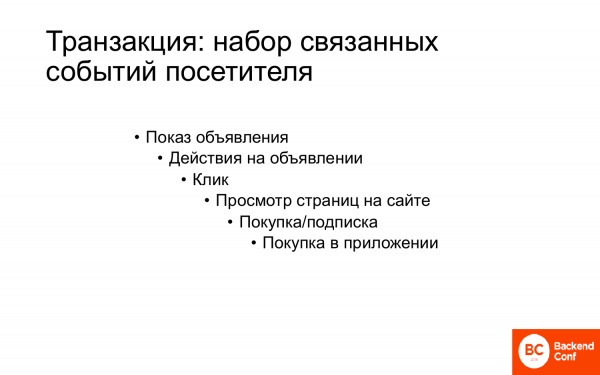
Reklamna transakcija je skup povezanih događaja korisnika, koji počinju od prikazivanja oglasa, zatim nešto se događa, možda kupnja, a zatim mogu biti dodatne kupnje. Na primjer, ako je ovo mobilna aplikacija ili mobilna igra, obično se instalacija aplikacije događa besplatno, a ako se u aplikaciji nešto dalje radi, za to mogu biti potrebna sredstva. I što više osoba potroši u aplikaciji, to je ona vrijednija. No, za to je potrebno sve povezati.
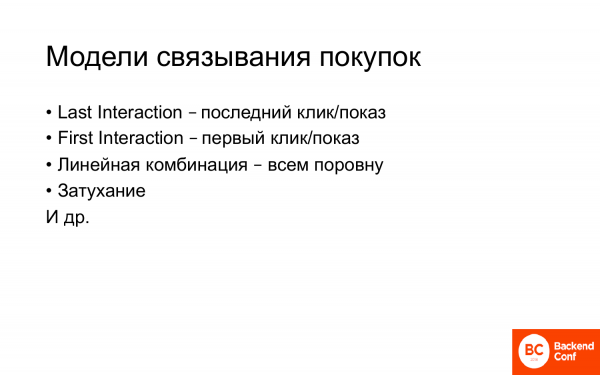
Postoji mnogo modela povezivanja.
Najpopularniji su:
- Last Interaction, gdje je interaction – ili klik ili prikaz.
- First Interaction, tj. prvo što je dovelo osobu na stranicu.
- Linearna kombinacija – svima jednako.
- Istjecanje.
- I drugo.
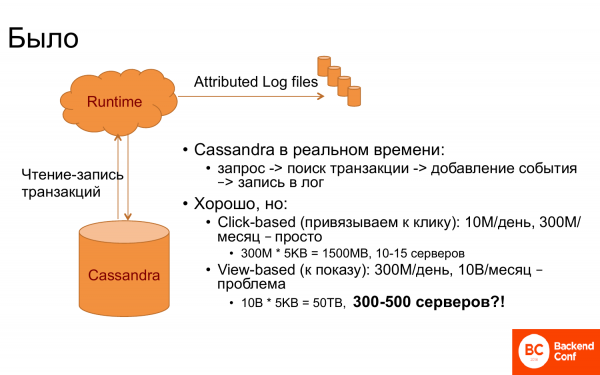
I kako je sve to izvorno radilo? Postojao je Runtime i Cassandra. Cassandra se koristila kao transaction storage, tj. u njoj su bile pohranjene sve povezane transakcije. I kada dođe neki događaj u Runtime, na primjer, prikaz neke stranice ili nešto drugo, radila se upit u Cassandru – postoji li takva osoba ili ne. Onda su se dobijale transakcije koje se odnose na njega. I vršeno je povezivanje.
I ako je bilo sreće da u upitu postoji transaction id, to je lako. No obično nije sreće. Stoga je bilo potrebno pronaći posljednju transakciju ili transakciju s posljednjim klikom itd.
In the beginning, everything worked very well as long as the linking was to the last click. With about 10 million clicks a day, which amounts to 300 million a month if a monthly window is set. And since in Cassandra it all has to be in memory to work quickly—because Runtime needs to respond swiftly—this required around 10-15 servers.
However, when they wanted to link transactions to shows, it didn't go as smoothly. Why? Clearly, it requires storing 30 times more events. Consequently, 30 times more servers are needed. It reached an astronomical figure, needing up to 500 servers to handle the linking while having significantly fewer in Runtime—that just doesn't add up. They started brainstorming solutions.
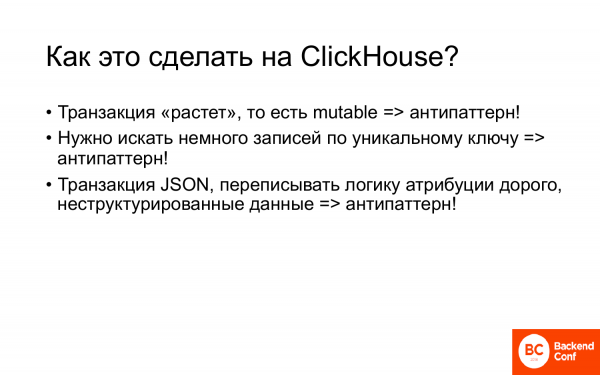
They landed on ClickHouse. But how do you implement it with ClickHouse? At first glance, it seems like a collection of anti-patterns.
- The transaction grows as we attach more and more new events to it, making it mutable, while ClickHouse doesn't handle mutable objects very well.
- When a visitor arrives, we need to retrieve their transactions by key, specifically by their visit id. This is also a point query, which isn't typically how ClickHouse operates. Generally, ClickHouse deals with large scans, but here we need to fetch a few records. Another anti-pattern.
- Additionally, transactions were in JSON format, but rewriting was not preferred, so they wanted to store JSON in an unstructured way and extract what was needed. This too is an anti-pattern.
That is to say, a collection of anti-patterns.
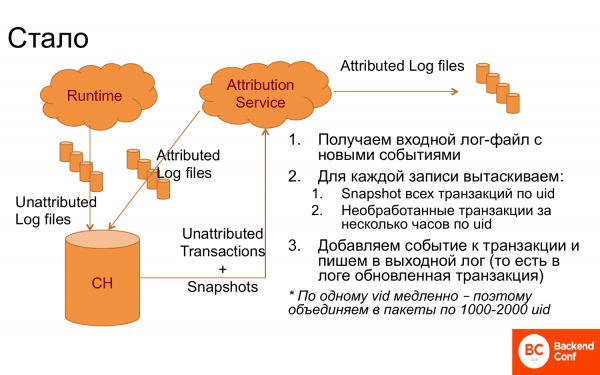
Nevertheless, they succeeded in creating a system that worked quite well.
What was done? ClickHouse was implemented, with logs being ingested in records. An attributed service was created to retrieve logs from ClickHouse. Then, for each record by visit id, it fetched transactions that might not have been fully processed yet, along with snapshots—i.e., already linked transactions, representing the results of previous work. From these, they built the logic, selected the correct transaction, and connected new events. The updated logs were written back into ClickHouse, establishing a constantly cyclical system. Additionally, the data was sent to DWH for further analysis.
V této podobě to nefungovalo moc dobře. A aby to ClickHouse usnadnil, když probíhal dotaz podle visit id, skupinovali jsme tyto dotazy do bloků po 1 000-2 000 visit id a vytahovali jsme veškeré transakce pro 1 000-2 000 lidí. A pak to všechno začalo fungovat.
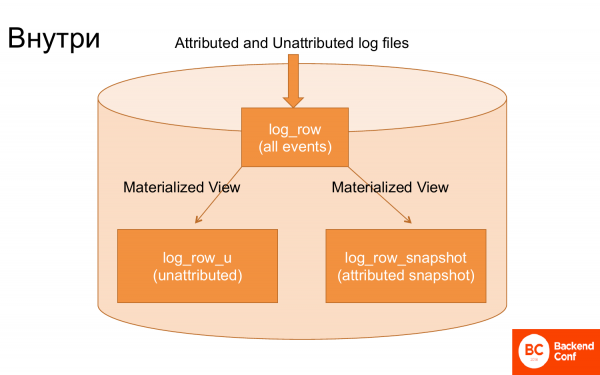
Pokud se podíváte do ClickHouse, existují pouze 3 hlavní tabulky, které to vše obsluhují.
První tabulka, do které se ukládají logy, přičemž logy se ukládají prakticky bez zpracování.
Druhá tabulka. Přes materializovaný pohled se z těchto logů vybíraly, které ještě nebyly přiřazené události, tj. nesouvisející. A přes materializovaný pohled se z těchto logů vytahovaly transakce pro vytvoření snapshotu. Tj. speciální materializovaný pohled vytvářel snapshot, a to konkrétně poslední nahromaděný stav transakce.
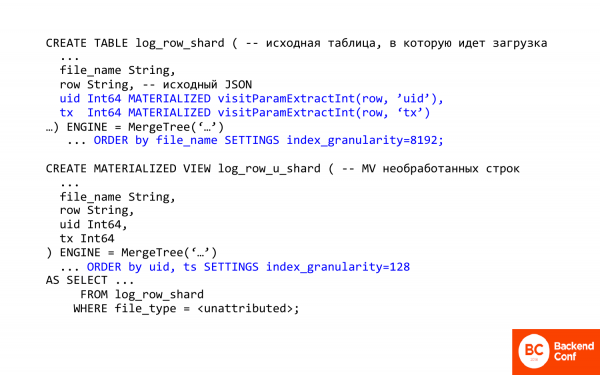
Zde je napsán text na SQL. Chtěl bych v něm okomentovat několik důležitých věcí.
První důležitá věc – to je možnost v ClickHouse vybírat sloupce z json. Tj. v ClickHouse existují některé metody pro práci s json. Jsou velmi, velmi primitivní.
visitParamExtractInt umožňuje vybírat atributy z json, tj. první zásah se spustí. A tímto způsobem je možné vytáhnout transaction id nebo visit id. To je první věc.
Druhá – zde je použito chytré materializované pole. Co to znamená? To znamená, že nemůžete vložit do tabulky, tj. nevkládá se, ale vypočítává se a uchovává při vložení. Při vložení ClickHouse udělá práci za vás. A již se vybírá z json to, co pak potřebujete.
V tomto případě je materializovaný pohled určen pro zpracované řádky. A právě se používá první tabulka s prakticky syrovými logy. A co dělá? Za prvé, mění třídění, tj. třídění nyní probíhá podle visit id, protože potřebujeme rychle vybírat konkrétní transakci konkrétní osoby.
Druhá důležitá věc – to je index_granularity. Pokud jste viděli MergeTree, obvykle je jako výchozí hodnota 8 192 nastavena index_granularity. Co to je? To je parametr řídkosti indexu. V ClickHouse je index řídký, nikdy neindexuje každý záznam. Dělá to po každých 8 192. A to je dobré, když je potřeba spočítat velké množství dat, ale špatné, když jen několik, protože je velký overhead. A pokud snížíte index granularity, snižujete overhead. Snížit na jedničku nelze, protože by mohlo být nedostatek paměti. Index je vždy uchováván v paměti.
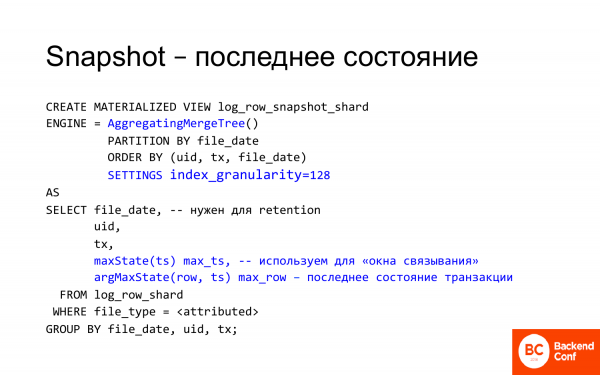
Snapshot uporablja še nekatere zanimive funkcionalnosti ClickHouse.
Najprej, to je AggregatingMergeTree. In v AggregatingMergeTree se hrani argMax, tj. stanje transakcije, ki ustreza zadnjemu timestampu. Transakcije se ves čas ustvarjajo nove za tega obiskovalca. In v najnovejšem stanju te transakcije smo dodali dogodek in dobili novo stanje. To je ponovno prišlo v ClickHouse. In preko argMax v tem materializiranem pogledu vedno lahko pridobimo aktualno stanje.
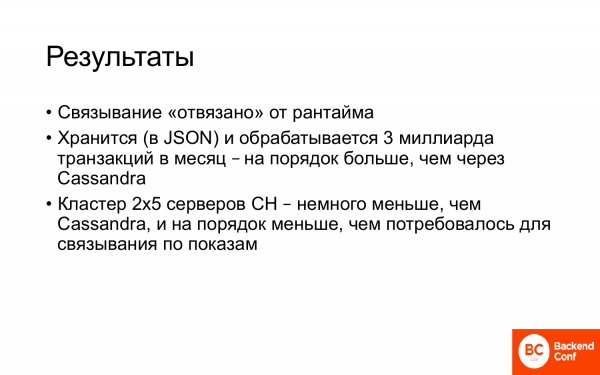
- Povezava je 'odstranjena' z Runtime.
- Shranjuje in obdeluje do 3 milijarde transakcij na mesec. To je za red velikosti več, kot je bilo v Cassandri, tj. v tipični transakcijski sistem.
- Klaster z 2x5 strežniki ClickHouse. 5 strežnikov in vsak strežnik ima repliko. To je celo manj, kot je bilo v Cassandri za izvajanje click based atribucije, tukaj pa imamo impression based. Tj. namesto, da bi povečali število strežnikov 30-krat, smo jih uspeli zmanjšati.
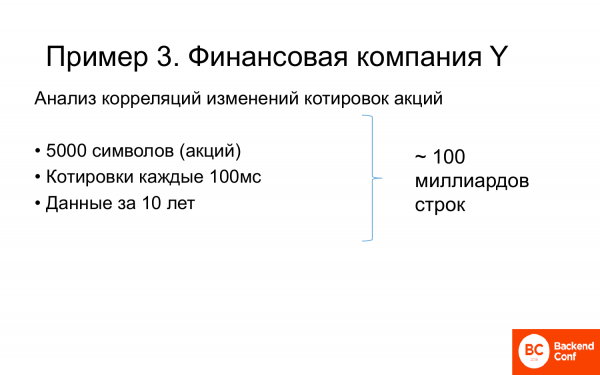
In zadnji primer je finančna podjetje Y, ki je analiziralo korelacije sprememb tečajev delnic.
In naloga je bila taka:
- Obstaja približno 5.000 delnic.
- Tečaji so znani vsakih 100 milisekund.
- Podatki so se nabrali v 10-letih. Očitno, pri nekaterih podjetjih več, pri nekaterih manj.
- Skupaj približno 100 milijard vrstic.
In bilo je treba izračunati korelacijo sprememb.
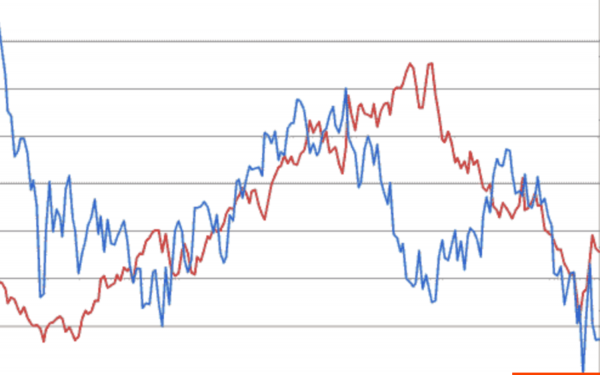
Tukaj sta dve delnici in njuni tečaji. Če ena raste, in druga raste, potem je to pozitivna korelacija, tj. ena narašča, druga tudi. Če ena raste, kot na koncu grafa, druga pa pada, potem je to negativna korelacija, tj. ko ena raste, druga pada.
Z analiziranjem teh medsebojnih sprememb lahko naredimo napovedi na finančnem trgu.
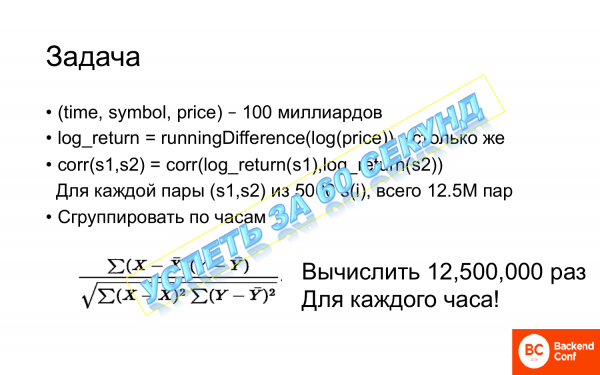
Ampak naloga je zahtevna. Kaj se za to dela? Imamo 100 milijard zapisov, v katerih so: čas, delnica in cena. Najprej moramo izračunati 100 milijard krat runningDifference algoritma cene. RunningDifference je funkcija v ClickHouse, ki zaporedno izračuna razliko med dvema vrsticama.
Nato je treba izračunati korelacijo, pri čemer je korelacijo treba izračunati za vsak par. Za 5.000 delnic to pomeni 12,5 milijona parov. In to je veliko, tj. 12,5 krat je treba izračunati to funkcijo korelacije.
In case someone has forgotten, ͞x and ͞y are the mathematical expectations based on the sample. That means you have to not only calculate the roots and sums, but also perform additional summations within those sums. A lot of calculations need to be executed 12.5 million times, and they need to be grouped by hours as well. And we have quite a few hours. And we have to do it all within 60 seconds. Just kidding.
We had to manage somehow because everything was running very, very slowly before ClickHouse arrived.
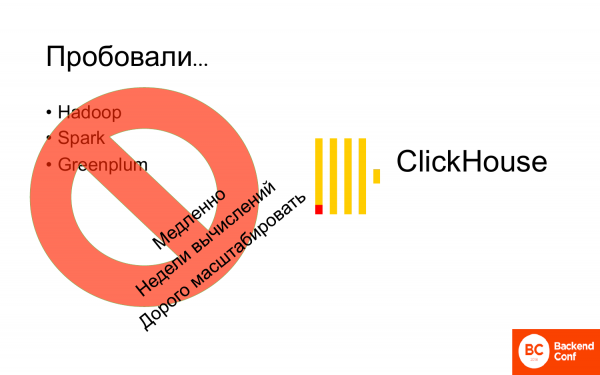
They tried to calculate this on Hadoop, on Spark, on Greenplum. And it was all very slow or expensive. That is, it was possible to get a calculation, but it was costly.
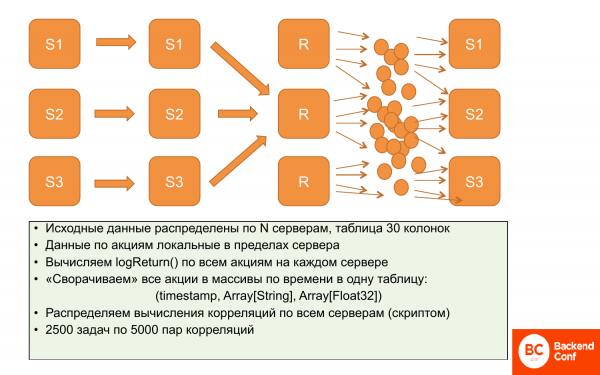
Then ClickHouse came along, and everything got much better.
I remind you, we have a problem with data locality, so the correlations cannot be localized. We cannot put part of the data on one server and part on another to make calculations; all data must be available everywhere.
What did they do? Initially, the data was localized. Each server stores data for the pricing of a specific set of stocks. And they do not overlap. Therefore, logReturns can be calculated in parallel and independently; all this happens while being both parallel and distributed.
Then they decided to reduce this data while retaining its expressiveness. They reduced it using arrays; that is, for each time interval, they created an array of stocks and an array of prices. This way, it takes up much less space, making the data easier to work with. These are almost parallel operations, meaning we simultaneously perform partial calculations and then write to the server.
After that, it can be replicated. The letter 'r' indicates that these data have been replicated. That is, we have the same data on all three servers – these arrays.
Then, with a special script, we can create batches from this set of 12.5 million correlations that need to be calculated. That is, 2,500 tasks with 5,000 pairs of correlations. And this task is computed on a specific ClickHouse server. It has all the data because it's the same on all servers, allowing it to compute sequentially.
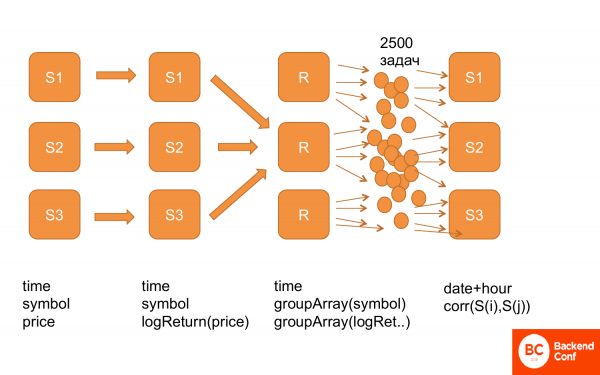
Poglejmo, kako to izgleda. Na začetku imamo vse podatke v tej strukturi: čas, delnice, cena. Potem smo izračunali logReturn, to je podatke iste strukture, le da namesto cene imamo logReturn. Potem smo jih predelali, torej imamo čas in groupArray po delnicah in cenah. Sreplirali smo jih. In po tem smo ustvarili vrsto opravil in nahranili ClickHouse, da jih je obdelal. In to deluje.
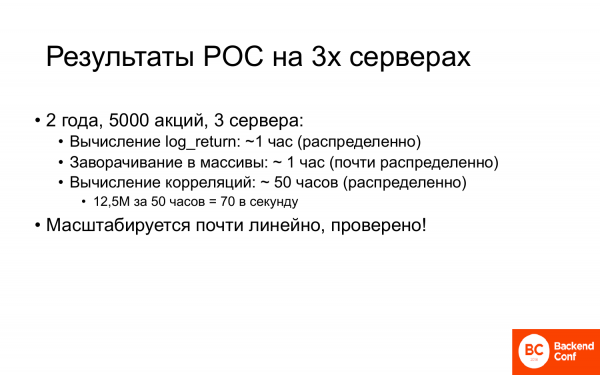
Na proof of concept naloga – to je bila podnaloga, torej smo vzeli manj podatkov. In to na treh strežnikih.
Ti prvi dve fazi: izračun log_return in ovijanje v tabele sta trajali približno eno uro.
Izračun korelacije pa je trajal približno 50 ur. Ampak 50 ur je malo, ker je prej to delovalo tedne. To je bil velik uspeh. In če izračunamo, je bilo vse obdelano 70-krat na sekundo na tem klastru.
Ampak najpomembnejša stvar je, da je ta sistem praktično brez ozkih grl, torej se praktično linearno skalira. In to so preverili. Uspešno so ga razširili.
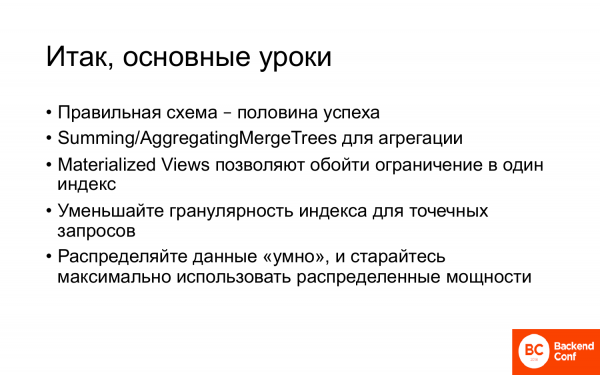
- Pravilna shema je polovica uspeha. In pravilna shema je uporaba vseh potrebnih tehnologij ClickHouse.
- Summing/AggregatingMergeTrees so tehnologije, ki omogočajo agregacijo ali izračun snapshot state kot posebno vrsto. In to bistveno poenostavi mnoge stvari.
- Materialized Views omogočajo zaobiti omejitev enega indeksa. Morda tega nisem razložil zelo jasno, a ko smo nalagali dnevnike, so bili surovi dnevniki v tabeli z enim indeksom, medtem ko so bili dnevniki atributov v drugi tabeli, torej iste podatke, le filtrirane, vendar je bil indeks popolnoma drugačen. Na videz so to isti podatki, vendar z drugačno sortiranjem. In Materialized Views omogočajo, da se, če potrebujete, izognete taki omejitvi ClickHouse.
- Zmanjšajte granularnost indeksa za točne poizvedbe.
- In pametno razporedite podatke, poskušajte čim bolj lokalizirati podatke znotraj strežnika. In poskušajte, da tudi poizvedbe uporabljajo lokalizacijo tam, kjer je to mogoče.
In summary, we can say that ClickHouse has firmly established itself in both commercial databases and open-source databases, specifically for analytics. It fits wonderfully into this landscape. Moreover, it is gradually starting to displace others because when you have ClickHouse, you don't need InfiniDB. Vertica may soon become unnecessary if they provide proper SQL support. Enjoy using it!
—Thank you for the presentation! Very interesting! Were there any comparisons with Apache Phoenix?
-No, I haven't heard anyone make comparisons. Both we and Yandex try to keep track of all comparisons of ClickHouse with different databases. Because if something turns out to be faster than ClickHouse, then Alexey Milovidov can't sleep at night and quickly starts to accelerate it. I haven't heard of such a comparison.
(Alexey Milovidov) Apache Phoenix is an SQL engine on HBase. HBase is mainly designed for key-value type work scenarios. Each row can have an arbitrary number of columns with arbitrary names. This can be said about systems like HBase and Cassandra. Heavy analytical queries won't work well on them. Or you might think they work fine if you haven't had any experience with ClickHouse.
Hvala
Good afternoon! I've been quite interested in this topic because I have an analytical subsystem. But when I look at ClickHouse, I get the feeling that ClickHouse is very well suited for event analysis, mutable data. And if I need to analyze a lot of business data with a bunch of large tables, then ClickHouse, as I understand it, isn't very suitable for me? Especially if they change. Is this correct, or are there examples that could refute this?
To je pravilno. In to je res za večino specializiranih analitičnih podatkovnih baz. Te so zasnovane tako, da obravnavajo eno ali več velikih tabel, ki so spremenljive, in veliko manjših, ki se počasneje spreminjajo. To pomeni, da ClickHouse ni kot Oracle, kjer lahko shranite vse in gradite zelo kompleksne poizvedbe. Da bi ClickHouse učinkovito uporabljali, je treba zasnovati shemo na način, ki dobro deluje v ClickHouse. To pomeni, da se je treba izogniti pretirani normalizaciji, uporabljati slovarje in se truditi ustvariti manj dolgih povezav. In če je shema tako zasnovana, lahko podobne poslovne naloge na ClickHouse rešujemo veliko bolj učinkovito kot v tradicionalni relacijski podatkovni bazi.
Hvala za predstavitev! Imam vprašanje glede zadnjega finančnega primera. Imeli so analitiko. Treba je bilo primerjati, kako se stvari gibljejo gor in dol. In mislim, da ste sistem zgradili prav za to analitiko? Če bi jutri potrebovali kakšen drug poročilo glede teh podatkov, ali bi bilo potrebno ponovno zgraditi shemo in naložiti podatke? Torej, bi morali opraviti kakšno predobdelavo, da bi lahko ustvarili poizvedbo?
Seveda, to je uporaba ClickHouse za povsem konkretno nalogo. To bi bilo tradicionalno rešeno v okviru Hadoop-a. To je idealna naloga za Hadoop. A v Hadoop-u je to zelo počasi. Moja cilj je pokazati, da lahko s ClickHouse-om rešujemo naloge, ki jih običajno obravnavamo z drugimi sredstvi, vendar jih rešujemo bistveno učinkoviteje. To je zasnovano za specifično nalogo. Seveda, če je naloga nekoliko podobna, jo lahko rešujemo na podoben način.
Razumem. Rekli ste, da se je obdelovalo 50 ur. Je to od samega začetka, ko so bili podatki naloženi, ali ko so bili pridobljeni rezultati?
Da-da.
Dobro, najlepša hvala.
To je na 3-strežni klasterski konfiguraciji.
Pozdravljam! Hvala za predstavitev! Vse je zelo zanimivo. Malo ne sprašujem glede funkcionalnosti, ampak o uporabi ClickHouse z vidika stabilnosti. Se vam je kdaj zgodilo, da ste morali obnoviti? Kako se obnaša ClickHouse v takih situacijah? Ali se je zgodilo, da ste izgubili tudi replikacijo? Mi smo na primer pri ClickHouse-u naleteli na težavo, ko je le-ta presegel svoj limit in padel.
Seveda, popolni sistemi ne obstajajo. Tudi ClickHouse ima svoje težave. Ampak, ste kdaj slišali, da Yandex.Metrica ni deloval dolgo časa? Verjetno ne. Deluje zanesljivo nekje od leta 2012-2013 na ClickHouse. O svoji izkušnji lahko tudi povem, da nikoli nismo imeli popolnih okvar. Nekatere delne težave so se lahko zgodile, vendar nikoli niso bile kritične dovolj, da bi resno vplivale na posel. Nikoli to ni bilo. ClickHouse je dovolj zanesljiv in ne odpove naključno. O tem ni treba skrbeti. To ni nedodelana stvar. To so dokazale mnoge družbe.
Pozdravljeni! Rekli ste, da je treba takoj dobro premisliti o shemi podatkov. Kaj pa, če se to zgodi? Moji podatki se nalivajo in nalivajo. Mine pol leta in razumem, da tako ne morem več, moram ponovno naložiti podatke in nekaj narediti z njimi.
To seveda odvisno od vašega sistema. Obstaja več načinov, kako to storiti praktično brez zaustavitve. Na primer, lahko ustvarite Materialized View, v katerem naredite drugo strukturo podatkov, če jo je mogoče nedvoumno preslikati. T. j. če omogoča preslikavo z orodji ClickHouse, t. j. izvleči nekatere stvari, spremeniti primarni ključ, spremeniti particioniranje, potem lahko naredite Materialized View. Tja prepišete svoje stare podatke, novi pa se bodo zapisovali samodejno. Nato se samo preklopite na uporabo Materialized View, nato spremenite zapis in staro tabelo izbrišete. To je način brez zaustavitve.
Hvala.
Izvor: habr.com
