

Kanarin – to majhna ptica, ki nenehno poje. Te ptice so občutljive na metan in ogljikov monoksid. Tudi pri majhni koncentraciji dodatnih plinov v zraku izgubljajo zavest ali umrejo. Zlatarji in rudarji so jih nosili s seboj: medtem ko kanarini pojejo, se lahko dela, če pa utihnejo – je v jami plin in je čas, da grejo ven. Rudarji so žrtvovali to majhno ptico, da so se rešili iz jam živih.
Podobna praksa se je pojavila tudi v IT. Na primer, v standardni nalogi za prenos nove različice storitve ali aplikacije v produkcijo s predhodnim testiranjem. Testno okolje je lahko predrago, avtomatizirani testi ne pokrivajo vsega, kar bi želeli, zato je tvegano ne testirati in ogroziti kakovost. V takih primerih pomaga pristop Canariaska distribucija, ko se na novo različico spusti malo pravega produkcijskega prometa. Ta pristop pomaga varno preveriti novo različico v produkciji, žrtvovati malo za veliko cilj. Več o tem, kako pristop deluje, kako je koristen in kako ga uresničiti, bo razložil Andrej Markelov (), na primeru implementacije v podjetju Infobip.
Andrej Markelov — vodilni inženir-programer v Infobipu, že 11 let se ukvarja z razvojem aplikacij v Javi na področju financ in telekomunikacij. Razvija odprtokodne produkte, aktivno sodeluje v Atlassian Community in piše vtičnike za Atlassianove produkte. Evangelist Prometheus, Docker in Redis.
O podjetju Infobip
To je globalna telekomunikacijska platforma, ki bankam, maloprodaji, spletnim trgovinam in transportnim podjetjem omogoča pošiljanje sporočil svojim strankam prek SMS, push, e-pošte in glasovnih sporočil. V takem poslu sta stabilnost in zanesljivost ključnega pomena, da stranke pravočasno prejmejo sporočila.
IT infrastruktura Infobipa v številkah:
- 15 podatkovnih centrov po vsem svetu;
- 500 edinstvenih storitev v uporabi;
- 2500 primerkov storitev, kar je precej več kot ekip;
- 4,5 TB mesečnega prometa;
- 4,5 milijarde telefonskih številk;
Poslovanje raste, s tem pa tudi število izdaj. Opravljamo približno 60 izdaj na dan, ker stranke želijo več možnosti in zmogljivosti. Ampak to je zahtevno – storitev je veliko, ekip pa malo. Treba je hitro pisati kodo, ki mora delovati v produkciji brez napak.
Izdaje
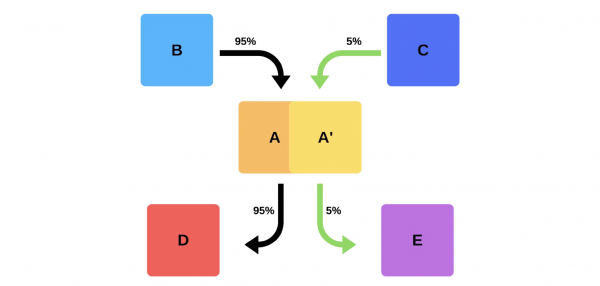
Tipična objava kod nas prolazi ovako. Na primjer, postoje servisi A, B, C, D i E, a svaki od njih razvija poseban tim.
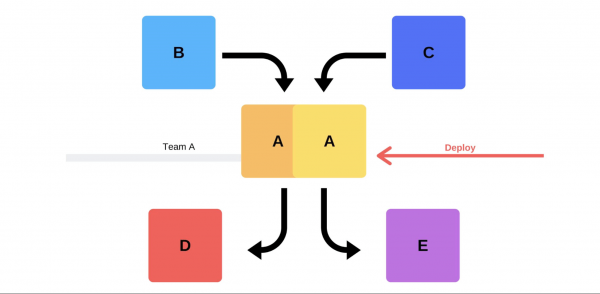
U nekom trenutku tim servisa A odlučuje da implementira novu verziju, ali timovi servisa B, C, D i E o tome nisu obavešteni. Postoje dva načina na koje tim servisa A može postupiti.
Obaviće inkrementalnu objavu: prvo će zameniti jednu verziju, a zatim drugu.
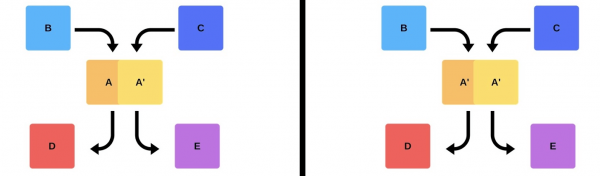
Ali postoji drugi način: tim će pronaći dodatne kapacitete i servere, implementiraće novu verziju, a zatim će prebaciti ruter, i verzija će početi da radi na produkciji.
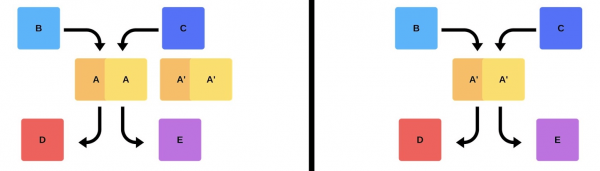
U svakom slučaju, nakon implementacije gotovo uvek se pojavljuju problemi, čak i ako je verzija testirana. Testirati se može ručno, može automatizovano, može se i ne testirati — problemi će se pojaviti u svakom slučaju. Najjednostavniji i ispravan način da ih rešimo je da se vratimo na radnu verziju. Kasnije se može baviti štetom, uzrocima i njihovim ispravkama.
Dakle, šta želimo?
Problemi nam nisu potrebni. Ako ih klijenti otkriju pre nas, to će udariti na reputaciju. Zato moramo brže pronalaziti probleme. Radom na vreme, minimizujemo štetu.
U isto vreme, želimo ubrzati implementaciju, tako da se to odvija brzo, lako, prirodno i bez napora s strane tima. Inženjere, DevOps inženjere i programere treba čuvati — objava nove verzije je stres. Tim nije potrošni materijal, težimo racionalno koristiti ljudske resurse.
Problemi sa implementacijom
Klijentki saobraćaj je nepredvidiv. Nemoguće je predvideti kada će klijentki saobraćaj biti minimalan. Ne znamo gde i kada klijenti započinju svoje kampanje — možda večeras u Indiji, a sutra u Hong Kongu. Uzimajući u obzir veliku vremensku razliku, implementacija čak i u 2 sata ujutro ne garantuje da klijenti neće biti pogođeni.
Problemi sa provajderima. Messangeri i provajderi su naši partneri. Ponekad imaju padove koji izazivaju greške prilikom implementacije novih verzija.
Distribuirani timovi. Timovi koji razvijaju klijentski deo i bekend, nalaze se u različitim vremenskim zonama. Zbog toga često ne mogu da se dogovore međusobno.
Data centri se ne mogu ponoviti na stejdžu. U jednom data centru ima 200 rackova — ponoviti to u pesku ni približno nije moguće.
Downtimeis unacceptable! We have an acceptable level of availability (Error Budget) when we operate 99.99% of the time, for example, and the remaining percentage is the 'margin of error.' Achieving 100% reliability is impossible, but it is important to continually monitor for failures and downtime.
Classic solutions
Writing code without bugs. When I was a young developer, managers would come to me asking to release without bugs, but that's not always possible.
Writing tests. Tests work, but sometimes not in the way that the business wants. Making money is not the tests' task.
Testing on staging. In my 3.5 years at Infobip, I have never seen the state of staging even partially match production.
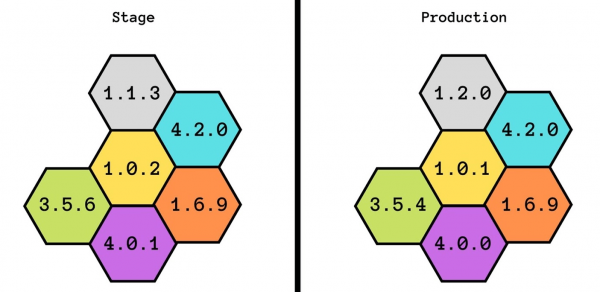
We even tried to develop this idea: first, we had staging, then pre-production, and then pre-production of pre-production. But that didn’t help either — they didn’t even match in terms of capacity. With staging, we can guarantee basic functionality, but we don’t know how it will perform under load.
The release is done by the developer. This is a good practice: even if someone changes a comment's name, they immediately add it to production. This helps to develop accountability and not forget about the changes made.
Additional complexities also exist. For developers, it is stressful to spend a lot of time checking everything manually.
Coordinated releases. This option is usually suggested by management: 'Let’s agree that every day you will test and add new versions.' This doesn’t work: there is always a team waiting for everyone else or vice versa.
Smoke tests
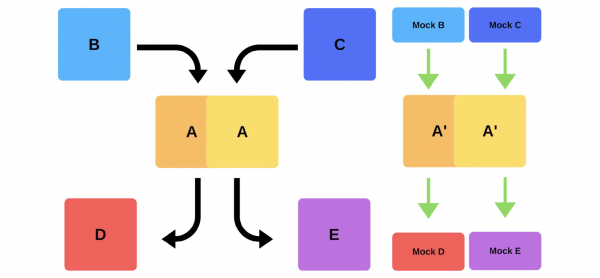
Another way to solve our deployment issues. Let’s see how smoke tests work in the previous example when Team A wants to deploy a new version.
First, the team deploys one instance in production. Messages in the instance from mocks simulate real traffic, so it matches the normal daily traffic. If everything is good, the team switches the new version to user traffic.
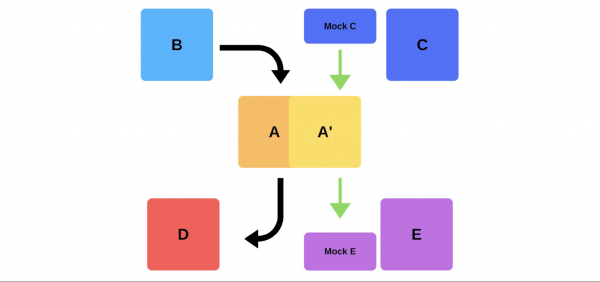
The second option is to deploy with additional hardware. The team tests it in production, then switches it, and everything works.
Disadvantages of smoke tests:
- Testom se ne može vjerovati. Gdje dobiti isti promet kao na produkciji? Može se koristiti jučerašnji ili tjedni promet, no on se ne podudara uvijek s trenutnim.
- Teško se održava. Morat ćemo održavati testne račune, neprestano ih resetirati prije svakog deploymenta, kada se u pohranu šalju aktivni zapisi. To je složenije nego pisanje testa u vlastitom pijesku.
Jedina prednost ovdje — može se provjeriti performanse.
Canary izdanja
Zbog nedostataka smoke testova počeli smo koristiti canary izdanja.
Praksa, slična onoj kako su rudari koristili kanarince za indikaciju razine plinova, pronašla je svoj put i u IT-u. Puštamo malo stvarnog produkcijskog prometa na novu verziju, pri čemu se trudimo zadržati unutar Sporazuma o razini usluga (SLA). SLA je naše "pravo na grešku" koje možemo iskoristiti jednom godišnje (ili tijekom nekog drugog vremenskog razdoblja). Ako bude sve u redu, dodajemo više prometa. Ako ne — vraćamo prethodne verzije.
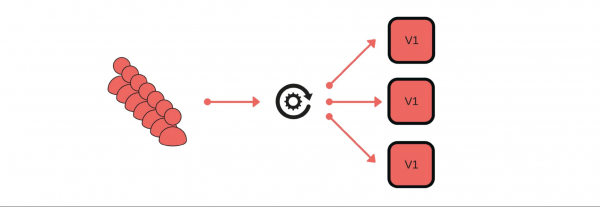
Implementacija i nijanse
Kako smo implementirali canary izdanja? Na primjer, grupa klijenata šalje poruke putem naše usluge.
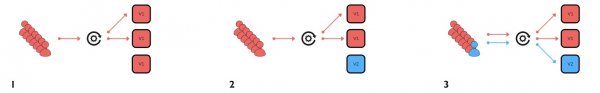
Deployment ide ovako: uklanjamo jedan čvor iz ravnoteže opterećenja (1), mijenjamo verziju (2) i odvojeno puštamo malo prometa (3).
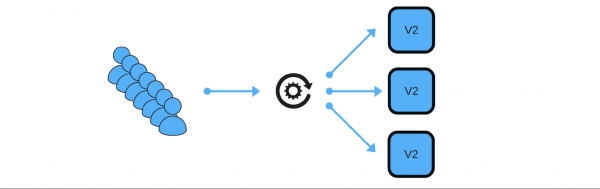
Općenito, u grupi će svi biti sretni, čak i ako jedan korisnik bude nezadovoljan. Ako je sve u redu — mijenjamo sve verzije.
Prikazat ću shematski kako to obično izgleda za mikroservise.
Postoji Otkriće usluga i još dva servisa: S1N1 i S2. Prvi servis (S1N1) obavještava Otkriće usluga kada se pokrene, a Otkriće usluga ga zapamti. Drugi servis s dva čvora (S2N1 i S2N2) također obavještava Otkriće usluga prilikom pokretanja.
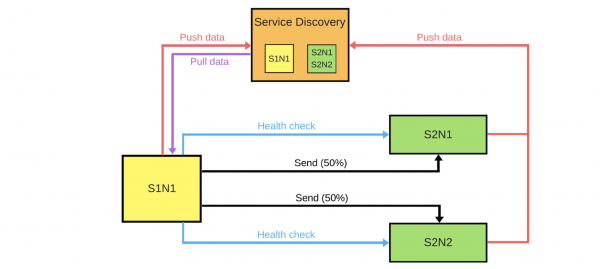
Drugi servis za prvi djeluje kao poslužitelj. Prvi traži od Otkrića usluga informacije o svojim poslužiteljima, a kada ih dobije — traži i provjerava ih („health check“). Kada provjeri, šalje im poruke.
Kada netko želi postaviti novu verziju drugog servisa, obavještava Otkriće usluga da će druga čvor biti canary čvor: na nju će se slati manje prometa, jer će se sada odvijati deployment. Uklanjamo canary čvor iz ravnoteže opterećenja i prvi servis ne šalje promet u njega.
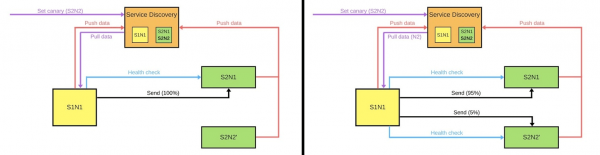
Zamenjamo različico, in Service Discovery ve, da je druga vozlišče zdaj canary - zato ji lahko dajemo manj obremenitve (5%). Če je vse dobro, spremenimo različico, vrnemo obremenitve in nadaljujemo z delom.
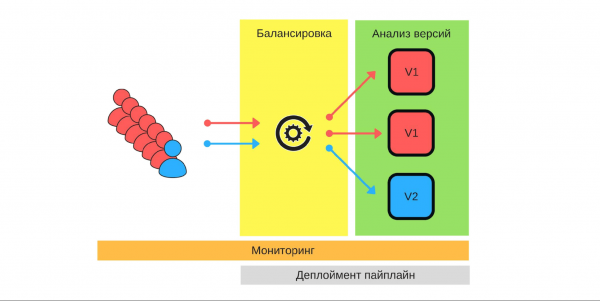
Za uresničitev tega potrebujemo:
- balansiranje;
- nadzor, saj je pomembno vedeti, kaj vsak uporabnik pričakuje, in kako podrobno delujejo naše storitve;
- analiza različic, da razumemo, kako dobro bo nova različica delovala v produkciji;
- avtomatizacija — napišemo zaporedje nameščanja (deployment pipeline).
Uravnoteženje
To je prvi korak, o katerem moramo razmišljati. Obstajata dve strategiji balansiranja.
Najenostavnejša možnost je, ko eno vozlišče vedno deluje kot canary. To vozlišče vedno prejme manj prometa in z namestitvijo začnemo od njega. V primeru težav bomo primerjali njegovo delovanje pred namestitvijo in med njo. Na primer, če se je število napak podvojilo, se je povečala tudi škoda.
Canary vozlišče se določi v procesu namestitve. Ko se namestitev konča in mu odstranimo status canary vozlišča, se balancer prometa povrne. Z manjšim številom strojev bomo dobili pošteno porazdelitev.
Nadzor
Temelj canary izdaj. Natančno moramo vedeti, zakaj to delamo in katere metrike želimo zbirati.
Primeri metrik, ki jih zbiramo iz naših storitev.
- Število napak, ki se beležijo v dnevnikih. To je očiten pokazatelj, da vse deluje kot je treba. Na splošno je to dobra metrika.
- Čas obdelave poizvedb (latency). To metriko spremljajo vsi, ker si vsi želijo delati hitro.
- Velikost čakalne vrste (throughput).
- Število uspešnih odgovorov na sekundo.
- Čas obdelave 95% vseh poizvedb.
- Poslovne metrike: koliko denarja podjetje zasluži v določenem času ali stopnja odhoda uporabnikov. Te metrike so za našo novo različico lahko pomembnejše od tistih, ki jih dodajajo inženirji.
Primeri metrik v večini priljubljenih sistemov za spremljanje.
Counter. To je neka naraščajoča količina, na primer število napak. To metriko je preprosto interpolirati in preučevati graf: včeraj je bilo 2 napake, danes 500, kar pomeni, da se je zgodilo nekaj narobe.
Število napak na minuto ali na sekundo, to je najpomembnejši pokazatelj, ki ga je mogoče izračunati s pomočjo Counter-a. Ti podatki dajejo jasno predstavo o delovanju sistema na daljavo. Uvrstimo v graf števila napak na sekundo za dve različici produkcijskega sistema.
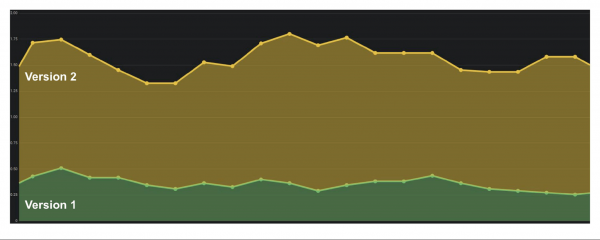
V prvi različici je bilo malo napak, morda audit ni deloval. V drugi različici je vse precej slabše. Lahko z gotovostjo trdimo, da so težave, zato moramo vrniti to različico.
Merilo. Metrični podatki so podobni števcem, vendar zapisujemo vrednosti, ki se lahko povečujejo ali zmanjšujejo. Na primer, čas izvajanja poizvedb ali velikost čakalne vrste.
Na grafu je prikazan primer latence. Iz grafa je razvidno, da sta si različici podobni in da z njimi lahko delamo. Če pa se pozorno ozremo, opazimo, kako se spreminja velikost. Če se čas izvajanja poizvedb povečuje ob dodajanju uporabnikov, je takoj jasno, da so težave — prej tega ni bilo.
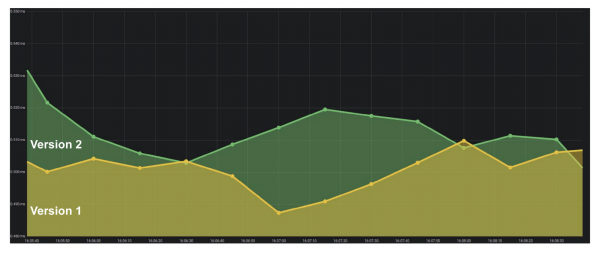
Povzetek. Eden najpomembnejših kazalnikov za biznis so percentili. Metrični podatek pokaže, da v 95% primerov naš sistem deluje tako, kot želimo. Lahko se sprijaznimo, če nekje pride do težav, ker razumemo splošno trend, kako dobro ali slabo je vse skupaj.
Orodja
ELK Stack. Canary lahko implementiramo z uporabo Elasticsearch — beležimo napake, ko se zgodijo dogodki. Z najpreprostejšim API klicem lahko dobimo število napak v vsakem trenutku in to primerjamo s preteklimi obdobji: GET /applg/_count?q=level:error.
Prometheus. Dobro se je izkazal v Infobip. Omogoča izvajanje večdimenzionalnih metrik, ker se uporabljajo oznake.
Lahko uporabimo level, instanco, service, jih kombiniramo v enem sistemu. S pomočjo offset lahko pogledamo recimo vrednost spremenljivke pred enim tednom z eno samo ekipo GET /api/v1/query?query={query}, gde {query}:
rate(logback_appender_total{
    level="error",
    instance=~"$instance"
}[5m] offset $offset_value)
Analiza različic
Obstaja več strategij za analizo različic.
Gledati metrike samo canary-nod. Ena najpreprostejših možnosti: namestimo novo različico in proučujemo samo delovanje. Ampak, če inženir v tem času začne pregledovati dnevnike, nenehno napeto osvežuje strani, potem ta rešitev ni drugačna od drugih.
Canary-noda se primerja z drugo nodom. To je primerjava z drugimi instancami, ki delujejo s polnim prometom. Na primer, če je s malim prometom slabše ali ne boljše kot na realnih instancah, je nekaj narobe.
Canary-noda se primerja s samo seboj iz preteklosti. Node, assigned for canary, can be compared with historical data. For instance, if everything was fine a week ago, we can use this data to understand the current situation.
Avtomatizacija
We want to free engineers from manual comparisons, which is why it's important to implement automation. The deployment process (deployment pipeline) usually looks like this:
- let's start;
- remove the node from the load balancer;
- set the canary node;
- enable the load balancer with a limited amount of traffic;
- compare.
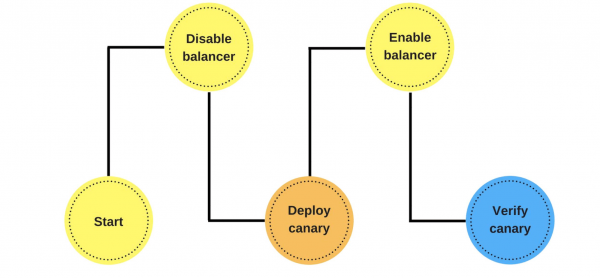
At this stage, we implement automatic comparison. How it might look and why it's better than post-deployment checking will be discussed using an example from Jenkins.
This is a pipeline to Groovy.
while (System.currentTimeMillis() < endCanaryTs) {
    def isOk = compare(srv, canary, time, base, offset, metrics)
    if (isOk) {
        sleep DEFAULT SLEEP
    }   else {
        echo "Canary failed, need to revert"
        return false
    }
}
Here, in the loop, we set that we will compare the new node for one hour. If the canary process has not yet completed — we call the function. It informs whether everything is fine or not: def isOk = compare(srv, canary, time, base, offset, metrics).
If everything is fine — sleep DEFAULT SLEEP, for example, for one second, and continue. If not, we exit — deployment failed.
Description of the metric. Let's see how the function compare might look using an example of DSL.
metric(
    'errorCounts',
    'rate(errorCounts{node=~"$canaryInst"}[5m] offset $offset)',
    {   baseValue, canaryValue ->
        if (canaryValue > baseValue * 1.3) return false
        return true
    }
)
Suppose we are comparing the error count and want to know the number of errors per second over the last 5 minutes.
We have two values: the base and the canary node. The value for the canary node is the current one. The base is baseValue — this is the value for any other non-canary node. We compare the values with the formula that we set based on our experience and observations. If the value canaryValue is poor, then the deployment has failed, and we roll back.
Why is all this necessary?
A person cannot check hundreds and thousands of metrics, not to mention doing it quickly. Automatic comparison helps to check all metrics and quickly notifies about problems. The response time is critical: if something happens in the last 2 seconds, the damage will be less than if it occurred 15 minutes ago. While someone notices the problem, writes to support, and the support tells us to roll back, we can lose customers.
Če je postopek uspel in vse v redu, avtomatsko namestimo preostale vozlišča. V tem času inženirji ne delajo nič. Šele ko zagnajo canary, se odločijo, katere metrike uporabiti, koliko časa naj traja primerjava, katero strategijo uporabiti.
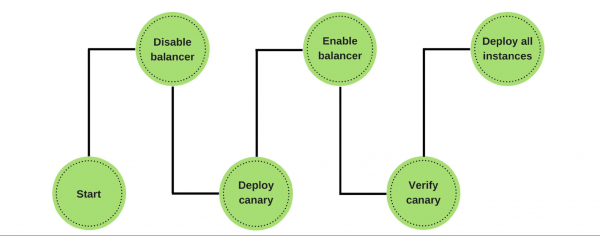
Če pride do težav — samodejno vrnemo canary-vozlišče, delamo na prejšnjih različicah in odpravljamo napake, ki smo jih našli. Z metriko jih je enostavno najti in videti škodo od nove različice.
Ovir
Uresničiti to, seveda, ni enostavno. Predvsem je potrebna sistemsko spremljanje. Inženirji uporabljajo svoje metrike, podpora in analitiki druge, podjetje tretje. Skupna sistem je skupni jezik, s katerim komunicirata podjetje in razvoj.
Treba je preveriti v praksi stabilnost metrik. Preverjanje pomaga razumeti, kateri minimalni nabor metrik je potreben za zagotavljanje kakovosti.
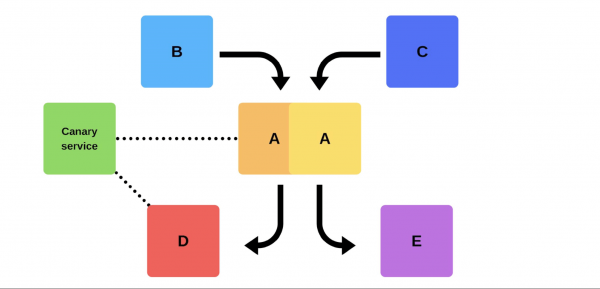
Kako to doseči? Uporabiti canary-storitev ne ob namestitvi. Dodajamo na starejši različici določeno storitev, ki lahko kadar koli vzame katero koli določeno vozlišče in zmanjša promet brez namestitve. Po tem primerjamo: preučujemo napake in iščemo tisto mejo, ko dosežemo kakovost.
Kakšne koristi smo imeli od canary-izdaj
Minimizirali smo odstotek škode zaradi napak. Večina napak pri namestitvi se zgodi zaradi neskladnosti nekaterih podatkov ali prioritet. Takih napak je postalo precej manj, saj lahko težavo rešimo v prvih sekundah.
Optimizirali smo delo ekip. Novinci imajo "pravico do napake": lahko namestijo v produkcijo brez strahu pred napako, kar prinaša dodatno pobudo in spodbudo za delo. Če kaj pokvarijo, to ne bo kritično, napake pa ne bodo odpuščali.
Avtomatizirali smo namestitev. To ni več ročni postopek, kot je bilo prej, temveč pravi avtomatiziran postopek. Toda traja dlje.
Izpostavili smo pomembne metrike. Vse podjetje, od podjetja do inženirjev, razume, kaj je v našem izdelku resnično pomembno, katere metrike, na primer, odtok in vstop uporabnikov. Kontroliramo proces: testiramo metrike, uvajamo nove, gledamo, kako delujejo stare, da zgradimo sistem, ki bo bolj produktiven pri zaslužku.
Imamo mnogo odličnih praksi i sistema koji nam pomažu. Unatoč tome, težimo biti profesionalci i obaviti svoj posao kvalitetno, bez obzira imamo li sustav koji nas podržava ili ne.
Inženjerski pristupi i prakse — . Ako ste postigli uspjehe na putu ka tehničkoj izvrsnosti i spremni ste podijeliti što vam je u tome pomoglo — .
Planiramo održati 8. juna. Razumijemo da je trenutno teško donijeti odluke o sudjelovanju na konferenciji. No, smatramo da karantena nije razlog za zaustavljanje profesionalne komunikacije i razvoja. Stoga ćemo u svakom slučaju pronaći način da razgovaramo o problemima vođe tima i pristupima njihovom rješavanju — ako bude potrebno, preći ćemo online i organizirati umrežavanje tamo!
Izvor: habr.com

 Russian
 Italian
 German
 Polish
 Estonian
 Albanian
 Bosnian
 Bulgarian
 Croatian
 Czech
 Danish
 Dutch
 English
 Finnish
 French
 Hungarian
 Latvian
 Lithuanian
 Norwegian
 Portuguese
 Romanian
 Slovak
 Slovenian
 Spanish
 Swedish
 Turkish