

Moje ime je Jurij, vodim tim za sistemsko administriranje u Sitimobilu. Danas ću podijeliti iskustvo rada s tehnologijom tankog rezerviranja (thin provisioning) datotečnih sustava Linux i objasniti kako se može primijeniti u tehnološkim CI/CD procesima tvrtke. Razgovarat ćemo o situaciji kada su nam za automatsko testiranje koda prilikom njegovog isporučivanja u proizvodnju što brže potrebne kopije MySQL baza podataka, koje su što bliže 'živoj' verziji, dostupne za čitanje i pisanje.
Uvod: zašto davati štetne savjete?
Logično pitanje, jer postoje provjereni mehanizmi migracija shema baza podataka u testne okoline. Zašto uopće dovoditi glavnu nešardiranu DBMS do takvih volumena? Pa i za testiranje nisu potrebni svi podaci. Pokušat ću objasniti.
Prije otprilike godinu dana, u pozadini aktivnog rasta našeg agregatora taksija (tijekom 2018. godine smo povećali broj završenih vožnji otprilike 15 puta), povećali su se volumeni podataka, opterećenje na poslužiteljima i učestalost isporuka. Našli smo se u sljedećoj situaciji:
- Glavna MySQL baza podataka rasla je na otprilike 1000 tablica ukupnog volumena od 2,5 TB i nastavila rasti.
- Nije bilo mogućnosti brzo se šardirati i razdvojiti bazu. Staromethoda "pisanje u bazu što želim i kako želim", hrpa JOIN-ova i unutarnjih ovisnosti tablica nije to dopuštala.
- Nije postojao mehanizam migracija shema baza podataka u testna okruženja.
- Nije bilo automatskog testiranja koda prilikom isporuke u proizvodnju.
Zadnji problem smo htjeli riješiti što brže. Već su pisani Postman testovi za provjeru glavnog PHP monolita, ali nedostajala je aktualna baza podataka. Također nismo mogli noću stvarati replikaciju, pretvarati je u majstor i davati je na ispitivanje tijekom dana: jako velika količina isporuka i promjena, uključujući i u podacima i shemi baze podataka, učinila bi da bi panel postao neoperativan već sredinom dana. A ograničavanje isporuka samo na radni dan bilo bi neučinkovito.
Ipak, zadatak je bio ispunjen: prvi radni panel dobili smo već nakon dva tjedna. Tijekom prošle godine doživio je mnoge promjene i i dalje se koristi.
Sljedeće ću detaljno opisati sve korake i faze razvoja našeg rješenja. Uvjerit ćete se da ova metoda zaslužuje pravo na postojanje.
Što je "tanko rezerviranje"?
To je hardverska ili softverska tehnologija (takođe poznata kao sparse volumes), koja omogućava alokaciju većih količina potrebnog resursa nego što je dostupno. Pritom, alocirani volumen mora da zadovoljava kriterijume just-enough (onoliko koliko je potrebno) i just-in-time (u potrebnom vremenu). Uglavnom se tanko rezervisanje koristi u raznim SANS-ovima kako bi se obezbedilo diskovno prostor u potrebnim količinama, koje premašuju fizički dostupne. Tehnologiju podržavaju različiti fajl sistemi, kao što su LVM2, ZFS, BTRFS. Široko se koristi u hipervizorima virtuelizacije. Tanka rezervacija nam je omogućila brzo kreiranje iz snapshotova glavne particije sa podacima onoliko kopija te particije koliko nam je potrebno (data direktorija SDB MySQL).
Prvi stand, tehnologija Thin LVM
Ovu glavu možemo nazvati „Kako napraviti najbrže snimke velikih količina podataka koristeći , smanjujući stabilnost fajl sistema i SDB MySQL na nepristojne nivoe.”
Pošto smo već koristili LVM za izgradnju glavnih particija OS-a, odlučili smo da počnemo upravo od nje. Za početak nam je trebao poseban fizički računar — replika naše glavne MySQL baze, na kojoj bismo mogli na zahtev kreirati snapshot replike i podići ga pored odvojenim instance MySQL. Tokom testiranja dozvolili smo promene na ovoj instanci, a po završetku testova uspešno smo je uklonili. Konfiguracija servera je bila sledeća:
- 2 x Intel Silver 4114 (10×2,2 GHz HT)
- 8 x 32 GB DDR4
- 8 x 1920 GB Intel SSD u RAID kontroleru Adaptec u RAID-10
O izboru između RAID kontrolera i softverskog RAID MD može se pisati poseban članak. Reći ću samo da su na naš izbor uticala dva faktora:
- U vreme postavljanja zadatka, sve SDB-ove smo instalirali na RAID kontrolere, tako da se može reći da je to istorijski uslovljeno.
- Razlika u performansama na sintetičkim testovima fajl sistema i testovima sa raznim operacijama u MySQL-u bila je minimalna.
Razdelili smo nastali RAID-10: ustvarili smo enotno Volume Group (VG) za celoten obseg (z overheadom približno 6,7 GB) in ustvarili logično particijo (Logical Volume, LV) za sistem s kapaciteto 50 GB. V običajni situaciji bi ostali prostor namenili particiji za MySQL. A potrebovali smo tanko rezervacijo, zato smo najprej ustvarili tako imenovani pool, znotraj katerega smo ustvarili particijo za /var/lib/mysql s kapaciteto 3,5 TB (na podlagi predvidenih obsegov DB):
lvcreate -l 100%FREE -T vga/thin
lvcreate -V 3.5T -T vga/thin -n mysql
Formatirali smo particijo v ext4, jo pripeli, zabeležili replikat in dobili izvorno okolje. Nato smo ustvarili API, ki mora ustvarjati posnetke, zagnati instanco MySQL na določenem vratu in odstraniti ustvarjeno instanco. Ker pri tem uporabljamo izključno sistemske klice, smo izbrali navadni bash za pisanje skriptov, za povezavo API HTTP → bash pa smo uporabili odprtokodno rešitev , napisano v Go.
Nekega dne bomo objavili naše bash skripte kot odprto kodo, za zdaj pa bom preprosto opisal glavni algoritem:
Ustvarjanje glavnega posnetka snapmain:
- Ustavimo glavno repliko.
- Naložimo blokado na operacije s posnetkom snapmain.
- Ustvarimo nov posnetek snapmain.
- Zagnamo MySQL in odstranimo blokado.
Ustvarjanje DB na poljubnem vratu iz snapmain:
- Naložimo blokado na določeno instanco DB (vrat).
- Preverimo, ali obstaja blokada ustvarjanja glavnega posnetka. Če obstaja, čakamo in ponovno preverimo vsakih 5 sekund.
- Preverimo, ali obstaja stara LV-particija instance.
3.1 Če obstaja, ustavimo instanco MySQL s pomočjo kill -9 in izbrišemo LV-particijo. - Ustvarimo novo instanco iz snapmain.
- Pripravimo in montiramo imenike za to instanco.
- Odstranimo znake slava (datoteke) in zaženemo instanco MySQL.
- Naredimo iz nje master.
- Odstranimo blokado.
Izbris DB na poljubnem vratu:
- Naložimo blokado na določeno instanco DB (vrat).
- Ubijemo instanco MySQL s pomočjo kill -9.
- Odmontiramo imenike.
- Izbrišemo LV-particijo in odstranimo blokado.
Primer ukazov za kloniranje particij nove instance DB:
lvcreate -n stage_3307 -s vga/snapmain
lvchange -ay -K vga/stage_3307
mount -o noatime,nodiratime,data=writeback /dev/mapper/vga-stage_3307 /mnt/stage_3307
Zdaj se bom osredotočil na glavni problem, s katerim smo se srečali pri uporabi tanke rezerve. Zasledili smo težave z zmogljivostjo SSD-diskov. To je posledica značilnosti Thin LVM: deluje na ravni naprave z nizkocenovnimi klifi, ki so po privzetku velike 4 MB. Kako je to izgledalo:
- Ustvarimo posnetek glavnega razdelka /var/lib/mysql.
- Začnemo replikacijo, da dohitevamo glavnega.
- Vsaka sprememba v tabelah replikacije prisili, da se stari, nespremenjeni klifi podatkov shranijo v razdelku posnetka.
- Vsaka sprememba v vzpostavljeni testni instanci prisili, da se stari, nespremenjeni klifi podatkov shranijo v razdelku kloniranega posnetka za to instanco.
- Dosežemo obremenitev vhodno-izhodnih operacij na 100% na napravi, kar upočasni vse operacije in postopno zaostaja replikacijo.
- Do konca delovnega dne dobimo zaostalo instanco za več ur.
Kako smo se s tem spopadli, da smo dobili bolj razumne rezultate (glavne točke):
RAID kontroler:
- Izklopili smo vse vrste predpomnjenja.
- Nastavili smo writeback (ko podatki vstopijo v predpomnilnik, se zapis konča, preden se dejansko shrani na disk).
Datotečni sistem:
- Na točki montaže /var/lib/mysql smo zapisali noatime,nodiratime,data=writeback
- Izklopili smo journaling ext4 z uporabo tune2fs.
MySQL:
- Zapisali smo innodb_flush_method = O_DSYNC (povečali smo hitrost zapisa, s čimer smo znižali zanesljivost).
- Izklopili smo journaling, dnevniki nam niso potrebni.
- Zapisali smo innodb_buffer_pool_size = 4G (manjša velikost InnoDB bazena pomeni, da se bo MySQL hitreje zaustavil in hitreje bomo ustvarili posnetek).
To ni popoln seznam, še posebej glede MySQL. Vendar pa so ostale spremembe manjše in pogosto niso vedno ali natančno aplicirane. Na primer, da bi razbremenili diske, smo celo premaknili innodb_parallel_doublewrite_path v /dev/shm, kar je v nekaterih primerih pri zagonu nepopolne instance prihranilo do 5 sekund.
Zakaj ustavljamo MySQL, preden naredimo posnetek? Saj ga lahko naredimo z delujočo replikacijo. Res je, a nova instanca Baze podatkov na tem posnetku bo privzeto štela za poškodovano in bo potrebovala celotno skeniranje ob zagonu. Ustaviti replikacijo je vsekakor hitreje, čeprav je to na koncu najdaljša operacija v celotnem procesu.
Z rezultatom smo dobili primerne časovne okvire in delujočo postavitev. Vendar, kot je razvidno iz najbolj povedne analize zamud replikacije glavne replikacije, situacija še zdaleč ni idealna:
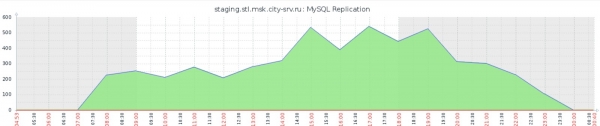
Med drugimi pomanjkljivostmi izpostavljamo praktično nemogoče spremljanje Thin LVM bazena: poleg sistemskih standardnih funkcij iostat je nemogoče ugotoviti, kateri element bazena trenutno povzroča največje obremenitve na datotečnem sistemu.
Še posebej je treba izpostaviti eno veliko pomanjkljivost, povezano z zgoraj opisano optimizacijo: dobili smo YOLO-stavbo. Približno enkrat na en do dva meseca ext4 ni zdržala takšnih zlorab in se nepovratno pokvarila, kar je zahtevalo ponovno formatiranje in ponovno nalaganje replik. S hitrostjo, ki smo jo pridobili, smo brezupno uničili stabilnost.
Na katerih metrih je treba spremljati med obratovanjem Thin LVM:
- Thin pool data %
- Thin pool metadata %
Če naš sistem z več potrebami za podatke preživi, dovolj je očistiti diske, vendar bo končanje prostora za metapodatke privedlo do popolnega zrušenja bazena in potrebe po njegovi ponovni ustvaritvi od začetka.
Datotečni sistem znotraj bazena se sčasoma močno fragmentira. Priporočam, da enkrat na dan zaženete ukaz po cron: fstrim -v /var/lib/mysql.
Vmesni zaključki:
- Tehnologija je enostavno uporabna, tako kot sam LVM, in ne zahteva posebne kvalifikacije inženirja.
- Dobro je primerna za manjše in ne preobremenjene baze podatkov. Manjša kot je baza, manjše je število delov, ki se premikajo po datotečnem sistemu znotraj bazena, in tako manjša je obremenitev diskov.
- Za našo nalogo smo začeli iskati druge rešitve, o čemer bomo govorili v naslednjem poglavju.
Druga postavitev, tehnologija ZFS
Nekoč sem se ukvarjal s datotečnim sistemom ZFS, vendar je takrat ZFS deloval dobro le v svojem matičnem sklopu operacijskih sistemov Solaris. Obstajala je različica, prenešena na FreeBSD, ki je imela dovolj dobro raven izvedbe. Prav tako je bila nedokončana različica za Linux, ki je zaprta v majhno rabo. Zaradi strukture shranjevanja podatkov B-tree (mimogrede, enaka struktura shranjevanja se uporablja tudi v InnoDB MySQL) se je ZFS slabo obnesel na namestitvah z zelo velikim številom datotek. Vse to skupaj z nujnostjo učenja teoretičnega dela pred uporabo je ZFS dolgo izključilo iz moje prakse. Pojavili so se ext4 in xfs, ki sta postala standard. Vendar, upoštevajoč, da je ZFS več kot primeren za naše naloge, in da je različica za Linux, sodeč po mnenjih, zrasla v povsem normalen izdelek (čeprav ni v popolni podpori, kar pomeni, da je treba sistem na ZFS povsem od začetka namestiti le z različnimi veščinami), smo se odločili, da jo preizkusimo.
Iz razumljivih razlogov smo izbrali stojalo enake konfiguracije (razen RAID-kontrolerja). Namestili smo osem SSD diskov po 1920 GB. Nismo želeli pisati lastne mrežne podobe za nalaganje strežnika na golo ZFS, zato smo na vseh diskih vzeli 50 GB in naredili MD RAID-10 za sistem. Preostalih 1950 GB na vsakem disku smo združili v ZFS-analog RAID-10:
zpool create zpool mirror /dev/sda2 /dev/sdb2 mirror /dev/sdc2 /dev/sdd2 mirror /dev/sde2 /dev/sdf2 mirror /dev/sdg2 /dev/sdh2Naredili smo particije za MySQL:
zfs create zpool/mysql
zfs set compression=gzip zpool/mysql
zfs set recordsize=128k zpool/mysql
zfs set atime=off zpool/mysql
zfs create zpool/mysql/data
zfs set recordsize=16k zpool/mysql/data
zfs set primarycache=metadata zpool/mysql/data
zfs set mountpoint=/var/lib/mysql zpool/mysql/data
Upoštevajte, da smo vključili privzeto stiskanje podatkov gzip. Na strežniku imamo veliko procesorskih virov, ki niso povsem izkoriščeni. Rezultat je, da se je 3 TB naše baze podatkov spremenilo v 1,6 TB, in ker je šibka točka, tako kot prejšnjič, največja zmogljivost diskov, manjše kot so podatki — boljši smo že na začetku pridobili odličen bonus iz ZFS! V prometnih urah ob polni obremenitvi za vzdrževanje delovanja gzip porabi do 4 jedra, vendar nam to ne predstavlja težav.
Nato je implementacija potekala hitreje. Po kot leplenka smo preselili nastavitve MySQL replik v LVM stojalu. Porabili smo nekaj časa za prepisovanje skriptov v ukaze ZFS, vendar so v splošnem algoritmi ostali enaki. Primer ustvarjanja posnetka:
zfs set snapdir=visible zpool/mysql/data
zfs create zpool/stage_3307
zfs clone zpool/mysql/data@snapmain zpool/stage_3307/data
zfs set mountpoint=/mnt/stage_3307 zpool/stage_3307/data
Iz dodatnega tuninga: preselili smo v pomnilnik ZFS-oddelke z metapodatki in logi l2arc in zil. Za našo nalogo, kot se je izkazalo pozneje, je to bilo odveč, vendar to optimizacijo zaenkrat puščamo, zlahka jo lahko spremenimo. Negativni učinki so ti, da je treba po ponovnem zagonu strežnika znova ustvariti ustrezne pomnilniške prostore. Izsek zpool status:
logs
      /dev/shm/zil_slog.img  ONLINE       0     0     0
cache
      /dev/shm/l2arc.img     ONLINE       0     0     0
V tej konfiguraciji smo začeli testirati stojalo in dobili odlične rezultate: z dvema hkrati delujočima kopijama Baze podatkov (in aktivno glavno replikacijo) na posnetkih smo dosegli obremenitev diskov na 50-60%.
Znebili smo se naše glavne težave, kar je razvidno na grafu zaostanka replikacije (primerjajte s prejšnjim grafom v razdelku Thin LVM):
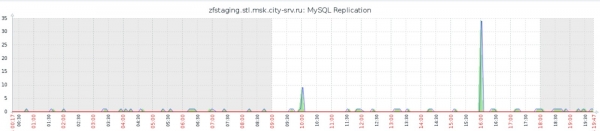
Poleg tega in zahvaljujoč temu smo močno pospešili vse operacije: popolno ustvarjanje posnetka s zaustavitvijo in zagonoma replikacije traja do 40 sekund, izvajanje nove kopije MySQL iz posnetka pa traja do 20 sekund. To nas popolnoma zadostuje tako nam kot našim testom programske kode.
Vmesni zaključki:
- Rezultati so v celoti zadovoljili naše potrebe po pridobitvi kopije produkcijske Baze podatkov za testiranje kode.
- Tehnologija zahteva razumevanje: treba je razumeti, kaj ZFS je in kako delati z njim.
- Nismo preverjali trenutnega stanja delovanja ZFS z velikim številom (več kot 1 milijon) majhnih datotek. Predpostavljamo pa, da težava ostaja, zato te datotečne sisteme ne bi priporočal za kakršne koli shrambe datotek.
Kaj zdaj?
Na stojalu nedelamo več nič, rezultati so zadovoljivi. Morda bomo v prihodnje dodali izključitve tabel v nastavitev replikacije stojala, ki niso potrebne za testiranje, kar bo še dodatno zmanjšalo obseg baze podatkov. Sistema BTRFS in njegove implementacije tehnologije tankega varčevanja še nismo preizkusili. Vendar pa to ni več naloga, saj je bil glavni cilj dosežen. Na splošno pa bi želeli prekiniti opisani pristop — realizirati delujoče migracije baz podatkov v testno okolje, ustvariti ločen testni krog baze podatkov ter se ukvarjati s šardiranjem glavne baze. Mnoge od teh stvari že uresničujemo, o čemer bomo obvezno poročali v prihajajočih člankih.
Zaključki
Izvirni cilj je bil dosežen, čeprav na nenavaden način. V vmesnih izsledkih so bili opisani prednosti in slabosti vsake od uporabljenih tehnologij, zato se dogovorimo, katero tehnologijo in kdaj lahko uporabimo:
- Thin LVM — za majhne baze podatkov in kadar ne želimo ali nimamo časa, da bi se učili ZFS.
- ZFS — če imate izkušnje z njo ali možnost, da si vzamete čas za učenje v vseh situacijah.
Na višji ravni predstave je ta članek več kot le primerjava tehnologij obeh datotečnih sistemov. Glavna ideja, ki jo želim prenesti in utrditi, je, da se ne smemo bali razmišljati nekonvencionalno v kritičnih poslovnih situacijah in jemati le pripravljenih receptov. Nekoč bi lahko celoten tehnični oddelek odmahnil z roko in rekel, da je naloga izdelave tridimenzionalnih varnostnih kopij baze podatkov v manj kot eni minuti neuresničljiva, in da ne potrebujemo tveganih tehnologij, naredimo, kot je treba. To bi bilo mogoče, vendar bi približno šest mesecev do leta izgubili ter prišli do številnih potovanj strank (potovanja so naš glavni poslovni pokazatelj) brez testov in med uvajanjem. Z nekonvencionalnim pristopom smo porabili precej manj časa za uvedbo, dobili izkušnje v novih in pozabljenih starejših tehnologijah ter omogočili testiranje prav v tistem trenutku, ko smo ga zelo potrebovali. Nedvomno je to pozitivno vplivalo na vse naše kazalnike. Izbira je vedno vaša, mi pa bomo na svoji strani še naprej poročali o zanimivih trenutnih in prihodnjih dosežkih v našem blogu.
Izvor: habr.com
