

Vsem dobro!
Moje ime je Nikita, sem vodja ekipe inženirjev Ciana. Ena izmed mojih nalog v podjetju je, da zmanjšam število incidentov, povezanih z infrastrukturo v produkciji, na nič.
Kar bo omenjeno v nadaljevanju, nam je povzročilo veliko bolečine, cilj tega članka pa je, da drugim preprečimo ponovitev naših napak ali vsaj minimaliziramo njihov vpliv.
Uvod
Davno, ko je bil Cian sestavljen iz monolitov in nikakršnih namigov na mikroservise še ni bilo, smo merili dostopnost virov z preverjanjem 3–5 strani.
Če odgovarjajo — je vse v redu, če ne odgovarjajo dalj časa — alarm. Koliko časa morajo ne delovati, da to šteje kot incident, so odločali ljudje na sestankih. Ekipa inženirjev je vedno sodelovala pri preiskovanju incidenta. Ko je bila preiskava končana, so napisali postmortem — svojevrsten poročilo po e-pošti v formatu: kaj se je zgodilo, kako dolgo je trajalo, kaj smo naredili v trenutku, kaj bomo naredili v prihodnosti.
Glavne strani spletne strani ali kako razumemo, da smo dosegli dno
Da bi lahko na nek način razumeli prioritetne napake, smo izpostavili najbolj kritične strani spletne strani za poslovne funkcionalnosti. Po njih štejejo število uspešnih/neuspešnih zahtev in časovnih omejitev. Tako merimo uptime.
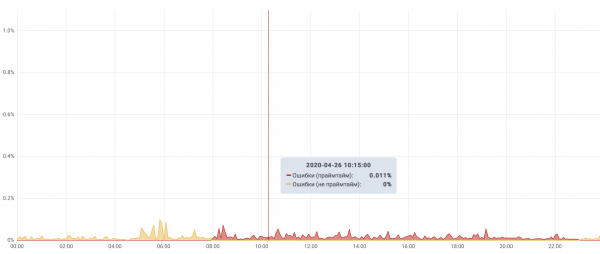
Recimo, da smo ugotovili, da obstaja vrsta super pomembnih odsekov spletne strani, ki so odgovorni za glavno storitev — iskanje in oddajo oglasov. Če število zahtev, ki so se končale z napako, presega 1%, je to kritičen incident. Če se v 15 minutah v konicah napak več kot 0,1% — to se prav tako šteje za kritičen incident. Ti kriteriji pokrivajo večji del incidentov, ostali pa presegajo obseg tega članka.
Top najboljših incidentov Ciana
Torej, zagotovo smo se naučili prepoznati dejstvo, da se je incident zgodil.
Zdaj je vsak incident podrobno opisan in odražen v epiki Jira. Mimogrede: za to smo ustanovili poseben projekt, ga poimenovali FAIL — v njem je mogoče ustvariti samo epike.
Če zberemo vse napake v zadnjih nekaj letih, so na vrhu:
- incidenti, povezani z mssql;
- incidenti, povzročeni z zunanjimi dejavniki;
- napake administratorja.
Osredotočili se bomo podrobneje na napake administratorjev, pa tudi na nekatere druge zanimive napake.
Peto mesto — „Postavljamo stvari v DNS“
Bil je turobni torek. Odločili smo se, da bomo uredili DNS-klaster.
Zadali smo si, da prenašamo notranje DNS-strežnike iz bind na powerdns, pri čemer smo za to namenili popolnoma ločene strežnike, na katerih ni nič drugega kot DNS.
Postavili smo po en DNS-strežnik na vsaki lokaciji naših podatkovnih centrov, in prišel je trenutek, da prenesemo domene iz bind v powerdns in preklopimo infrastrukturo na nove strežnike.
V najhujšem trenutku prenosa je iz vseh strežnikov, ki so bili navedeni v lokalnih predpomnilnikih bind na vseh strežnikih, ostal le en, ki je bil v podatkovnem centru v Sankt Peterburgu. Ta DC je prvotno bil deklariran kot nekritičen za nas, a je nenadoma postal enotna točka napake.
Prav v tem obdobju prenosa je odpovedal kanal med Moskvo in Sankt Peterburgom. Dejansko smo ostali brez DNS-a pet minut, dokler ponudnik gostovanja ni odpravil težav.
Zaključki:
Če smo prej zanemarjali zunanje dejavnike med pripravami na delo, pa smo jih zdaj vključili v seznam stvari, na katere se pripravljamo. Zdaj stremimo k temu, da so vsi komponenti rezervirani n-2, na čas dela pa lahko znižamo to raven na n-1.
- Med sestavljanjem akcijskega načrta označite točke, kjer bi lahko storitev odpovedala, in razmislite o scenariju, kjer se vse zgodi 'slabše ne more biti', vnaprej.
- Porazdelite notranje DNS-strežnike po različnih geolokacijah/podatkovnih centrih/rackih/switchih/priključkih.
- Na vsakem strežniku namestite lokalni predpomnilni DNS-strežnik, ki preusmerja poizvedbe na glavne DNS-strežnike, v primeru njegove nedostopnosti pa odgovarja iz predpomnilnika.
Četrto mesto — 'Urejanje v Nginx'
Nekega lepega dne je naša ekipa sklenila, da 'je dovolj, da to prenašamo', in se je začel proces refaktorizacije Nginx konfiguracij. Glavni cilj je bil pripeljati konfiguracije do intuitivne strukture. Prej je bilo vse 'zgodovinsko povsem zmedeno' in ni imelo nobene logike. Zdaj smo vsak server_name prenesli v istoimensko datoteko in porazdelili vse konfiguracije po mapah. Mimogrede — konfiguracija vsebuje 253949 vrstic ali 7836520 znakov in zaseda skoraj 7 megabajtov. Višja raven strukture:
Struktura Nginx
├── access
│   ├── allow.list
...
│   └── whitelist.conf
├── geobase
│   ├── exclude.conf
...
│   └── geo_ip_to_region_id.conf
├── geodb
│   ├── GeoIP.dat
│   ├── GeoIP2-Country.mmdb
│   └── GeoLiteCity.dat
├── inc
│   ├── error.inc
...
│   └── proxy.inc
├── lists.d
│   ├── bot.conf
...
│   ├── dynamic
│   └── geo.conf
├── lua
│   ├── cookie.lua
│   ├── log
│   │   └── log.lua
│   ├── logics
│   │   ├── include.lua
│   │   ├── ...
│   │   └── utils.lua
│   └── prom
│       ├── stats.lua
│       └── stats_prometheus.lua
├── map.d
│   ├── access.conf
│   ├── ..
│   └── zones.conf
├── nginx.conf
├── robots.txt
├── server.d
│   ├── cian.ru
│   │   ├── cian.ru.conf
│   │   ├── ...
│   │   └── my.cian.ru.conf
├── service.d
│   ├── ...
│   └── status.conf
└── upstream.d
    ├── cian-mcs.conf
    ├── ...
    └── wafserver.conf
Значно улучшилось, но в процессе переименования и распределения конфигураций часть из них имела неправильное расширение и не попала в директиву include *.conf. В результате часть хостов оказалась недоступной и возвращала 301 на главную страницу. Поскольку код ответа не был 5xx/4xx, это заметили не сразу, а лишь под утро. После этого мы начали писать тесты для проверки инфраструктурных компонентов.
Zaključki:
- Правильно структурируйте конфигурации (не только nginx) и продумывайте структуру на раннем этапе проекта. Это сделает их более понятными для команды, что, в свою очередь, сократит время на вывод продукта на рынок.
- Для некоторых инфраструктурных компонентов пишите тесты. Например: проверка, что все ключевые server_name отдают правильный статус, плюс тело ответа. Будет достаточно иметь под рукой несколько скриптов, которые проверяют основные функции компонента, чтобы не вспоминать в 3 часа ночи, что еще нужно проверить.
Третье место — «Внезапно закончилось место в Cassandra»
Данные постепенно росли, и все было хорошо до того момента, когда в кластере Cassandra начали падать ремонты больших кейспейсов, потому что на них не может правильно сработать компакция.
В один ненастный день кластер почти превратился в тыкву, а именно:
- оставалось около 20% места по кластеру;
- полноценно добавить узлы невозможно, так как не проходит очистка после добавления узла из-за нехватки места на разделах;
- производительность постепенно снижается, так как не работает компакция;
- кластер работает в аварийном режиме.
Izlaz — dodali smo još 5 čvorova bez čišćenja, nakon čega smo počeli planski povlačiti iz klastera i ponovo uvođenje, kao prazni čvorovi, na kojima je ponestalo prostora. Vremena je potrošeno mnogo više nego što bismo želeli. Postojala je opasnost od delimične ili potpune nedostupnosti klastera.
Zaključki:
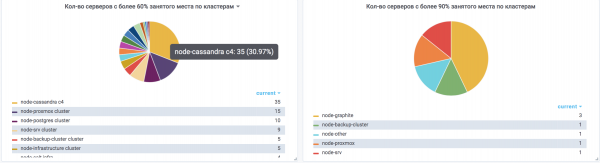
- Na svim serverima Cassandra ne bi trebalo da bude zauzeto više od 60% prostora na svakom odeljenju.
- Zadovoljstvo opterećenje CPU-a ne bi smelo da prelazi 50%.
- Ne treba zanemarivati planiranje kapaciteta, i ono se mora razmišljati za svaki komponent, uzimajući u obzir njegovu specifičnost.
- Što više čvorova u klasteru — to bolje. Serveri koji sadrže mali obim podataka brže se prebacuju, a takav klaster je lakše oživeti.
Drugo mesto — "Podaci su nestali iz Consul key-value skladišta"
Za otkrivanje usluga mi, kao i mnogi, koristimo Consul. No, naše key-value se koristi i za blue-green izbacivanje monolita. Tu se čuvaju informacije o aktivnim i neaktivnim upstream-ima, koje se menjaju tokom deploja. Zbog toga je napisan deploy servis koji je komunicirao sa KV-om. U nekom trenutku podaci su nestali iz KV-a. Oporavili smo se iz sećanja, ali uz niz grešaka. Kao posledica — tokom izbacivanja opterećenje na upstream-ima se raspodelilo nejednako, a dobili smo mnogo grešaka 502 zbog preopterećenja backend-a po CPU-u. Na kraju smo prešli sa Consul KV na Postgres, odakle ih već nije lako obrisati.
Zaključki:
- Usluge bez ikakve autorizacije ne bi trebale sadržavati kritične podatke za rad sajta. Na primer, ako nema autorizacije u ES — najbolje bi bilo zabraniti pristup na mrežnom nivou svuda gde nije potreban, ostaviti samo neophodne, kao i omogućiti action.destructive_requires_name: true.
- Isprobajte mehanizam rezervnog kopiranja i oporavka unapred. Na primer, unapred napravite skript (na primer, na Python-u) koji može i da pravi rezervne kopije i da obnavlja.
Prvo mesto — "Kapetan ne očiglednost"
Nekje smo opazili nepravilno porazdelitev obremenitve na upstream nginx, ko je v ozadju delovalo več kot 10 strežnikov. Ker je round-robin usmerjal zahtevke od prvega do zadnjega upstream po vrsti, in je vsak reload nginx začel znova, so prve upstream vedno prejele več zahtevkov kot ostale. Posledično so delovale počasneje in celotna stran je trpela. To je postajalo vse bolj očitno, ko se je povečevalo število prometa. Preprosto osvežitev nginx, da bi vključili random, ni uspela — treba je bilo predelati kup lua kode, ki ni delovala na verziji 1.15 (takrat). Tako smo morali patchati naš nginx 1.14.2 in vanj vgraditi podporo za random. To je rešilo problem. Ta napaka zmaga v kategoriji 'kapitan očitnost'.
Zaključki:
Bilo je zelo zanimivo in vznemirljivo raziskovati to napako).
- Postavite monitoring tako, da bo pomagal hitro odkrivati podobne fluktuacije. Na primer, lahko uporabite ELK za spremljanje rps za vsak backend vsakega upstreama in spremljate njihov čas odziva z vidika nginx. V tem primeru nam je to pomagalo odkriti problem.
Večji del napak bi bilo mogoče preprečiti z bolj skrbnim pristopom k temu, kar počnete. Vedno se morate spomniti na Murphyjev zakon: Vsaka stvar, ki lahko gre narobe, bo šla narobe, in graditi komponente, ki se ravnajo po njem.
Izvor: habr.com
