

V naših projektih uporabljamo mikrostoritveno arhitekturo. Ko pride do ožjih grl pri zmogljivosti, je veliko časa porabljenega za spremljanje in analizo logov. Pri beleženju časovnih oznak posameznih operacij v log datoteko je običajno težko razumeti, kaj je povzročilo klic teh operacij, slediti zaporedju dejanj ali časovnemu odklonu ene operacije glede na drugo v različnih storitvah.
Za zmanjšanje ročnega dela smo se odločili uporabiti eno izmed orodij za sledenje. O tem, kako in za kaj se lahko uporablja sledenje ter kako smo to počeli mi, bo govora v tem članku.
Katere težave lahko rešimo s pomočjo sledenja
- Najti ožja grla v zmogljivosti tako znotraj ene storitve kot v celotnem drevesu izvajanja med vsemi sodelujočimi storitvami. Na primer:
- Mnogi kratki zaporedni klici med storitvami, na primer, za geokodiranje ali za dostop do baze podatkov.
- Dolga čakanja na vhodno-izhodne operacije, na primer, prenos podatkov preko omrežja ali branje iz diska.
- Dolgo analiziranje podatkov.
- Dolge operacije, ki zahtevajo CPU.
- Odseki kode, ki niso potrebni za pridobitev končnega rezultata in jih je mogoče odstraniti ali pa jih zagnati odloženo.
- Jasno razumeti, v kakšnem zaporedju se kaj kliče in kaj se zgodi, ko se operacija izvaja.

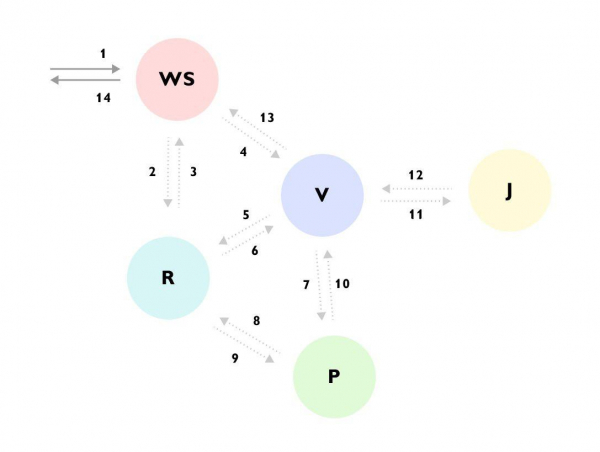
Vidimo, da je, na primer, zahteva prišla v storitev WS -> storitev WS je dopolnila podatke preko storitve R -> nato je poslala zahtevo v storitev V -> storitev V je naložila veliko podatkov iz storitve R -> obiskala storitev P -> storitev P je še enkrat obiskala storitev R -> storitev V je ignorirala rezultat in šla v storitev J -> in šele nato vrnila odgovor v storitev WS, medtem pa še naprej v ozadju izračunava nekaj drugega.
Brez takšnega sledenja ali podrobne dokumentacije za celoten proces je zelo težko razumeti, kaj se dogaja, ko prvič pogledamo kodo, pa tudi koda je razmetana po različnih storitvah in skrita za kupom binov in vmesnikov. - Zbiranje informacij o drevesu izvajanja za nadaljnjo odloženo analizo. V vsakem koraku izvajanja lahko v sleditev dodate informacije, ki so na voljo v tem koraku, in se nato razjasnite, kateri vhodni podatki so povzročili takšno situacijo. Na primer:
- ID uporabnika
- Pravna pooblastila
- Vrsta izbrane metode
- Dnevnik ali napaka pri izvajanju
- Pretvorba zapisnika u podskup metrika i daljnja analiza u obliku metrika.
Što može zabilježiti praćenje. Span
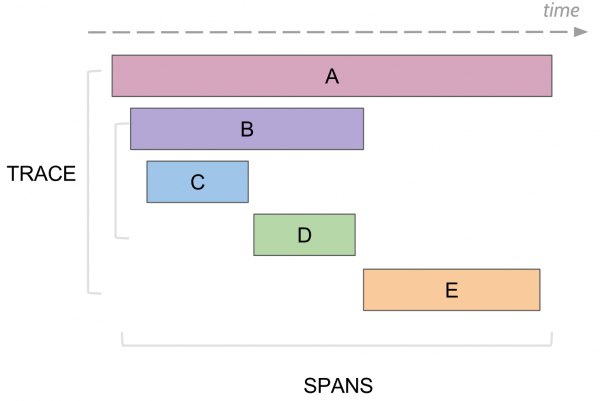
U praćenju postoji pojam spana, što je analog jedan logu u konzoli. Span ima:
- Naziv, obično naziv metode koja je izvršena
- Naziv servisa u kojem je span generiran
- Vlastiti jedinstveni ID
- Neka meta informacija u obliku key/value koja je zabilježena u njemu. Na primjer, parametri metode ili je li metoda završila greškom ili ne
- Vrijeme početka i završetka izvršavanja ovog spana
- ID roditeljskog spana
Svaki span se šalje u kolektor spanova za pohranu u bazu za kasnije pregledavanje čim završi svoje izvršavanje. Moguće je izgraditi stablo svih spanova povezujući ih prema ID-u roditelja. Tijekom analize može se pronaći, na primjer, svi spanovi u nekom servisu koji su trajali duže od određenog vremena. Zatim, prelaskom na određeni span, vidjeti cijelo stablo iznad i ispod tog spana.
Opentrace, Jaeger i kako smo to implementirali za svoje projekte
Postoji opći standard , koji opisuje kako i što treba prikupljati, ne povezujući praćenje s određenom implementacijom u bilo kojem jeziku. Na primjer, u Javi se sav rad sa tragovima obavlja putem zajedničkog API-ja Opentrace, a ispod njega može se skrivati, na primjer, Jaeger ili prazna defaultna implementacija koja ništa ne radi.
Koristimo kao implementaciju Opentrace. Sastoji se od nekoliko komponenti:
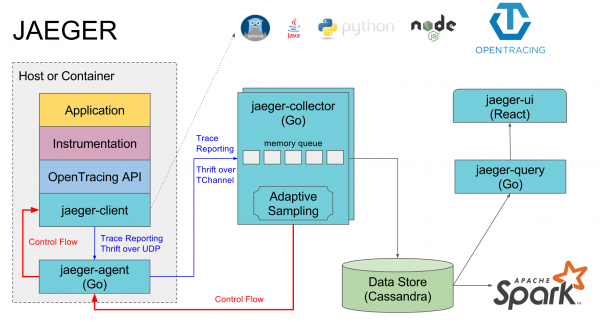
- Jaeger-agent — lokalni agent koji obično stoji na svakoj mašini i u njega se logiraju servisi na lokalni defaultni port. Ako agenta nema, tada su svi tragovi svih servisa na toj mašini obično isključeni
- Jaeger-collector — u njega svi agenti šalju prikupljene tragove, a on ih pohranjuje u odabranu bazu podataka
- Baza podataka — preferiraju cassandra, ali mi koristimo elasticsearch, postoji implementacija još za nekoliko drugih baza podataka i in memory implementacija koja ništa ne pohranjuje na disk
- Jaeger-query — to je servis koji pristupa bazi podataka i vraća već prikupljene tragove za analizu
- Jaeger-ui — to je web sučelje za pretraživanje i pregledavanje tragova, pristupa jaeger-query
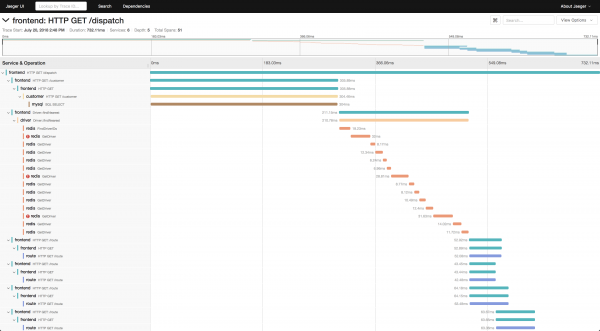
Određenom komponentom može se smatrati implementacija opentrace Jaeger za određene jezike, putem koje se spanovi šalju u jaeger-agent.
se zmanjšuje na implementacijo vmesnika io.opentracing.Tracer, po katerem bodo vsi sledovi skozi njega oddani resničnemu agentu.
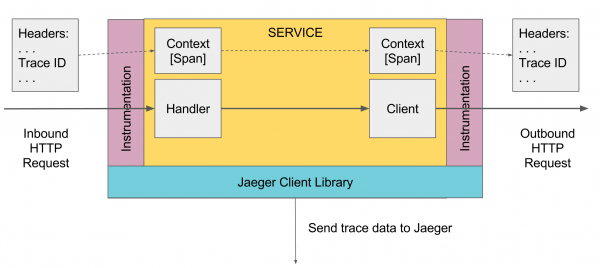
Prav tako je mogoče povezati komponente Springa in implementacijo Jaegerja ki bo samodejno konfigurirala sledenje vsega, kar poteka skozi te komponente, na primer http poizvedbe v kontrolerje, poizvedbe v bazo podatkov preko jdbc itd.
Logiranje sledov v Javi
Nekje na najvišji ravni mora biti ustvarjen prvi Span, to lahko izvede avtomatsko na primer kontroler Springa ob prejemu poizvedbe, ali ročno, če tak ni na voljo. Nato se prenese skozi Scope nižje. Če želi kakšna metoda spodaj dodati Span, vzame iz Scope trenutni activeSpan, ustvari nov Span in pove, da je njegov nadrejeni prejeti activeSpan, in naredi nov Span aktiven. Pri klicanju zunanjih storitev jim posredujejo trenutni aktivni span, te storitve pa ustvarijo nove spane, ki so povezani s tem spanom.
Vsa dela potekajo prek instance Tracer, pridobiti ga je mogoče preko mehanizma DI ali GlobalTracer.get() kot globalno spremenljivko, če mehanizem DI ne deluje. Po privzetku, če tracer ni bil inicializiran, se vrne NoopTracer, ki nič ne počne.
Nato se iz tracerja preko ScopeManagerja pridobi trenutni scope, ustvari se nov scope iz trenutnega s povezovanjem novega spana, v nadaljevanju pa se zapre ustvarjeni Scope, ki zapre ustvarjeni span in vrne prejšnji Scope v aktivno stanje. Scope je povezan s tokom, zato pri večnitnem programiranju ne smemo pozabiti prenesti aktivnega spana v drug tok, za nadaljnjo aktivacijo Scope drugega toka s povezovanjem k temu spanu.
io.opentracing.Tracer tracer = ...; // GlobalTracer.get()

void DoSmth () {
   try (Scope scope = tracer.buildSpan("DoSmth").startActive(true)) {
      ...
   }
}
void DoOther () {
    Span span = tracer.buildSpan("someWork").start();
    try (Scope scope = tracer.scopeManager().activate(span, false)) {
        // Naredite stvari.
    } catch(Exception ex) {
        Tags.ERROR.set(span, true);
        span.log(Map.of(Fields.EVENT, "error", Fields.ERROR_OBJECT, ex, Fields.MESSAGE, ex.getMessage()));
    } finally {
        span.finish();
    }
}

void DoAsync () {
    try (Scope scope = tracer.buildSpan("ServiceHandlerSpan").startActive(false)) {
        ...
        final Span span = scope.span();
        doAsyncWork(() -> {
            // KORAK 2 ZGORNJE: ponastavite Span v povratnem klicu, ko bo
            // startActive() moralo dokončati.
            try (Scope scope = tracer.scopeManager().activate(span, false)) {
                ...
            }
        });
    }
}
Za večnotočnega programiranja obstajajo TracedExecutorService in podobne obloge, ki samodejno prenesejo trenutni span v nit pri zagonu asinhronih nalog:
private ExecutorService executor = new TracedExecutorService(
    Executors.newFixedThreadPool(10), GlobalTracer.get()
);
Za zunanje http poizvedbe obstaja
HttpClient httpClient = new TracingHttpClientBuilder().build();Problemi, s katerimi smo se srečali
- Bini in DI ne delujejo vedno, če se tracer ne uporablja v storitvi ali komponenti, zato Tracer morda ne deluje in morate uporabiti GlobalTracer.get().
- Annotations ne delujejo, če to ni komponenta ali storitev, ali če se klic metode zgodi iz sosednje metode istega razreda. Treba je biti previden, preveriti, kaj deluje, in uporabljati ročno ustvarjanje trace, če @Traced ne deluje. Prav tako lahko dodate dodatni prevajalnik za java anotacije, takrat bi morale delovati povsod.
- V starih spring in spring boot ne deluje samodejna konfiguracija opentracing spring cloud zaradi napak v DI, zato, če želite, da samodejno delujejo trace v komponentah springa, lahko to storite po analogiji z
- V groovy ne deluje try with resources, nujno je potrebno uporabiti try finally.
- Vsaka storitev mora imeti svoj spring.application.name, pod katerim bodo beleženi trace. Pri čemer je ločeno ime za produkcijo in testiranje, da se ne mešata skupaj.
- Če uporabite GlobalTracer in tomcat, potem imajo vse storitve, zagnane v tem tomcat, en GlobalTracer, zato bo na vseh ime storitve enako.
- Pri dodajanju trace v metodo morate biti prepričani, da se ne kliče v zanki mnogokrat. Treba je dodati en skupni trace za vse klice, ki bo beležil skupni čas delovanja. V nasprotnem primeru bo ustvarjala odvečno obremenitev.
- Enkrat smo v jaeger-ui opravili prevelike poizvedbe za veliko število trace in ker nismo čakali na odgovor, smo jih izvedli še enkrat. Na koncu je jaeger-query začel porabiti veliko pomnilnika in upočasnil elastic. Pomagalo je z reinicializacijo jaeger-query.
Vzorec, shranjevanje in ogled trace
Obstajajo trije tipi :
- Const, ki pošilja in shranjuje vse trace.
- Probabilistic, ki filtrira trace z določeno verjetnostjo.
- Ratelimiting, ki omejuje število sledi na sekundo. Te parametre je mogoče nastaviti na odjemalcu, ali na jaeger-agentu ali v kolektorju. Trenutno imamo v kupcih uporabljeno const 1, saj ni veliko zahtevkov, vendar ti trajajo dolgo. V prihodnosti, če bo to preobremenilo sistem, lahko omejimo.
Če uporabljate Cassandro, ta privzeto hrani sledi le za dva dni. Pri nas se uporablja in sledi se hranijo za ves čas in se ne brišejo. Za vsak dan se ustvari ločen indeks, na primer jaeger-service-2019-03-04. V prihodnosti bo treba nastaviti avtomatsko čiščenje starih sledov.
Da bi si ogledali sledi, morate:
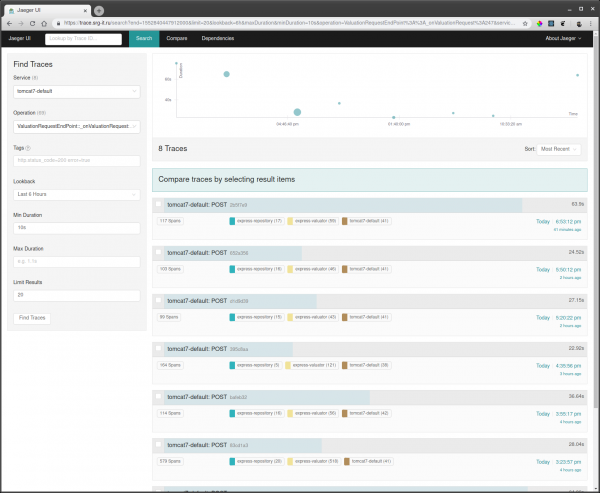
- Izbrati storitev, po kateri želite filtrirati sledi, na primer tomcat7-default za storitev, ki teče v Tomcatu in ne more imeti svojega imena.
- Nato izberite operacijo, časovno obdobje in minimalni čas operacije, na primer od 10 sekund, da vzamete le dolge izvajanja.

- Pojdite v eno od sledi in poglejte, kaj je tam povzročalo težave.

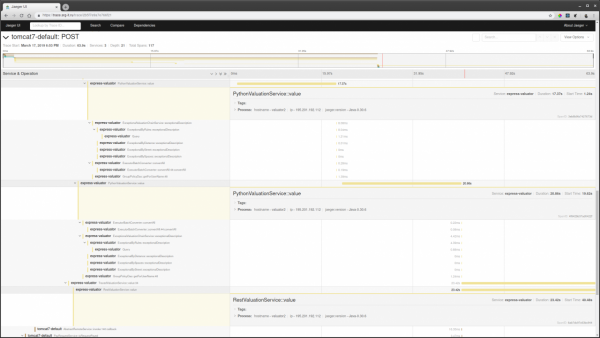
Prav tako, če je poznan kakšen id zahtevka, lahko najdete sled po tem id-ju preko iskanja po oznakah, če je ta id beležen v sledi.
Dokumentacija
- Dokumentacija OpenTracing
- Dokumentacija Jaeger
- Povezava Jaeger java
- Povezava spring OpenTracing
Članki
- Jaeger OpenTracing in mikroservisi v realnem projektu na PHP in Golang
- Evolving Distributed Tracing at Uber Engineering
- Zaženi Jaeger Agent na golih strežnikih
Video
- Kako smo uporabili Jaeger in Prometheus za zagotavljanje izjemno hitrih uporabniških poizvedb — Bryan Boreham
- Intro: Jaeger — Yuri Shkuro, Uber & Pavol Loffay, Red Hat
- Serghei Iakovlev, "Majhna zgodba o veliki zmagi: OpenTracing, AWS in Jaeger"
Izvor: habr.com
