

Za popolno obvladovanje Kubernetes je potrebno poznati različne načine za skaliranje virov v klastru: po , je to ena od glavnih nalog Kubernetes. Pripravili smo visokoleten pregled mehanizmov horizontalnega in vertikalnega avtomatskega skaliranja ter spreminjanja velikosti klastrov, skupaj s priporočili, kako jih učinkovito uporabljati.
Članek je prevedla ekipa, ki je implementirala avtomatsko skaliranje v .
Zakaj je pomembno razmisliti o skaliranju
— orodje za upravljanje virov in orkestracijo. Seveda ni slabo, če se poglobimo v odlične funkcije uvedbe, spremljanja in upravljanja podov (modul pod je skupina kontejnerjev, ki se zaženejo kot odgovor na zahtevo).
Vendar pa bi se morali zamisliti tudi o takšnih vprašanjih:
- Kako skalirati module in aplikacije?
- Kako ohranjati konteinerje v delovnem in učinkovitm stanju?
- Kako se odzvati na stalne spremembe v kodi in obremenitvah uporabnikov?
Nastavitev klastrov Kubernetes za uravnoteženje virov in zmogljivosti je lahko zapletena naloga, ki zahteva strokovno znanje o notranjem delovanju Kubernetes. Obremenitev vaših aplikacij ali storitev se lahko spreminja čez dan ali celo v eni uri, zato je uravnoteženje bolje razumeti kot nenehen proces.
Ravni avtomatskega skaliranja Kubernetes
Učinkovito avtomatsko skaliranje zahteva usklajevanje med dvema ravnema:
- Raven podov, ki vključuje horizontalno (Horizontal Pod Autoscaler, HPA) in vertikalno avtomatsko skaliranje (Vertical Pod Autoscaler, VPA). To je skaliranje obstoječih virov za vaše kontejnerje.
- Raven klasterja, ki jo upravlja sistem avtomatskega skaliranja klasterja (Cluster Autoscaler, CA), ki povečuje ali zmanjšuje število vozlišč v klasterju.
Modul horizontalnega avtomatskega skaliranja (HPA)
Kot izhaja iz imena, HPA skalira število replik podov. Kot sprožilce za spremembo števila replik večina devopsov uporablja obremenitev procesorja in pomnilnika. Vendar pa je mogoče sistem skalirati tudi na podlagi , njih ali celo .
Visokoleten pregled delovanja HPA:
- HPA nepretržno preverja vrednosti meritev, ki so bile določene ob namestitvi, s privzetim intervalom 30 sekund.
- HPA poskuša povečati število modulov, če je dosežena določena meja.
- HPA posodobi število replik znotraj nadzornika za uvedbo/replikacijo.
- Nadzornik za uvedbo/replikacijo nato uvede vse potrebne dodatne module.
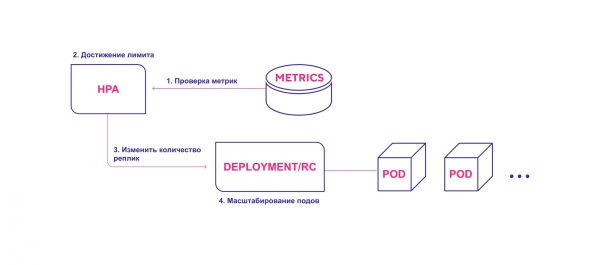
HPA sproži postopek uvajanja modulov, ko doseže mejno vrednost meritev.
Pri uporabi HPA upoštevajte naslednje:
- Privzeti interval preverjanja HPA je 30 sekund. Določa ga zastavica. horizontal-pod-autoscaler-sync-period v nadzorniku kontrolerja.
- Privzeta relativna napaka znaša 10%.
- Po zadnjem povečanju števila modulov HPA pričakuje stabilizacijo meritev v treh minutah. Ta interval nastavi zastavica. horizontal-pod-autoscaler-upscale-delay.
- Po zadnjem zmanjšanju števila modulov HPA pričakuje stabilizacijo v petih minutah. Ta interval nastavi zastavica. horizontal-pod-autoscaler-downscale-delay.
- HPA najbolje deluje z objekti uvajanja, ne pa z nadzorniki replik. Horizontalno avtomatsko skaliranje ni združljivo s postopnim posodabljanjem (rolling update), ki neposredno manipulira z nadzorniki replik. Pri uvajanju je število replik neposredno odvisno od objektov uvajanja.
Vertikalno avtomatsko skaliranje pod-ov
Vertikalno avtomatsko skaliranje (VPA) dodeljuje več (ali manj) procesorskega časa ali pomnilnika obstoječim pod-om. Primerno je za pod-e s shranjenim stanjem (stateful) ali brez njega (stateless), vendar je predvsem namenjeno storitvam s shranjenim stanjem. Vendar pa lahko uporabite VPA tudi za module brez shranjenega stanja, če potrebujete avtomatsko prilagajanje obsega prvotno dodeljenih virov.
VPA tudi reagira na dogodke OOM (out of memory, nedovoljeno pomnilnika). Za spremembo procesorskega časa in količine pomnilnika je potrebna ponovna nastavitev pod-ov. Pri ponovni nastavitvi VPA spoštuje proračun porazdelitve (), da zagotovi minimalno potrebno število modulov.
Lahko nastavite minimalne in maksimalne vire za vsak modul. Tako lahko omejite največji dodeljeni pomnilnik na 8 GB. To je koristno, če trenutni vozli ne morejo dodeliti več kot 8 GB pomnilnika na kontejner. Podrobne specifikacije in mehanizmi delovanja so opisani v .
Poleg tega ima VPA zanimivo funkcijo priporočevalca (VPA Recommender). Ta spremlja uporabo virov in dogodke OOM vseh modulov, da predlaga nove vrednosti pomnilnika in procesorskega časa na podlagi inteligentnega algoritma, ki upošteva zgodovinske metrike. Na voljo je tudi API, ki sprejme deskriptor pod in vrne predlagane vrednosti virov.
Pomembno je omeniti, da VPA Recommender ne spremlja 'meje' virov. To lahko privede do tega, da modul monopolizira vire v vozlih. Bolje je nastaviti mejno vrednost na ravni prostora imen, da se izognete velikemu poraba pomnilnika ali procesorskega časa.
Visok nivo delovanja VPA:
- VPA neprekinjeno preverja vrednosti metrik, določenih ob namestitvi, z privzetim intervalom 10 sekund.
- Če je dosežena določena meja, VPA poskuša spremeniti dodeljeno količino virov.
- VPA posodobi količino virov znotraj nadzora razporeditve/repliciranja.
- Ob ponovnem zagonu modulov se vsi novi viri uporabljajo za ustvarjene instance.
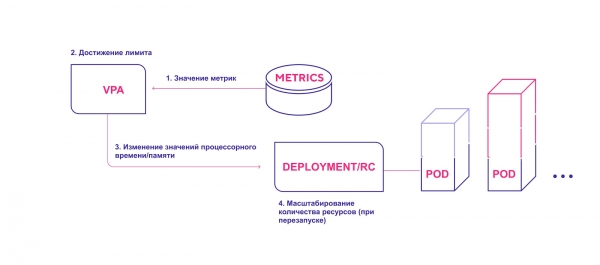
VPA doda potrebno količino virov.
Pri uporabi VPA upoštevajte naslednje točke:
- Spreminjanje velikosti zahteva obvezen ponovni zagon pod’a. To je potrebno za preprečevanje nestabilnega delovanja po spremembah. Za zanesljivost se moduli ponovno zagonijo in porazdelijo po vozlih na podlagi novih dodeljenih virov.
- VPA in HPA trenutno nista združljiva in ne moreta delovati na enakih pod’ih. Če v enem klastru uporabljate oba mehanizma za spremljanje velikosti, poskrbite, da nastavitve ne omogočijo aktiviranja na enakih objektih.
- VPA prilagaja zahteve kontejnerjev za vire izključno na podlagi pretekle in trenutne uporabe. Ne postavlja omejitev uporabe virov. Lahko pride do težav z nepravilnim delovanjem aplikacij, ki bodo začele zavzemati vse več virov, kar bo privedlo do tega, da Kubernetes ugasne ta pod.
- VPA je še v zgodnji fazi razvoja. Bodite pripravljeni, da bo v bližnji prihodnosti sistem lahko doživel nekatere spremembe. Lahko preberete o in . Tako je v načrtih uvesti skupno delovanje VPA in HPA ter implementacijo modulov skupaj s politiko vertikalnega samodejnega prilagajanja zanje (na primer, posebna oznaka 'requires VPA').
Samodejno prilagajanje klasterja Kubernetes
Samodejno prilagajanje klasterja (Cluster Autoscaler, CA) spreminja število vozlišč glede na število pričakovanih modulov pod. Sistem redno preverja prisotnost pričakovanih modulov — in povečuje velikost klasterja, če so potrebni dodatni viri in če klaster ne presega nastavljenih omejitev. CA sodeluje s ponudnikom oblačnih storitev, zahteva dodatna vozlišča ali sprosti neaktivna. Prva javna različica CA je bila predstavljena v Kubernetes 1.8.
Visokotanjna shema delovanja CA:
- CA preverja prisotnost modulov v čakanju v privzetnem intervalu 10 sekund.
- Če so en ali več modulov v čakanju zaradi pomanjkanja razpoložljivih virov v klasterju za njihovo razporeditev, poskuša pripraviti eno ali več dodatnih vozlišč.
- Ko ponudnik oblačnih storitev dodeli potrebno vozlišče, se le to pridruži klasterju in je pripravljeno za obravnavo modulov pod.
- Kubernetesov načrtovalnik razporedi pričakovane module na novo vozlišče. Če nekateri moduli po tem še vedno ostanejo v čakanju, se proces ponovi — in v klaster dodajo nova vozlišča.
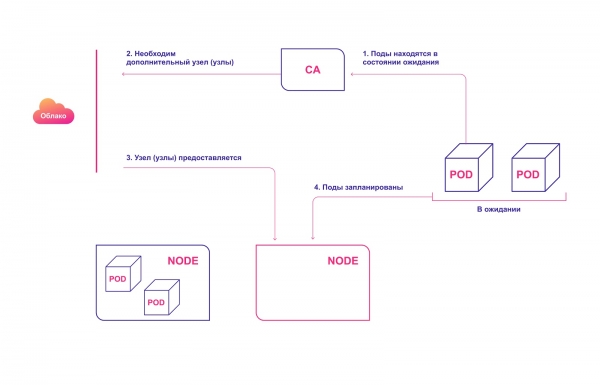
Samodejno dodeljevanje vozlišč klasterja v oblaku
Upoštevajte naslednje pri uporabi CA:
- CA zagotavlja, da imajo vsi moduli v klasterju prostor za zagon, ne glede na stopnjo obremenitve procesorja. Poleg tega poskuša zagotoviti, da v klasterju ni nepotrebnih vozlišč.
- CA registrira potrebo po skaliranju približno v 30 sekundah.
- Potem ko vozlišče postane nepotrebno, CA privzeto čaka 10 minut, preden skalira sistem.
- V sistemu za avtomatsko skaliranje obstaja koncept razširjevalcev (expanders). To so različne strategije za izbiro skupine vozlišč, v katero bodo dodana nova.
- Odgovorno uporabite možnost cluster-autoscaler.kubernetes.io/safe-to-evict (true). Če je nastavljeno veliko podov ali če so mnogi od njih razpršeni po vseh vozliščih, boste v veliki meri izgubili možnost zmanjšanja velikosti klasterja.
- Iskoristite , da preprečite odstranitev podov, zaradi česar lahko del vašega aplikacije popolnoma preneha delovati.
Kako sisteme za avtomatsko skaliranje Kubernetes sodelujejo med seboj
Za popolno harmonijo je treba uporabiti avtomatsko skaliranje tako na ravni podov (HPA/VPA) kot na ravni klasterja. Razmeroma preprosto med seboj sodelujejo:
- HPA ali VPA posodobi replikacije podov ali vire, dodeljene obstoječim podom.
- Če za načrtovano skaliranje primanjkuje vozlišč, CA zazna, da so pody v stanju čakanja.
- CA dodeli nova vozlišča.
- Moduli so porazdeljeni po novih vozliščih.
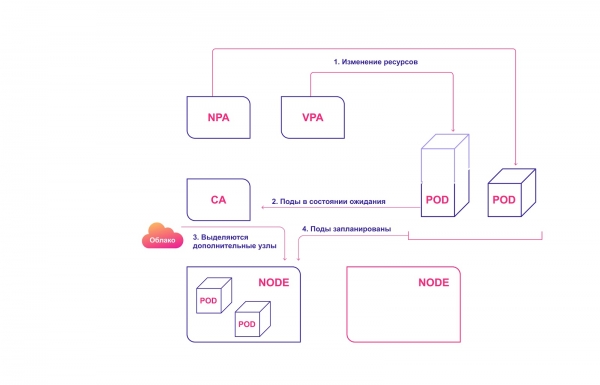
Skupni sistem sistemov za skaliranje Kubernetes
Tipične napake pri avtomatskem skaliranju Kubernetes
Obstaja več tipičnih težav, s katerimi se devops srečuje, ko poskuša uporabiti avtomatsko skaliranje.
HPA in VPA sta odvisna od metrik in nekaterih zgodovinskih podatkov. Če je dodeljenih premalo virov, se moduli zložijo in ne morejo ustvarjati metrik. V tem primeru avtomatsko skaliranje nikoli ne bo uspešno.
Sama operacija skaliranja je občutljiva na čas. Želimo, da se moduli in klaster hitro skalirajo — preden uporabniki opazijo kakršne koli težave in okvare. Zato je treba upoštevati povprečni čas skaliranja podov in klasterja.
Idealni scenarij je 4 minute:
- 30 sekund. Posodobitev ciljanih metrik: 30−60 sekund.
- 30 sekund. HPA preverja vrednosti metrik: 30 sekund.
- Manj kot 2 sekundi. Moduli pod so ustvarjeni in prehajajo v stanje čakanja: 1 sekunda.
- Manj kot 2 sekundi. CA vidi čakajoče module in pošilja klice za pripravo vozlišč: 1 sekunda.
- 3 minute. Oblačni provajder dodeljuje čvorove. K8s čeka da budu spremni: do 10 minuta (zavisno od nekoliko faktora).
Najgori (realniji) scenario — 12 minuta:
- 30 sekundi. Ažuriranje ciljanih metrika.
- 30 sekundi. HPA proverava vrednosti metrika.
- Manje od 2 sekunde. Pod moduli su kreirani i prelaze u stanje čekanja.
- Manje od 2 sekunde. CA vidi čekajuće module i šalje pozive za pripremu čvorova.
- 10 minuta. Oblačni provajder dodeljuje čvorove. K8s čeka da budu spremni. Vreme čekanja zavisi od nekoliko faktora, kao što su kašnjenje provajdera, kašnjenje operativnog sistema, rad pomoćnih alata.
Ne mešajte mehanizme skaliranja oblačnih provajdera sa našom CA. Potonja radi unutar Kubernetes klastera, dok mehanizam oblačnog provajdera funkcioniše na osnovu raspodela čvorova. On ne zna šta se dešava sa vašim podovima ili aplikacijom. Ove sisteme rade paralelno.
Kako upravljati skaliranjem u Kubernetesu
- Kubernetes je alat za upravljanje resursima i orkestraciju. Operacije upravljanja podovima i resursima klastera su ključna tačka u učenju Kubernetes-a.
- Savladajte logiku skalabilnosti podova uz HPA i VPA.
- CA treba koristiti samo ako dobro razumete potrebe svojih podova i kontejnera.
- Za optimalnu konfiguraciju klastera potrebno je razumeti kako različiti sistemi skaliranja rade zajedno.
- Pri proceni vremena skaliranja imajte u vidu najgori i najbolji scenario.
Izvor: habr.com
