

Verjetno danes nikogar ne skrbi, zakaj je treba zbirati meritve storitev. Naslednji logičen korak je nastaviti obveščanje o zbranih meritvah, ki vas bo obveščalo o kakršnih koli odstopanjih v podatkih na vam prijazne kanale (e-pošta, Slack, Telegram). V storitvi za spletno rezervacijo hotelov vse meritve naših storitev gredo v InfluxDB in se prikazujejo v Grafani, tam je tudi nastavljeno osnovno obveščanje. Za naloge, kot je 'moramo izračunati nekaj in to primerjati', uporabljamo Kapacitor.
Kapacitor je del TICK sklada, ki zna obdelovati meritve iz InfluxDB. Lahko poveže več meritev med seboj (join), iz pridobljenih podatkov izračuna nekaj koristnega, zapiše rezultat nazaj v InfluxDB in pošlje obvestilo v Slack/Twitter/e-pošto.
Celoten sklad ima odlično in podrobno , ampak vedno se bodo našle uporabne stvari, ki niso posebej navedene v priročnikih. V tem članku sem se odločil zbrati nekaj takih koristnih, a manj očitnih nasvetov (osnovna sintaksa TICKscript je opisana ) in pokazati, kako jih lahko uporabimo, na primeru reševanja enega izmed naših problemov.
Gremo!
float & int, napake pri izračunih
Popolnoma standardna težava, ki se reši s pretvorbo:
var alert_float = 5.0
var alert_int = 10
data|eval(lambda: float("value") > alert_float OR float("value") < float("alert_int"))
Uporaba default()
Če oznaka/polje ni izpolnjeno, pride do napak pri izračunih:
|default()
        .tag('status', 'empty')
        .field('value', 0)
fill v join (inner vs outer)
Privzeto join zavrže točke, kjer podatki niso prisotni (inner).
Pri fill(‘null’) bo izveden outer join, po katerem je treba narediti default() in zapolniti prazne vrednosti:
var data = res1
    |join(res2)
        .as('res1', 'res2)
        .fill('null')
    |default()
        .field('res1.value', 0.0)
        .field('res2.value', 100.0)
Tukaj je vseeno eno vprašanje. Če bo v zgornjem primeru ena od serij (res1 ali res2) prazna, bo tudi končna serija (data) prazna. Na to temo je objavljenih nekaj zahtevkov na GitHubu (, , ) – čakamo na popravke in malo trpimo.
Uporaba pogojev pri izračunih (if v lambda)
|eval(lambda: if("value" > 0, true, false)
Zadnjih pet minut iz pipelines v obdobju
Na primer, potrebujete primerjati vrednosti zadnjih petih minut s prejšnjim tednom. Lahko vzamete dva paketa podatkov z dvema ločenima batch-oma ali potegnete del podatkov iz večjega obdobja:
|where(lambda: duration((unixNano(now()) - unixNano("time"))/1000, 1u) < 5m)
Alternativa za zadnjih pet minuta može biti korištenje BarrierNode, koji prekida podatke prije navedenog vremena:
|barrier()
        .period(5m)
Primjeri korištenja Go-šablona u porukama
Šabloni odgovaraju formatu iz paketa , u nastavku je nekoliko često viđenih zadataka.
if-else
Održavamo red, ne uzrujavamo ljude suvišnim tekstom:
|alert()
    ...
    .message(
        '{{ if eq .Level "OK" }}Sada je sve u redu{{ else }}Šefe, sve je pokvareno{{end}}'
    )
Dve decimale nakon decimalne tačke u poruci
Poboljšavamo čitljivost poruke:
|alert()
    ...
    .message(
        'sada je vrednost {{ index .Fields "value" | printf "%0.2f" }}'
    )
Razvoj varijabli u poruci
Izbacujemo više informacija u poruku kako bismo odgovorili na pitanje "Zašto viče"?
var warnAlert = 10
  |alert()
    ...
    .message(
       'Danas je vrednost manja od '+string(warnAlert)+'%'
    )
Jedinstveni identifikator alarma
Potrebna stvar kada u podacima postoji više grupa, inače će se generisati samo jedan alarm:
|alert()
      ...
      .id('{{ index .Tags "myname" }}\/{{ index .Tags "myfield" }}')
Prilagođeni handleri
U velikom spisku handlera postoji exec, koji omogućava izvršenje vašeg skripta sa prosleđenim parametrima (stdin) – samo kreativnost!
Jedan od naših prilagođenih je mali Python skript za slanje obaveštenja na Slack.
Najpre smo želeli slati sliku iz Grafane u poruci koja je zaštićena autentifikacijom. Nakon toga – pisati OK u thread prethodnog alarma iz iste grupe, a ne kao zasebnu poruku. Još malo kasnije – dodavati u poruku najčešću grešku u poslednjih X minuta.
Posebna tema – povezivanje sa drugim servisima i bilo kakve radnje inicirane alarmom (samo ako vaš nadzor funkcioniše dovoljno dobro).
Primer opisa handlera, gde je slack_handler.py naš skript:
topic: slack_graph
id: slack_graph.alert
match: level() != INFO AND changed() == TRUE
kind: exec
options:
  prog: \/sbin\/slack_handler.py
  args: ["-c", "CHANNELID", "--graph", "--search"]
Kako debagovati?
Opcija sa ispisom u log
|log()
      .level("error")
      .prefix("something")
Pogledajte (cli): kapacitor -url :9092 logs lvl=error
Opcija sa httpOut
Prikazuje podatke u trenutnom pipeline-u:
|httpOut('something')
Pogledajte (get): :9092\/kapacitor\/v1\/tasks\/task_name\/something
Šema izvršavanja
- Svaki zadatak vraća stablo izvršavanja sa korisnim brojkama u formatu .
- Uzimamo blok .
- Ubacujemo u viewer, .
Gde još možemo dobiti timestamp u influxdb prilikom obrnute upisa
timestamp u influxdb pri obrnutoj upotrebi
Na primer, nastavljamo alert na iznos zahteva po satu (groupBy(1h)) i želimo da zabeležimo nastali alert u influxdb (da bismo lepo prikazali postojanje problema na grafiku u grafani).
influxDBOut() će zapisati vrednost time iz alert-a u timestamp, pa će tačka na grafiku biti zabeležena pre/posle nego što je stigao alert.
Kada je potrebna preciznost: zaobići ćemo ovaj problem pozivom prilagođenog handler-a, koji će zabeležiti podatke u influxdb sa trenutnim timestamp-om.
docker, izgradnja i deploy
Prilikom pokretanja kapacitor može učitati zadatke, šablone i handlere iz direktorijuma koji je naveden u konfiguraciji, u bloku [load].
Za ispravno kreiranje zadatka potrebne su sledeće stvari:
- Naziv fajla – razvija se u id/naziv skripte
- Tip – stream/batch
- dbrp – ključna reč za označavanje iz koje baze + politike skripta radi (dbrp "supplier"."autogen")
Ako u nekom batch-zadatku ne bude linije sa dbrp, ceo servis će odbiti da se pokrene i iskreno će o tome napisati u log.
U chronograf-u, s druge strane, ove linije ne bi trebalo da bude, preko interfejsa se ne prihvata i daje grešku.
Hak prilikom izgradnje kontejnera: Dockerfile izlazi sa -1 ako postoje linije sa //.+dbrp, što će omogućiti odmah da se shvati razlog greške prilikom izgradnje.
join jedan na mnoge
Zadatak-primer: potrebno je uzeti 95. percentil vremena rada servisa za nedelju, uporediti svaku minutu iz poslednjih 10 sa ovom vrednošću.
Nije moguće napraviti join jedan na mnoge, last/mean/median po grupi tačaka pretvara čvor u stream, biće vraćena greška “cannot add child mismatched edges: batch -> stream”.
Rezultat batch-a, kao promenljive u lambda-izrazu, takođe se ne može uložiti.
Postoji opcija da se potrebne cifre iz prvog batch-a sačuvaju u fajl preko udf-a i da se ovaj fajl učita preko sideload.
Šta smo ovim rešavali?
Imamo oko 100 dobavljača hotela, od kojih svaki može imati nekoliko konekcija, nazovimo to kanalom. Ima oko 300 ovih kanala, svaki od kanala može se isključiti. Od svih beleženih metrika pratićemo stopu grešaka (requests i errors).
Zašto ne grafana?
Alerte po greškama, podešene u grafani, imaju nekoliko nedostataka. Neki su kritični, na neke možemo zatvoriti oči, u zavisnosti od situacije.
Grafana ne zna da računa između mera + alerting, a potrebna nam je stopa (requests-errors)/requests.
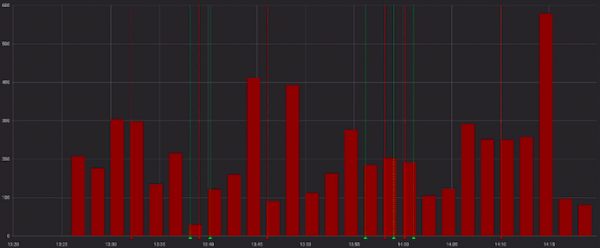
Greške izgledaju zlostavljački:
I manje zlostavljački, ako se gleda sa uspešnim zahtevima:
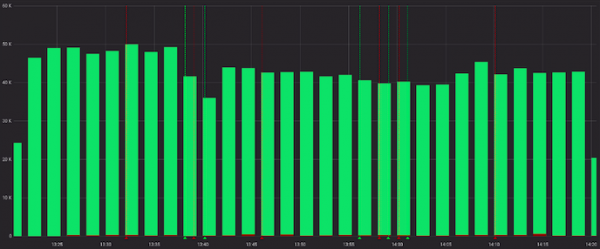
Okej, lahko vnaprej izračunamo oceno storitve do Grafane, kar je v nekaterih primerih sprejemljivo. Vendar ne v našem, saj se za vsak kanal šteje drugačno razmerje kot "normalno", alerti pa delujejo na osnovi statičnih vrednosti (iskanje s člani, spreminjanje, če preveč pogosto opozarja).
To so primeri "normalno" za različne kanale:
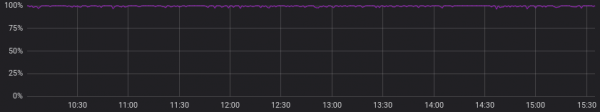
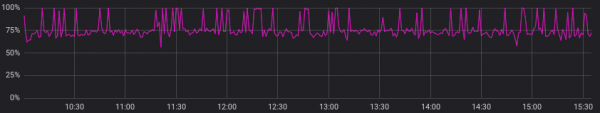
Prezremo prejšnjo točko in predpostavimo, da je"normalna" slika pri vseh ponudnikih podobna. Zdaj je vse v redu in ali lahko obvladamo alerte v Grafani?
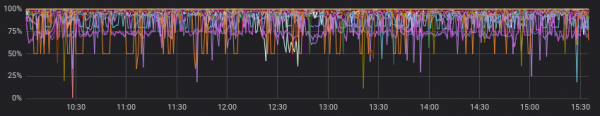
Lahko, a si ne želimo, ker je treba izbrati eno od naslednjih možnosti:
a) narediti več grafov za vsak kanal posebej (in trpeti zaradi njihovega vzdrževanja)
b) pustiti en graf z vsemi kanali (in se izgubiti v barvitih črtah in nastavljenih alertedih)
Kako smo to naredili?
Spet, v dokumentaciji je dober začetni primer (), lahko pokukate ali vzamete za osnovo pri podobnih nalogah.
Kaj smo dosegli:
- združitev dveh serij v nekaj urah, grupiranje po kanalih;
- popolnimo serije po skupinah, če podatkov ni bilo;
- primerjamo mediano zadnjih 10 minut s prejšnjimi podatki;
- kričimo, če kaj odkrijemo;
- zapisujemo izračunane stopnje in nastale alerte v InfluxDB;
- pošiljamo koristno sporočilo v Slack.
Po mojem mnenju, uspelo nam je doseči vse, kar bi želeli doseči na izhodu (in celo nekaj več s prilagojenimi obvodi).
Na github.com si lahko ogledate in pridobljenega skripta.
Primer pridobljenega kode:
dbrp "supplier"."autogen"
var name = 'requests.rate'
var grafana_dash = 'pczpmYZWU/mydashboard'
var grafana_panel = '26'
var period = 8h
var todayPeriod = 10m
var every = 1m
var warnAlert = 15
var warnReset = 5
var reqQuery = 'SELECT sum("count") AS value FROM "supplier"."autogen"."requests"'
var errQuery = 'SELECT sum("count") AS value FROM "supplier"."autogen"."errors"'

var prevErr = batch
 |query(errQuery)
 .period(period)
 .every(every)
 .groupBy(1m, 'channel', 'supplier')

var prevReq = batch
 |query(reqQuery)
 .period(period)
 .every(every)
 .groupBy(1m, 'channel', 'supplier')

var rates = prevReq
 |join(prevErr)
 .as('req', 'err')
 .tolerance(1m)
 .fill('null')
 // заполнение значений нулями, если их не было
 |default()
 .field('err.value', 0.0)
 .field('req.value', 0.0)
 // if в lambda: считаем рейт, только если ошибки были
 |eval(lambda: if("err.value" > 0, 100.0 * (float("req.value") - float("err.value")) / float("req.value"), 100.0))
 .as('rate')

// записываем посчитанные значения в инфлюкс
rates
 |influxDBOut()
 .quiet()
 .create()
 .database('kapacitor')
 .retentionPolicy('autogen')
 .measurement('rates')

// выбираем данные за последние 10 минут, считаем медиану
var todayRate = rates
 |where(lambda: duration((unixNano(now()) - unixNano("time")) / 1000, 1u)  warnAlert)
 .warnReset(lambda: ("prev.median" - "today.median") < warnReset)
 .flapping(0.25, 0.5)
 .stateChangesOnly()
 // собираем в message ссылку на график дашборда графаны
 .message(
 '{{ .Level }}: {{ index .Tags "channel" }} err/req ratio ({{ index .Tags "supplier" }})
{{ if eq .Level "OK" }}It is ok now{{ else }}
'+string(todayPeriod)+' median is {{ index .Fields "today.median" | printf "%0.2f" }}%, by previous '+string(period)+' is {{ index .Fields "prev.median" | printf "%0.2f" }}%{{ end }}
http://grafana.ostrovok.in/d/'+string(grafana_dash)+
'?var-supplier={{ index .Tags "supplier" }}&var-channel={{ index .Tags "channel" }}&panelId='+string(grafana_panel)+'&fullscreen&tz=UTC0300'
 )
 .id('{{ index .Tags "name" }}{{ index .Tags "channel" }}')
 .levelTag('level')
 .messageField('message')
 .durationField('duration')
 .topic('slack_graph')

// "today.median" дублируем как "value", также пишем в инфлюкс остальные филды алерта (keep)
trigger
 |eval(lambda: "today.median")
 .as('value')
 .keep()
 |influxDBOut()
 .quiet()
 .create()
 .database('kapacitor')
 .retentionPolicy('autogen')
 .measurement('alerts')
 .tag('alertName', name)
Kakoy rezul'tat?
Kapacitor превосходно выполняет функции мониторинга и алертинга с множеством группировок, производит дополнительные вычисления по уже записанным метрикам, осуществляет кастомные действия и запускает скрипты (udf).
Порог вхождения не слишком высок – попробуйте его, если Grafana или другие инструменты не полностью удовлетворяют ваши запросы.
Izvor: habr.com

 Russian
 Italian
 German
 Polish
 Estonian
 Albanian
 Bulgarian
 Croatian
 Czech
 Danish
 Dutch
 English
 French
 Hungarian
 Latvian
 Lithuanian
 Norwegian
 Portuguese
 Romanian
 Slovak
 Slovenian
 Spanish
 Swedish