

Kaj bi čutili, če bi en dan poleti podatkovni center z vašo opremo izgledal tako?
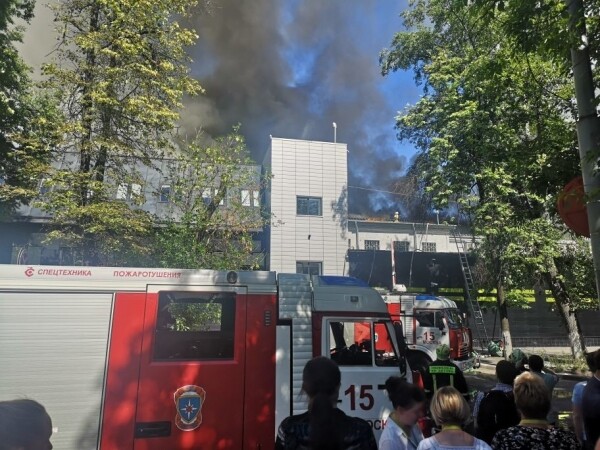
Pozdravljeni vsi! Ime mi je Dmitrij Samsonov, delam kot vodilni sistemski administrator pri "". Na fotografiji je eden od štirih podatkovnih centrov, kjer je nameščena oprema, ki podpira naš projekt. Za temi stenami se nahaja okoli 4.000 enot opreme: strežniki, sistemi za shranjevanje podatkov, omrežna oprema itd. — skoraj ⅓ celotne naše opreme.
Večina strežnikov uporablja Linux. Imamo tudi nekaj deset strežnikov na Windows (MS SQL) — naše dediščine, katere se že vrsto let postopoma odrekamo.
Torej, 5. junija 2019 ob 14:35 je inženir enega naših podatkovnih centrov poročal o požarni alarm.
Zanikanje
14:45. Majhni incidenti z dimom v podatkovnih centrih se zgodijo pogosteje, kot se zdi. Kazalniki znotraj dvoran so bili v normalnih mejah, zato je bila naša prva reakcija razmeroma mirna: uvedli smo prepoved del na produkciji, torej na kakršne koli spremembe konfiguracij, uvajanje novih različic itd., razen del, povezanih s popravili.
Jeza
Ste se kdaj vprašali, ali bi se lahko od gasilcev pozanimali, kje natančno na strehi je prišlo do požara, ali pa bi se sami povzpeli na gorečo streho, da bi ocenili situacijo? Kakšna bi bila stopnja zaupanja v informacije, pridobljene skozi pet ljudi?
14:50. Pojavila se je informacija, da se ogenj bliža sistemu za hlajenje. Ali bo prišel do njega? Dežurni sistemski administrator preusmerja zunanji promet z front tega podatkovnega centra.
Trenutno so vse naše storitve podvojene v treh podatkovnih centrih, uporablja se uravnoteženje na ravni DNS, kar omogoča odstranitev naslovov enega podatkovnega centra iz DNS, s čimer uporabnike zaščitimo pred morebitnimi težavami z dostopom do storitev. V primeru, da so težave v podatkovnem centru že nastale, se ta samodejno umakne iz rotacije. Več informacij lahko preberete tukaj:
Požar na nas zaenkrat ni vplival — ne uporabniki, ne oprema nista utrpela škode. Ali gre za nesrečo? Prvi razdelek dokumenta "Načrt ukrepov v primeru nesreče" opredeljuje pojem "Nesreča", razdelek pa se konča takole:
«Če obstajajo dvomi, ali gre za nesrečo ali ne, potem gre za nesrečo!»
14:53. Dodeljuje se koordinator hitnih situacija.
Koordinator je osoba koja kontroliše komunikaciju između svih učesnika, procenjuje obim nepogode, koristi "Plan akcije u hitnim slučajevima", angažuje potreban osoblje, nadgleda završetak popravki, a najvažnije — delegira sve zadatke. Drugim rečima, to je osoba koja upravlja celokupnim procesom rešavanja problema.
Tržište
15:01. Počinjemo isključivanje servera koji nisu vezani za produkciju.
15:03. Isključujemo sve rezervisane servise na pravi način.
Ovo uključuje ne samo frontove (na koje korisnici već ne ulaze) i njihove pomoćne servise (poslovna logika, keširanja itd.), već i različite baze podataka sa faktorom replikacije 2 ili više (, , , i druge).
15:06. Primljene su informacije da požar preti jednoj od sala podatkovnog centra. U toj sali nemamo opreme, ali to što požar može preći sa krova na sale, značajno menja situaciju.
(Kasnije se ispostavilo da fizičke pretnje za salu nije bilo, jer je hermetički izolovana od krova. Pretnja je bila samo za sistem hlađenja te sale.)
15:07. Dozvoljavamo izvršavanje komandi na serverima u ubrzanom režimu bez dodatnih provera ().
15:08. Temperatura u salama je u granicama normale.
15:12. Zabeležen je porast temperature u salama.
15:13. Više od polovine servera u podatkovnom centru je isključeno. Nastavljamo.
15:16. Doneta je odluka o isključenju sve opreme.
15:21. Počinjemo isključivanje napajanja na stateless serverima bez pravilnog isključivanja aplikacije i operativnog sistema.
15:23. Formira se grupa odgovornih za MS SQL (njih je malo, zavisnost servisa od njih nije velika, ali procedura obnavljanja funkcionalnosti traje duže i složenija je nego, na primer, kod Cassandre).
Depresija
15:25. Primljene su informacije o isključenju napajanja u četiri sale od 16 (br. 6, 7, 8, 9). U salama 7 i 8 se nalazi naša oprema. Još uvek nemamo informacije o dve naše sale (br. 1 i 3).
Obično se pri požarima električna energija odmah isključuje, ali u ovom slučaju, zahvaljujući koordinisanom radu vatrogasaca i tehničkog osoblja podatkovnog centra, isključivanje nije bilo svuda i odmah, već po potrebi.
(Kasneje je bilo ugotovljeno, da napajanje v dvoranah 8 in 9 ni bilo izključeno.)
15:28. Začnemo z obnavljanjem MS SQL baz iz varnostnih kopij v drugih podatkovnih centrih.
Koliko časa bo to trajalo? Ali bo dovolj pasovne širine na celotni poti?
15:37. Zaznana so bila izklopi nekaterih delov omrežja.
Upravljanje in produkcijska omrežja sta fizično izolirana drug od drugega. Če je produkcijska omrežje dostopna, lahko dostopate do strežnika, ustavite aplikacijo in izklopite OS. Če pa ni dostopna, lahko dostopate prek IPMI, ustavite aplikacijo in izklopite OS. Če sta obe omrežji nedostopni, ne morete storiti ničesar. 'Hvala, kapitan!', pomislite.
Morda si mislite: 'Tudi dobro, preveč zmede.'
Dejstvo je, da strežniki tudi brez požara generirajo ogromno toplote. Natančneje, ko imajo hlajenje, ustvarjajo toploto, in ko nimajo, ustvarjajo peklensko vročino, ki v najboljšem primeru stopi del opreme in izklopi druge dele, v najslabšem primeru pa… povzroči požar v dvorani, ki skoraj zagotovo uniči vse.
15:39. Zaznali smo težave z bazo conf.
Baza conf je backend za istoimensko storitev, ki jo uporabljajo vse aplikacije produkcije za hitro spremembo nastavitev. Brez te baze ne moremo upravljati dela portala, vendar pa sam portal lahko deluje.
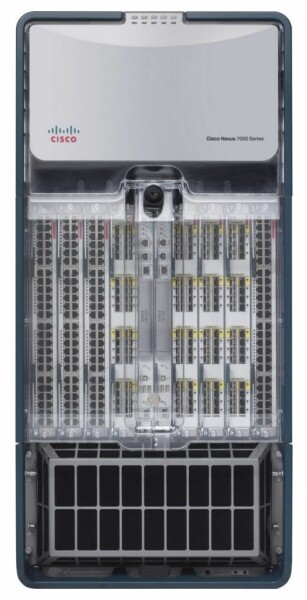
15:41. Temperaturni senzorji na omrežni opremi Core beležijo podatke, blizu najvišjih dovoljenih vrednosti. To je naprava, ki zaseda celoten števec in zagotavlja delovanje vseh omrežij znotraj podatkovnega centra.
15:42. Issue tracker in wiki nista na voljo, preklapljamo na standby.
To ni produkcija, vendar je v primeru okvare dostopnost katere koli bazo znanja lahko ključnega pomena.
15:50. Ena od sistemov za nadzor se je izključila.
Je več njih, in odgovarjajo za različne vidike delovanja storitev. Del njih je nastavljen na samostojno delovanje znotraj vsakega podatkovnega centra (tj. nadzorujejo samo svoj podatkovni center), drugi pa so sestavljeni iz razpršenih komponent, ki brez težav prenesejo izgubo katerega koli podatkovnega centra.
V tem primeru je prenehal delovati , ki deluje v načinu master-standby. Preklopili smo na standby.
Sprejemanje
15:51. Prek IPMI smo izklopili vse strežnike brez pravilnega zaključka dela, razen MS SQL.
Ste pripravljeni na množično upravljanje strežnikov preko IPMI, če bo to potrebno?
Ta trenutek, ko je reševanje opreme v podatkovnem centru na tej točki zaključeno. Vse, kar je bilo mogoče storiti, je bilo storjeno. Nekateri kolegi si lahko privoščijo počitek.
16:13. Prejeli smo informacije, da so se na strehi poškodovale cevi za freon iz klimatskih naprav - to bo odložilo zagon podatkovnega centra po gašenju požara.
16:19. Na podlagi podatkov, prejetih od tehničnega osebja podatkovnega centra, se je prenehalo zviševati temperatura v dvoranah.
17:10. Obnovili smo delovanje baze conf. Zdaj lahko spremenimo nastavitve aplikacij.
Zakaj je to tako pomembno, če je vse odporno na okvare in deluje celo brez enega podatkovnega centra?
Prvič, ni vse odporno na okvare. Obstajajo različne sekundarne storitve, ki trenutno ne preživijo okvare podatkovnega centra dovolj dobro, in so baze v načinu master-standby. Možnost upravljanja nastavitev omogoča, da se vse potrebno stori, da se tudi v težkih razmerah minimizira vpliv posledic okvare na uporabnike.
Drugič, postalo je jasno, da v prihodnjih urah delo podatkovnega centra ne bo popolnoma obnovljeno, zato je bilo treba sprejeti ukrepe, da dolgotrajna nedostopnost replik ne privede do dodatnih težav, kot je prenapolnitev diskov v preostalih podatkovnih centrih.
17:29. Čas za pico! Imamo ljudi, ne robote.
Rehabilitacija
18:02. V dvoranah št. 8 (naša), 9, 10 in 11 se je temperatura stabilizirala. V eni izmed dvoran, ki so še vedno izklopljene (št. 7), se nahaja naša oprema, temperatura pa tam še naprej narašča.
18:31. Dali smo zeleno luč za zagon opreme v dvoranah št. 1 in 3 - te dvorane požar ni prizadel.
Trenutno se začenja zagon strežnikov v dvoranah št. 1, 3, 8, in sicer z najbolj kritičnimi. Preverja se pravilnost delovanja vseh zagnanih storitev. Še vedno so težave z dvorano št. 7.
18:44. Tehnično osebje podatkovnega centra je ugotovilo, da v dvorani št. 7 (kjer stoji le naša oprema) številni strežniki niso izklopljeni. Po naših podatkih tam ostaja vklopljenih 26 strežnikov. Po ponovnem preverjanju ugotovimo 58 strežnikov.
20:18. Tehnično osebje podatkovnega centra prezračuje zrak v dvorani brez klimatskih naprav skozi mobilne zračne cevi, postavljene skozi hodnike.
23:08. Prvi administrator je otišao kući. Netko mora noćas spavati kako bi sutra nastavili s radovima. Dalje otpustimo još nekoliko administratora i programera.
02:56. Pokrenuli smo sve što se moglo pokrenuti. Provodimo veliku provjeru svih usluga automatskim testovima.
03:02. Klimatizacija u posljednjoj, 7. sali je obnovljena.
03:36. Aktivirani su ispravci u data centru u DNS rotaciji. Od ovog trenutka počinje dolaziti korisnički promet.
Opuštamo veći dio tima administratora da idu kući. Ali nekoliko osoba ostavljamo.
Mali FAQ:
Q: Što se događalo od 18:31 do 02:56?
A: Slijedeći "Plan djelovanja u slučaju nesreće", pokrećemo sve usluge, počevši od najvažnijih. U tom trenutku koordinator u chatu dodjeljuje uslugu slobodnom administratoru, koji provjerava jesu li OS i aplikacija pokrenuti, nema li grešaka, jesu li pokazatelji u normi. Nakon završetka pokretanja javlja u chat da je slobodan i dobiva novu uslugu od koordinatora.
Proces dodatno usporavaju neispravni hardver. Čak i ako su zaustavljanje OS-a i isključivanje servera prošli ispravno, neki serveri se ne vraćaju zbog iznenadne greške diskova, memorije, šasije. U slučaju gubitka električne energije, postotak grešaka se povećava.
Q: Zašto ne možemo jednostavno pokrenuti sve odjednom, a zatim popraviti ono što se pojavi u nadzoru?
A: Sve treba raditi postupno, jer između usluga postoje zavisnosti. A sve treba provjeravati odmah, ne čekajući nadzor — jer se s problemima bolje nositi odmah, ne čekajući njihovo pogoršanje.
7:40. Posljednji administrator (koordinator) otišao je spavati. Radovi prvog dana su završeni.
8:09. Prvi programeri, inženjeri u data centrima i administratori (uključujući novog koordinatora) započeli su s obnoviteljskim radovima.
09:37. Započeli smo podizanje sale br. 7 (posljednja).
Paralelno nastavljamo s obnavljanjem onoga što nismo dovršili u drugim salama: zamjena diskova/memorije/servera, popravak svega što "gori" u nadzoru, povratno prebacivanje uloga u shemama master-standby i ostali sitni poslovi koji su ipak prilično brojni.
17:08. Odobravamo sve redovne radove s produkcijom.
21:45. Radovi drugog dana su završeni.
09:45. Danes je petek. V monitoringu je še vedno veliko manjših težav. Pred nami so vikendi in vsi si želimo počitka. Nadaljujemo z množičnim odpravljanjem napak. Običajne administrativne naloge, ki smo jih lahko odložili, so bile odložene. Novi koordinator je tukaj.
15:40. Nenadoma se je ponovno zagnalo polovico omrežne infrastrukture Core v DRUGEM podatkovnem centru. Fronte smo odstranili iz rotacije, da bi zmanjšali tveganja. Uporabniki niso opazili težav. Kasneje se je izkazalo, da je šlo za okvarjeno ogrodje. Koordinator se ukvarja z odpravo težav hkrati v dveh incidentih.
17:17. Delovanje omrežja v drugem podatkovnem centru je bilo obnovljeno, vse je preverjeno. Podatkovni center je bil vključen v rotacijo.
18:29. Delo tretjega dne in splošno okrevanje po incidentu je zaključeno.
Zadnja misel
04.04.2013, , „Odnoklassniki“ —v treh dneh je bil portal popolnoma ali delno nedostopen. Vse to obdobje je več kot 100 ljudi iz različnih mest, iz različnih podjetij (še enkrat hvala!), na daljavo in neposredno v podatkovnih centrih, ročno in avtomatsko odpravilo tisoče strežnikov.
Imeli smo spoznanja. Da se to ne ponovi, smo izvedli in še vedno izvajamo obsežne ukrepe.
Kakšne so glavne razlike med trenutnim incidentom in 404?
- Imamo „Načrt ukrepanja ob incidentu“. Enkrat na četrtletje izvajamo vaje - uprizorimo incident, ki ga mora skupina skrbnikov (vsi izmenično) odpraviti z uporabo „Načrta ukrepanja ob incidentu“. Vodilni sistemski skrbniki izpolnjujejo vlogo koordinatorja izmenično.
- Enkrat četrtletno v testnem načinu izoliramo podatkovne centre (vse po vrsti) preko omrežja LAN in WAN, kar nam omogoča pravočasno odkrivanje ozkih grl.
- Manj okvarjenih diskov, ker smo zaostrili standarde: manj delovnih ur, strožja mejna vrednost za S.M.A.R.T.
- Popolnoma smo se poslovili od BerkeleyDB — stare in nestabilne baze podatkov, ki je potrebovala veliko časa za obnovitev po ponovnem zagonu strežnika.
- Zmanjšali smo število strežnikov z MS SQL in zmanjšali odvisnost od preostalih.
- Imamo svoje , v katerega že dve leti aktivno selimo vse storitve. Oblak znatno poenostavi celoten cikel dela z aplikacijo, v primeru incidenta pa nudi edinstvena orodja, kot so:
- pravilno zaustavljanje svih aplikacija jednim klikom;
- jednostavna migracija aplikacija sa neuspelih servera;
- automatsko rangiranje (prema prioritetu usluga) pokretanje celog data centra.
Incident opisan u ovom članku bio je najveći od 404-ih. Naravno, nije sve prošlo glatko. Na primer, dok je onečišćeni data centar bio nedostupan, u drugom data centru otkazao je disk na jednom od servera, što je značilo da je bila dostupna samo jedna od tri replikacije u Cassandra klasteru, zbog čega 4,2% korisnika mobilnih aplikacija nije moglo da se prijavi. U međuvremenu, već povezani korisnici su nastavili da rade. Ukupno je nakon incidenta otkriveno više od 30 problema – od banalnih grešaka do nedostataka u arhitekturi usluga.
Međutim, najvažnija razlika između trenutnog incidenta i 404-ih je u tome što su, dok smo rešavali posledice požara, korisnici i dalje komunicirali i obavljali video pozive u , igrali igre, slušali muziku, poklanjali jedni drugima poklone, gledali video, serije i televizijske kanale u , kao i strimovali u .
Kako prolaze vaši incidenti?
Izvor: habr.com

 Russian
 Italian
 German
 Polish
 Estonian
 Albanian
 Bulgarian
 Croatian
 Czech
 Danish
 Dutch
 English
 French
 Hungarian
 Latvian
 Norwegian
 Portuguese
 Romanian
 Slovak
 Slovenian
 Spanish
 Swedish