

Kratka uvodna reč
Verujem da bismo mogli postići više stvari kada bismo imali korak-po-korak upute koje nam govore šta i kako da radimo. I sam se sećam trenutaka u životu kada nisam mogao da započnem neki posao jer je jednostavno bilo teško razumeti odakle da krenem. Možda si nekada davno na internetu video reč „Data Science“ i pomislio da je to daleko od tebe, da su ljudi koji se time bave negde drugde, u drugom svetu. Međutim, nisu. Oni su ovde. I, možda, zahvaljujući ljudima iz ovog područja, naišao si na članak u svojoj feed-u. Postoji mnogo kurseva koji će ti pomoći da se upoznaš sa ovim zanatom, a ovde ću ti pomoći da napraviš prvi korak.
Pa, jesi li spreman? Odmah ću reći da moraš znati Python 3, jer ću ga koristiti ovde. Takođe savetujem da unapred instaliraš Jupyter Notebook ili da pogledaš kako da koristiš Google Colab.
Prvi korak
Kaggle je tvoj značajan pomoćnik u ovom procesu. U suštini, možeš i proći bez njega, ali o tome ću pričati u drugom članku. To je platforma na kojoj se održavaju takmičenja iz Data Science-a. U svakom od takmičenja na ranim fazama dobićeš neverovatnu količinu iskustva u rešavanju različitih zadataka, iskustva u razvoju i iskustva u radu u timu, što je važno u današnje vreme.
Uzeće svoju zadatak odatle. Zove se „Titanic“. Uslov je sledeći: predvideti hoće li svaki pojedinačni čovek preživeti. U suštini, zadatak nekoga ko se bavi DS-om je prikupljanje podataka, njihovo obrađivanje, obučavanje modela, predikcija itd. Na Kaggle-u nam omogućavaju da preskočimo fazu prikupljanja podataka — oni su predstavljeni na platformi. Treba da ih preuzmemo i možemo početi sa radom!
To možemo učiniti na sledeći način:
na kartici Podaci nalaze se datoteke koje sadrže podatke


Preuzeli smo podatke, pripremili naše Jupyter beležnice i...
Drugi korak
Kako sada da preuzmemo te podatke?
Prvo, uvozimo potrebne biblioteke:
import pandas as pd
import numpy as np
Pandas će nam omogućiti da učitamo .csv datoteke za dalju obradu.
Numpy je potreban da bismo predstavili našu tabelu podataka u obliku matrice sa brojevima.
Idemo dalje. Uzećemo datoteku train.csv i učitaćemo je kod nas:
dataset = pd.read_csv('train.csv')
Bomo sklicevati na naš vzorec podatkov train.csv prek spremenljivke dataset. Poglejmo, kaj tam imamo:
dataset.head()
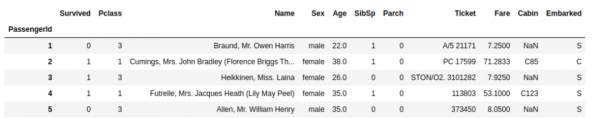
Funkcija head() nam omogoča, da si ogledamo prvih nekaj vrstic podatkovnega okvira.
Stolpec Survived predstavlja naše rezultate, ki so v tem podatkovnem okviru znani. Glede na nalogo moramo napovedati stolpec Survived za podatke test.csv. Ti podatki vsebujejo informacije o drugih potnikih Titanika, za katere nam, ki rešujemo nalogo, izidi niso znani.
Torej, razdelimo našo tabelo na odvisne in neodvisne podatke. Tukaj je vse preprosto. Odvisni podatki so tisti, ki so odvisni od neodvisnih, torej tistih, ki so v izidih. Neodvisni podatki so tisti, ki vplivajo na izid.
Na primer, imamo tak nabor podatkov:
„Vova se je učil informatike — ne.
Vova je dobil 2 iz informatike.“
Ocena iz informatike je odvisna od odgovora na vprašanje: ali se je Vova učil informatiko? Jasno? Pojdimo naprej, že smo bližje cilju!
Tradicionalna spremenljivka za neodvisne podatke je X. Za odvisne je y.
Naredimo naslednje:
X = dataset.iloc[ : , 2 : ]
y = dataset.iloc[ : , 1 : 2 ]
Kaj to pomeni? S funkcijo iloc[:, 2: ] pravimo Pythону: želim videti v spremenljivki X podatke, ki se začnejo od drugega stolpca (vključno in ob predpostavki, da se šteje od nič). V drugi vrstici pravimo, da želimo videti v y podatke iz prvega stolpca.
[ a:b, c:d ] — to je konstrukcija, ki jo uporabljamo v oklepajih. Če ne navedemo nekaterih spremenljivk, bodo ostale privzete. Torej lahko navedemo [:,: d] in takrat bomo v podatkovnem okviru dobili vse stolpce, razen tistih, ki se začnejo z d in naprej. Spremenljivki a in b določata vrstice, vendar jih potrebujemo vse, zato jih pustimo privzete.
Poglejmo, kaj smo dobili:
X.head() 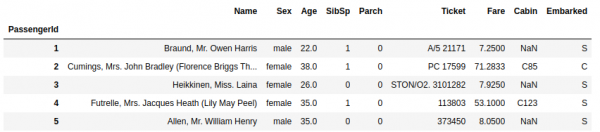
y.head() 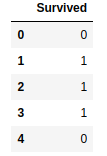
Da poenostavimo to kratko lekcijo, bomo odstranili stolpce, ki zahtevajo posebno 'negovanje', ali pa sploh ne vplivajo na preživetje. V njih so podatki tipa str.
count = ['Name', 'Ticket', 'Cabin', 'Embarked']
X.drop(count, inplace=True, axis=1)
Super! Poglejmo naslednji korak.
Korak tri
Tukaj bomo morali kodirati naše podatke, da bo stroj bolje razumel, kako ti podatki vplivajo na rezultat. Vendar bomo kodirali le podatke tipa str, ki smo jih pustili. Stolpec „Spol“. Kako želimo kodirati? Predstavljajmo si podatke o spolu osebe kot vektor: 10 — moški spol, 01 — ženski spol.
Najprej naše tabele pretvorimo v NumPy matriko:
X = np.array(X)
y = np.array(y)
In zdaj poglejmo:
from sklearn.compose import ColumnTransformer
from sklearn.preprocessing import OneHotEncoder

ct = ColumnTransformer(transformers=[('encoder', OneHotEncoder(), [1])],
                       remainder='passthrough')
X = np.array(ct.fit_transform(X))
Knjižnica sklearn je res odlična knjižnica, ki nam omogoča, da opravimo celotno delo v podatkovni znanosti. Vsebuje veliko zanimivih modelov strojnega učenja ter nam omogoča pripravo podatkov.
OneHotEncoder nam bo omogočil, da kodiramo spol osebe v predstavljeni obliki, kakor smo opisali. Ustvarila se bosta 2 razreda: moški, ženski. Če je oseba moški, bo v stolpec „moški“ zapisana 1, v „ženski“ pa 0.
Po OneHotEncoder() stoji [1] — to pomeni, da želimo kodirati stolpec številka 1 (številčenje se začne od nič).
Super. Gremo še naprej!
Običajno se zgodi, da nekateri podatki ostanejo prazni (tj. NaN — not a number). Na primer, imamo informacije o osebi: njeno ime, spol. Vendar podatkov o njeni starosti ni. V tem primeru bomo uporabili metodo: izračunali bomo aritmetično sredino vseh stolpcev in, če so v stolpcu podatki manjkajoči, bomo praznino zapolnili z aritmetičnim sredinom.
from sklearn.impute import SimpleImputer
imputer = SimpleImputer(missing_values=np.nan, strategy='mean')
imputer.fit(X)
X = imputer.transform(X)
In zdaj upoštevajmo, da se lahko pojavijo situacije, ko so podatki zelo razpršeni. Nekateri podatki so v razponu [0:1], nekateri pa lahko presegajo stotine in tisoče. Da bi izključili tak razpon in bila računalnika natančnejša v izračunih, bomo podatke skalirali, jih obsegli. Naj števila ne presegajo tri. Za to bomo uporabili funkcijo StandartScaler.
from sklearn.preprocessing import StandardScaler
sc = StandardScaler()
X[:, 2:] = sc.fit_transform(X[:, 2:])
Zdaj naši podatki izgledajo tako:

Odlično. Že smo blizu našemu cilju!
Četrti korak
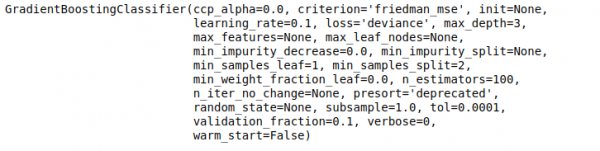
Naučimo naš prvi model! U biblioteci sklearn možemo pronaći ogromnu količinu zanimljivih stvari. Primijenio sam model Gradient Boosting Classifier na ovaj zadatak. Koristimo klasifikator, jer je naš zadatak klasifikacija. Potrebno je prognozu klasificirati kao 1 (preživio) ili 0 (nije preživio).
from sklearn.ensemble import GradientBoostingClassifier
gbc = GradientBoostingClassifier(learning_rate=0.5, max_depth=5, n_estimators=150)
gbc.fit(X, y)
Funkcija fit govori Pythonu: Neka model potraži odnose između X i y.
Manje od sekunde i model je spreman.
Kako ga primijeniti? Sada ćemo to vidjeti!
Korak pet. Zaključak
Sada trebamo učitati tabelu s našim testnim podacima za koje treba napraviti prognozu. S ovom tabelom ćemo učiniti iste radnje koje smo radili za X.
X_test = pd.read_csv('test.csv', index_col=0)

count = ['Name', 'Ticket', 'Cabin', 'Embarked']
X_test.drop(count, inplace=True, axis=1)

X_test = np.array(X_test)

from sklearn.compose import ColumnTransformer
from sklearn.preprocessing import OneHotEncoder
ct = ColumnTransformer(transformers=[('encoder', OneHotEncoder(), [1])],
                       remainder='passthrough')
X_test = np.array(ct.fit_transform(X_test))

from sklearn.impute import SimpleImputer
imputer = SimpleImputer(missing_values=np.nan, strategy='mean')
imputer.fit(X_test)
X_test = imputer.transform(X_test)

from sklearn.preprocessing import StandardScaler
sc = StandardScaler()
X_test[:, 2:] = sc.fit_transform(X_test[:, 2:])
Primijenimo naš model!
gbc_predict = gbc.predict(X_test)
To je to. Napravili smo prognozu. Sada je potrebno zapisati u csv i poslati na sajt.
np.savetxt('my_gbc_predict.csv', gbc_predict, delimiter=",", header = 'Survived')
Gotovo. Dobili smo datoteku koja sadrži prognoze za svakog putnika. Preostaje samo da se ta rešenja postave na sajt i dobiju ocene prognoze. Ovaj primitivni pristup daje ne samo 74% tačnih odgovora u javnosti, već takođe i određeni poticaj u Data Science. Najzanimljiviji mogu u bilo koje vreme napisati mi u privatne poruke i postaviti pitanja. Hvala svima!
Izvor: habr.com

 Russian
 Italian
 German
 Polish
 Estonian
 Albanian
 Bulgarian
 Croatian
 Czech
 Danish
 Dutch
 English
 Finnish
 French
 Hungarian
 Latvian
 Lithuanian
 Norwegian
 Portuguese
 Romanian
 Slovak
 Slovenian
 Spanish
 Swedish