

Hello, Habr!
V luči trenutnih dogodkov zaradi koronavirusa so nekateri internetni servisi začeli prejemati povečano obremenitev. Na primer, , ker ni bilo dovolj moči. In daleč ne vedno je mogoče izboljšati strežnik, preprosto dodajanje zmogljivejše opreme, vendar moramo obdelati zahteve strank (ali pa odidejo k konkurentom).
V tem članku bom na kratko opisal priljubljene prakse, ki bodo omogočile hitro in zanesljivo storitev. Izmed možnih razvoja sem izbral le tiste, ki jih lahko zdaj enostavno uporabite. Za vsako točko imate ali že pripravljene knjižnice, ali pa je mogoče nalogo rešiti s pomočjo oblačne platforme.
Horizontalno skaliranje
Najpreprostejša in vsem znana točka. Pogojujemo, da sta najbolj pogosto uporabljeni dve shemi porazdelitve obremenitve — horizontalno in vertikalno skaliranje. dovolite storitvam, da delujejo vzporedno, s čimer porazdelite obremenitev med njimi. naročite močnejše strežnike ali optimizirate kodo.
Kot primer bom vzel abstraktno oblačno shrambo datotek, tj. nekakšen analog OwnCloud, OneDrive in tako dalje.
Standardna slika takšne sheme je spodaj, vendar le predstavlja kompleksnost sistema. Kaj pa, če uporabnik shrani datoteko iz tablice in jo nato želi pogledati na telefonu?
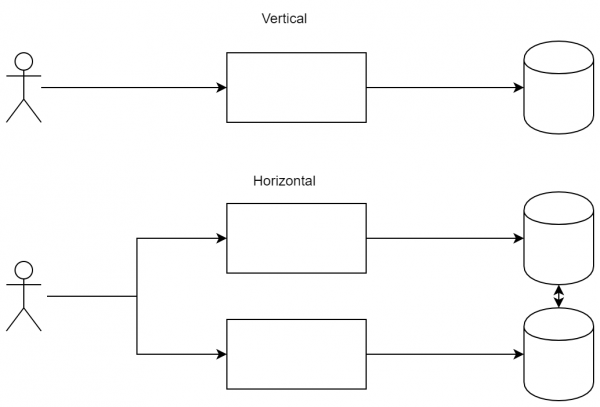
Razlika med pristopi: pri vertikalnem skaliranju smo pripravljeni povečati moč enot, pri horizontalnem pa dodajamo nove enote, da porazdelimo obremenitev.
CQRS
je precej pomemben vzorec, saj omogoča različnim strankam, ne le, da se povežejo z različnimi storitvami, ampak tudi prejemajo enake tokove dogodkov. Njegove prednosti niso tako očitne za preprosto aplikacijo, vendar je izjemno pomemben (in preprost) za obremenjeno storitev. Njegovo bistvo je: vhodni in izhodni tokovi podatkov se ne smejo križati. To pomeni, da ne morete poslati poizvedbe in pričakovati odgovora, temveč pošljete poizvedbo v storitev A, vendar odgovor prejmete v storitvi B.
Prvi bonus ovog pristupa je mogućnost prekida veze (u širokom smislu te reči) tokom izvršavanja dugog zahteva. Na primer, uzmimo više-manje standardnu sekvencu:
- Klijent je poslao zahtev serveru.
- Server je pokrenuo dugu obradu.
- Server je odgovorio klijentu rezultatom.
Zamislimo da se u koraku 2 dogodio prekid veze (ili se mreža ponovo povezala, ili je korisnik prešao na drugu stranicu, prekinuvši vezu). U tom slučaju, serveru će biti teško da pošalje odgovor korisniku s informacijama o tome šta je tačno obrađeno. Primenom CQRS, sekvenca će biti malo drugačija:
- Klijent se pretplatio na ažuriranja.
- Klijent je poslao zahtev serveru.
- Server je odgovorio "zahtev prihvaćen".
- Server je odgovorio rezultatom preko kanala iz tačke "1".
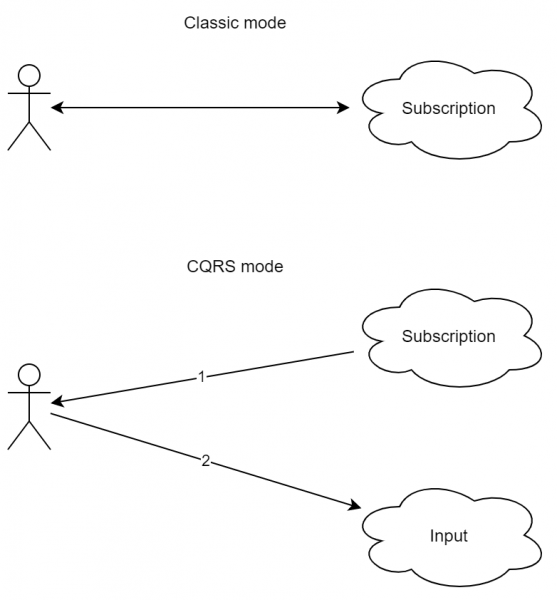
Kao što se može videti, shema je malo složenija. Štaviše, intuitivni pristup zahteva-odgovora ovde nedostaje. Međutim, kao što se vidi, prekid veze tokom obrade zahteva neće dovesti do greške. Štaviše, ako je korisnik zapravo povezan sa servisom s više uređaja (na primer, sa mobilnog telefona i sa tableta), može se omogućiti da odgovor dolazi na oba uređaja.
Zanimljivo je da kod obrade dolaznih poruka postaje sličan (ne 100%) za događaje na koje je uticao sam klijent, kao i za ostale događaje, uključujući one od drugih klijenata.
Međutim, u stvarnosti dobijamo dodatne pogodnosti zbog toga što se jednosmerni protok može obrađivati u funkcionalnom stilu (koristeći RX i slične alate). I ovo je ozbiljna prednost, jer se u suštini aplikacija može učiniti potpuno reaktivnom, uz primenu funkcionalnog pristupa. Za kompleksne programe to može značajno uštedeti resurse na razvoju i održavanju.
Ako spojimo ovaj pristup s horizontalnim skaliranjem, dobijamo mogućnost slanja zahteva na jedan server, a primanja odgovora od drugog. Tako klijent može sam izabrati uslugu koja mu odgovara, a sistem unutar može ispravno obraditi događaje.
Event Sourcing
Kot veste, ena od osnovnih značilnosti porazdeljenega sistema je pomanjkanje skupnega časa in skupne kritične sekcije. Za en proces lahko izvedete sinhronizacijo (na istih mutexih), znotraj katere ste prepričani, da nihče drug ne izvaja te kode. Vendar pa je to za porazdeljen sistem nevarno, saj bo to zahtevalo prevelike stroške, hkrati pa bi uničilo vso čarobnost skaliranja — vse komponente bi se kljub temu morale zanašati na eno samo.
Od tod pridemo do pomembnega dejstva — hitrega porazdeljenega sistema ni mogoče sinhronizirati, saj bi s tem zmanjšali učinkovitost. Po drugi strani pa pogosto potrebujemo določeno usklajenost komponent. In za to lahko uporabimo pristop z , kjer je zagotovljeno, da v odsotnosti sprememb podatkov po nekem časovnem obdobju po zadnji posodobitvi („na koncu“) vsi zahtevki vrnejo zadnjo posodobljeno vrednost.
Pomembno je razumeti, da se za klasične baze podatkov pogosto uporablja , kjer vsak vozlišče obvladuje enake informacije (to se pogosto doseže, ko se transakcija šteje za dokončano šele po odgovoru drugega strežnika). Tukaj so nekatera popustitev zaradi stopenj izolacije, vendar osnovna ideja ostaja enaka — lahko živite v popolnoma usklajenem svetu.
Vendar se vrnimo k prvotni nalogi. Če je del sistema mogoče zgraditi s , potem lahko zgradimo naslednjo shemo.
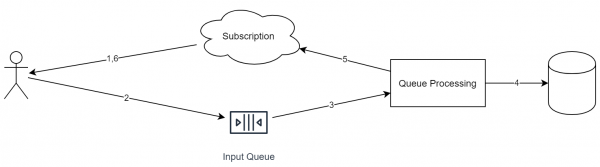
Pomembne značilnosti tega pristopa:
- Vsak prihajajoči zahtevek se postavi v eno vrsto.
- Med obdelavo zahtevka lahko storitev prav tako postavi naloge v druge vrste.
- Vsak prihajajoči dogodek ima identifikator (ki je potreben za deduplikacijo).
- Vrsta ideološko deluje po shemi "samo dodaj". Elementov ni mogoče odstranjevati ali preurejati.
- Vrsta deluje po shemi FIFO (oprosti za pleonazem). Če je potrebno izvesti vzporedno izvajanje, je treba v eni izmed faz premakniti objekte v različne vrste.
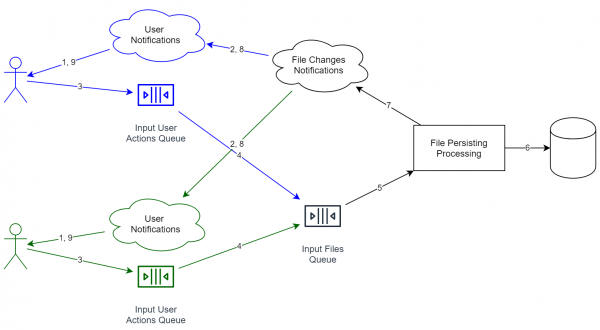
Spomnim vas, da obravnavamo primer spletnega shranjevanja datotek. V tem primeru bo sistem izgledal nekako takole:
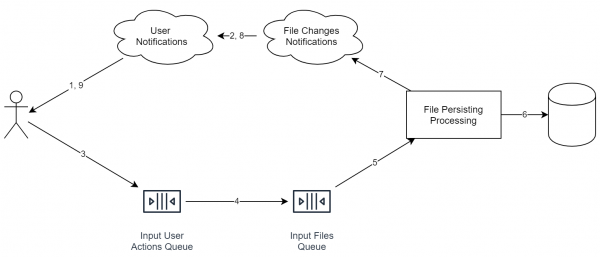
Pomembno je, da storitve na diagramu ne pomenijo nujno ločenega strežnika. Tudi postopek je lahko enak. Pomembnejše je, da so te stvari ideološko razdeljene na način, da je mogoče enostavno uporabiti horizontalno skaliranje.
Za dva uporabnika bo shema videti tako (storitev, namenjene različnim uporabnikom, so označene z različnimi barvami):
Bonusi takšne kombinacije:
- Storitve za obdelavo informacij so razdeljene. Čakalne vrste so prav tako razdeljene. Če bomo potrebovali povečati prepustnost sistema, bomo le morali zagnati več storitev na večjem številu strežnikov.
- Ko od uporabnika pridobimo informacije, nam ni treba čakati na popolno shranjevanje podatkov. Nasprotno, zadostuje, da odgovorimo »v redu«, nato pa postopoma začnemo delati. Hkrati čakalna vrsta omili vrhove, saj se dodajanje novega objekta zgodi hitro, polnega procesa skozi celoten cikel pa uporabnik ne rabi čakati.
- Za primer sem dodal storitev deduplifikacije, ki poskuša združiti enake datoteke. Če traja dolgo pri 1 % primerov, tega stranka praktično ne bo opazila (glej zgoraj), kar je velika prednost, saj od nas ni več zahtevana 100-odstotna hitrost in zanesljivost.
Vendar se takoj vidijo tudi slabosti:
- Našemu sistemu je zmanjkalo stroge usklajenosti. To pomeni, da lahko, če se na primer naročimo na različne storitve, teoretično pridobimo različno stanje (saj lahko ena od storitev ne uspe pravočasno sprejeti obvestila iz notranje čakalne vrste). Kot še en posledica, sistem zdaj nima skupnega časa. To pomeni, da ni mogoče na primer razvrstiti vseh dogodkov preprosto po času prihoda, saj ure med strežniki morda niso sinhronizirane (poleg tega enaka ura na dveh strežnikih predstavlja utopijo).
- Nobenih dogodkov zdaj ni mogoče preprosto razveljaviti (kot bi to lahko storili z bazo podatkov). Namesto tega je potrebno dodati nov dogodek — , ki bo spremenil zadnje stanje v potrebno. Kot primer iz sorodne področja: brez prepisovanja zgodovine (kar je v nekaterih primerih slabo) v gitu ni mogoče razveljaviti commit, vendar pa je mogoče narediti posebni , ki po svoji naravi preprosto vrne staro stanje. Vendar pa bo v zgodovini ostal tako napačen commit kot tudi rollback.
- Podatkovna shema se lahko spreminja z vsakim izidom, vendar starih dogodkov ni mogoče nadgraditi na nov standard (ker dogodkov v osnovi ni mogoče spreminjati).
Kot je razvidno, se Event Sourcing odlično ujema s CQRS. Še več, implementirati sistem z učinkovitim in uporabnikom prijaznim čakanjem, vendar brez ločevanja podatkovnih tokov, je že samo po sebi zahtevno, saj je potrebno dodati točke sinhronizacije, ki bi izničile celoten pozitivni učinek čakanja. Ko uporabljamo oba pristopa hkrati, je potrebna manjša korekcija v kodi programa. V našem primeru, ko je datoteka poslana na strežnik, se odziv vrne samo z «ok», kar pomeni le to, da je «operacija dodajanja datoteke shranjena». Formalno to ne pomeni, da so podatki že dostopni na drugih napravah (na primer, storitev deduplikacije lahko preoblikuje indeks). Vendar pa bo po določenem času stranki prišlo obvestilo v slogu «datoteka X je shranjena».
Kot rezultat:
- Število statusov za pošiljanje datotek se povečuje: namesto klasičnega «datoteka je bila poslana» prejmete dva: «datoteka je bila dodana v čakalno vrsto na strežniku» in «datoteka je shranjena v shrambo». Zadnje pomeni, da lahko druge naprave začnejo prejemati datoteko (z upoštevanjem, da čakalne vrste delujejo z različnimi hitrostmi).
- Zaradi tega, ker informacije o pošiljanju zdaj prihajajo po različnih kanalih, moramo razviti rešitve, da pridobimo status obdelave datoteke. Kot posledica tega: v nasprotju s klasičnim request-response, lahko stranka ponovno zažene postopek obdelave datoteke, vendar bo status te obdelave pravilen. Ta točka deluje, v bistvu, že iz škatle. Posledično smo zdaj bolj tolerantni na napake.
Sharding
Kot je že opisano zgoraj, v sistemih z event sourcingom ni stroge doslednosti. To pomeni, da lahko uporabljamo več shranjevanj brez kakršne koli sinhronizacije med njimi. Prihajajočih k naši nalogi, lahko:
- Datoteke razdelimo po tipih. Na primer, slike/video lahko dekodiramo in izberemo učinkovitejši format.
- Razdvajanje računov po državah. Zaradi mnogih zakonov je to lahko potrebno, toda ta arhitekturna shema ponuja to možnost samodejno.
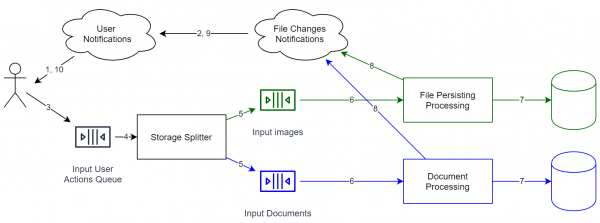
Če želite premakniti podatke iz enega skladišča v drugo, pa brez standardnih sredstev ne bo šlo. Na žalost je v tem primeru potrebno ustaviti vrsto, izvesti migracijo in nato znova zagnati. Na splošno podatkov "v živo" ni mogoče prenesti, vendar, če je vrsta dogodkov popolnoma shranjena in imate kopije prejšnjih stanj skladišča, lahko ponovno predvajamo dogodke na naslednji način:
- V Event Source ima vsak dogodek svoj identifikator (ideally - naraščajoč). To pomeni, da lahko v skladišče dodamo polje — id zadnjega obdelanega elementa.
- Dvojimo vrsto, da lahko vsi dogodki obdelujejo za več neodvisnih skladišč (prvo — to, v katerem so trenutno shranjeni podatki, in drugo — novo, ki pa je trenutno prazno). Druga vrsta se seveda zaenkrat ne obdeluje.
- Zacnemo drugo vrsto (to pomeni, da začnemo znova predvajati dogodke).
- Ko bo nova vrsta relativno prazna (t.j. povprečna razlika v času med dodajanjem elementa in njegovim pridobivanjem bo sprejemljiva), lahko začnemo preklapljati bralce na novo skladišče.
Kot je razvidno, v našem sistemu nikoli ni bilo in še vedno ni stroge doslednosti. Obstaja le eventualna doslednost, kar pomeni, da se dogodki obdelujejo v istem vrstnem redu (vendar morda z različno zamudo). In z uporabo tega lahko relativno enostavno prenesemo podatke brez zaustavitve sistema na drug konec sveta.
Tako, kot nadaljujemo naš primer o spletnem skladišču za datoteke, nam takšna arhitektura že prinaša vrsto bonusov:
- Objekte lahko premikamo bližje uporabnikom, in to dinamično. S tem lahko izboljšamo kakovost storitve.
- Del podatkov lahko hranimo znotraj podjetij. Na primer, uporabniki podjetij pogosto zahtevajo shranjevanje svojih podatkov v nadzorovanih podatkovnih centrih (da bi se izognili uhajanju podatkov). S pomočjo sharding-a lahko to enostavno podpiramo. Naloga je še poenostavljena, če ima naročnik združljivo oblačno rešitev (na primer, ).
- Najpomembnejša stvar pa je, da tega morda ne bomo morali storiti. Za začetek bi nam vsekakor zadostovalo eno skladišče za vse račune (da bi lahko hitreje začeli delati). Ključna značilnost tega sistema je, da je, čeprav razširljiv, v začetni fazi dovolj preprost. Preprosto povedano, ne smemo takoj pisati kode, ki deluje z milijonom ločenih neodvisnih čakalnih vrst itd. Če bo potrebno, pa to lahko storimo v prihodnosti.
Gostovanje statične vsebine
Ta točka se morda zdi povsem očitna, a je kljub temu potrebna za povsem standardno obremenjeno aplikacijo. Njena bistvo je preprosto: vsa statična vsebina se razdaja ne s tistega strežnika, kjer je aplikacija, ampak s specializiranih strežnikov, namenjenih prav temu. Posledično se te operacije izvajajo hitreje (konvencionalni nginx dostavlja datoteke učinkoviteje in z manj stroški kot Java strežnik). Poleg tega arhitektura CDN () omogoča postavitev naših datotek bližje končnim uporabnikom, kar pozitivno vpliva na priročnost dela s storitvijo.
Najpreprostejši in standardni primer statične vsebine so zbirke skript in slik za spletno stran. Z njimi je vse preprosto — vnaprej so znane, nato se arhiv naloži na strežnike CDN, od koder se razdajo končnim uporabnikom.
Vendar pa se v praksi za statično vsebino lahko uporabi pristop, ki je nekako podoben lambda arhitekturi. Vrnimo se k našemu nalogu (spletno skladišče datotek), pri katerem moramo datoteke razdeliti uporabnikom. Najpreprostejša rešitev bi bila ustvariti storitev, ki za vsako uporabniško zahtevo izvede vse potrebne preglede (avtorizacija itd.) in potem prenese datoteko neposredno iz našega skladišča. Glavna pomanjkljivost tega pristopa je, da se statična vsebina (datoteka z določeno revizijo je v bistvu statična vsebina) deli s tistim samim strežnikom, ki vsebuje poslovno logiko. Namesto tega lahko naredimo naslednjo shemo:
- Strežnik izda URL za prenos. Lahko je v obliki file_id + key, kjer je key mini-digitalni podpis, ki daje pravico dostopa do vira za naslednjih 24 ur.
- Prenos datoteke opravi preprost nginx z naslednjimi možnostmi:
- Predpomnjenje vsebine. Ker ta storitev lahko deluje na ločenem strežniku, smo si za prihodnost omogočili možnost shranjevanja vseh nedavno prenesenih datotek na disku.
- Preverjanje ključa ob vzpostavitvi povezave.
- Neobvezno: pretakanje vsebine. Na primer, če komprimiramo vse datoteke v storitvi, lahko izvlečenje izvede prav ta modul. Posledično so IO operacije opravljene na pravem mestu. Stisnitelj v Javi lahko zlahka porabi veliko odvečnega pomnilnika, vendar je preklica storitve z poslovno logiko na pogojne Rust/C++ lahko tudi neučinkovito. V našem primeru uporabljamo različne procese (ali celo storitve), zato lahko razmeroma učinkovito ločimo poslovno logiko in IO operacije.
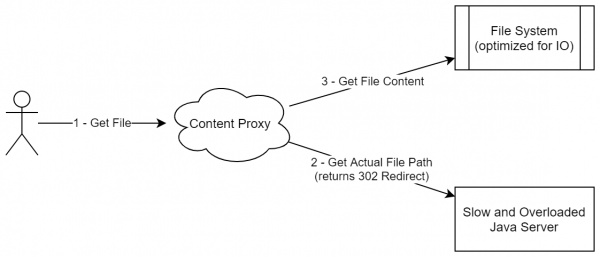
Takšna shema ni zelo podobna distribuciji statične vsebine (ker celotnega sklopa statike ne nalagamo nekam), vendar v resnici ta pristop prav tako obravnava distribucijo nespremenljivih podatkov. Poleg tega se to shemo lahko posploši tudi na druge primere, ko vsebina ni zgolj statična, temveč jo lahko predstavimo kot niz nespremenljivih in neizbrisanih blokov (čeprav se ti lahko dodajajo).
Še en primer (za utrjevanje): če ste delali z Jenkins/TeamCity, potem veste, da sta oba rešitve napisani v Javi. Oba predstavljata Java proces, ki se ukvarja tako z orkestracijo gradnje kot z upravljanjem vsebine. Zlasti imata oba naloge, kot je "predaj datoteko/mapo s strežnika". Na primer: izdaja artefaktov, prenos izvorne kode (ko agent ne prenese kode neposredno iz repozitorija, temveč to naredi strežnik), dostop do logov. Vse te naloge se razlikujejo po obremenitvah IO. Tako se izkaže, da strežnik, odgovoren za kompleksno poslovno logiko, hkrati mora znati učinkovito preusmerjati velike tokove podatkov. In kar je še bolj zanimivo, to operacijo lahko delegiramo istemu nginxu po prav tako isti shemi (samo v zahtevo je potrebno dodati ključ podatkov).
Vendar če se vrnemo k našemu sistemu, potem dobimo takšno shemo:
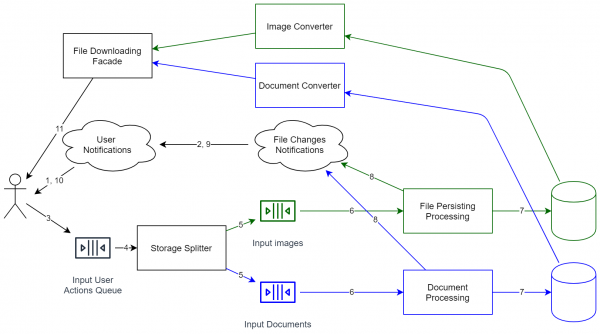
Kot je očitno, se je sistem radikalno zapletel. Zdaj to ni več le mini-proces, ki lokalno shranjuje datoteke. Zdaj je potrebna že precej zahtevna podpora, nadzor različic API itd. Zato je po tem, ko so vse sheme narisane, najbolje podrobno oceniti, ali se splača razširljivost takšnih stroškov. Če pa želite imeti možnost širiti sistem (tudi za delo z večjim številom uporabnikov), se boste morali odločiti za takšna rešitev. Kljub temu je sistem arhitekturno pripravljen na obremenitev (praktično vsak komponenta se lahko klonira za horizontalno skaliranje). Sistem je mogoče posodabljati brez zaustavitve (le nekateri postopki bodo nekoliko upočasnjeni).
Kot sem že omenil na začetku, so nekateri internetni servisi sedaj obremenjeni z večjo obremenitvijo. In nekateri od njih so enostavno prenehali delovati pravilno. V bistvu so sistemi odpovedali prav v trenutku, ko bi podjetje moralo zaslužiti. Namesto odložene dostave, namesto ponudbe strankam 'načrtujte dostavo za prihodnje mesece', je sistem enostavno rekel 'pojdite k konkurentom'. To je cena nizke zmogljivosti: izgube se zgodijo prav takrat, ko bi bila dobiček najvišja.
Zaključek
Vse te pristope smo poznali že prej. Enak VK že dolgo uporablja idejo Static Content Hosting za prikaz slik. Množica spletnih iger uporablja shemo Sharding za razdelitev igralcev po regijah ali pa za razdelitev igralnih lokacij (če je svet enoten). Pristop Event Sourcing se aktivno uporablja v elektronski pošti. Večina aplikacij trgovcev, kjer neprekinjeno prihajajo podatki, je v resnici zgrajena na pristopu CQRS, da bi imele možnost filtrirati prejeto vsebino. Horizontalno skaliranje pa se že dolgo uporablja v mnogih storitvah.
Vendar pa, kar je najpomembneje, so postali vsi ti vzorci izjemno enostavni za uporabo v sodobnih aplikacijah (seveda, če so smiselni). Oblaki ponujajo sharding in horizontalno skaliranje takoj, kar je precej lažje, kot da sami naročite različne namenski strežnike v različnih podatkovnih centrih. CQRS je postal precej lažji predvsem zaradi razvoja knjižnic, kot je RX. Pred 10 leti bi redka spletna stran lahko podpirala takšno rešitev. Event sourcing se prav tako nastavi neverjetno enostavno zahvaljujoč že pripravljenim kontejnerjem s Apache Kafka. Pred 10 leti bi to bila novost, danes pa je to postalo rutina. Podobno velja za statično gostovanje vsebine: zaradi bolj priročnih tehnologij (vključno z obširno dokumentacijo in veliko bazo odgovorov) je tak pristop postal še bolj enostaven.
Kot rezultat, je izvajanje vrste precej zapletenih arhitekturnih vzorcev zdaj postalo veliko lažje, kar pomeni, da jih je bolje vnaprej preučiti. Če se je v desetletni aplikaciji od enega izmed zgoraj navedenih rešitev odreklo zaradi visokih stroškov uvajanja in delovanja, pa je zdaj, v novi aplikaciji ali po refaktoringu, mogoče narediti storitev, ki bo arhitekturno tako razširljiva (z vidika zmogljivosti) kot pripravljena na nove zahteve strank (na primer za lokalizacijo osebnih podatkov).
In kar je najvažnejše: prosim, ne uporabljajte teh pristopov, če imate preprosto aplikacijo. Da, so lepi in zanimivi, vendar je za spletno stran s vrhunskim obiskom 100 ljudi pogosto dovolj klasični monolit (vsaj navzven, znotraj pa se lahko vse razdeli na module itd.).
Izvor: habr.com
