

Pisanje tega članka me je spodbudilo veliko število gradiv o statični analizi, ki so vse pogosteje prišla v oči. Najprej je to , ki se aktivno promovira na Habu z pregledi napak, ki jih je njihov instrument našel v projektih z odprto kodo. Nedavno je PVS-studio uvedel , in seveda razvijalci IntelliJ IDEA, čigar vgrajeni analitik je danes verjetno najbolj napreden za Javo, .
Ob branju takih pregledov se zdi, da gre za čarobni napoj: pritisni gumb in tukaj je — seznam napak pred očmi. Zdi se, da se bo ob izboljševanju analitikov težav odkrilo vedno več, in izdelki, ki jih skenirajo ti roboti, se bodo izboljšali, brez kakršnega koli truda z naše strani.
Toda čarobnih napojov ni. Rad bi govoril o tem, o čemer običajno ne govorijo v objavah vrste „kaj vse lahko naš robot najde“: česa analitiki nikoli ne morejo, kakšna je njihova resnična vloga in mesto v procesu dobave programske opreme, ter kako jih pravilno uvajati.
Zobnik (vir: ).
Česa statični analitiki nikoli ne morejo storiti
Kaj praktično pomeni analiza izvorne kode? Vnosimo določene izvorne kode in na izhodu v kratkem času (znatno krajšem od izvajanja testov) dobimo določene podatke o našem sistemu. Temeljna in matematično nepreklicna ovira je, da lahko na ta način pridobimo le ozko skupino informacij.
Najbolj znan primer problema, ki se ne more rešiti z uporabo statične analize — : to je teorema, ki dokazuje, da ni možno razviti splošnega algoritma, ki bi na podlagi izvorne kode programa določil, ali bo ta zanikala ali se končala v končnem času. Razširitev te teoreme je , ki potrjuje, da je za kakršno koli netrivijalno lastnost izračunljivih funkcij določitev, ali poljubni program izračuna funkcijo s to lastnostjo, algoritemsko nerešljiv problem. Na primer, nemogoče je napisati analitik, ki bo po katerem koli izvorno kodo določil, ali analizirani program implementira algoritem, ki izračuna, recimo, kvadrat celo število.
Tako ima funkcionalnost statičnih analizatorjev nepremagljive omejitve. Statistični analizator nikoli ne bo mogel v vseh primerih določiti takih stvari, kot so na primer pojav «null pointer exception» v jezikih, ki dopuščajo vrednost null, ali v vseh primerih določiti pojav «attribute not found» v jezikih z dinamično tipizacijo. Vse, kar lahko najpopolnejši statični analizator naredi, je izločanje posebnih primerov, katerih število med vsemi možnimi težavami z vašo izvorno kodo je, brez pretiravanja, kaplja v morju.
Statična analiza ni iskanje napak.
Iz zgoraj navedenega sledi sklep: statična analiza ni sredstvo za zmanjšanje števila napak v programu. Tvegano trdim: ob prvem uvajanju v vaš projekt bo našel v kodi 'zanimiva' mesta, vendar najverjetneje ne bo našel nobenih napak, ki vplivajo na kakovost delovanja vašega programa.
Primeri napak, ki jih avtomatsko najdejo analizatorji, so impresivni, vendar ne smemo pozabiti, da so ti primeri najdeni s skeniranjem velikega nabora velikih kodnih baz. Na enak način hekerji, ki imajo možnost preizkusiti nekaj preprostih gesel na številnih računih, na koncu najdejo račune, kjer je enostavno geslo.
Ali to pomeni, da statične analize ni treba izvajati? Seveda ne! In ravno iz istega razloga, zakaj je vredno preverjati vsako novo geslo, da ne pade na seznam 'preprostih' gesel.
Statična analiza je več kot iskanje napak.
V resnici so naloge, ki jih lahko analizira, bistveno širše. Kajti na splošno, statična analiza je vsakršna preveritev izvornih kod, opravljena pred njihovim zagonom. Tukaj je nekaj stvari, ki jih lahko počnete:
- Preverjanje sloga kodiranja v širšem pomenu te besede. To vključuje tako preverjanje oblikovanja kot iskanje uporabe praznih/nepotrebnih oklepajev, nastavitev pragu meril, kot so število vrstic / ciklomatična kompleksnost metode itd. — vse, kar lahko oteži berljivost in vzdrževanje kode. V Javi je tak instrument Checkstyle, v Pythu pa flake8. Programi te vrste se običajno imenujejo „linters“.
- Analizi je lahko podvržen ne samo izvršni koda. Datoteke virov, kot so JSON, YAML, XML, .properties, lahko (in morajo!) biti samodejno preverjene na veljavnost. Saj je bolje izvedeti, da je z neparnimi narekovaji poškodovana struktura JSON v zgodnji fazi samodejnega preverjanja Pull Request, kot pa pri izvajanju testov ali v času izvajanja? Ustrezna orodja so na voljo: na primer, , .
- Kompilacija (ali analiza za dinamične programske jezike) je tudi oblika statične analize. Običajno lahko prevajalniki dajejo opozorila, ki signalizirajo težave s kakovostjo izvorne kode, katerih ne smemo ignorirati.
- Včasih kompilacija ni le kompilacija izvršnega kode. Na primer, če imate dokumentacijo v formatu , se ob pretvorbi v HTML/PDF lahko obdelovalec AsciiDoctor () izdaja opozorila, na primer o poškodovanih notranjih povezavah. In to je pomemben razlog, da ne sprejmete Pull Request s spremembami dokumentacije.
- Preverjanje pravopisa je prav tako oblika statične analize. Orodje lahko preverja pravopis ne le v dokumentaciji, temveč tudi v izvornih kodah programov (v komentarjih in literatih) v različnih programskih jezikih, vključno s C/C++, Javom in Pythonom. Napaka v pravopisu v uporabniškem vmesniku ali dokumentaciji je tudi napaka!
- Konfiguracijski testi (o tem, kaj to je — glej in poročila), čeprav se izvajajo v okolju izvajanja enotnih testov, kot je pytest, so pravzaprav tudi vrsta statične analize, saj ne izvajajo izvorne kode med svojim izvajanjem.
Kot vidimo, iskanje napak na tem seznamu zaseda manj pomembno vlogo, vse ostalo pa je dostopno z uporabo brezplačnih odprtokodnih orodij.
Kateri od teh vrst statične analize bi morali uporabljati v vašem projektu? Seveda, vse, več je bolje! Najpomembnejše je, da to pravilno implementirate, o čemer bomo govorili naprej.
Dobavna cev kot večstopenjski filter in statična analiza kot njen prvi kaskad.
Klasična metafora neprekinjene integracije je cevovod (pipeline), po katerem potekajo spremembe — od spremembe izvorne kode do dobave v produkcijo. Standardni zaporedni koraki tega cevovoda izgledajo tako:
- statična analiza
- kompilacija
- enotni testi
- integracijski testi
- UI testi
- ročna preverjanja
Spremembe, ki so bile zavrnjene na N-tem koraku cevovoda, ne preidejo na korak N+1.
Zakaj tako, in ne drugače? V tistem delu cevovoda, ki se nanaša na testiranje, testerji spoznajo široko znano piramido testiranja.
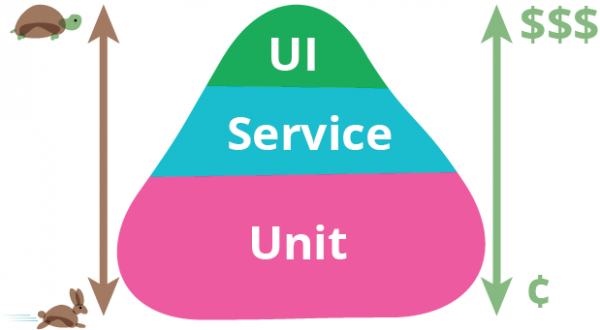
Testna piramida. Vir: Martin Fowler.
Na dnu te piramide so testi, ki jih je lažje pisati, ki se hitro izvajajo in nimajo tendence k lažnim pozitivnim rezultatom. Zato bi jih moralo biti več, pokrivati bi morali več kode in se izvajati najprej. Na vrhu piramide pa je situacija nasprotna, zato se mora število integracijskih in UI testov zmanjšati na nujno minimalno. Človek v tej verigi je najdražji, najpočasnejši in najmanj zanesljiv vir, zato je na samem koncu in opravlja delo le, če prejšnji koraki niso odkrili nobenih napak. Vendar pa po istih principih deluje cevovod tudi v delih, ki niso neposredno povezani s testiranjem!
Rad bi predlagal analogijo v obliki večstopenjskega sistema filtracije vode. Na vhod priteče umazana voda (spremembe z napakami), na izhodu pa moramo dobiti čisto vodo, v kateri so odstranjenje vse neželene onesnaževalce.
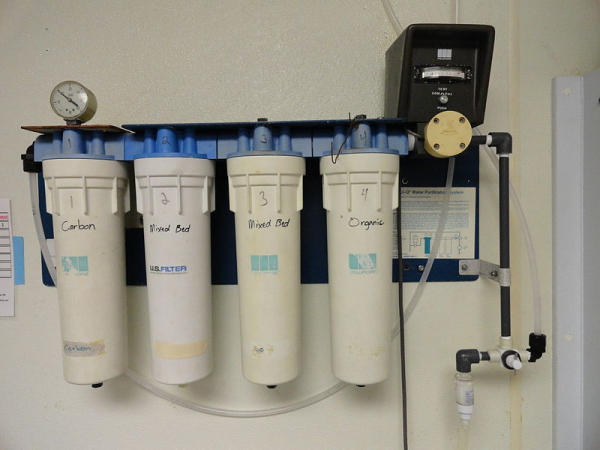
Večstopenjski filter. Vir:
Kot je znano, se čistilni filtri zasnovajo tako, da lahko vsak naslednji kaskad filtrira vedno manjše delce onesnaževal. Ob tem imajo kaskade bolj grobe filtracije večjo propustnost in nižje stroške. V naši analogiji to pomeni, da vhodna kvalitetna vrata zagotavljajo večjo hitrost delovanja, zahtevajo manj napora za zagon in so same po sebi manj zahtevne za delovanje — in ravno v tej zaporedju so zasnovane. Vloga statične analize, ki, kot zdaj razumemo, lahko zajame le najbolj grobe napake — je vloga mreže 'čistilca' na samem začetku kaskade filtrov.
Sama statična analiza ne izboljšuje kakovosti končnega produkta, kot 'čistilec' ne naredi vode pitne. Kljub temu pa je v kombinaciji z drugimi elementi procesne linije njen pomen očiten. Čeprav v večkaskadnem filtru lahko izhodni kaskadi potencialno zajamejo vsa ista onesnaževala kot vhodni — je jasno, kakšne posledice bo imela poskus izpustiti se zgolj s kaskadami fine filtracije, brez vhodnih kaskad.
Namen 'čistilca' je razbremeniti naslednje kaskade zadolžitve za zajemanje res grobih napak. Na primer, najmanj, oseba, ki izvaja pregled kode, ne sme biti motena zaradi nepravilno oblikovane kode in kršenja določenih norm kodiranja (kot so odvečne oklepaje ali pregloboko zaklepanje vej). Napake, kot je NPE, morajo biti ujete z enotskimi testi, vendar, če nam analitik že pred testom nakazuje, da se napaka nujno zgodi — bo to znatno pospešilo njeno odpravo.
Menim, da je zdaj jasno, zakaj statična analiza ne izboljšuje kakovosti izdelka, če se uporablja epizodično, in bi morala biti uporabljena stalno za filtriranje sprememb z grobimi napakami. Vprašanje, ali bo uporaba statičnega analitik izboljšala kakovost vašega izdelka, je približno enako vprašanju 'ali se bodo pitne lastnosti vode, vzete iz umazanega vodnjaka, izboljšale, če jo bomo prefiltrirali skozi cedilo?'
Vključitev v legacy-projekt
Pomembno praktično vprašanje: kako vključiti statično analizo v proces neprestanega integriranja kot "quality gate"? V primeru avtomatskih testov je vse jasno: obstaja niz testov, kjer je vsak neuspeh dovolj, da menimo, da zbirka ni prestala quality gate. Poskusiti postaviti gate na podlagi rezultatov statične analize pa propade: pri legacy kodi je preveč opozoril, ki jih analiza prikaže, popolnoma jih ignorirati nočemo, a hkrati ni mogoče ustaviti dostave izdelka zgolj zato, ker so v njem opozorila analizatorja.
Ko ga prvič uvedemo, analizador na katerem koli projektu izdaja ogromno število opozoril, ki večinoma nimajo zveze s pravilnim delovanjem izdelka. Takoj popraviti vseh teh pripomb ni mogoče, številnih tudi ni treba. Na koncu koncev, vemo, da naš izdelek na splošno deluje, in to pred uvedbo statične analize!
Kot rezultat se mnogi omejijo na občasno uporabo statične analize ali jo uporabljajo le v informativnem načinu, ko se pri gradnji preprosto izda poročilo analizatorja. To je ekvivalentno odsotnosti kakršne koli analize, saj če imamo že veliko opozoril, bo pojavitev še enega (ne glede na to, kako resno) ob spremembi kode ostala neopažena.
Poznani so naslednji načini uvedbe quality gates:
- Nastavitev omejitve skupnega števila opozoril ali števila opozoril, deljenega s številom vrstic kode. To slabo deluje, saj takšen gate prosto spusti spremembe z novimi napakami, dokler njihova omejitev ni presežena.
- Zagotavljanje, da so vsi stari opozorila v kodi na nekem mestu označeni kot prezrta, in zavrnitev gradnje pri pojavu novih opozoril. To funkcionalnost omogočata PVS-studio in nekateri spletni viri, kot je Codacy. Nisem delal s PVS-studio, kar se tiče mojih izkušenj s Codacy, pa je njihova glavna težava v tem, da je ugotavljanje, katera napaka je 'stara', in katera 'nova' - precej zapleteno in algoritem ne deluje vedno pravilno, posebej, če se datoteke močno spreminjajo ali preimenujejo. Spomnim se, da je Codacy lahko v pull requestu spustil nova opozorila, hkrati pa zavrnil pull request zaradi opozoril, ki niso povezana s spremembami v kodi tega PR.
- Po mojem mnenju je najučinkovitejša rešitev opisana v knjigi »metoda zasuka« (»ratcheting«). Osnovna ideja je, da je lastnost vsakršne izdaje število opozoril statične analize, in dovoljena so le tista spremembe, ki skupno število opozoril ne povečajo.
Zasuk
Deluje tako:
- V začetni fazi se zabeleži v metapodatkih o izdaji število opozoril v kodi, ki jih najdejo analizatorji. Tako se ob gradnji glavne veje v vašem upravljalniku repozitorijev ne zabeleži le 'različica 7.0.2', temveč 'različica 7.0.2, ki vsebuje 100500 opozoril Checkstyle'. Če uporabljate napreden upravljalnik repozitorijev (kot je Artifactory), je shranjevanje takih metapodatkov o vaši izdaji enostavno.
- Zdaj vsak pull request pri gradnji primerja število pridobljenih opozoril s tistim, ki ga ima trenutna izdaja. Če PR poveča to število, koda ne prestane kvalitativnega preizkusa s statično analizo. Če se število opozoril zmanjša ali ne spremeni - to prestane.
- Ob naslednji izdaji bo ponovno izračunano število opozoril zabeleženo v metapodatkih izdaje.
Tako pomalo, ali postepeno (kao kod rada zakretača), broj upozorenja će težiti nuli. Naravno, sistem se može prevariti dodavanjem novog upozorenja, ali ispravkom tuđeg. To je u redu, jer na duge staze daje rezultat: upozorenja se obično ispravljaju ne pojedinačno, već odmah u grupama određenog tipa, i sva lako uklonjiva upozorenja dosta brzo nestaju.
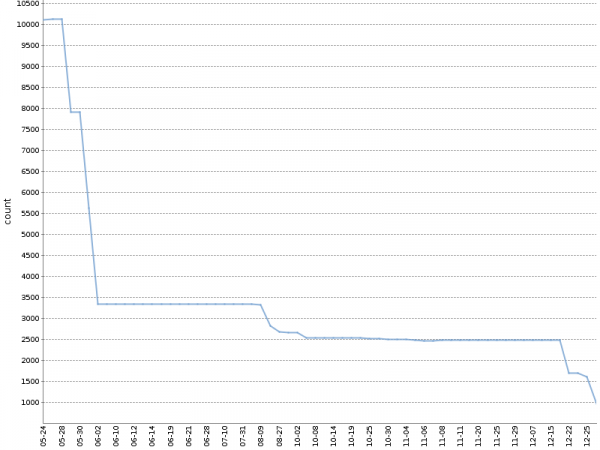
Na ovom grafikonu prikazan je ukupni broj Checkstyle upozorenja tokom šest meseci rada takvog "zakretača" na . Broj upozorenja se smanjio za red, pri čemu je to prirodno desilo, paralelno sa razvojem proizvoda!
Primjenjujem modifikovanu verziju ove metode, posebno računajući upozorenja po modulima projekta i alatima analize, dok generisani YAML fajl sa metapodacima o izgradnji izgleda otprilike ovako:
celesta-sql:
  checkstyle: 434
  spotbugs: 45
celesta-core:
  checkstyle: 206
  spotbugs: 13
celesta-maven-plugin:
  checkstyle: 19
  spotbugs: 0
celesta-unit:
  checkstyle: 0
  spotbugs: 0
U svakom naprednom CI sistemu "zakretač" se može implementirati za sve alate statičke analize, ne oslanjajući se na pluginove i spoljne alate. Svaki od analizatora daje svoj izveštaj u jednostavnom tekstualnom ili XML formatu, koji se lako može analizirati. Ostaje samo da se napiše potrebna logika u CI skripti. Možete pogledati kako je to implementirano u našim open-source projektima na bazi Jenkins i Artifactory. ili . Oba primera zavise od biblioteke : metod countWarnings() obićno broji xml tagove u datotekama koje generišu Checkstyle i Spotbugs, a compareWarningMaps() implementira taj zakretač, izbacujući grešku u slučaju kada se broj upozorenja u bilo kojoj od kategorija poveća.
Zanimljiv način implementacije „ratchet” moguće je za analizu pravopisa komentara, tekstualnih literalnih i dokumentacije uz pomoć aspell. Kao što je poznato, prilikom provere pravopisa, ne svaka reč koja nije poznata standardnom rečniku je pogrešna; one mogu biti dodate u korisnički rečnik. Ako se korisnički rečnik napravi delom izvornog koda projekta, pravilo kvaliteta za pravopis može se formulirati na sledeći način: izvođenje aspell-a sa standardnim i korisničkim rečnikom. da pronalazi nikakve greške u pravopisu.
O važnosti fiksiranja verzije analizatora
Na kraju se mora napomenuti sledeće: bez obzira na to kako implementirate analizu u vašem procesu isporuke, verzija analizatora mora biti fiksirana. Ako dođe do samovoljna ažuriranja analizatora, prilikom izgradnje sledećeg pull request-a mogu se „pojaviti” nove greške koje nisu povezane sa promenom koda, već su rezultat toga što novi analizator jednostavno može pronaći više grešaka — i to će pokvariti vaš proces prihvatanja pull request-ova. Ažuriranje analizatora mora biti svesna odluka. Ipak, stroga fiksacija verzije svake komponente izgradnje je u svakom slučaju neophodan zahtev i tema za zasebnu raspravu.
Zaključki
- Statička analiza neće vam pronaći greške i ne poboljšava kvalitet vašeg proizvoda kao rezultat jednorazne primene. Pozitivan efekat na kvalitet donosi samo njeno stalno korišćenje u procesu isporuke.
- Pronalaženje grešaka uopšte nije glavni cilj analize; ogromna većina korisnih funkcija dostupna je u opensource alatima.
- Implementirajte pravila kvaliteta prema rezultatima statičke analize na samom početku procesa isporuke, koristeći „ratchet” za legacy kod.
Povezave
- izveštaj o različitim metodama analize koda (ne samo statičkoj!)
Izvor: habr.com
