

Ta opomba bo zanimiva za tiste, ki uporabljajo knjižnico za obdelavo tabelarnih podatkov za R — data.table, in morda bodo veseli, da vidijo prilagodljivost njene uporabe na različnih primerih.
Navdihnjen z dobrim primerom , in upajoč, da ste že prebrali njegov članek, predlagam, da se poglobimo v optimizacijo kode in uspešnost na podlagi data.table.
Uvod: od kod prihaja data.table?
Najbolje je začeti spoznavanje knjižnice nekoliko z razdalje, natančneje, s podatkovnimi strukturami, iz katerih lahko nastane objekt data.table (naprej DT).
Matrika
Код
## arrays ---------

arrmatr <- array(1:20, c(4,5))

class(arrmatr)

typeof(arrmatr)

is.array(arrmatr)

is.matrix(arrmatr)
Ena od teh struktur je matrika (?base::array). Tako kot v drugih jezikih so matrike tukaj večdimenzionalne. Vendar je zanimivo, da na primer dvodimenzionalna matrika začne podedovati lastnosti razreda matrike (?base::matrix), enodimenzionalna matrika pa, kar je prav tako pomembno, ne podeduje od vektorja (?base::vector).
Pri tem je treba razumeti, da je vrsto podatkov, ki jih vsebuje določen objekt, treba preveriti s funkcijo base::typeof, ki vrne notranji opis vrste v skladu z R Internals — splošnim protokolom jezika, povezanem s prvotno C.
Še ena ukaz, za določitev razreda objekta, base::class, vrne v primeru vektorjev vektorsko vrsto (razlikuje se po imenu od notranje, a omogoča tudi razumevanje vrste podatkov).
Lista
Iz dvodimenzionalne matrike, ki je tudi matrika, se lahko preide v seznam (?base::list).
Код
## lists ------------------

mylist <- as.list(arrmatr)

is.vector(mylist)

is.list(mylist)
Pri tem se zgodijo takoj več stvari:
- Druga dimenzija matrike se skrči, kar pomeni, da hkrati dobimo tako seznam kot vektor.
- Seznam tako podeduje od teh razredov. Treba je imeti v mislih, da bo enemu elementu seznama ustrezalo eno (skalarnost) vrednost iz celice matrike-matrika.
Zaradi tega, ker je seznam prav tako vektor, mu je mogoče uporabljati nekatere funkcije za vektorje.
Podatkovni okvir
Iz seznama, matrike ali vektorja se lahko preide v podatkovni okvir (?base::data.frame).
Код
## data.frames ------------

df <- as.data.frame(arrmatr)
df2 <- as.data.frame(mylist)

is.list(df)

df$V6 <- df$V1 + df$V2
Kar je zanimivo: podatkovni okvir podeduje od seznama! Stolpci podatkovnega okvira so celice seznama. To bo pomembno kasneje, ko bomo uporabljali funkcije, uporabljene za sezname.
data.table
Obtežimo DT (?data.table::data.table) lahko iz podatkovnega okvira, seznama, vektorja ali matrike. Na primer, tako (v prostoru).
Код
## data.tables -----------------------
library(data.table)

data.table::setDT(df)

is.list(df)

is.data.frame(df)

is.data.table(df)
Koristno je to, da DT, tako kot podatkovni okvir, podeduje lastnosti seznama.
DT in pomnilnik
V nasprotju z vsemi drugimi objekti v R base, DT se prenašajo po referenci. Če potrebujete kopiranje v novo območje pomnilnika, potrebujete funkcijo data.table::copy ali morate iz starega objekta izbrati podmnožico.
Код
df2 <- df

df[V1 == 1, V2 := 999]

data.table::fsetdiff(df, df2)

df2 <- data.table::copy(df)

df[V1 == 2, V2 := 999]

data.table::fsetdiff(df, df2)
S tem se uvod končuje. DT je nadaljevanje razvoja podatkovnih struktur v R, ki se večinoma dogaja s povečanjem in pospeševanjem operacij, ki se izvajajo nad objekti razreda podatkovni okvir. Hkrati pa ohranja dedovanje od drugih primitivov.
Nekaj primerov uporabe lastnosti data.table
Kot seznam…
Iteracija po vrsticah podatkovnega okvirja ali DT ni najboljša ideja, saj je koda z zanko v jeziku R precej počasnejša C, po drugi strani pa je iteracija po stolpcih, katerih je praviloma precej manj, povsem izvedljiva. Med iteracijo po stolpcih imejmo v mislih, da je vsak stolpec element seznama, ki običajno vsebuje vektor. Operacije nad vektorji so dobro vektorizirane v osnovnih funkcijah jezika. Prav tako lahko uporabimo operaterje izbire, ki so značilni za sezname in vektorje: `[[`, `$`.
Код
## operations on data.tables ------------

#using list properties

df$'V1'[1]

df[['V1']]

df[[1]][1]

sapply(df, class)

sapply(df, function(x) sum(is.na(x)))
Vektorizacija
Če je potrebno iti po vrsticah velikega DT, bo najboljša rešitev napisati funkcijo z vektorizacijo. Če to ne deluje, pa je treba pomisliti, da je zanka inside DT še vedno hitrejša od zanke v R, saj se izvaja na C.
Poskusimo na večjem primeru s 100K vrsticami. Izkopali bomo prvo črko iz besed, ki so vključene v vektorsko kolumno. w.
Updated
Код
library(magrittr)
library(microbenchmark)

## Večji primer ----

rown <- 100000

dt %
	.[, d := 1 + b + c + rnorm(nrow(.))]

# vektorizacija

microbenchmark({
	dt[
		, first_l := unlist(strsplit(w, split = ' ', fixed = T))[1]
		, by = 1:nrow(dt)
	   ]
})

# drugi

first_l_f %
		do.call(rbind, .) %>%
		`[`(,1)
}

dt[, first_l := NULL]

microbenchmark({
	dt[
		, first_l := .(first_l_f(w))
		]
})

# tretji

first_l_f2 %
		unlist %>%
		matrix(nrow = 3) %>%
		`[`(1,)
}

dt[, first_l := NULL]

microbenchmark({
	dt[
		, first_l := .(first_l_f2(w))
		]
})
Prvi prehod z iteracijo po vrsticah:
Unit: milisekunde
expr min
{ dt[, `:=`(first_l, unlist(strsplit(w, split = " ", fixed = T))[1]), by = 1:nrow(dt)] } 439.6217
lq mean median uq max neval
451.9998 460.1593 456.2505 460.9147 621.4042 100
Drugi krog, kjer se vektorizacija odvija preko pretvorbe seznama v matriko in pridobitvi elementov na rezini z indeksom 1 (to je v bistvu vektorizacija). Popravil se bom: vektorizacija na ravni funkcije strsplit, ki zna sprejeti vektor kot vhod. Izkazalo se je, da je postopek pretvorbe seznama v matriko veliko težji od same vektorizacije, a je že v tem primeru veliko hitrejši od ne-vektorizirane različice.
Unit: milisekunde
expr min lq mean median uq max neval
{ dt[, `:=`(first_l, .(first_l_f(w)))] } 93.07916 112.1381 161.9267 149.6863 185.9893 442.5199 100
Pospešitev po mediani je 3-krat.
Tretji krog, kjer je spremenjen postopek pretvorbe v matriko.
Unit: milisekunde
expr min lq mean median uq max neval
{ dt[, `:=`(first_l, .(first_l_f2(w)))] } 32.60481 34.13679 40.4544 35.57115 42.11975 222.972 100
Pospešitev po mediani je 13-krat.
S to zadevo je treba eksperimentirati, več kot je — boljše bo.
Še en primer z vektorizacijo, kjer je tudi besedilo, vendar je približano realnim pogojem: različne dolžine besed, različno število besed. Potrebno je vzeti prvih 3 besede. Tako:
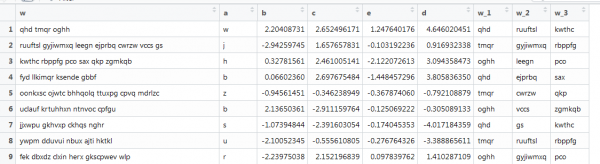
Tukaj prejšnja funkcija ne deluje, saj so vektorji različne dolžine, mi pa smo nastavili velikost matrike. Predelali bomo to, ko bomo pobrskali po internetu.
Код
# fourth

rown <- 100000

words <-
	sapply(
		seq_len(rown)
		, function(x){
			nwords <- rbinom(1, 10, 0.5)
			paste(
				sapply(
					seq_len(nwords)
					, function(x){
						paste(sample(letters, rbinom(1, 10, 0.5), replace = T), collapse = '')
					}
				)
				, collapse = ' '
			)
		}
	)

dt <-
	data.table(
		w = words
		, a = sample(letters, rown, replace = T)
		, b = runif(rown, -3, 3)
		, c = runif(rown, -3, 3)
		, e = rnorm(rown)
	) %>%
	.[, d := 1 + b + c + rnorm(nrow(.))]

first_l_f3 <- function(sd, n)
{
	l <- strsplit(sd, split = ' ', fixed = T)

	maxl <- max(lengths(l))

	sapply(l, "length<-", maxl) %>%
		`[`(n,) %>%
		as.character
}

microbenchmark({
	dt[
		, (paste0('w_', 1:3)) := lapply(1:3, function(x) first_l_f3(w, x))
		]
})

dt[
	, (paste0('w_', 1:3)) := lapply(1:3, function(x) first_l_f3(w, x))
	]
Unit: milisekunde
expr min lq mean median
{ dt[, `:=`((paste0(«w_», 1:3)), strsplit(w, split = " ", fixed = T))] } 851.7623 916.071 1054.5 1035.199
uq max neval
1178.738 1356.816 100
Skript je deloval s povprečno hitrostjo 1 sekundo. Ni slabo.
Povezano z eno verigo...
Z objekti DT lahko delamo s chainingom. Izgleda kot pripenjanje sintakse oklepajev desno, v bistvu gre za sladkor.
Код
# chaining

res1 <- dt[a == 'a'][sample(.N, 100)]

res2 <- dt[, .N, a][, N]

res3 <- dt[, coefficients(lm(e ~ d))[1], a][, .(letter = a, coef = V1)]
Teče po cevovodih...
Taka opravila je mogoče izvesti preko piping, izgleda podobno, a funkcionalno je bogatejša, saj lahko uporabimo katere koli metode, ne le DT. Prikazali bomo koeficiente logistične regresije za naše sintetične podatke z vrsto filtrov na DT.
Код
# piping

samplpe_b <- dt[a %in% head(letters), sample(b, 1)]

res4 <-
	dt %>%
	.[a %in% head(letters)] %>%
	.[,
	  {
	  	dt0 <- .SD[1:100]

	  	quants <-
	  		dt0[, c] %>%
	  		quantile(seq(0.1, 1, 0.1), na.rm = T)

	  	.(q = quants)
	  }
	  , .(cond = b > samplpe_b)
	  ] %>%
	glm(
		cond ~ q -1
		, family = binomial(link = "logit")
		, data = .
	) %>%
	summary %>%
	.[[12]]
Statistika, strojno učenje in drugo znotraj DT
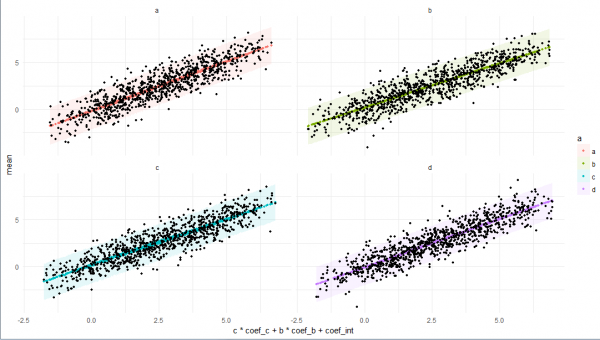
Lahko uporabimo lambda funkcije, a je včasih bolje, da jih ustvarimo ločeno, zapišemo celoten pipeline analize podatkov in naprej — delujejo znotraj DT. Primer je obogaten z vsemi zgoraj omenjenimi funkcijami, plus nekaj koristnih stvari iz arzenala DT (kot je dostop do samega DT znotraj DT preko povezave, vstavljenih včasih ne zaporedno, a za boljšo predstavo).
Код
# function

rm(lm_preds)

lm_preds <- function(
	sd, by, n
)
{

	if(
		n < 100 |
		!by[['a']] %in% head(letters, 4)
	   )
	{

		res <-
			list(
				low = NA
				, mean = NA
				, high = NA
				, coefs = NA
			)

	} else {

		lmm <-
			lm(
				d ~ c + b
				, data = sd
			)

		preds <-
			stats::predict.lm(
				lmm
				, sd
				, interval = "prediction"
				)

		res <-
			list(
				low = preds[, 2]
				, mean = preds[, 1]
				, high = preds[, 3]
				, coefs = coefficients(lmm)
			)
	}

	res

}

res5 <-
	dt %>%
	.[e < 0] %>%
	.[.[, .I[b > 0]]] %>%
	.[, `:=` (
		low = as.numeric(lm_preds(.SD, .BY, .N)[[1]])
		, mean = as.numeric(lm_preds(.SD, .BY, .N)[[2]])
		, high = as.numeric(lm_preds(.SD, .BY, .N)[[3]])
		, coef_c = as.numeric(lm_preds(.SD, .BY, .N)[[4]][1])
		, coef_b = as.numeric(lm_preds(.SD, .BY, .N)[[4]][2])
		, coef_int = as.numeric(lm_preds(.SD, .BY, .N)[[4]][3])
	)
	, a
	] %>%
	.[!is.na(mean), -'e', with = F]


# plot

plo <-
	res5 %>%
	ggplot +
	facet_wrap(~ a) +
	geom_ribbon(
		aes(
			x = c * coef_c + b * coef_b + coef_int
			, ymin = low
			, ymax = high
			, fill = a
		)
		, size = 0.1
		, alpha = 0.1
	) +
	geom_point(
		aes(
			x = c * coef_c + b * coef_b + coef_int
			, y = mean
			, color = a
		)
		, size = 1
	) +
	geom_point(
		aes(
			x = c * coef_c + b * coef_b + coef_int
			, y = d
		)
		, size = 1
		, color = 'black'
	) +
	theme_minimal()

print(plo)
Zaključek
Upam, da sem uspel ustvariti celovito, a seveda ne popolno sliko objekta, kot je data.table, ki sega od njegovih lastnosti, povezanih z dedovanjem iz razredov R, do njegovih lastnih posebnosti in okolja elementov tidyverse. Upam, da vam bo to pomagalo bolje spoznati in uporabljati to knjižnico za delo in razvedrilni.
Hvala!
Celotna koda
Код
## load libs ----------------

library(data.table)
library(ggplot2)
library(magrittr)
library(microbenchmark)


## arrays ---------

arrmatr <- array(1:20, c(4,5))

class(arrmatr)

typeof(arrmatr)

is.array(arrmatr)

is.matrix(arrmatr)


## lists ------------------

mylist <- as.list(arrmatr)

is.vector(mylist)

is.list(mylist)


## data.frames ------------

df <- as.data.frame(arrmatr)

is.list(df)

df$V6 <- df$V1 + df$V2


## data.tables -----------------------

data.table::setDT(df)

is.list(df)

is.data.frame(df)

is.data.table(df)

df2 <- df

df[V1 == 1, V2 := 999]

data.table::fsetdiff(df, df2)

df2 <- data.table::copy(df)

df[V1 == 2, V2 := 999]

data.table::fsetdiff(df, df2)


## operations on data.tables ------------

#using list properties

df$'V1'[1]

df[['V1']]

df[[1]][1]

sapply(df, class)

sapply(df, function(x) sum(is.na(x)))


## Bigger example ----

rown <- 100000

dt <-
	data.table(
		w = sapply(seq_len(rown), function(x) paste(sample(letters, 3, replace = T), collapse = ' '))
		, a = sample(letters, rown, replace = T)
		, b = runif(rown, -3, 3)
		, c = runif(rown, -3, 3)
		, e = rnorm(rown)
	) %>%
	.[, d := 1 + b + c + rnorm(nrow(.))]

# vectorization

# zero - for loop

microbenchmark({
	for(i in 1:nrow(dt))
		{
		dt[
			i
			, first_l := unlist(strsplit(w, split = ' ', fixed = T))[1]
		]
	}
})

# first

microbenchmark({
	dt[
		, first_l := unlist(strsplit(w, split = ' ', fixed = T))[1]
		, by = 1:nrow(dt)
	   ]
})

# second

first_l_f <- function(sd)
{
	strsplit(sd, split = ' ', fixed = T) %>%
		do.call(rbind, .) %>%
		`[`(,1)
}

dt[, first_l := NULL]

microbenchmark({
	dt[
		, first_l := .(first_l_f(w))
		]
})

# third

first_l_f2 <- function(sd)
{
	strsplit(sd, split = ' ', fixed = T) %>%
		unlist %>%
		matrix(nrow = 3) %>%
		`[`(1,)
}

dt[, first_l := NULL]

microbenchmark({
	dt[
		, first_l := .(first_l_f2(w))
		]
})

# fourth

rown <- 100000

words <-
	sapply(
		seq_len(rown)
		, function(x){
			nwords <- rbinom(1, 10, 0.5)
			paste(
				sapply(
					seq_len(nwords)
					, function(x){
						paste(sample(letters, rbinom(1, 10, 0.5), replace = T), collapse = '')
					}
				)
				, collapse = ' '
			)
		}
	)

dt <-
	data.table(
		w = words
		, a = sample(letters, rown, replace = T)
		, b = runif(rown, -3, 3)
		, c = runif(rown, -3, 3)
		, e = rnorm(rown)
	) %>%
	.[, d := 1 + b + c + rnorm(nrow(.))]

first_l_f3 <- function(sd, n)
{
	l <- strsplit(sd, split = ' ', fixed = T)

	maxl <- max(lengths(l))

	sapply(l, "length<-", maxl) %>%
		`[`(n,) %>%
		as.character
}

microbenchmark({
	dt[
		, (paste0('w_', 1:3)) := lapply(1:3, function(x) first_l_f3(w, x))
		]
})

dt[
	, (paste0('w_', 1:3)) := lapply(1:3, function(x) first_l_f3(w, x))
	]


# chaining

res1 <- dt[a == 'a'][sample(.N, 100)]

res2 <- dt[, .N, a][, N]

res3 <- dt[, coefficients(lm(e ~ d))[1], a][, .(letter = a, coef = V1)]

# piping

samplpe_b <- dt[a %in% head(letters), sample(b, 1)]

res4 <-
	dt %>%
	.[a %in% head(letters)] %>%
	.[,
	  {
	  	dt0 <- .SD[1:100]

	  	quants <-
	  		dt0[, c] %>%
	  		quantile(seq(0.1, 1, 0.1), na.rm = T)

	  	.(q = quants)
	  }
	  , .(cond = b > samplpe_b)
	  ] %>%
	glm(
		cond ~ q -1
		, family = binomial(link = "logit")
		, data = .
	) %>%
	summary %>%
	.[[12]]


# function

rm(lm_preds)

lm_preds <- function(
	sd, by, n
)
{

	if(
		n < 100 |
		!by[['a']] %in% head(letters, 4)
	   )
	{

		res <-
			list(
				low = NA
				, mean = NA
				, high = NA
				, coefs = NA
			)

	} else {

		lmm <-
			lm(
				d ~ c + b
				, data = sd
			)

		preds <-
			stats::predict.lm(
				lmm
				, sd
				, interval = "prediction"
				)

		res <-
			list(
				low = preds[, 2]
				, mean = preds[, 1]
				, high = preds[, 3]
				, coefs = coefficients(lmm)
			)
	}

	res

}

res5 <-
	dt %>%
	.[e < 0] %>%
	.[.[, .I[b > 0]]] %>%
	.[, `:=` (
		low = as.numeric(lm_preds(.SD, .BY, .N)[[1]])
		, mean = as.numeric(lm_preds(.SD, .BY, .N)[[2]])
		, high = as.numeric(lm_preds(.SD, .BY, .N)[[3]])
		, coef_c = as.numeric(lm_preds(.SD, .BY, .N)[[4]][1])
		, coef_b = as.numeric(lm_preds(.SD, .BY, .N)[[4]][2])
		, coef_int = as.numeric(lm_preds(.SD, .BY, .N)[[4]][3])
	)
	, a
	] %>%
	.[!is.na(mean), -'e', with = F]


# plot

plo <-
	res5 %>%
	ggplot +
	facet_wrap(~ a) +
	geom_ribbon(
		aes(
			x = c * coef_c + b * coef_b + coef_int
			, ymin = low
			, ymax = high
			, fill = a
		)
		, size = 0.1
		, alpha = 0.1
	) +
	geom_point(
		aes(
			x = c * coef_c + b * coef_b + coef_int
			, y = mean
			, color = a
		)
		, size = 1
	) +
	geom_point(
		aes(
			x = c * coef_c + b * coef_b + coef_int
			, y = d
		)
		, size = 1
		, color = 'black'
	) +
	theme_minimal()

print(plo)
Izvor: habr.com
