

Pozdravljeni, in najprej malo lirike. Občasno zavidam kolegom, ki delajo na daljavo — saj je čudovito imeti priložnost delati z kateregakoli konca sveta, povezanega z Internetom, dopust kadarkoli, odgovornost za projekte in roke, ne pa biti v pisarni od 8. do 17. Moja pozicija in delovne naloge praktično izključujejo možnost dolge odsotnosti v podatkovnem centru. Vendar pa se občasno zgodijo zanimivi primeri, kot je opisano spodaj — in zavedam se, da obstaja le malo pozicij, kjer je toliko svobode za ustvarjalno izražanje notranjega troubleshooterja.
Majhna opomba — ob pisanju članka primer ni bil popolnoma rešen, vendar upoštevajoč hitrost odziva dobaviteljev, lahko popolna rešitev traja še mesece, in deliti svoje ugotovitve želim že zdaj. Upam, da me boste, cenjeni bralci, oprostili te naglice. Ampak dovolj vode — kaj se dogaja s primerom?
Najprej uvod: obstaja podjetje (kjer delam kot omrežni inženir), ki gosti rešitve strank v zasebnem oblaku VMWare. Večina novih rešitev se povezuje na VXLAN segmente, ki jih upravlja NSX-V — ne bom ocenjeval, koliko časa mi je ta rešitev prihranila, na kratko povedano — veliko. Uspešno sem celo usposobil kolege za nastavitev NSX ESG in majhne rešitve strank se postavijo brez mojega sodelovanja. Pomembna opomba — kontrollna raven pri nas ima unicast replikacijo. Hipervizorji so povezani redundantno z dvema vmesnikoma na različne fizične stikala Juniper QFX5100 (zbirana v Virtual Chassis) in politiko usklajevanja temelji na izvorni virtualni vratni oznaki — to je za popolno sliko.
Rešitve strank so zelo raznolike: od Windows IIS, kjer so vsi sestavni deli spletnega strežnika nameščeni na eni napravi, do precej večjih — na primer uravnoteženi Apache spletni obrazi + LB MariaDB v Galera + datotečni strežniki, sinhronizirani s pomočjo GlusterFS. Skoraj vsak strežnik je treba spremljati posebej, javni naslovi pa niso pri vseh sestavnih delih — če ste se soočili s to nalogo in imate bolj elegantno rešitev, bom vesel nasveta.
Moja rešitev za spremljanje se sestavlja iz "povezave" požarnega zidu (Fortigate) v vsak notranji klientski omrežji (+SNAT in seveda stroge omejitve glede dovoljenega prometa) in spremljanja notranjih naslovov — na ta način dosežemo določeno unifikacijo in poenostavitev spremljanja. Samo spremljanje poteka iz gruče strežnikov PRTG. Načrt spremljanja je približno tak:
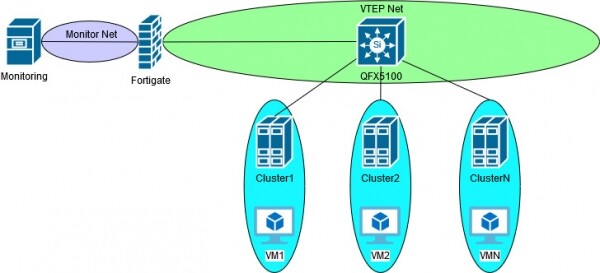
Dokler smo delali le z VLAN-om, je vse delovalo povsem običajno in predvidljivo, kot ura. Po uvedbi NSX-V in VXLAN-a smo naleteli na vprašanje — ali lahko še naprej spremljamo na star način? Ob času tega vprašanja je bila najelegantnejša rešitev postavitev NSX ESG in povezava VXLAN trunk v VTEP omrežje. Hitro v navednicah — saj uporaba GUI za nastavitev klientskih omrežij, SNAT in pravil požarnega zidu sicer poenoti upravljanje v enotnem vmesniku vSphere, vendar po mojem mnenju precej otežuje in poleg vsega omejuje nabor orodij za reševanje težav. Tisti, ki so uporabljali NSX ESG kot zamenjavo za "pravi" požarni zid, se mislim, da se bodo strinjali. Čeprav bi bila taka rešitev verjetno bolj stabilna — saj se vse dogaja v okviru enega prodajalca.
Še ena rešitev je uporaba NSX DLR v načinu mostu med VLAN in VXLAN. Tukaj mislim, da je vse jasno — preprosto izginja korist uporabe VXLAN — saj je v tem primeru še vedno potrebno pripeljati VLAN do monitoring-instalacije. Mimogrede, med obdelavo te rešitve sem se srečal s težavo, ko DLR-most ni pošiljal paketov virtualki, s katero je bil na istem gostitelju. Vem, vem — v knjigah in vodičih po NSX-V je jasno navedeno, da mora biti za NSX Edge dodeljen ločen grozd, ampak to je v knjigah… Tako ali tako, po nekaj mesecih s podporo težave nismo rešili. V bistvu sem razumel logiko delovanja — modul jedra hipervizorja, odgovoren za enkapsulacijo VXLAN, ni bil uporabljen, če sta bila DLR in opazovani strežnik na istem gostitelju, saj promet ne zapusti gostitelja in po logiki bi moral biti priključen na VXLAN segment — enkapsulacija ni potrebna. S podporo smo se osredotočili na virtualni vmesnik vdrPort, ki logično združuje uplinke in hkrati izvaja mostovanje/enkapsulacijo — tam je bila opažena neskladnost v vhodnem prometu, ki sem ga vzel za obdelavo v trenutnem primeru. Ampak kot je bilo rečeno, tega primera nisem dokončal, saj sem bil prenesen na drug projekt in tudi ta veja je bila od začetka brezizhodna, zato nisem imel posebne želje, da bi jo razvijal. Če se ne motim, je bila težava opažena v različicah NSX 6.1.4 in 6.2.
In tukaj — bingo! Fortinet napoveduje nativno . In ne samo point-to-point ali VXLAN-over-IPSec, ne programsko mostovanje VLAN-VXLAN — vse to so začeli uvajati že z različico 5.4 (in predstavljeno pri drugih ), and the actual support of the unicast control plane. When implementing the solution, I encountered another issue — the monitored servers would periodically 'disappear' and then reappear in monitoring, although the virtual machine itself was alive. The reason, as it turned out, was that I forgot to enable Ping on the VXLAN interface. During the rebalancing of clusters, the virtual machines were moved, while Ping completed the vMotion to indicate the new ESXI host to which the machine had been moved. A foolish mistake on my part, but this problem once again undermined my trust in the support from the manufacturer — in this case, Fortinet. I won't even mention that every case related to VXLAN begins with the question 'where is your softswitch VLAN-VXLAN settings?' This time I was advised to change the MTU — this is for the Ping, which is 32 bytes. Then 'play around' with tcp-send-mss and tcp-receive-mss in the policy — for the VXLAN, which is encapsulated in UDP. Phew, sorry — I needed to vent. In general, I resolved this issue on my own.
After successfully testing the traffic, it was decided to implement this solution. And in production, it turned out that after a day or two, everything monitored through VXLAN gradually disconnects entirely. Deactivating/activating the interface helped, but only temporarily. Knowing the sluggishness of the manufacturer's support, I took on troubleshooting myself — after all, my company, my network — my responsibility.
Troubleshooting progress under the spoiler. Those tired of letters and boasting — skip ahead to the post-analysis.
Troubleshooting progressThank you for continuing to read — let's continue!
So, monitoring works for some time, then disconnects on its own. This means there are probably no issues in the firewall policies. However, since I've encountered problems with hanging system processes in Fortigate versions 5.6+, the first thing we check is 'diagnose debug flow' — as expected, traffic is allowed and leaves the interface, and as expected, nothing comes back in response. This means we dig further down the stack. Unfortunately, I will have to hide addresses even if they are RFC1918, but I hope to provide enough description for understanding. The server inside the VXLAN has the address x.x.x.15, the Fortigate interface x.x.x.254, and all other addresses belong to the VTEP network.
Za uspešno prenos VXLAN encapsulated paketov je potrebno, da so informacije pravilne v več tabelah. Za overlay to sta ARP in OVSDB, za underlay pa ARP in CAM. V primeru Fortigate je VXLAN FDB pravzaprav OVSDB. Tam bomo začeli:
 fortigate (root) #diag sys vxlan fdb list vxlan-LS
mac=00:50:56:8f:3f:5a state=0x0002 flags=0x00 remote_ip=у.у.у.47 port=4789 vni=5008 ifindex=7
Tukaj je vse zelo preprosto — MAC naslov virtualnega stroja mora biti na VTEP z naslovom у.у.у.47. Ko pogledam vsebino in nastavitve ESXI grozda, ugotovim, da je MAC virtualnega stroja pravilen, naslov VTEP prav tako. Preverim CAM/ARP tabelo na Fortigate — spet vse ustreza nastavitvam ESXI gostitelja:
fortigate (root) #get sys arp | grep у.у.у.47
у.у.у.47 0 00:50:56:65:f6:2c dmz
Tabele so pravilne in promet odhaja — morda težava ni na Fortigate? Namenoma sem izpustil analizo usmerjanja prometa na Juniperju — logično je, da bi to moralo slediti, vendar imam preprosto omrežje — le en VLAN za VTEP in vse komponente so priključene neposredno. Poleg tega se spomnim primera z DLR mostom, VDR in izginjajočim prometom — grem snifati na ESXI gostitelju, pri tem ustvarjam primer tudi za VMWare. Spodaj MAC „97:6e“ pripada Fortigate, vmnic1 — to je vmesnik, ki ima VTEP z naslovom у.у.у.47, snifamo v obeh smereh "—dir 2":
pktcap-uw --uplink vmnic1 --vni 5008 --mac 90:6c:ac:a9:97:6e --dir 2 -o /tmp/monitor.pcap
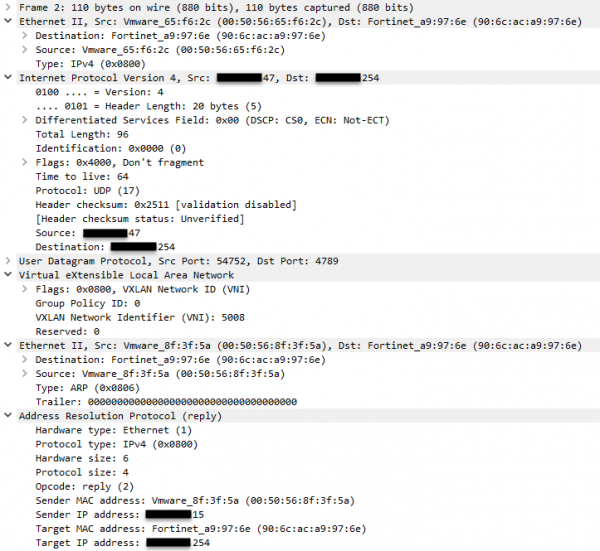
Napredek — v snifanju vidim ARP zahtevo in prejet odgovor. Prikazujem samo ARP odgovor in tam je vse pravilno. Nisem omenil, toda ves ta čas strežnik za spremljanje ping-a naslov х.х.х.15 — kje je torej ICMP promet? Spomnim se, da imam dva uplinka. Tukaj bi se dalo trditi, da je virtualni izvorni port enak (moja politika skupinskega povezovanja), torej bi moral za isto vNIC vybrati en in isti uplink, vendar ko sem že na gostitelju, ni problema preveriti drugega uplinka:
pktcap-uw --uplink vmnic4 --vni 5008 --mac 90:6c:ac:a9:97:6e --dir 2 -o /tmp/monitor.pcap
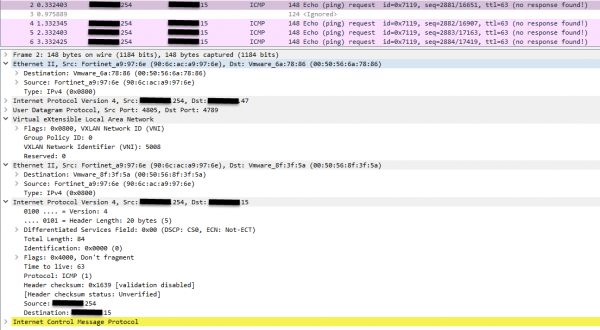
Приходит множество запросов от Fortigate, но ответов не поступает. Это явно свидетельствует о том, что проблема не в Fortigate. Я снова задумываюсь: вновь та же проблема с пропаданием трафика на VDR, снова придется потратить пару месяцев на решение этого вопроса. Через несколько дней, оставив эмоции позади и не желая принимать ситуацию как данность, решил собрать дополнительные сниффы для поддержки, чтобы ускорить процесс. И тут мой взгляд "случайно" падает на Ethernet инкапсуляцию underlay. Царь-то не настоящий, и MAC-адрес VTEP не совпадает с его IP. Сбрасываю в ноль, снифлю, выясняю — верно или не верно. Приведу ARP таблицу рядом, чтобы было удобнее сравнивать. Обратите внимание на первую Ethernet инкапсуляцию на картинке сверху:
fortigate (root) #get sys arp | grep у.у.у.47
у.у.у.47 0 00:50:56:65:f6:2c dmz
fortigate (root) #get sys arp | grep у.у.у.42
у.у.у.42 0 00:50:56:6a:78:86 dmz
Итак, что мы имеем в результате — после миграции виртуальной машины, Fortigate пытается отправить трафик на VTEP из (корректной) VXLAN FDB, но использует неправильный DST MAC, и трафик ожидаемо отбрасывается интерфейсом гипервизора. В одном случае из четырёх этот MAC принадлежал исходному гипервизору, с которого начинали миграцию машины.
Вчера получил письмо от техподдержки Fortinet — по моему запросу открыли баг 615586. Прям не знаю, радоваться или огорчаться: с одной стороны — проблема не в настройках, с другой — фикс придет только с обновлением прошивки, в лучшем случае в следующем. За счёт повышенного ЧСВ также стало известно про еще один баг, который я обнаружил в прошлом месяце, правда, в тот раз в HTML5 GUI vSphere. Прям локальный QA отдел вендоров...
Рискну предположить следующее:
1 — multicast control plane, скорее всего, не будет подвержена описанной проблеме — ведь MAC-адреса VTEP получают из IP-адреса группы, на которую подписан интерфейс.
2 — скорее всего, проблема Fortigate в оффлоаде сессий на Network Processor (приблизительно аналог CEF) — если каждый пакет пропускать через CPU, будут использоваться таблицы, содержащие правильную информацию — во всяком случае визуально. В пользу этого предположения говорит то, что помогает закрыть/открыть интерфейс или подождать некоторое время — более 5 минут.
3 — изменение политики объединения, например, на explicit failover, или внедрение LAG, проблему не решит, так как наблюдалось «застревание» MAC исходного гипервизора в инкапсулированных пакетах.
В свете этого могу поделиться, что недавно открыл для себя , kjer je bilo v enem izmed člankov trditev, da so stetfull požarni zidovi in predpomnilniški načini prenosa podatkov le rešitev na hitro. No, nisem tako izkušen v IT, da bi lahko trdil kaj takega, prav tako se ne strinjam s številnimi trditvami blogov. Vendar mi nekako govori, da je v Ivanovih besedah nekaj resnice.
Hvala za pozornost! Z veseljem bom odgovoril na vprašanja in prisluhnil konstruktivni kritiki.
Izvor: habr.com
