

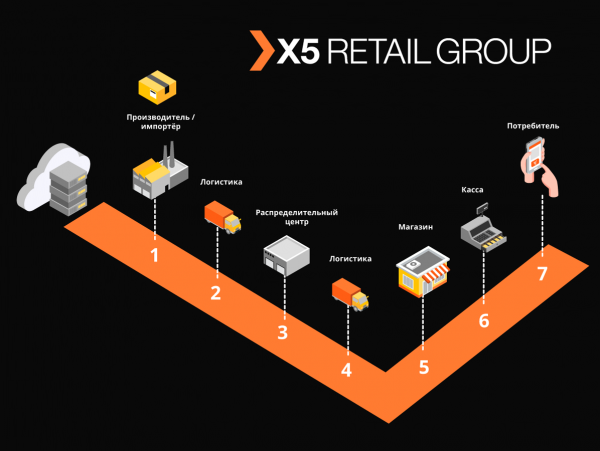
Od leta 2019 v Rusiji velja zakon o obveznem označevanju. Zakon se ne uporablja za vse skupine blaga, roki uveljavitve obveznega označevanja za različne skupine blaga pa so različni. Med prve blago, ki mora biti označeno, spadajo tobak, obutev in zdravila, kasneje pa bodo dodane še druge kategorije, na primer parfumi, tekstil in mleko. To zakonodajno novost je spodbudilo razvoj novih IT-rešitev, ki omogočajo sledenje celotni življenjski verigi blaga od proizvajalca do končnega potrošnika, vključno z vsemi udeleženci v procesu: tako država kot vse organizacije, ki prodajajo blago z obveznim označevanjem.
V podjetju X5 je sistem, ki bo sledil označenemu blagu in izmenjeval podatke z državo in dobavitelji, dobil ime “Markus”. Opišemo, kako in kdo ga je razvijal, kakšno je njegovo tehnološko okolje in zakaj se lahko ponosimo na dosežke.
Pravi HighLoad
“Markus” rešuje številne naloge, najpomembnejša pa je integracijsko sodelovanje med informacijskimi sistemi X5 in državno informacijsko sistem označenih proizvodov (GIS MP) za sledenje gibanju označenega blaga. Platforma prav tako hrani vse prejeti kode označevanja in celotno zgodovino gibanja teh kod po objektih ter pomaga preprečiti zamenjavo označenega blaga. Na primeru tobačnega blaga, ki je bilo vključeno v prve skupine označenih izdelkov, samo en tovorni avto cigaret vsebuje približno 600.000 paketov, od katerih ima vsak svoj edinstven kodo. Naloga našega sistema je slediti in preveriti zakonitost premikov vsakega takšnega paketa med skladišči in trgovinami ter v končni fazi preveriti ustreznost njihove prodaje končnemu kupcu. Zabeležimo približno 125.000 blagajniških transakcij na uro, hkrati pa je potrebno zabeležiti, kako je vsak tak paket prišel v trgovino. Tako upoštevajoč vse premeščanja med objekti pričakujemo desetine milijard zapisov na leto.
Ekipa M
Kljub temu, da je projekt „Markus“ znotraj H5 obravnavan kot projekt, se izvaja po produktnem pristopu. Ekipa dela po metodi Scrum. Projekt se je začel poleti lani, prvi rezultati pa so bili vidni šele oktobra, ko je bila povsem oblikovana lastna ekipa, razvita arhitektura sistema in kupljena oprema. Trenutno ima ekipa 16 članov, od katerih se šest ukvarja z razvojem backend in frontend, trije pa sistemsko analizo. Šest oseb se ukvarja z ročnim, obremenitvenim in avtomatiziranim testiranjem ter podporo izdelku. Poleg tega imamo tudi specialista SRE.
Kodo v naši ekipi ne pišejo le razvijalci, praktično vsi fantje znajo programirati in pišejo avtomatske teste, obremenitvene skripte in skripte za avtomatizacijo. Temu posvečamo posebno pozornost, saj tudi podpora izdelku zahteva visoko raven avtomatizacije. Kolegom, ki prej niso programirali, vedno poskušamo svetovati in pomagati ter jim dodeliti manjše naloge.
Zaradi pandemije koronavirusne okužbe smo celotno ekipo prestavili na delo na daljavo, prisotnost vseh orodij za upravljanje razvoja, zgrajen delovni tok v Jiri in GitLabu pa je omogočila, da smo ta korak enostavno prestali. Meseci dela na daljavo so pokazali, da produktivnost ekipe ni trpela, za mnoge je bilo delo bolj udobno, edina stvar, ki jo primanjkuje, je osebno srečanje.
Srečanje ekipe pred delom na daljavo
Srečanja med delom na daljavo
Tehnološki sklad rešitve
Standardno skladišče in orodje CI/CD za H5 je GitLab. Uporabljamo ga za shranjevanje kode, neprekinjeno testiranje, uvajanje na testne in produkcijske strežnike. Uporabljamo tudi prakso pregleda kode, pri kateri morata vsaj dva kolega odobriti spremembe, ki jih je predlagal razvijalec. Statični analizatorji kode SonarQube in JaCoCo nam pomagajo ohranjati kodo čisto in zagotavljati zahtevano raven kritja enotnih testov. Vse spremembe v kodi morajo obvezno prestati te preglede. Vsi testni scenariji, ki jih izvedemo ročno, se nato avtomatizirajo.
Za uspešno izvajanje poslovnih procesov s „Markusom“ smo morali rešiti vrsto tehnoloških nalog, o vsaki posebej.
Naloga 1. Potreba po horizontalni razširljivosti sistema
Za rešitev te naloge smo izbrali mikrostoritevni pristop k arhitekturi. Pri tem je bilo zelo pomembno razumeti področja odgovornosti storitev. Poskušali smo jih razdeliti po poslovnih operacijah ob upoštevanju specifike procesov. Na primer, sprejem blaga v skladišče je redka, a zelo obsežna operacija, pri kateri je treba čim hitreje pridobiti od državnega regulatorja informacije o sprejetih enotah blaga, katerih količina v enem pošiljanju doseže do 600000, preveriti dopustnost sprejema tega blaga v skladišče in predati vse potrebne informacije sistemu avtomatizacije skladišča. Odpremanje iz skladišč pa je veliko intenzivnejša, vendar se ukvarja z manjšimi volumni podatkov.
Vse storitve implementiramo po načelu stateless in tudi notranje operacije poskušamo razdeliti na korake, pri čemer uporabljamo, kot jih imenujemo, self-teme Kafka. To je, ko mikrostoritev pošlje sporočilo samo sebi, kar omogoča uravnovešanje obremenitve pri bolj zahtevnih operacijah in poenostavi vzdrževanje produkta, vendar o tem kasneje.
Odločili smo se, da bomo v ločene storitve izločili module za interakcijo z zunanjimi sistemi. To je omogočilo rešitev težave pogosto spreminjajočih se API-jev zunanjih sistemov skoraj brez vpliva na storitve s poslovno funkcionalnostjo.
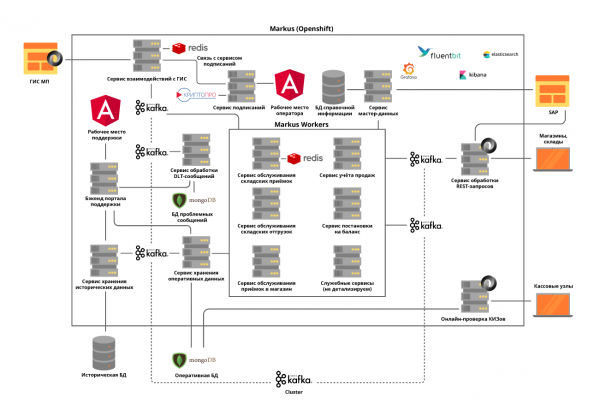
Vse mikrostoritve se uvajajo v klaster OpenShift, kar rešuje tako problem razširljivosti vsake mikrostoritve, kot nam omogoča, da ne uporabljamo zunanjih orodij za odkrivanje storitev.
Naloga 2. Potreba po ohranjanju visoke obremenitve in zelo intenzivnem izmenjavanju podatkov med storitvami platforme: samo v fazi zagon projekta se izvede približno 600 operacij na sekundo. Pričakujemo povečanje te vrednosti na 5000 operacij/sekund, ko bomo povezali trgovske objekte z našo platformo.
To solve this task, we deployed a Kafka cluster and practically completely eliminated synchronous interactions between the platform's microservices. This requires a very careful analysis of system requirements, as not all operations can be asynchronous. Additionally, we not only transmit events through the broker but also include all necessary business information in the message. As a result, the message size can reach several hundred kilobytes. The limitation on message size in Kafka requires us to accurately predict message sizes, and if necessary, we split them logically, related to business operations.
For example, goods arriving in a vehicle are divided by boxes. Separate microservices are allocated for synchronous operations, and thorough load testing is conducted. Using Kafka presented us with another challenge — ensuring our service operates effectively under Kafka integration turns all our unit tests into asynchronous ones. We addressed this task by writing our utility methods using the Embedded Kafka Broker. This does not negate the need for writing unit tests for individual methods, but we prefer to test complex cases using Kafka.
We paid a lot of attention to tracing logs to ensure that their TraceId are not lost when exceptions occur during service operations or when working with Kafka batch. While this did not raise particular issues in the first case, in the second case, we were compelled to log all TraceIds that came with the batch and select one to continue tracing. Thus, when searching by the original TraceId, the user can easily find which one the tracing continued with.
Task 3. The need to store a large volume of data: over 1 billion markings per year for tobacco alone is received by X5. They require constant and quick access. The system must process about 10 billion records regarding the movement history of marked goods.
To solve the third problem, we chose the NoSQL database MongoDB. We have built a shard consisting of 5 nodes, and each node contains a Replica Set of 3 servers. This allows us to scale the system horizontally by adding new servers v klaster, in zagotoviti njegovo odpornost proti napakam. Tukaj se soočamo z drugim problemom – zagotavljanje transakčnosti v klasterju mongo z upoštevanjem uporabe vodoravno skalabilnih mikroservisov. Na primer, ena od nalog našega sistema je prepoznavanje poskusov ponovnega prodaje blaga z enakimi številkami označb. Tukaj prihaja do težav z napačnimi skeniranji ali napačnimi operacijami blagajnikov. Ugotovili smo, da se takšne kopije lahko pojavijo tako znotraj enega obdelovanega batcha Kafka, kot tudi znotraj dveh hkrati obdelovanih batchov. Tako preverjanje pojava podvojitev s poizvedbo v bazi ni dajalo rezultatov. Za vsak mikroservis smo težavo reševali ločeno glede na poslovno logiko tega servisa. Na primer, za račune smo dodali preverjanje znotraj batcha in ločeno obdelavo za pojav podvojenih zapisov pri vstavljanju.
Da delo uporabnikov z zgodovino operacij ne bi vplivalo na najpomembnejše – delovanje naših poslovnih procesov, smo vse zgodovinske podatke izločili v ločen servis z ločeno bazo podatkov, ki prav tako prejema informacije prek Kafka. Tako uporabniki delajo z izoliranim servisom, ne da bi vplivali na servise, ki obdelujejo podatke o trenutnih operacijah.
Naloga 4. Ponovna obdelava vrstic in spremljanje:
V razdeljenih sistemih se neizogibno pojavljajo težave in napake pri dostopnosti baz podatkov, vrstic in zunanjih virov podatkov. V primeru 'Markusa' je vir takšnih napak integracija z zunanjimi sistemi. Potrebno je bilo najti rešitev, ki omogoča ponovno pošiljanje zahtevkov glede na napake s predpisanim timeoutom, vendar ne prekine obdelave uspešnih zahtevkov v glavni vrstici. Za to je bila izbrana tako imenovana koncept 'topic based retry'. Za vsak glavni topic se ustvari ena ali več retry topicov, v katere se usmerjajo sporočila z napakami, pri čemer se izključuje zamuda pri obdelavi sporočil iz glavnega topic-a. Shema interakcije —
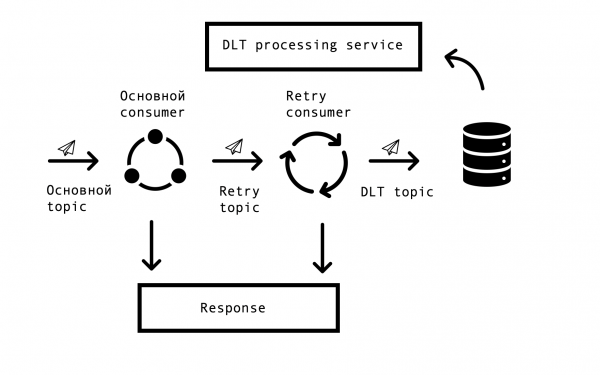
Za izvajanje tovrstne sheme smo potrebovali tole — integrirati to rešitev s Springom in se izogniti podvajanju kode. Na spletu smo naleteli na podobno rešitev, ki temelji na Spring BeanPostProcessorju, vendar se nam je zdela preveč obsežna. Naša ekipa je razvila preprostejšo rešitev, ki se omogoča vključitev v krog Spring pri ustvarjanju porabnikov in dodatno dodajanje Retry porabnikov. Prototip naše rešitve smo predložili ekipi Spring, ogledate si ga lahko . Število Retry porabnikov in število poskusov vsakega porabnika se nastavi preko parametrov, odvisno od potreb poslovnega procesa, in da vse deluje, je dovolj, da preprosto dodamo vsem Spring razvijalcem znano oznako org.springframework.kafka.annotation.KafkaListener.
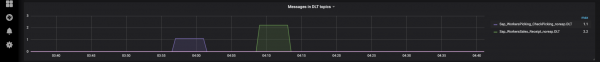
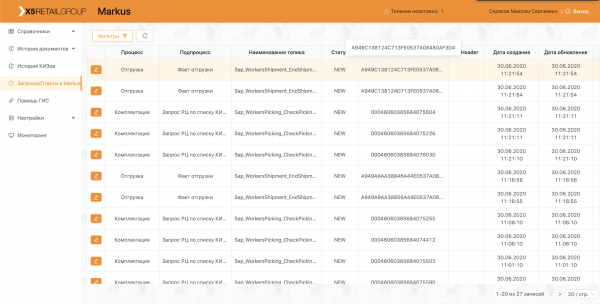
V primeru, da sporočila ni bilo mogoče obdelati po vseh poskusih ponovne obdelave, le-to preide v DLT (dead letter topic) s pomočjo Spring DeadLetterPublishingRecoverer. Na prošnjo podpore smo razširili to funkcionalnost in ustvarili poseben storitev, ki omogoča ogled prejetih sporočil v DLT, stackTrace, traceId in druge koristne informacije o njih. Poleg tega smo dodali spremljanje in opozorila za vse DLT teme, in zdaj dejansko pojavitev sporočila v DLT temi pomeni razlog za analizo in odprtje napake. To je zelo priročno — že po imenu teme takoj razumemo, na kateri stopnji procesa se je težava pojavila, kar močno pospeši iskanje njene osnovne vzročne težave.
Pred kratkim smo izvedli vmesnik, ki omogoča ponovno pošiljanje sporočil s pomočjo naše podpore, po odpravi njihovih vzrokov (na primer, obnova delovanja zunanjega sistema) in seveda odprtje ustrezne napake za analizo. Tukaj so nam prišli prav naši self-teme, da ne bi morali znova zagnati dolge verige obdelave, jo lahko zaženemo znova s potrebne stopnje.
Izvajanje platforme
Platforma je že v produktivni uporabi, vsak dan izvajamo dobave in naloge, povezujemo nove distribucijske centre in trgovine. V okviru pilotnega projekta sistem deluje s skupinami izdelkov 'Tobačna' in 'Obutev'.
Vsa naša ekipa sodeluje pri izvajanju pilotnih projektov, analizira nastale težave in predlaga izboljšave našega izdelka, od izboljšanja logov do sprememb v procesih.
Da ne ponavljamo svoje napake, vsi primeri, ki smo jih našli med pilotiranjem, najdejo svoj odsev v avtomatiziranih testih. Veliko število avto-testov in unit-testov omogoča izvajanje regresijskega testiranja in uvajanje hotfix-a praktično v nekaj urah.
Trenutno nadaljujemo z razvojem in izboljševanjem naše platforme ter se nenehno srečujemo z novimi izzivi. Če vas zanima, vam bomo o naših rešitvah povedali v naslednjih člankih.
Izvor: habr.com
