

TL; DR: JSONB lahko znatno poenostavi razvoj sheme Baze podatkov brez vidne izgube zmogljivosti pri poizvedbah.
Uvod
Oglejmo si klasičen primer, verjetno enega od najstarejših načinov uporabe v svetu relacijskih baz podatkov: imamo entiteto in potrebujemo shraniti določene lastnosti (atribute) te entitete. Vendar pa vsi primerki morda nimajo enakega niza lastnosti, poleg tega pa je v prihodnosti možno dodati še lastnosti.
Najenostavnejša rešitev tega problema je ustvarjanje stolpca v tabeli baze podatkov za vsako vrednost lastnosti in preprosto izpolnjevanje tistih, ki so potrebne za določen primer entitete. Odlično! Problem je rešen… do trenutka, ko vaša tabela ne vsebuje milijonov zapisov in ne potrebujete dodati novega zapisa.
Oglejmo si vzorec EAV (), ki se pojavlja precej pogosto. Ena tabela vsebuje entitete (zapise), druga tabela vsebuje imena lastnosti (atributov), tretja tabela pa povezuje entitete z njihovimi atributi in vsebuje vrednosti teh atributov za trenutno entiteto. To vam omogoča, da imate različne nize lastnosti za različne objekte ter da dodajate lastnosti “v teku”, ne da bi spreminjali strukturo baze podatkov.
Kljub temu ne bi pisal tega zapisa, če ne bi bilo pomanjkljivosti v pristopu z uporabo EVA. Na primer, za pridobitev ene ali več entitet, ki imajo 1 atribut, so potrebni 2 join-a (združevanja) v poizvedbi: prvo – združitev s tabelo atributov, drugo – združitev s tabelo vrednosti. Če entiteta ima 2 atribute, je potrebnih že 4 join-ov! Poleg tega so vsi atributi običajno shranjeni kot nizi, kar vodi do pretvorb tipov, tako za rezultat kot za pogoj WHERE. Če pišete veliko poizvedb, je to dokaj potratno glede na porabo virov.
Kljub tem očitnim pomanjkljivostim se EAV že dolgo uporablja za reševanje tovrstnih problemov. To so bile neizbežne pomanjkljivosti, boljše alternative pa preprosto ni bilo.
Toda nato je v PostgreSQL prišla nova “tehnologija”...
Začenja od PostgreSQL 9.4 je bil dodan tip podatkov JSONB za shranjevanje binarnih podatkov JSON. Čeprav shranjevanje JSON v tej obliki običajno zahteva nekoliko več prostora in časa kot preprost besedilni JSON, se operacije z njim izvajajo veliko hitreje. Prav tako JSONB podpira indeksiranje, kar naredi poizvedbe še hitrejše.
Tip podatkov JSONB nam omogoča zamenjavo obsežnega vzorca EAV z dodajanjem le enega stolpca JSONB v našo tabelo entitet, kar znatno poenostavi načrtovanje baze podatkov. Mnogi pa trdijo, da bi to moralo biti povezano z zmanjšanjem zmogljivosti ... Zato je ta članek nastal.
Nastavitev testne baze podatkov
Za to primerjavo sem ustvaril bazo podatkov na novi namestitvi PostgreSQL 9.5 na 80-dolarni konfiguraciji Ubuntu 14.04. Po prilagoditvi nekaterih parametrov v postgresql.conf sem zagnal skript z uporabo psql. Za predstavitev podatkov v obliki EAV so bile ustvarjene naslednje tabele:
CREATE TABLE entity (
  id           SERIAL PRIMARY KEY,
  name         TEXT,
  description  TEXT
);
CREATE TABLE entity_attribute (
  id          SERIAL PRIMARY KEY,
  name        TEXT
);
CREATE TABLE entity_attribute_value (
  id                  SERIAL PRIMARY KEY,
  entity_id           INT    REFERENCES entity(id),
  entity_attribute_id INT    REFERENCES entity_attribute(id),
  value               TEXT
);
Spodaj je tabela, kjer bodo shranjeni isti podatki, vendar z atributi v stolpcu tipa JSONB – properties.
CREATE TABLE entity_jsonb (
  id          SERIAL PRIMARY KEY,
  name        TEXT,
  description TEXT,
  properties  JSONB
);
Izgleda veliko preprosteje, kajne? Nato je bilo dodanih 10 milijonov zapisov v tabele entitet (entity & entity_jsonb) in sicer so bile napolnjene enake podatke tabele, kjer se uporablja vzorec EAV in pristop s stolpcem JSONB – entity_jsonb.properties. Tako smo dobili več različnih tipov podatkov med celotnim sklopom lastnosti. Primer podatkov:
{
  id:          1
  name:        "Entity1"
  description: "Test entiteta št. 1"
  properties:  {
    color:        "rdeča"
    lenght:       120
    width:        3.1882420
    hassomething: true
    country:      "Belgija"
  }
}
Torej, zdaj imamo enake podatke za dve možnosti. Začnimo primerjati izvedbe v praksi!
Poenostavitev zasnove
Že prej je bilo omenjeno, da je bila zasnova Baze podatkov znatno poenostavljena: ena tabela, zahvaljujoč uporabi stolpca JSONB za lastnosti, namesto uporabe treh tabel za EAV. A kako se to odraža v poizvedbah? Posodobitev enega lastnosti entitete izgleda takole:
-- EAV
UPDATE entity_attribute_value
SET value = 'blue'
WHERE entity_attribute_id = 1
  AND entity_id = 120;

-- JSONB
UPDATE entity_jsonb
SET properties = jsonb_set(properties, '{"color"}', '"blue"')
WHERE id = 120;
Kot vidimo, zadnji poizvedba ne izgleda preproste. Da bi posodobili vrednost lastnosti v JSONB objektu, moramo uporabiti funkcijo , in moramo posredovati našo novo vrednost kot JSONB objekt. Vendar ne potrebujemo poznati nobenega identifikatorja vnaprej. Glede na primer z EAV, moramo poznati tako entity_id kot entity_attribute_id, da izvedemo posodobitev. Če želite posodobiti lastnost v stolpcu JSONB na podlagi imena objekta, to vse naredimo v eni preprosti vrstici.
Zdaj izberimo tisto entiteto, ki smo jo pravkar posodobili, glede na njen novi barvi:
-- EAV
SELECT e.name
FROM entity e
  INNER JOIN entity_attribute_value eav ON e.id = eav.entity_id
  INNER JOIN entity_attribute ea ON eav.entity_attribute_id = ea.id
WHERE ea.name = 'color' AND eav.value = 'blue';

-- JSONB
SELECT name
FROM entity_jsonb
WHERE properties ->> 'color' = 'blue';
Mislim, da se lahko strinjamo, da je drugi primer krajši (brez join!), in zato bolj berljiv. Tukaj zmaga JSONB! Uporabljamo operator JSON ->> za pridobitev barve kot besedilne vrednosti iz JSONB objekta. Obstaja tudi drugi način dosego istega rezultata v JSONB modelu z uporabo operatorja @>:
-- JSONB
SELECT name
FROM entity_jsonb
WHERE properties @> '{"color": "blue"}';
To je nekoliko zahtevnejše: preverjamo, ali JSON objekt v stolpcu lastnosti vsebuje objekt, ki se nahaja desno od operatorja @>. Manj berljivo, bolj zmogljivo (glej naprej).
Pojdimo še korak naprej in poenostavimo uporabo JSONB, ko morate izbrati več lastnosti hkrati. Tukaj resnično pristoji JSONB pristop: preprosto izberemo lastnosti kot dodatne stolpce v našem naboru rezultatov brez potrebe po združevanju:
-- JSONB
SELECT name
  , properties ->> 'color'
  , properties ->> 'country'
FROM entity_jsonb
WHERE id = 120;
Pri EAV boste potrebovali 2 združitvi za vsako lastnost, ki jo želite povprašati. Po mojem mnenju zgoraj navedene poizvedbe kažejo veliko poenostavitev pri oblikovanju baze podatkov. Več primerov, kako pisati poizvedbe za JSONB, morda tudi v objavi.
Sedaj je čas, da govorimo o zmogljivosti.
Performansa
Da bi primerjal zmogljivost, sem uporabil v poizvedbah, za štetje časa izvajanja. Vsaka poizvedba je bila izvedena vsaj trikrat, ker prvič načrtovalcu poizvedb vzame več časa. Najprej sem izvedel poizvedbe brez kakršnih koli indeksov. Očitno je to koristilo JSONB, saj joini, potrebni za EAV, niso mogli uporabljati indeksov (polja tujih ključev niso bila indeksirana). Po tem sem ustvaril indeks za 2 stolpca tujih ključev v tabeli vrednosti EAV, poleg tega indeks za stolpec JSONB.
Posodobitve podatkov so pokazale naslednje rezultate glede časa (v ms). Upoštevajte, da je lestvica logaritmična:
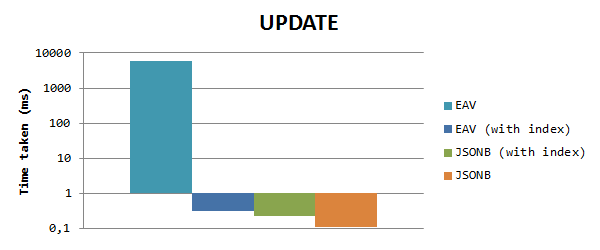
Vidimo, da je JSONB veliko (> 50000-krat) hitrejši od EAV, če ne uporabljamo indeksov, zaradi razloga, omenjenega zgoraj. Ko indeksiramo stolpce s primarnimi ključi, skoraj izgine razlika, vendar je JSONB še vedno 1,3-krat hitrejši od EAV. Upoštevajte, da indeks v stolpcu JSONB tukaj nima nobenega vpliva, saj ne uporabljamo stolpca lastnosti v kriterijih ocenjevanja.
Za izbiro podatkov na podlagi vrednosti lastnosti dobimo naslednje rezultate (navadna lestvica):
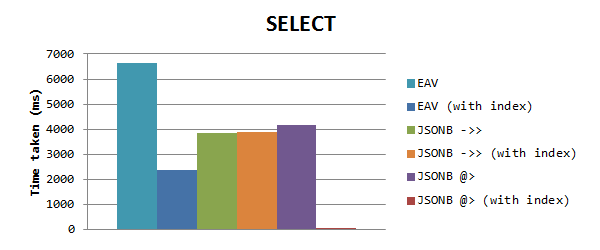
Opaziti je, da JSONB ponovno deluje hitreje kot EAV brez indeksov, vendar ko je EAV z indeksi – vseeno deluje hitreje kot JSONB. Kasneje sem opazil, da je čas za poizvedbe JSONB enak, kar me je pripeljalo do spoznanja, da GIN-indeks ne deluje. Očitno, ko uporabljate indeks GIN za stolpec s polnimi lastnostmi, deluje le pri uporabi operatorja vključitve @>. To sem uporabil v novem testu, kar je imelo ogromen vpliv na čas: le 0,153 ms! To je 15000-krat hitreje kot EAV in 25000-krat hitreje kot operator ->>.
Mislim, da je bilo dovolj hitro!
Velikost tabel BDP
Poglejmo velikosti tabel pri obeh pristopih. V psql lahko prikažemo velikost vseh tabel in indeksov s pomočjo ukaza dti+
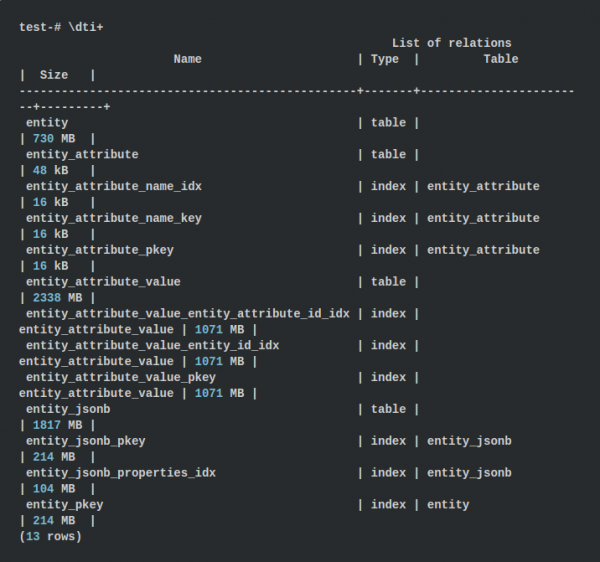
Za pristop EAV znašajo velikosti tabel približno 3068 MB, indeksi pa do 3427 MB, kar skupaj daje 6,43 GB. Pri uporabi pristopa z JSONB se uporablja 1817 MB za tabelo in 318 MB za indekse, kar znaša 2,08 GB. Izkaže se, da je 3-krat manj! Ta podatek me je malo presenetil, ker shranjujemo imena lastnosti v vsakem objektu JSONB.
Toda, vendar številke govorijo same zase: v EAV hranimo 2 celotna zunanja ključa za vrednost atributa, kar pomeni 8 bajtov dodatnih podatkov. Poleg tega v EAV vse vrednosti lastnosti hranimo v besedilu, medtem ko JSONB uporablja numerične in logične vrednosti, kjer je to mogoče, kar pripomore k manjšemu obsegu.
Zaključki
Na splošno menim, da lahko hranjenje lastnosti entitet v formatu JSONB znatno poenostavi načrtovanje in vzdrževanje vaše baze podatkov. Če izvajate veliko poizvedb, bo vse, kar je shranjeno v eni tabeli z entiteto, resnično delovalo bolj učinkovito. Dejansko poenostavitev interakcije med podatki je že prednost, toda tudi rezultatna baza podatkov je 3-krat manjša.
Prav tako, na podlagi opravljenih testov, lahko zaključimo, da so izgube zmogljivosti zelo neznatne. V nekaterih primerih JSONB deluje celo hitreje kot EAV, kar ga dela še boljšo izbiro. Vendar pa ta referenčni test seveda ne pokriva vseh vidikov (na primer, entitete z zelo veliko lastnosti, znatno povečanjem števila lastnosti obstoječih podatkov,…), zato, če imate kakšne predloge, kako jih izboljšati, jih prosim pustite v komentarjih!
Izvor: habr.com
