

Dragi čitatelji, dobar dan. Danas ćemo malo govoriti o Apache Sparku i njegovim perspektivama razvoja.
U današnjem svetu Big Data, Apache Spark je de facto standard za razvoj rešenja za paketsku obradu podataka. Pored toga, takođe se koristi za kreiranje striming aplikacija koje funkcioniraju na konceptu mikro paketa, obrađujući i isporučujući podatke u malim količinama (Spark Structured Streaming). Tradicionalno je bio deo opšteg Hadoop staka, koristeći YARN kao menadžer resursa (ili, u nekim slučajevima, Apache Mesos). Do 2020. godine, njegovo korišćenje u tradicionalnom obliku za većinu kompanija nalazi se pod velikim pitanjem zbog nedostatka adekvatnih Hadoop distribucija — razvoj HDP i CDH je zaustavljen, CDH nije dovoljno razvijen i ima visoke troškove, a ostali Hadoop provajderi su ili prestali da postoje ili imaju nejasnu budućnost. Zbog toga sve veći interes kod zajednice i velikih kompanija izaziva pokretanje Apache Sparka putem Kubernetesa — postavljajući standard u orkestraciji kontejnera i upravljanju resursima u privatnim i javnim oblačnim okruženjima, rešava problem nepraktičnog planiranja resursa zadataka Sparka na YARN-u i pruža stabilno razvijenu platformu s brojnim komercijalnim i otvorenim distribucijama za kompanije svih veličina i profila. Takođe, na talasu popularnosti, većina je uspela da stekne nekoliko svojih instalacija i poveća svoje znanje o njegovom korišćenju, što olakšava prelazak.
Počevši od verzije 2.3.0, Apache Spark je dobio zvaničnu podršku za pokretanje zadataka u Kubernetes klasteru i danas ćemo govoriti o trenutnoj zrelosti ovog pristupa, raznim mogućnostima korišćenja i preprekama s kojima se treba susresti prilikom implementacije.
Pre svega, razmotrićemo proces razvoja zadataka i aplikacija na bazi Apache Sparka i istaknuti tipične slučajeve u kojima je potrebno pokrenuti zadatak na Kubernetes klasteru. U pripremi ovog posta kao distribucija koristi se OpenShift i biće date komande relevantne za njegovu komandnu liniju (oc). Za druge Kubernetes distribucije mogu se koristiti odgovarajuće komande standardne komandne linije Kubernetes (kubectl) ili njihovi analozi (na primer, za oc adm policy).
Prva uporaba — spark-submit
Med razvojem nalog in aplikacij mora razvijalec izvajati naloge za odpravljanje napak pri transformaciji podatkov. Teoretično se lahko za te namene uporabijo nadomestki, vendar se je v praksi, kjer sodelujejo resnični (tudi testni) primerki končnih sistemov, pokazalo, da je razvoj v tem razredu nalog hitrejši in kakovostnejši. V primeru, ko odpravljamo napake na resničnih primerkih končnih sistemov, sta mogoča dva scenarija delovanja:
- razvijalec lokalno izvaja nalogo Spark v načinu standalone;

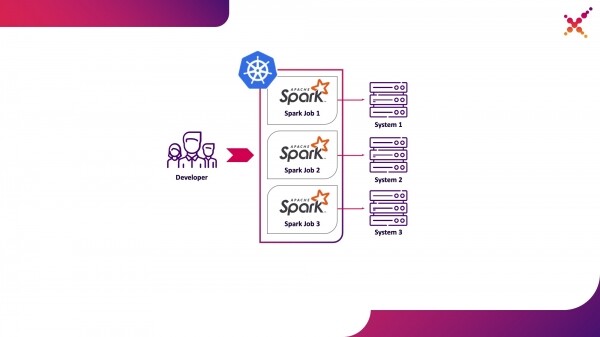
- razvijalec izvaja nalogo Spark v okviru Kubernetes na testnem okolju.
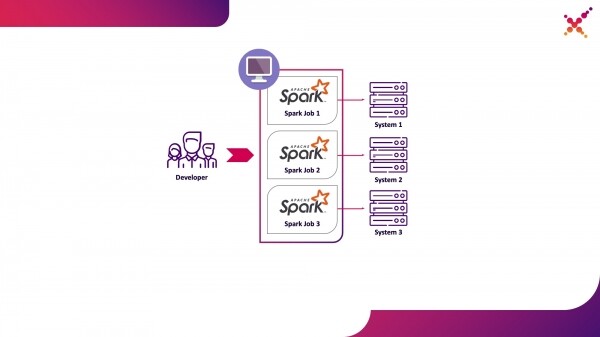
Prva možnost ima pravico do obstoja, vendar prinaša vrsto pomanjkljivosti:
- za vsakega razvijalca je potrebno zagotoviti dostop z delovnega mesta do vseh potrebnih primerkov končnih sistemov;
- na delovni napravi je potrebno imeti dovolj virov za zagon razvijane naloge.
Druga možnost je brez teh pomanjkljivosti, saj uporaba grozda Kubernetes omogoča dodelitev potrebnega nabora virov za zagon nalog in zagotavlja potrebne dostope do primerkov končnih sistemov, fleksibilno omogoča dostop za vse člane razvojne ekipe z uporabo modela vlog Kubernetes. Izpostavimo jo kot prvo uporabo — zagon nalog Spark z lokalnega računalnika razvijalca na grozdu Kubernetes v testnem okolju.
Podrobneje bomo opisali postopek nastavitve Sparka za lokalno izvajanje. Da začnete uporabljati Spark, ga je potrebno namestiti:
mkdir /opt/spark
cd /opt/spark
wget http://mirror.linux-ia64.org/apache/spark/spark-2.4.5/spark-2.4.5.tgz
tar zxvf spark-2.4.5.tgz
rm -f spark-2.4.5.tgz
Zberemo potrebne pakete za delo z Kubernetes:
cd spark-2.4.5/
./build/mvn -Pkubernetes -DskipTests clean package
Popolna gradnja traja dolgo, za ustvarjanje slik Docker in njihovega zagona v grozdu Kubernetes pa v resnici potrebujemo le jar datoteke iz imenika 'assembly/', zato lahko zgradimo le ta podsistem:
. /build/mvn -f ./assembly/pom.xml -Pkubernetes -DskipTests clean package
Za zagon nalog Spark v Kubernetes je potrebno ustvariti sliko Docker, ki se bo uporabljala kot osnovna. Tukaj sta mogoča dva pristopa:
- Ustvarjena slika Docker vključuje izvedljivo kodo naloge Spark;
- Ustvarjena slika vključuje samo Spark in potrebne odvisnosti, izvedbena koda se shranjuje oddaljeno (na primer, v HDFS).
Za začetek bomo zgradili Docker sliko, ki vsebuje testni primer naloge Spark. Za ustvarjanje Docker slik ima Spark ustrezno orodje z imenom „docker-image-tool“. Oglejmo si njegovo pomoč:
./bin/docker-image-tool.sh --help
Z njegovo pomočjo lahko ustvarjamo Docker slike in jih nalagamo v oddaljene registre, vendar ima privzeto številne pomanjkljivosti:
- obvezno ustvari kar 3 Docker slike — za Spark, PySpark in R;
- ne dovoljuje določanja imena slike.
Zato bomo uporabili spremenjeno različico tega orodja, predstavljeno spodaj:
vi bin/docker-image-tool-upd.sh
#!/usr/bin/env bash

function error {
  echo "$@" 1>&2
  exit 1
}

if [ -z "${SPARK_HOME}" ]; then
  SPARK_HOME="$(cd "`dirname "$0"`"/..; pwd)"
fi
. "${SPARK_HOME}/bin/load-spark-env.sh"

function image_ref {
  local image="$1"
  local add_repo="${2:-1}"
  if [ $add_repo = 1 ] && [ -n "$REPO" ]; then
    image="$REPO/$image"
  fi
  if [ -n "$TAG" ]; then
    image="$image:$TAG"
  fi
  echo "$image"
}

function build {
  local BUILD_ARGS
  local IMG_PATH

  if [ ! -f "$SPARK_HOME/RELEASE" ]; then
    IMG_PATH=$BASEDOCKERFILE
    BUILD_ARGS=(
      ${BUILD_PARAMS}
      --build-arg
      img_path=$IMG_PATH
      --build-arg
      datagram_jars=datagram/runtimelibs
      --build-arg
      spark_jars=assembly/target/scala-$SPARK_SCALA_VERSION/jars
    )
  else
    IMG_PATH="kubernetes/dockerfiles"
    BUILD_ARGS=(${BUILD_PARAMS})
  fi

  if [ -z "$IMG_PATH" ]; then
    error "Cannot find docker image. This script must be run from a runnable distribution of Apache Spark."
  fi

  if [ -z "$IMAGE_REF" ]; then
    error "Cannot find docker image reference. Please add -i arg."
  fi

  local BINDING_BUILD_ARGS=(
    ${BUILD_PARAMS}
    --build-arg
    base_img=$(image_ref $IMAGE_REF)
  )
  local BASEDOCKERFILE=${BASEDOCKERFILE:-"$IMG_PATH/spark/docker/Dockerfile"}

  docker build $NOCACHEARG "${BUILD_ARGS[@]}"
    -t $(image_ref $IMAGE_REF)
    -f "$BASEDOCKERFILE" .
}

function push {
  docker push "$(image_ref $IMAGE_REF)"
}

function usage {
  cat <<EOF
Usage: $0 [options] [command]
Builds or pushes the built-in Spark Docker image.

Commands:
  build       Build image. Requires a repository address to be provided if the image will be
              pushed to a different registry.
  push        Push a pre-built image to a registry. Requires a repository address to be provided.

Options:
  -f file               Dockerfile to build for JVM based Jobs. By default builds the Dockerfile shipped with Spark.
  -p file               Dockerfile to build for PySpark Jobs. Builds Python dependencies and ships with Spark.
  -R file               Dockerfile to build for SparkR Jobs. Builds R dependencies and ships with Spark.
  -r repo               Repository address.
  -i name               Image name to apply to the built image, or to identify the image to be pushed.
  -t tag                Tag to apply to the built image, or to identify the image to be pushed.
  -m                    Use minikube's Docker daemon.
  -n                    Build docker image with --no-cache
  -b arg      Build arg to build or push the image. For multiple build args, this option needs to
              be used separately for each build arg.

Using minikube when building images will do so directly into minikube's Docker daemon.
There is no need to push the images into minikube in that case, they'll be automatically
available when running applications inside the minikube cluster.

Check the following documentation for more information on using the minikube Docker daemon:

  https://kubernetes.io/docs/getting-started-guides/minikube/#reusing-the-docker-daemon

Examples:
  - Build image in minikube with tag "testing"
    $0 -m -t testing build

  - Build and push image with tag "v2.3.0" to docker.io/myrepo
    $0 -r docker.io/myrepo -t v2.3.0 build
    $0 -r docker.io/myrepo -t v2.3.0 push
EOF
}

if [[ "$@" = *--help ]] || [[ "$@" = *-h ]]; then
  usage
  exit 0
fi

REPO=
TAG=
BASEDOCKERFILE=
NOCACHEARG=
BUILD_PARAMS=
IMAGE_REF=
while getopts f:mr:t:nb:i: option
do
 case "${option}"
 in
 f) BASEDOCKERFILE=${OPTARG};;
 r) REPO=${OPTARG};;
 t) TAG=${OPTARG};;
 n) NOCACHEARG="--no-cache";;
 i) IMAGE_REF=${OPTARG};;
 b) BUILD_PARAMS=${BUILD_PARAMS}" --build-arg "${OPTARG};;
 esac
done

case "${@: -1}" in
  build)
    build
    ;;
  push)
    if [ -z "$REPO" ]; then
      usage
      exit 1
    fi
    push
    ;;
  *)
    usage
    exit 1
    ;;
esac
Z njegovo pomočjo sestavimo osnovno sliko Spark, ki vsebuje testno nalogo za izračun števila Pi s pomočjo Sparka (tu je {docker-registry-url} — URL vašega registra Docker slik, {repo} — ime repozitorija znotraj registra, ki se ujema s projektom v OpenShiftu, {image-name} — ime slike (če se uporablja trostopenjska razdelitev slik, na primer, kot v integriranem registru slik Red Hat OpenShift), {tag} — oznaka te različice slike):
./bin/docker-image-tool-upd.sh -f resource-managers/kubernetes/docker/src/main/dockerfiles/spark/Dockerfile -r {docker-registry-url}/{repo} -i {image-name} -t {tag} build
Avtentikiramo se v klaster OKD s pomočjo konzolskega orodja (tu je {OKD-API-URL} — URL API klasterja OKD):
oc login {OKD-API-URL}
Pridobimo žeton trenutnega uporabnika za avtentikacijo v Docker Registry:
oc whoami -t
Avtentikiramo se v notranji Docker Registry klasterja OKD (kot geslo uporabimo žeton, pridobljen s prejšnjim ukazom):
docker login {docker-registry-url}
Naložimo zbrano Docker sliko v Docker Registry OKD:
./bin/docker-image-tool-upd.sh -r {docker-registry-url}/{repo} -i {image-name} -t {tag} push
Preverimo, ali je zbrana slika dostopna v OKD. Za to odprite v brskalniku URL s seznamom slik ustreznega projekta (tu je {project} — ime projekta znotraj klasterja OpenShift, {OKD-WEBUI-URL} — URL spletne konzole OpenShift) — https://{OKD-WEBUI-URL}/console/project/{project}/browse/images/{image-name}.
Za zagon nalog mora biti ustvarjen storitveni račun s pravicami za zagon podov kot root (o tem se bomo kasneje pogovarjali):
oc create sa spark -n {project}
oc adm policy add-scc-to-user anyuid -z spark -n {project}
Izvedemo ukaz spark-submit za objavo naloge Spark v klasterju OKD, pri čemer navedemo ustvarjeni storitveni račun in Docker sliko:
/opt/spark/bin/spark-submit --name spark-test --class org.apache.spark.examples.SparkPi --conf spark.executor.instances=3 --conf spark.kubernetes.authenticate.driver.serviceAccountName=spark --conf spark.kubernetes.namespace={project} --conf spark.submit.deployMode=cluster --conf spark.kubernetes.container.image={docker-registry-url}/{repo}/{image-name}:{tag} --conf spark.master=k8s://https://{OKD-API-URL} local:///opt/spark/examples/target/scala-2.11/jars/spark-examples_2.11-2.4.5.jar
Ovde:
—name — ime naloge, ki bo sodelovalo pri oblikovanju imen podov Kubernetes;
—class — класа извршне датотеке, која се позива приликом покретања задатка;
—conf — конфигурацијски параметри Spark;
spark.executor.instances — број активних Spark извршитеља;
spark.kubernetes.authenticate.driver.serviceAccountName — име службеног налога Kubernetes који се користи при покретању подова (за одређивање безбедносног контекста и могућности при интеракцији са Kubernetes API);
spark.kubernetes.namespace — Kubernetes именски простор у коме ће се покретати подови извршитеља и драјвера;
spark.submit.deployMode — режим покретања Spark-а (за стандардни spark-submit користи се "cluster", за Spark Operator и новије верзије Spark-а "client");
spark.kubernetes.container.image — Docker слика која се користи за покретање подова;
spark.master — URL API Kubernetes-а (наводи се спољашњи тако да се приступа са локалне машине);
local:// — пут до извршне датотеке Spark унутар Docker слике.
Прелазимо у одговарајући OKD пројекат и истражујемо креиране подове — https://{OKD-WEBUI-URL}/console/project/{project}/browse/pods.
За олакшавање процеса развоја може се користити још једна опција, где се креира заједничка основна Spark слика која се користи за све задатке и снапшоти извршних датотека објављују у спољно складиште (као што је Hadoop) и наводе се приликом позивања spark-submit као линк. У том случају можемо покретати различите верзије Spark задатака без поновног састављања Docker слика, користећи, на пример, WebHDFS за објављивање слика. Пошаљите захтев за креирање датотеке (овде {host} — хост WebHDFS сервиса, {port} — порт WebHDFS сервиса, {path-to-file-on-hdfs} — жељени пут до датотеке на HDFS):
curl -i -X PUT "http://{host}:{port}/webhdfs/v1/{path-to-file-on-hdfs}?op=CREATE
При томе ће бити добијен одговор у виду (овде {location} — URL који треба користити за преузимање датотеке):
HTTP/1.1 307 TEMPORARY_REDIRECT
Location: {location}
Content-Length: 0
Преузимамо извршну датотеку Spark у HDFS (овде {path-to-local-file} — пут до извршне датотеке Spark на тренутном хосту):
curl -i -X PUT -T {path-to-local-file} "{location}"
Након тога можемо урадити spark-submit користећи Spark датотеку која је учитана на HDFS (овде {class-name} — име класе коју треба покренути за извршавање задатка):
/opt/spark/bin/spark-submit --name spark-test --class {class-name} --conf spark.executor.instances=3 --conf spark.kubernetes.authenticate.driver.serviceAccountName=spark --conf spark.kubernetes.namespace={project} --conf spark.submit.deployMode=cluster --conf spark.kubernetes.container.image={docker-registry-url}/{repo}/{image-name}:{tag} --conf spark.master=k8s://https://{OKD-API-URL} hdfs://{host}:{port}/{path-to-file-on-hdfs}
При томе треба напоменути да може бити потребно модификовати Dockerfile и скрипту entrypoint.sh — додати у Dockerfile директиву за копирање зависних библиотеа у директоријум \/opt\/spark\/jars и укључити HDFS конфигурацијску датотеку у SPARK_CLASSPATH у entrypoint.sh.
Drugi način uporabe — Apache Livy
Nadalje, ko je naloga razvita in je potrebno testirati pridobljen rezultat, se pojavi vprašanje njenega zagon v okviru CI/CD procesa ter sledenja statusom njene izvedbe. Seveda jo lahko zagnamo tudi z lokalnim klicem spark-submit, ampak to zaplete infrastrukturo CI/CD, saj zahteva namestitev in konfiguracijo Sparka na agentih/runnerjih CI strežnika ter nastavitev dostopa do API Kubernetes. V tem primeru je izbrana ciljna izvedba uporaba Apache Livy kot REST API za zagon Spark nalog, nameščenega znotraj klasterja Kubernetes. Z njegovo pomočjo lahko zagonite Spark naloge na klasterju Kubernetes z uporabo običajnih cURL poizvedb, kar je enostavno izvedljivo na osnovi katerega koli CI rešitve, njegova namestitev znotraj klasterja Kubernetes pa reši vprašanje avtentikacije pri interakciji z API Kubernetes.
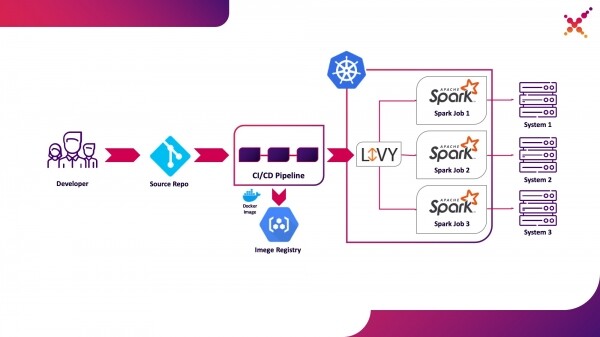
Izpostavimo ga kot drugi način uporabe — zagon Spark nalog v okviru CI/CD procesa na klasterju Kubernetes v testnem okolju.
Nekaj o Apache Livy — deluje kot HTTP strežnik, ki zagotavlja spletni vmesnik in RESTful API, ki omogoča oddaljen zagon spark-submit z dodelitvijo potrebnih parametrov. Tradicionalno je bil dobavljen kot del distribucije HDP, lahko pa je tudi nameščen v OKD ali katerikoli drugi namestitvi Kubernetes s pomočjo ustreznega manifesta in nabora Docker slik, na primer, tega — . Za naš primer je bila zgrajena podobna Docker slika, ki vključuje Spark različico 2.4.5 iz naslednjega Dockerfile:
FROM java:8-alpine

ENV SPARK_HOME=/opt/spark
ENV LIVY_HOME=/opt/livy
ENV HADOOP_CONF_DIR=/etc/hadoop/conf
ENV SPARK_USER=spark

WORKDIR /opt

RUN apk add --update openssl wget bash &&
    wget -P /opt https://downloads.apache.org/spark/spark-2.4.5/spark-2.4.5-bin-hadoop2.7.tgz &&
    tar xvzf spark-2.4.5-bin-hadoop2.7.tgz &&
    rm spark-2.4.5-bin-hadoop2.7.tgz &&
    ln -s /opt/spark-2.4.5-bin-hadoop2.7 /opt/spark

RUN wget http://mirror.its.dal.ca/apache/incubator/livy/0.7.0-incubating/apache-livy-0.7.0-incubating-bin.zip &&
    unzip apache-livy-0.7.0-incubating-bin.zip &&
    rm apache-livy-0.7.0-incubating-bin.zip &&
    ln -s /opt/apache-livy-0.7.0-incubating-bin /opt/livy &&
    mkdir /var/log/livy &&
    ln -s /var/log/livy /opt/livy/logs &&
    cp /opt/livy/conf/log4j.properties.template /opt/livy/conf/log4j.properties

ADD livy.conf /opt/livy/conf
ADD spark-defaults.conf /opt/spark/conf/spark-defaults.conf
ADD entrypoint.sh /entrypoint.sh

ENV PATH="/opt/livy/bin:${PATH}"

EXPOSE 8998

ENTRYPOINT ["/entrypoint.sh"]
CMD ["livy-server"]
Ustvarjena slika se lahko zgradi in naloži v vaš obstoječi Docker repozitorij, na primer v notranji repozitorij OKD. Za njeno uvedbo se uporablja naslednji manifest ({registry-url} — URL Docker registra, {image-name} — ime Docker slike, {tag} — oznaka Docker slike, {livy-url} — želeni URL, pod katerim bo dostopen strežnik Livy; manifest 'Route' se uporablja, če je za distribucijo Kubernetes izbran Red Hat OpenShift, sicer se uporablja ustrezen manifest Ingress ali storitev tipa NodePort):
---
apiVersion: apps/v1
kind: Deployment
metadata:
  labels:
    component: livy
  name: livy
spec:
  progressDeadlineSeconds: 600
  replicas: 1
  revisionHistoryLimit: 10
  selector:
    matchLabels:
      component: livy
  strategy:
    rollingUpdate:
      maxSurge: 25%
      maxUnavailable: 25%
    type: RollingUpdate
  template:
    metadata:
      creationTimestamp: null
      labels:
        component: livy
    spec:
      containers:
        - command:
            - livy-server
          env:
            - name: K8S_API_HOST
              value: localhost
            - name: SPARK_KUBERNETES_IMAGE
              value: 'gnut3ll4/spark:v1.0.14'
          image: '{registry-url}/{image-name}:{tag}'
          imagePullPolicy: Always
          name: livy
          ports:
            - containerPort: 8998
              name: livy-rest
              protocol: TCP
          resources: {}
          terminationMessagePath: /dev/termination-log
          terminationMessagePolicy: File
          volumeMounts:
            - mountPath: /var/log/livy
              name: livy-log
            - mountPath: /opt/.livy-sessions/
              name: livy-sessions
            - mountPath: /opt/livy/conf/livy.conf
              name: livy-config
              subPath: livy.conf
            - mountPath: /opt/spark/conf/spark-defaults.conf
              name: spark-config
              subPath: spark-defaults.conf
        - command:
            - /usr/local/bin/kubectl
            - proxy
            - '--port'
            - '8443'
          image: 'gnut3ll4/kubectl-sidecar:latest'
          imagePullPolicy: Always
          name: kubectl
          ports:
            - containerPort: 8443
              name: k8s-api
              protocol: TCP
          resources: {}
          terminationMessagePath: /dev/termination-log
          terminationMessagePolicy: File
      dnsPolicy: ClusterFirst
      restartPolicy: Always
      schedulerName: default-scheduler
      securityContext: {}
      serviceAccount: spark
      serviceAccountName: spark
      terminationGracePeriodSeconds: 30
      volumes:
        - emptyDir: {}
          name: livy-log
        - emptyDir: {}
          name: livy-sessions
        - configMap:
            defaultMode: 420
            items:
              - key: livy.conf
                path: livy.conf
            name: livy-config
          name: livy-config
        - configMap:
            defaultMode: 420
            items:
              - key: spark-defaults.conf
                path: spark-defaults.conf
            name: livy-config
          name: spark-config
---
apiVersion: v1
kind: ConfigMap
metadata:
  name: livy-config
data:
  livy.conf: |-
    livy.spark.deploy-mode=cluster
    livy.file.local-dir-whitelist=/opt/.livy-sessions/
    livy.spark.master=k8s://http://localhost:8443
    livy.server.session.state-retain.sec = 8h
  spark-defaults.conf: 'spark.kubernetes.container.image        "gnut3ll4/spark:v1.0.14"'
---
apiVersion: v1
kind: Service
metadata:
  labels:
    app: livy
  name: livy
spec:
  ports:
    - name: livy-rest
      port: 8998
      protocol: TCP
      targetPort: 8998
  selector:
    component: livy
  sessionAffinity: None
  type: ClusterIP
---
apiVersion: route.openshift.io/v1
kind: Route
metadata:
  labels:
    app: livy
  name: livy
spec:
  host: {livy-url}
  port:
    targetPort: livy-rest
  to:
    kind: Service
    name: livy
    weight: 100
  wildcardPolicy: None
Po uspešni uporabi in zagonu pod-a je grafični vmesnik Livy dostopen na povezavi: http://{livy-url}/ui. S pomočjo Livy lahko objavimo nalogo Spark, tako da uporabimo REST zahtevo, na primer iz Postmana. Spodaj je prikazan primer zbirke z zahtevami (v polju 'args' lahko predamo konfiguracijske argumente z spremenljivkami, potrebnimi za delovanje zagnane naloge):
{
    "info": {
        "_postman_id": "be135198-d2ff-47b6-a33e-0d27b9dba4c8",
        "name": "Spark Livy",
        "schema": "https://schema.getpostman.com/json/collection/v2.1.0/collection.json"
    },
    "item": [
        {
            "name": "1 Pošaljite posao s jar-om",
            "request": {
                "method": "POST",
                "header": [
                    {
                        "key": "Content-Type",
                        "value": "application/json"
                    }
                ],
                "body": {
                    "mode": "raw",
                    "raw": "{nt\"file\": \"local://opt/spark/examples/target/scala-2.11/jars/spark-examples_2.11-2.4.5.jar\", nt\"className\": \"org.apache.spark.examples.SparkPi\",nt\"numExecutors\":1,nt\"name\": \"spark-test-1\",nt\"conf\": {ntt\"spark.jars.ivy\": \"/tmp/.ivy\",ntt\"spark.kubernetes.authenticate.driver.serviceAccountName\": \"spark\",ntt\"spark.kubernetes.namespace\": \"{project}\",ntt\"spark.kubernetes.container.image\": \"{docker-registry-url}/{repo}/{image-name}:{tag}\"nt}n}"
                },
                "url": {
                    "raw": "http://{livy-url}/batches",
                    "protocol": "http",
                    "host": [
                        "{livy-url}"
                    ],
                    "path": [
                        "batches"
                    ]
                }
            },
            "response": []
        },
        {
            "name": "2 Pošaljite posao bez jar-a",
            "request": {
                "method": "POST",
                "header": [
                    {
                        "key": "Content-Type",
                        "value": "application/json"
                    }
                ],
                "body": {
                    "mode": "raw",
                    "raw": "{nt\"file\": \"hdfs://{host}:{port}/{path-to-file-on-hdfs}\", nt\"className\": \"{class-name}\",nt\"numExecutors\":1,nt\"name\": \"spark-test-2\",nt\"proxyUser\": \"0\",nt\"conf\": {ntt\"spark.jars.ivy\": \"/tmp/.ivy\",ntt\"spark.kubernetes.authenticate.driver.serviceAccountName\": \"spark\",ntt\"spark.kubernetes.namespace\": \"{project}\",ntt\"spark.kubernetes.container.image\": \"{docker-registry-url}/{repo}/{image-name}:{tag}\"nt},nt\"args\": [ntt\"HADOOP_CONF_DIR=/opt/spark/hadoop-conf\",ntt\"MASTER=k8s://https://kubernetes.default.svc:8443\"nt]n}"
                },
                "url": {
                    "raw": "http://{livy-url}/batches",
                    "protocol": "http",
                    "host": [
                        "{livy-url}"
                    ],
                    "path": [
                        "batches"
                    ]
                }
            },
            "response": []
        }
    ],
    "event": [
        {
            "listen": "prerequest",
            "script": {
                "id": "41bea1d0-278c-40c9-ad42-bf2e6268897d",
                "type": "text/javascript",
                "exec": [
                    ""
                ]
            }
        },
        {
            "listen": "test",
            "script": {
                "id": "3cdd7736-a885-4a2d-9668-bd75798f4560",
                "type": "text/javascript",
                "exec": [
                    ""
                ]
            }
        }
    ],
    "protocolProfileBehavior": {}
}
Izvršite prvi zahtev iz kolekcije, idite na OKD interfejs i proverite da li je zadatak uspešno pokrenut — https://{OKD-WEBUI-URL}/console/project/{project}/browse/pods. U međuvremenu, na Livy interfejsu (http://{livy-url}/ui) biće dostupna sesija, putem koje možete pratiti napredak izvršenja zadatka i istraživati logove sesije koristeći Livy API ili grafički interfejs.
Zdaj bomo pokazali mehanizem delovanja Livy. Da bi to naredili, bomo proučili dnevnike vsebnika Livy znotraj poda s strežnikom Livy — https://{OKD-WEBUI-URL}/console/project/{project}/browse/pods/{livy-pod-name}?tab=logs. Iz njih je razvidno, da ob klicu REST API Livy v vsebniku z imenom „livy“ poteka izvajanje spark-submit, podobno tistemu, ki smo ga uporabili zgoraj (tu je {livy-pod-name} – ime ustvarjenega poda s strežnikom Livy). V zbirki je prav tako predstavljen drugi zahtevek, ki omogoča zagon nalog z oddaljenim nameščanjem izvršnega datoteka Spark s pomočjo strežnika Livy.
Tretja možnost uporabe — Spark Operator
Sedaj, ko je bila naloga testirana, se pojavi vprašanje njenega rednega zagona. Nativni način za reden zagon nalog v grozdu Kubernetes je entiteta CronJob, ki jo lahko uporabimo, vendar v tem trenutku postaja vse bolj priljubljena uporaba operaterjev za upravljanje aplikacij v Kubernetes, in za Spark obstaja dokaj zrel operater, ki se uporablja tudi v rešitvah podjetniškega nivoja (na primer, Lightbend FastData Platform). Priporočamo, da ga uporabite — trenutna stabilna različica Sparka (2.4.5) ima precej omejene možnosti konfiguracije zagona nalog Spark v Kubernetes, medtem ko v naslednji glavni različici (3.0.0) napovedujejo popolno podporo za Kubernetes, a datum njene izdaje ostaja neznan. Spark Operator nadomešča to pomanjkljivost tako, da dodaja pomembne parametre konfiguracije (na primer, montiranje ConfigMap s konfiguracijo dostopa do Hadoopa v pode Spark) in možnost rednega zagona naloge po urniku.
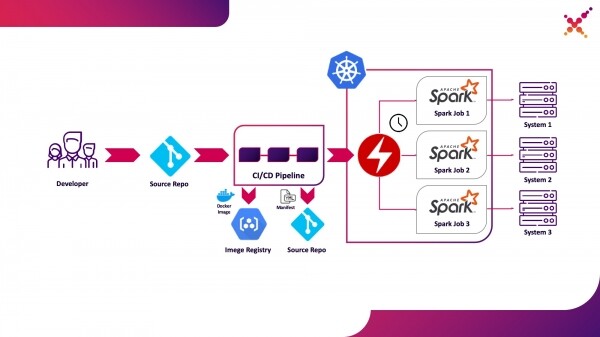
Izpostavimo ga kot tretjo možnost uporabe — reden zagon nalog Spark v grozdu Kubernetes v produkcijskem okolju.
Spark Operator ima odprtokodni izvor in se razvija v okviru Google Cloud Platform — . Njegova namestitev je lahko izvedena na 3 načine:
- V okviru namestitve Lightbend FastData Platform/Cloudflow;
- S pomočjo Helma:
helm repo add incubator http://storage.googleapis.com/kubernetes-charts-incubator helm install incubator/sparkoperator --namespace spark-operator - Uporaba manifestov iz uradnega repozitorija (https://github.com/GoogleCloudPlatform/spark-on-k8s-operator/tree/master/manifest). Pri tem je treba opozoriti, da Cloudflow vključuje operaterja z različico API v1beta1. Če se uporablja ta tip namestitve, morajo biti opisi manifestov aplikacij Spark zasnovani na osnovi primerov iz oznak v Gitu z ustrezno različico API, na primer 'v1beta1-0.9.0-2.4.0'. Različico operaterja si je mogoče ogledati v opisu CRD, ki je del operaterja v slovarju 'versions':
oc get crd sparkapplications.sparkoperator.k8s.io -o yaml
Če je operater pravilno nameščen, se v ustreznem projektu prikaže aktiven pod z operaterjem Spark (na primer cloudflow-fdp-sparkoperator v prostoru Cloudflow za namestitev Cloudflow) in ustrezna vrsta virov Kubernetes z imenom 'sparkapplications'. Obstoječe aplikacije Spark lahko preučite z naslednjim ukazom:
oc get sparkapplications -n {project}
Za zagon nalog s pomočjo Spark Operator je treba opraviti 3 stvari:
- ustvariti Docker sliko, ki vključuje vse potrebne knjižnice ter konfiguracijske in izvajalne datoteke. V ciljni sliki je to slika, ustvarjena v fazi CI/CD in testirana na testnem grozdu;
- objaviti Docker sliko v registru, dostopnem iz grozda Kubernetes;
- oblikovati manifest z vrsto 'SparkApplication' in opisom zagnane naloge. Primeri manifestov so na voljo v uradnem repozitoriju (na primer, ). Pomembne točke v zvezi z manifestom so:
- v slovarju 'apiVersion' mora biti navedena različica API, ki ustreza različici operaterja;
- v slovarju 'metadata.namespace' mora biti navedeno ime prostora, v katerem bo aplikacija zagnana;
- v slovarju 'spec.image' mora biti navedena naslov ustvarjene Docker slike v dostopnem registru;
- v slovarju 'spec.mainClass' mora biti navedena razred naloge Spark, ki ga je treba zagnati pri zagonu procesa;
- v slovarju 'spec.mainApplicationFile' mora biti navedena pot do izvajalne jar datoteke;
- v slovarju 'spec.sparkVersion' mora biti navedena uporabljena različica Spark;
- v slovarju 'spec.driver.serviceAccount' mora biti navedena storitvena računovodja znotraj ustreznega prostora imenskega prostora Kubernetes, ki bo uporabljena za zagon aplikacije;
- v slovarju 'spec.executor' mora biti navedeno število virov, dodeljenih aplikaciji.
- V slovarju «spec.volumeMounts» mora biti navedena lokalna mapa, v kateri bodo ustvarjene lokalne datoteke naloge Spark.
Primer oblikovanja manifesta (tukaj {spark-service-account} je servisni račun znotraj Kubernetes grozda za zagon nalog Spark):
apiVersion: "sparkoperator.k8s.io/v1beta1"
kind: SparkApplication
metadata:
  name: spark-pi
  namespace: {project}
spec:
  type: Scala
  mode: cluster
  image: "gcr.io/spark-operator/spark:v2.4.0"
  imagePullPolicy: Always
  mainClass: org.apache.spark.examples.SparkPi
  mainApplicationFile: "local:///opt/spark/examples/jars/spark-examples_2.11-2.4.0.jar"
  sparkVersion: "2.4.0"
  restartPolicy:
    type: Never
  volumes:
    - name: "test-volume"
      hostPath:
        path: "/tmp"
        type: Directory
  driver:
    cores: 0.1
    coreLimit: "200m"
    memory: "512m"
    labels:
      version: 2.4.0
    serviceAccount: {spark-service-account}
    volumeMounts:
      - name: "test-volume"
        mountPath: "/tmp"
  executor:
    cores: 1
    instances: 1
    memory: "512m"
    labels:
      version: 2.4.0
    volumeMounts:
      - name: "test-volume"
        mountPath: "/tmp"
V tem manifestu je naveden servisni račun, za katerega je potrebno pred objavo manifesta ustvariti potrebne povezave vlog, ki zagotavljajo potrebna dostopna pravice za interakcijo aplikacije Spark z API-jem Kubernetes (če je potrebno). V našem primeru aplikaciji potrebuje pravice za ustvarjanje Pod-ov. Ustvarili bomo potrebno povezavo vloge:
oc adm policy add-role-to-user edit system:serviceaccount:{project}:{spark-service-account} -n {project}
Prav tako je vredno omeniti, da lahko v specifikaciji tega manifesta navedemo parameter „hadoopConfigMap“, ki omogoča navedbo ConfigMap z konfiguracijo Hadoop brez predhodnega umestitve ustrezne datoteke v Docker sliko. Prav tako je primeren za redno zagon nalog — s pomočjo parametra „schedule“ lahko navedemo urnik za zagon te naloge.
Po tem shranimo naš manifest v datoteko spark-pi.yaml in ga uporabimo na našem Kubernetes grozdu:
oc apply -f spark-pi.yaml
Pri tem bo ustvarjen objekt tipa «sparkapplications»:
oc get sparkapplications -n {project}
> NAME       AGE
> spark-pi   22h
Pri tem bo ustvarjen pod z aplikacijo, katere status bo prikazan v ustvarjenem «sparkapplications». To lahko pogledate z naslednjim ukazom:
oc get sparkapplications spark-pi -o yaml -n {project}
Po zaključku naloge bo POD prešel v status «Completed», ki se bo prav tako posodobil v «sparkapplications». Dodatke aplikacije lahko pogledate v brskalniku ali z naslednjim ukazom (tukaj {sparkapplications-pod-name} je ime poda zažene naloge):
oc logs {sparkapplications-pod-name} -n {project}
Upravljanje zadacima Spark može se također provesti putem specijaliziranog alata sparkctl. Za njegovu instalaciju kloniramo repozitorij sa njegovim izvornih kodom, instaliramo Go i sastavljamo ovaj alat:
git clone https://github.com/GoogleCloudPlatform/spark-on-k8s-operator.git
cd spark-on-k8s-operator/
wget https://dl.google.com/go/go1.13.3.linux-amd64.tar.gz
tar -xzf go1.13.3.linux-amd64.tar.gz
sudo mv go /usr/local
mkdir $HOME/Projects
export GOROOT=/usr/local/go
export GOPATH=$HOME/Projects
export PATH=$GOPATH/bin:$GOROOT/bin:$PATH
go -version
cd sparkctl
go build -o sparkctl
sudo mv sparkctl /usr/local/bin
Istražimo listu pokrenutih zadataka Spark:
sparkctl list -n {project}
Naprimo opis za zadatak Spark:
vi spark-app.yaml
apiVersion: "sparkoperator.k8s.io/v1beta1"
kind: SparkApplication
metadata:
  name: spark-pi
  namespace: {project}
spec:
  type: Scala
  mode: cluster
  image: "gcr.io/spark-operator/spark:v2.4.0"
  imagePullPolicy: Always
  mainClass: org.apache.spark.examples.SparkPi
  mainApplicationFile: "local:///opt/spark/examples/jars/spark-examples_2.11-2.4.0.jar"
  sparkVersion: "2.4.0"
  restartPolicy:
    type: Never
  volumes:
    - name: "test-volume"
      hostPath:
        path: "/tmp"
        type: Directory
  driver:
    cores: 1
    coreLimit: "1000m"
    memory: "512m"
    labels:
      version: 2.4.0
    serviceAccount: spark
    volumeMounts:
      - name: "test-volume"
        mountPath: "/tmp"
  executor:
    cores: 1
    instances: 1
    memory: "512m"
    labels:
      version: 2.4.0
    volumeMounts:
      - name: "test-volume"
        mountPath: "/tmp"
Pokrenimo opisani zadatak pomoću sparkctl:
sparkctl create spark-app.yaml -n {project}
Istražimo listu pokrenutih zadataka Spark:
sparkctl list -n {project}
Istražimo listu događaja pokrenutog zadatka Spark:
sparkctl event spark-pi -n {project} -f
Istražimo status pokrenutog zadatka Spark:
sparkctl status spark-pi -n {project}
Na kraju, htjeli bismo razmotriti otkrivene nedostatke korištenja trenutne stabilne verzije Sparka (2.4.5) u Kubernetesu:
- Prvi i, verovatno, najveći nedostatak je nedostatak lokalnosti podataka. I pored svih nedostataka, YARN je imao i prednosti, poput principa dostave koda do podataka (umesto podataka do koda). Zahvaljujući tome, Spark zadaci su se izvršavali na čvorovima gde su se nalazili podaci uključeni u proračune, što je značajno smanjilo vreme prenosa podataka putem mreže. Kada koristimo Kubernetes, suočavamo se sa potrebom za prenosom podataka putem mreže koji su uključeni u izvršavanje zadataka. U slučaju da su dovoljno veliki, vreme izvršavanja zadataka može se značajno povećati, a takođe će biti potreban i značajan kapacitet diska dodeljenim instancama Spark zadataka za njihovo privremeno skladištenje. Ovaj nedostatak može se smanjiti korišćenjem specijalizovanih softverskih alata koji obezbeđuju lokalnost podataka u Kubernetesu (na primer, Alluxio), ali to u suštini znači potrebu za skladištenjem pune kopije podataka na čvorovima Kubernetes klastera.
- Drugi važan nedostatak je bezbednost. Podrazumevane funkcije vezane za obezbeđenje sigurnosti prilikom pokretanja Spark zadataka su isključene, dok upotreba Kerberosa nije obuhvaćena u zvaničnoj dokumentaciji (iako su odgovarajuće opcije uvedene u verziji 3.0.0, što će zahtevati dodatno istraživanje), a u dokumentaciji o obezbeđenju bezbednosti prilikom korišćenja Sparka (https://spark.apache.org/docs/2.4.5/security.html) kao skladišta ključeva se pominju samo YARN, Mesos i Standalone Cluster. Pri tome, korisnik pod kojim se pokreću Spark zadaci ne može se direktno odrediti — samo postavljamo servisni račun pod kojim će raditi pod, a korisnik se bira na osnovu postavljenih pravila bezbednosti. U tom smislu, koristi se ili korisnik root, što nije bezbedno u produkcijskom okruženju, ili korisnik sa slučajnim UID-om, što nije praktično za dodeljivanje prava pristupa podacima (može se rešiti kreiranjem PodSecurityPolicies i njihovim povezivanjem sa odgovarajućim servisnim računima). Trenutno se to rešava ili stavljanjem svih potrebnih datoteka direktno u Docker sliku, ili modifikacijom skripte za pokretanje Sparka da koristi mehanizam skladištenja i pribavljanja tajni koji je usvojen u vašoj organizaciji.
- Zagon nalog Spark z uporabo Kubernetes je uradno še vedno v eksperimentalnem načinu, zato so v prihodnosti možne pomembne spremembe v uporabljenih artefaktih (konfiguracijskih datotekah, osnovnih slikah Docker in zagonskih skriptah). In res — med pripravo gradiva so bile testirane različice 2.3.0 in 2.4.5, katerih obnašanje se je bistveno razlikovalo.
Čakamo na posodobitve — nedavno je izšla nova različica Spark (3.0.0), ki je prinesla opazne spremembe v delovanju Sparka na Kubernetes, vendar je ohranila eksperimentalni status podpore temu upravljalcu virov. Morda bodo naslednje posodobitve resnično omogočile, da se v celoti priporoči opustitev YARN in zagon nalog Spark na Kubernetes, ne da bi bilo treba skrbeti za varnost vašega sistema in brez potrebe po samostojnem razvoju funkcionalnih komponent.
Konec.
Izvor: habr.com
